Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
Platí na: SQL Server 2016 (13.x) a novější verze Azure SQL DatabaseAzure SQL Managed InstanceSQL database in Microsoft Fabric
Své dotazy můžete optimalizovat přes JSON dokumenty pomocí standardních indexů B-stromu. Indexy databází zlepšují výkon operací filtrování a řazení. Bez indexů musí Database Engine provádět kompletní skenování tabulky pokaždé, když zadáte dotaz na data.
Tip
Indexy fungují stejně jako u dat JSON v varchar/nvarchar nebo nativní datového typu json.
Note
Datový typ json a indexy JSON jsou obecně dostupné v SQL Serveru 2025 (17.x), Azure SQL Database, Azure SQL Managed Instance (s aktualizačními zásadamiSQL Server 2025 nebo Always-up-to-date) a SQL databázi v Microsoft Fabric.
Existují dva způsoby, jak indexovat JSON data, v závislosti na tom, jak je ukládáte:
| Typ indexu | Description |
|---|---|
| JSON index | Když ukládáte JSON do sloupce json, vytvořte na sloupci JSON index. Jeden JSON index může optimalizovat mnoho dotazů, které využívají funkce jako JSON_VALUE, JSON_PATH_EXISTS, a JSON_CONTAINS pro vyhledávání hodnot v dokumentu. Tento přístup je doporučen pro datový typ json . |
| Vypočtený sloupcový index | Když ukládáte JSON jako varchar nebo nvarchar text, nebo když chcete indexovat jednu JSON vlastnost jako silně typovaný sloupec, vytvořte vypočítaný sloupec s JSON_VALUE a vytvořte na něm standardní index. |
Indexujte sloupec JSON pomocí JSON indexu
Platí pro: Azure SQL Database, Azure SQL Managed Instance, SQL Server 2025 (17.x) a SQL databázi v Microsoft Fabric
JSON index můžete vytvořit přímo na sloupci json. JSON index indexuje cesty v dokumentu JSON, takže jeden index může optimalizovat mnoho vyhledávání v dokumentu bez samostatného vypočteného sloupce pro každou vlastnost.
Note
JSON indexy nejsou podporovány v SQL Server 2022 (16.x) a starších verzích.
Následující příklad vytváří tabulku s json sloupcem a JSON indexem na tomto sloupci:
CREATE TABLE Orders
(
    OrderID INT IDENTITY PRIMARY KEY,
    OrderDetails JSON NOT NULL
);

CREATE JSON INDEX IX_OrderDetails
    ON Orders (OrderDetails);
S JSON indexem na místě může Database Engine optimalizovat dotazy, které používají JSON_VALUE, JSON_PATH_EXISTS, nebo JSON_CONTAINS. Například následující dotaz může použít JSON index k filtrování objednávek podle jména zákazníka:
SELECT OrderID
FROM Orders
WHERE JSON_VALUE(OrderDetails, '$.Customer.Name') = N'Aaron Campbell';
Pro úplnou syntaxi, možnosti indexu a kompletní seznam podporovaných predikátů viz CREATE JSON INDEX.
Indexování vlastností JSON pomocí počítaných sloupců
Použijte index vypočítaného sloupce, když ukládáte JSON jako varchar nebo nvarchar text, nebo když chcete zobrazit jednu JSON vlastnost jako silně typovaný sloupec pro filtrování nebo třídění. Obvykle chcete filtrovat nebo třídit výsledky dotazů podle jedné nebo více vlastností JSON dokumentů.
Example
V tomto příkladu předpokládejme, že tabulka AdventureWorks.SalesOrderHeader obsahuje sloupec Info, který obsahuje různé informace ve formátu JSON o prodejních objednávkách. Obsahuje například nestrukturovaná data o zákazních, prodejních osobách, dodacích a fakturačních adresách atd. Hodnoty ze sloupce Info můžete použít k filtrování prodejních objednávek pro zákazníka.
Ve výchozím nastavení použitý sloupec Info neexistuje, dá se vytvořit v AdventureWorks databázi s následujícím kódem. Následující příklady se nevztahují na AdventureWorksLT řadu ukázkových databází.
IF NOT EXISTS (SELECT *
               FROM sys.columns
               WHERE object_id = OBJECT_ID('[Sales].[SalesOrderHeader]')
                     AND name = 'Info')
    ALTER TABLE [Sales].[SalesOrderHeader]
        ADD [Info] NVARCHAR (MAX) NULL;
GO

UPDATE h
SET [Info] =
(
    SELECT concat(p.FirstName, N' ', p.LastName) AS [Customer.Name],
            p.BusinessEntityID AS [Customer.ID],
            p.[PersonType] AS [Customer.Type],
            soh.SalesOrderID AS [Order.ID],
            soh.SalesOrderNumber AS [Order.Number],
            soh.OrderDate AS [Order.CreationDate],
            soh.TotalDue AS [Order.TotalDue]
    FROM [Sales].SalesOrderHeader AS soh
        INNER JOIN [Sales].[Customer] AS c
            ON c.CustomerID = soh.CustomerID
        INNER JOIN [Person].[Person] AS p
            ON p.BusinessEntityID = c.CustomerID
    WHERE soh.SalesOrderID = h.SalesOrderID
    FOR JSON PATH, WITHOUT_ARRAY_WRAPPER
)
FROM [Sales].SalesOrderHeader AS h;
Dotaz pro optimalizaci
Tady je příklad typu dotazu, který chcete optimalizovat pomocí indexu.
SELECT SalesOrderNumber,
       OrderDate,
       JSON_VALUE(Info, '$.Customer.Name') AS CustomerName
FROM Sales.SalesOrderHeader
WHERE JSON_VALUE(Info, '$.Customer.Name') = N'Aaron Campbell';
Příklad indexu
Pokud chcete zrychlit své filtry nebo klauzule ORDER BY pro vlastnost v dokumentu JSON, můžete použít stejné indexy, které už používáte v jiných sloupcích. V dokumentech JSON však nemůžete přímo odkazovat na vlastnosti.
- Nejprve vytvořte "virtuální sloupec", který vrátí hodnoty, které chcete použít k filtrování.
- Pak vytvořte index pro tento virtuální sloupec.
Následující příklad vytvoří počítaný sloupec, který lze použít k indexování. Pak vytvoří index pro nový vypočítaný sloupec. Tento příklad vytvoří sloupec, který zveřejňuje jméno zákazníka, které je uloženo v cestě $.Customer.Name v datech JSON.
ALTER TABLE Sales.SalesOrderHeader
    ADD vCustomerName AS JSON_VALUE(Info, '$.Customer.Name');

CREATE INDEX idx_soh_json_CustomerName
    ON Sales.SalesOrderHeader(vCustomerName);
Toto prohlášení vrátí následující upozornění:
Warning! The maximum key length for a nonclustered index is 1700 bytes.
The index 'vCustomerName' has maximum length of 8000 bytes.
For some combination of large values, the insert/update operation will fail.
Funkce JSON_VALUE může vracet textové hodnoty až 8 000 bajtů (například jako nvarchar(4000) typ). Hodnoty delší než 1700 bajtů se ale nedají indexovat. Pokud se pokusíte zadat hodnotu do indexovaného počítaného sloupce, který je delší než 1700 bajtů, operace jazyka pro manipulaci s daty (DML) selže.
Pokud chcete dosáhnout lepšího výkonu, zkuste přetypovat hodnotu, kterou zpřístupňujete, pomocí počítaného sloupce na nejmenší použitelný datový typ. Používejte typy int a datetime2 místo typů řetězců.
Další informace o počítaném sloupci
Vypočítaný sloupec se neuloží. Počítaný sloupec se vypočítá pouze v případech, kdy je potřeba znovu vytvořit index. Nezabírá v tabulce další prostor.
Je důležité vytvořit počítaný sloupec se stejným výrazem, který plánujete použít v dotazech – v tomto příkladu je výraz JSON_VALUE(Info, '$.Customer.Name').
Dotazy nemusíte přepisovat. Pokud používáte výrazy s funkcí JSON_VALUE, jak je znázorněno v předchozím ukázkovém dotazu, SQL Server zjistí, že existuje ekvivalentní počítaný sloupec se stejným výrazem a pokud je to možné, použije index.
Plán provádění pro tento příklad
Tady je plán provádění dotazu v tomto příkladu.
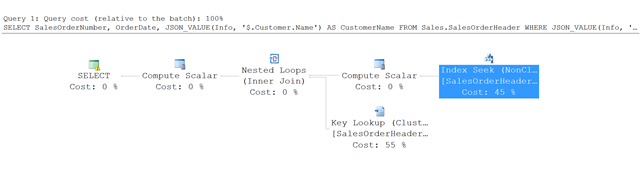
Místo úplné kontroly tabulek sql Server použije vyhledávání indexu do neclusterovaného indexu a najde řádky, které splňují zadané podmínky. Potom pomocí klíčového vyhledávání v tabulce SalesOrderHeader načte další sloupce, na které odkazuje dotaz – v tomto příkladu SalesOrderNumber a OrderDate.
Optimalizace indexu dále pomocí zahrnutých sloupců
Pokud do indexu přidáte požadované sloupce, můžete se vyhnout tomuto dodatečnému vyhledávání v tabulce. Tyto sloupce můžete přidat jako standardní zahrnuté sloupce, jak je znázorněno v následujícím příkladu, který rozšiřuje předchozí CREATE INDEX příklad.
CREATE INDEX idx_soh_json_CustomerName
    ON Sales.SalesOrderHeader(vCustomerName)
    INCLUDE(SalesOrderNumber, OrderDate);
V tomto případě SQL Server nemusí číst další data z SalesOrderHeader tabulky, protože vše, co potřebuje, je součástí neclusterovaného indexu JSON. Tento typ indexu je vhodný způsob, jak kombinovat data JSON a sloupce v dotazech a vytvářet optimální indexy pro vaši úlohu.
Indexy vypočítaných sloupců zohledňují kolaci
Důležitou vlastností vypočítávaných sloupcových indexů nad daty JSON je, že zohledňují kolaci. Výsledek funkce JSON_VALUE, kterou použijete při tvorbě počítaného sloupce, je textová hodnota, která přebírá řazení z původního výrazu. Hodnoty v indexu jsou proto seřazené pomocí pravidel kolace definovaných ve zdrojových sloupcích.
Abychom ukázali, že indexy zohledňují řazení, následující příklad vytvoří jednoduchou tabulku kolekcí s primárním klíčem a obsahem JSON.
CREATE TABLE JsonCollection
(
    id INT IDENTITY CONSTRAINT PK_JSON_ID PRIMARY KEY,
    [json] NVARCHAR (MAX) COLLATE SERBIAN_CYRILLIC_100_CI_AI
        CONSTRAINT [Content should be formatted as JSON] CHECK (ISJSON(json) > 0)
);
Předchozí příkaz určuje srbské cyrilické řazení pro sloupec json. Následující příklad naplní tabulku a vytvoří index na vlastnosti 'název'.
INSERT INTO JsonCollection
VALUES (N'{"name":"Иво","surname":"Андрић"}'),
       (N'{"name":"Андрија","surname":"Герић"}'),
       (N'{"name":"Владе","surname":"Дивац"}'),
       (N'{"name":"Новак","surname":"Ђоковић"}'),
       (N'{"name":"Предраг","surname":"Стојаковић"}'),
       (N'{"name":"Михајло","surname":"Пупин"}'),
       (N'{"name":"Борислав","surname":"Станковић"}'),
       (N'{"name":"Владимир","surname":"Грбић"}'),
       (N'{"name":"Жарко","surname":"Паспаљ"}'),
       (N'{"name":"Дејан","surname":"Бодирога"}'),
       (N'{"name":"Ђорђе","surname":"Вајферт"}'),
       (N'{"name":"Горан","surname":"Бреговић"}'),
       (N'{"name":"Милутин","surname":"Миланковић"}'),
       (N'{"name":"Никола","surname":"Тесла"}');
GO

ALTER TABLE JsonCollection
    ADD vName AS JSON_VALUE(json, '$.name');

CREATE INDEX idx_name
    ON JsonCollection(vName);
Předchozí příkazy vytvoří standardní index vypočítaného sloupce vName, který představuje hodnotu z vlastnosti $.name JSON. Na znakové stránce srbské cyrilice je pořadí písmen А, Б, В, Г, Д, Ђ, Е, atd. Pořadí položek v indexu je v souladu s pravidly Srbské Cyriliky, protože výsledek funkce JSON_VALUE dědí kolaci ze zdrojového sloupce. Následující příklad dotazuje tuto kolekci a seřadí výsledky podle názvu.
SELECT JSON_VALUE(json, '$.name'),
       *
FROM JsonCollection
ORDER BY JSON_VALUE(json, '$.name');
Pokud se podíváte na skutečný plán provádění, uvidíte, že používá seřazené hodnoty z neclusterovaného indexu.
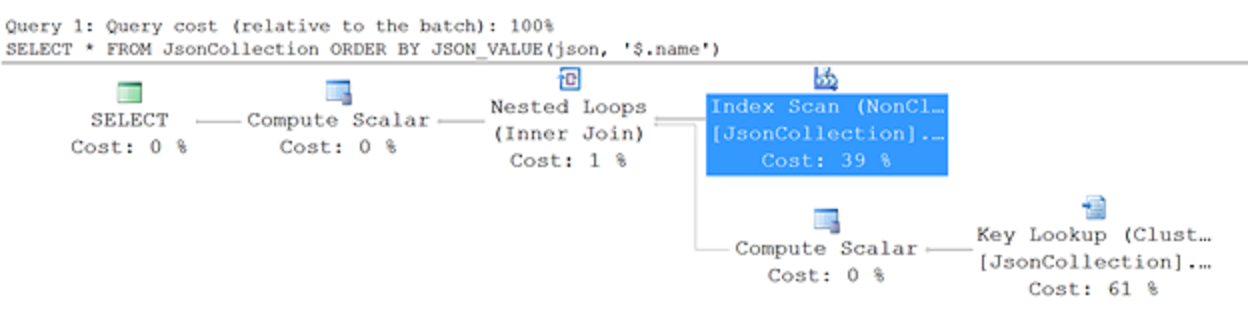
I když dotaz obsahuje klauzuli ORDER BY, plán provádění nepoužívá operátor Sort. Index JSON je již seřazený podle pravidel srbštiny cyrilice. Sql Server proto může použít neclusterovaný index, ve kterém jsou výsledky již seřazené.
Pokud ale změníte kolaci výrazu ORDER BY – například když za funkci COLLATE French_100_CI_AS_SC přidáte JSON_VALUE – získáte jiný plán provádění dotazů.
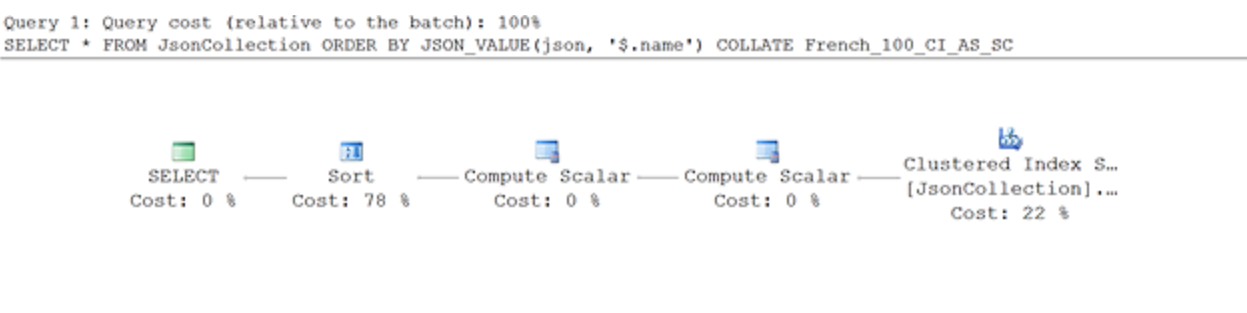
Vzhledem k tomu, že pořadí hodnot v indexu nevyhovuje francouzským pravidlům kolace, SQL Server nemůže index použít k seřazení výsledků. Proto přidá operátor třídění, který seřadí výsledky podle pravidel francouzské kolace.
Microsoft videa
Vizuální úvod k integrované podpoře JSON najdete v následujícím videu: