Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
Platí pro: SQL ServerAzure SQL DatabaseSpravovaná instance Azure SQLDatabáze SQL v Microsoft Fabric
Databázový stroj SQL Serveru zpracovává dotazy na různé architektury úložiště dat, jako jsou místní tabulky, dělené tabulky a tabulky distribuované napříč několika servery. Následující sekce popisují, jak Database Engine zpracovává dotazy a optimalizuje opakované použití dotazů prostřednictvím ukládání plánů provádění do mezipaměti.
Ukázky kódu v tomto článku používají ukázkovou databázi AdventureWorksDW2025, AdventureWorksLT2025 nebo AdventureWorks2025, kterou si můžete stáhnout z úložiště GitHub Azure Data SQL Samples Repository.
Režimy provádění
Databázový stroj systému SQL Server může zpracovávat Transact-SQL (T-SQL) příkazy pomocí dvou odlišných režimů zpracování:
- Výkon režimu řádku
- Spouštění v dávkovém režimu
Výkon režimu řádku
Spouštění v režimu po řádcích je metoda zpracování dotazů používaná u tabulek a indexů v řádkovém úložišti, kde jsou data uložena ve formátu řádků. Když je dotaz vykonán a přistupuje k datům v tabulkách a indexech rowstore, operátory stromu vykonání a podoperátory čtou každý požadovaný řádek napříč všemi sloupci specifikovanými v objektovém schématu. Z každého čteného řádku Database Engine následně získá sloupce potřebné pro výslednou sadu, na které odkazuje příkaz JOIN, predikát SELECT nebo predikát filtru.
Poznámka:
Spouštění v režimu řádků je velmi efektivní pro scénáře OLTP, ale může být méně efektivní při skenování velkého množství dat, například ve scénářích datových skladů.
Spouštění v dávkovém režimu
Spouštění v dávkovém režimu je metoda zpracování dotazů, která zpracovává více řádků současně (odtud termín dávka). Každý sloupec v dávce je uložen jako vektor v samostatné oblasti paměti, takže zpracování dávkovým způsobem je vektorové. Dávkové zpracování také využívá algoritmy optimalizované pro pokročilé instrukční sady a zvýšenou propustnost paměti v moderních procesorech.
Spouštění v dávkovém režimu bylo původně integrováno a optimalizováno pro formát úložiště columnstore. Počínaje verzí SQL Serveru 2019 (15.x) a v Azure SQL Database spouštění v dávkovém režimu nevyžaduje indexy columnstore. Další informace najdete v dávkovém režimu na úložišti řádků.
Dávkové zpracování zpracovává komprimovaná data, pokud je to možné, a eliminuje operátor Exchange, který používá řádkový režim. Výsledkem je lepší paralelismus a rychlejší výkon.
Když dotaz běží v dávkovém režimu a přistupuje k datům v indexech columnstore, operátory stromu vykonání a podřízené operátory čtou více řádků dohromady ve sloupcových segmentech. Database Engine čte pouze sloupce požadované pro výsledek, na které odkazuje příkaz JOIN, SELECT predikát nebo predikát filtru. Pro více informací o indexech columnstore viz Columnstore Index Architecture.
Poznámka:
Dávkové provádění je velmi efektivní pro scénáře datového skladování, kde lze číst a agregovat velké množství dat.
Zpracování příkazů SQL
Zpracování jednoho T-SQL příkazu je nejzákladnější způsob, jakým Database Engine vykonává T-SQL příkazy. Následující kroky ilustrují základní proces zpracováním jednoho příkazu SELECT, který odkazuje pouze na lokální základní tabulky (žádné pohledy nebo vzdálené tabulky).
Priorita logického operátoru
Když ve výroku použijete více než jeden logický operátor, NOT se vyhodnocuje nejdříve, pak AND a nakonec OR. Aritmetické a bitové operátory se zpracovávají před logickými operátory. Pro více informací viz Přednost operátora.
V následujícím příkladu se barevná podmínka vztahuje na produktový model 21, nikoli na produktový model 20, protože AND má přednost před OR.
SELECT ProductID,
       ProductModelID
FROM Production.Product
WHERE ProductModelID = 20
      OR ProductModelID = 21
         AND Color = 'Red';
GO
Používání závorek, i když nejsou povinné, může zlepšit čitelnost dotazů a snížit riziko chyby kvůli prioritě operátora. Následující příklad je čtivější než předchozí a má stejný význam.
SELECT ProductID,
       ProductModelID
FROM Production.Product
WHERE ProductModelID = 20
      OR (ProductModelID = 21
          AND Color = 'Red');
GO
Význam dotazu můžete změnit přidáním závorek k vynucení vyhodnocení OR jako prvního. Následující dotaz najde pouze produkty v modelech 20 a 21, které jsou červené.
SELECT ProductID,
       ProductModelID
FROM Production.Product
WHERE (ProductModelID = 20
       OR ProductModelID = 21)
      AND Color = 'Red';
GO
Optimalizace příkazů SELECT
Příkaz SELECT není procedurální. Neuvádí přesné kroky, které by databázový server měl použít k načtení požadovaných dat. Toto deklarativní chování znamená, že databázový server musí analyzovat příkaz i databázi, aby určil nejefektivnější způsob extrakce požadovaných dat. Tento proces se nazývá optimalizace plánu dotazů. Komponentou, která tuto úlohu vykonává, je optimalizátor dotazů. Vstup do optimalizátoru dotazů se skládá z dotazu, databázového schématu (definic objektů) a statistik objektů. Výstupem Query Optimizeru je plán provádění dotazů, někdy označovaný jako plán dotazu nebo plán provádění dotazu. Obsah plánu provedení je podrobněji popsán v ukládání plánu provedení do mezipaměti a jeho opětovném použití.
Následující diagram ilustruje vstupy a výstupy optimalizátoru dotazů během optimalizace jednoho SELECT příkazu:
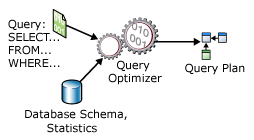
Příkaz definuje SELECT jen:
- Formát sady výsledků To je určeno většinou ve výběrovém seznamu. Jiné klauzule, například
ORDER BYaGROUP BYtaké ovlivňují konečnou formu sady výsledků. - Tabulky, které obsahují zdrojová data. Toto je určeno v klauzuli
FROM. - Jak tabulky logicky souvisejí pro účely
SELECTpříkazu. To je definováno ve spojovacím výrazu, který se může objevit v klauzuliWHEREnebo v klauzuliONnásledující poFROM. - Podmínky, které musí řádky ve zdrojových tabulkách splňovat, aby se kvalifikoval pro
SELECTpříkaz. Ty jsou uvedené vWHEREklauzulích aHAVINGklauzulích.
Plán provádění dotazu definuje:
Posloupnost, ve které jsou zdrojové tabulky přístupné.
Obvykle může databázový server přistupovat k základním tabulkám v mnoha pořadích a sestavit výslednou sadu. Pokud například
SELECTpříkaz odkazuje na tři tabulky, databázový server by mohl nejprve získat přístupTableA, použít data zTableAk extrahování odpovídajících řádků zTableB, a pak použít data zTableBk extrahování dat zTableC. Další sekvence, ve kterých má databázový server přístup k tabulkám, jsou:TableC,TableB,TableAnebo
TableB,TableA,TableCnebo
TableB,TableC,TableAnebo
TableC,TableA,TableBMetody použité k extrakci dat z každé tabulky.
Obecně platí, že pro přístup k datům v každé tabulce existují různé metody. Pokud je potřeba pouze několik řádků s konkrétními klíčovými hodnotami, databázový server může rychle vyhledat řádky nebo prohledat malý rozsah indexu. Pokud jsou všechny řádky v tabulce potřeba, databázový server může místo toho prohledat celou tabulku nebo index. Pokud jsou všechny řádky v tabulce potřeba, ale existuje index, jehož klíčové sloupce jsou v
ORDER BY, může provedení skenování indexu místo skenování tabulky ušetřit samostatné třídění výsledné množiny. Pokud je tabulka velmi malá, úplné procházení tabulky může být nejefektivnější metodou pro téměř všechny přístupy k tabulce.Metody používané k výpočtům a způsob filtrování, agregace a řazení dat z každé tabulky.
Při přístupu k datům z tabulek různé metody provádějí výpočty nad daty, například výpočet skalárních hodnot, a agregují a třídí data podle definice v textu dotazu. Například při použití klauzule
GROUP BYneboORDER BYa při filtrování dat, například při použití klauzuleWHEREneboHAVING.
Proces výběru jednoho plánu provádění z potenciálně mnoha možných plánů se označuje jako optimalizace. Optimalizátor dotazů je jednou z nejdůležitějších součástí databázového stroje. Zatímco optimalizátor dotazů používá určitou režii k analýze dotazu a výběru plánu, tato režie je obvykle několikanásobně ušetřena, když optimalizátor dotazů vybere efektivní plán provedení. Například dvě stavební společnosti mohou dostat identické projektové plány pro dům. Pokud jedna firma na začátku několik dní plánuje, jak dům postavit, a druhá začne stavět bez plánu, firma, která si najde čas na naplánování svého projektu, pravděpodobně dokončí stavbu jako první.
Query Optimizer je optimalizátor založený na nákladech. Každý možný plán provádění má přidružené náklady z hlediska množství použitých výpočetních prostředků. Optimalizátor dotazů musí analyzovat možné plány a zvolit plán s nejnižšími odhadovanými náklady. Některé složité příkazy mají tisíce možných plánů provedení. V těchto případech optimalizátor dotazů neanalyzuje všechny možné kombinace. Místo toho používá složité algoritmy k vyhledání plánu provádění, který má náklady přiměřeně blízko minimální možné náklady.
Optimalizátor dotazů nemusí nutně vybírat plán provedení s nejnižšími odhadovanými náklady. Najde plán s rozumnými odhadovanými náklady v dostupném čase vyhrazeném pro optimalizaci. Paralelní plán provádění může spotřebovat více zdrojů než sériový plán a zároveň zkrátit odhadovaný uplynulý čas.
SQL Server Query Optimizer spoléhá na statistiky při odhadu nákladů na zdroje různých metod pro extrakci informací z tabulky nebo indexu. Statistiky jsou uchovávány pro sloupce a indexy a obsahují informace o hustotě1 základních dat. Tyto informace uvádějí selektivnost hodnot v konkrétním indexu nebo sloupci. Například v tabulce představující auta má mnoho automobilů stejný výrobce, ale každé auto má jedinečné identifikační číslo vozidla (VIN). Index na VIN je selektivnější než index na výrobce, protože VIN má nižší hustotu než výrobce. Pokud statistiky indexu nejsou aktuální, optimalizátor dotazů nemusí být pro aktuální stav tabulky nejvhodnější volbou. Další informace o hustotách najdete v tématu Statistika.
1 Hustota definuje rozdělení jedinečných hodnot, které existují v datech, nebo průměrný počet duplicitních hodnot pro daný sloupec. S poklesem hustoty se selektivita hodnoty zvyšuje.
Optimalizátor dotazů je důležitý, protože umožňuje databázovému serveru dynamicky se přizpůsobovat měnícím se podmínkám v databázi bez nutnosti vstupu vývojáře nebo správce databáze. Tato funkce umožňuje vývojářům soustředit se na popis konečného výsledku dotazu. Mohou důvěřovat optimalizátoru dotazů, že pokaždé, když je optimalizován plán dotazu pro příkaz, vytvoří efektivní plán provádění pro aktuální stav databáze.
Poznámka:
SQL Server Management Studio má tři možnosti zobrazení plánů provádění:
- Odhadovaný plán provedení, což je zkompilovaný plán, jak je vytvořen optimalizátorem dotazů.
- Skutečný plán provedení, který je stejný jako zkompilovaný plán plus jeho kontext provádění. Tento kontext zahrnuje informace o běhu dostupné po dokončení vykonání, jako jsou varování při vykonání, nebo v novějších verzích Database Engine uplynulý čas a čas CPU použitý během vykonání.
- Statistiky živých dotazů, což je stejné jako zkompilovaný plán plus jeho kontext vykonání. Tento kontext zahrnuje informace o běhu během průběhu provádění a aktualizuje se každou sekundu. Informace o běhu zahrnují například skutečný počet řádků procházejících operátory.
Zpracování příkazu SELECT
Database Engine zpracovává jeden SELECT příkaz podle následujících kroků:
- Analyzátor prohledá příkaz a rozdělí
SELECTho do logických jednotek, jako jsou klíčová slova, výrazy, operátory a identifikátory. - Vytváří se strom dotazů, někdy označovaný jako sekvenční strom, který popisuje logické kroky potřebné k transformaci zdrojových dat do formátu požadovaného pro výslednou sadu.
- Optimalizátor dotazů analyzuje různé způsoby přístupu ke zdrojovým tabulkám. Vybere sérii kroků, která výsledky vrátí nejrychleji při využití menšího množství prostředků. Aktualizuje dotazovací strom, aby zaznamenal přesně tuto sérii kroků. Konečná optimalizovaná verze stromu dotazů se nazývá plán provádění.
- Relační modul začíná vykonávat plán. Při zpracování kroků, které vyžadují data ze základních tabulek, požaduje požadované sady řádků z úložného enginu.
- Relační modul zpracuje data vrácená z modulu úložiště do formátu definovaného pro sadu výsledků a vrátí sadu výsledků klientovi.
Skládání konstant a vyhodnocování výrazů
Databázový stroj vyhodnocuje některé konstantní výrazy na začátku, aby se zlepšil výkon dotazů. Tato optimalizační technika používaná Query Optimizerem si klade za cíl zjednodušit výrazy v době kompilace, nikoli za běhu. Zahrnuje vyhodnocení konstantních výrazů během kompilace dotazu, aby výsledný plán provádění byl efektivnější. Tento proces se nazývá konstantní skládání. Konstanta je T-SQL literál, například 3, 'ABC', '2025-12-31', 1.0e3, nebo 0x12345678. Podívejte se například na tento dotaz:
SELECT *
FROM Orders
WHERE OrderDate < DATEADD(day, 30 * 12, '2025-01-01');
Zde 30 * 12 je konstantní výraz. Database Engine tento výraz vyhodnotí během kompilace a může dotaz interně přepsat jako:
SELECT *
FROM Orders
WHERE OrderDate < DATEADD(day, 360, '2025-01-01');
Skládací výrazové konstrukty
Database Engine používá konstantní skládání s následujícími typy výrazů:
- Aritmetické výrazy, například
1 + 1a5 / 3 * 2, které obsahují pouze konstanty. - Logické výrazy, například
1 = 1a1 > 2 AND 3 > 4, které obsahují pouze konstanty. - Vestavěné funkce, které Database Engine považuje za skládatelné, včetně
CASTaCONVERT. Obecně platí, že vnitřní funkci lze vyhodnotit předem, pokud je funkcí pouze svých vstupů a nikoli jiných kontextových informací, jako jsouSETmožnosti, jazyková nastavení, databázová nastavení a šifrovací klíče. Nedeterministické funkce nejsou skládací. Deterministické předdefinované funkce jsou skládací, s některými výjimkami. - Deterministické metody uživatelsky definovaných typů CLR a deterministické skalární hodnotové CLR uživatelsky definované funkce. Další informace naleznete v tématu Konstantní posouvání pro CLR User-Defined Funkce a metody.
Poznámka:
Pro velké typy objektů se vytvoří výjimka. Pokud je výstupní typ procesu foldingu velký objektový typ (text, ntext, image, nvarchar(max), varchar(max), varbinary(max), json nebo xml), Database Engine výraz nefolduje.
Výrazy, které nelze zjednodušit
Všechny ostatní typy výrazů nejsou skládací. Zejména následující typy výrazů nejsou skládací:
- Nekonstantní výrazy, jako je výraz, jehož výsledek závisí na hodnotě sloupce.
- Výrazy, jejichž výsledky závisí na místní proměnné nebo parametru, například
@x. - Nedeterministické funkce.
- Uživatelsky definované T-SQL funkce.
- Výrazy, jejichž výsledky závisí na nastavení jazyka.
- Výrazy, jejichž výsledky závisí na
SETmožnostech. - Výrazy, jejichž výsledky závisí na možnostech konfigurace serveru.
Příklady skládacích a nepřesunutelných konstantních výrazů
Představte si následující dotaz:
USE AdventureWorks2025;
GO

SELECT *
FROM Sales.SalesOrderHeader AS s
     INNER JOIN Sales.SalesOrderDetail AS d
         ON s.SalesOrderID = d.SalesOrderID
WHERE TotalDue > 117.00 + 1000.00;
Pokud volba databáze PARAMETERIZATION není pro tento dotaz nastavena na FORCED, je výraz 117.00 + 1000.00 vyhodnocen a před kompilací dotazu nahrazen svým výsledkem 1117.00. Výhody tohoto konstantního vyhodnocování zahrnují:
- Výraz se nemusí opakovaně vyhodnocovat během provádění.
- Hodnota výrazu po vyhodnocení je použita optimalizátorem dotazů k odhadu velikosti výsledné množiny této části dotazu
TotalDue > 117.00 + 1000.00.
Na druhou stranu, pokud dbo.f je uživatelsky definovaná skalární funkce, výraz dbo.f(100) se nesbalí, protože Databázový stroj nesbaluje výrazy, které zahrnují uživatelem definované funkce, i když jsou deterministické. Pro více informací o parametrizaci viz Nucená parametrizace.
Vyhodnocení výrazu
Kromě toho některé výrazy, které nejsou konstantně složené, ale jejichž argumenty jsou známé v době kompilace, ať už jsou argumenty parametry nebo konstanty, jsou vyhodnocovány odhadovačem velikosti sady výsledků (kardinality), který je součástí optimalizátoru při optimalizaci.
Konkrétně se při kompilaci vyhodnocují následující předdefinované funkce a speciální operátory, pokud jsou známy všechny jejich vstupy: UPPER, , LOWERRTRIM, DATEPART( YY only ), GETDATECAST, a CONVERT. Následující operátory se také vyhodnocují v době kompilace, pokud jsou známy všechny jejich vstupy:
- Aritmetické operátory:
+,-,*,/, unární- - Logické operátory:
AND,OR,NOT - Srovnávací operátory:
<,>,<=,>=,<>,LIKE,IS NULL,IS NOT NULL
Při odhadu kardinality nejsou vyhodnoceny žádné jiné funkce ani operátory optimalizátoru dotazů.
Příklady vyhodnocení výrazů v čase kompilace
Zvažte tuto uloženou proceduru:
USE AdventureWorks2025;
GO

CREATE PROCEDURE MyProc
(
    @d DATETIME
)
AS
SELECT COUNT(*)
FROM Sales.SalesOrderHeader
WHERE OrderDate > @d + 1;
Během optimalizace SELECT příkazu v postupu se Optimalizátor dotazů pokusí vyhodnotit očekávanou kardinalitu sady výsledků pro podmínku OrderDate > @d + 1. Výraz @d + 1 není neustále složený, protože @d je parametr. V době optimalizace je však známa hodnota parametru. Tato hodnota umožňuje optimalizátoru dotazů přesně odhadnout velikost výsledné množiny, což mu pomáhá vybrat dobrý plán dotazů.
Nyní zvažte příklad podobný předchozímu, s tím rozdílem, že místní proměnná @d2 nahradí @d + 1 v dotazu a výraz se vyhodnocuje v SET příkazu místo v dotazu.
USE AdventureWorks2025;
GO

CREATE PROCEDURE MyProc2
(
    @d DATETIME
)
AS
BEGIN
    DECLARE @d2 AS DATETIME;
    SET @d2 = @d + 1;
    SELECT COUNT(*)
    FROM Sales.SalesOrderHeader
    WHERE OrderDate > @d2;
END
Když je příkaz SELECT v MyProc2 optimalizován v Database Engine, hodnota @d2 není známa. Proto optimalizátor dotazů používá výchozí odhad selektivity OrderDate > @d2 (v tomto případě 30 procent).
Zpracujte další příkazy
Základní kroky zpracování příkazu SELECT platí i pro další T-SQL příkazy, jako jsou INSERT, UPDATE, a DELETE. Příkazy UPDATE i DELETE musí cílit na sadu řádků pro úpravu nebo smazání. Proces identifikace těchto řádků je stejný proces, který slouží k identifikaci zdrojových řádků, které přispívají k sadě SELECT výsledků příkazu. Příkazy UPDATE i INSERT mohou obsahovat vložené příkazy SELECT, které poskytují datové hodnoty k aktualizaci nebo vložení.
Dokonce i příkazy Data Definition Language (DDL), jako CREATE PROCEDURE nebo ALTER TABLE, odpovídají sérii relačních operací na tabulkách systémového katalogu a někdy (například ALTER TABLE ADD COLUMN) proti datovým tabulkám.
Pracovní stoly
Relační engine může potřebovat vytvořit pracovní tabulku pro provedení logické operace specifikované v příkazu T-SQL. Pracovní tabulky jsou interní tabulky, které obsahují mezivýsledky. Pracovní tabulky se generují pro určité dotazy GROUP BY, ORDER BY nebo UNION. Například pokud klauzule ORDER BY odkazuje na sloupce, které nejsou pokryty žádným indexem, může relační engine potřebovat vytvořit pracovní tabulku, která seřadí výslednou množinu do požadovaného pořadí. Pracovní tabulky se také někdy používají jako zásobníky, které dočasně uchovávají výsledek provádění části dotazovacího plánu. Pracovní stoly se vytvářejí v tempdb a pak se automaticky odstraňují, když už nejsou potřeba.
Zobrazení rozlišení
Procesor dotazů Database Engine zpracovává indexované a neindexované pohledy odlišně:
- Databáze ukládá řádky indexovaného pohledu ve stejném formátu jako tabulka. Pokud optimalizátor dotazů použije indexované zobrazení v plánu dotazu, zachází s indexovaným zobrazením stejně jako se základní tabulkou.
- Uložená je pouze definice neindexovaného zobrazení, nikoli řádků zobrazení. Query Optimizer začleňuje logiku z definice pohledu do plánu provádění, který vytváří pro příkaz T-SQL odkazující na neindexovaný pohled.
Logika, kterou optimalizátor dotazů používá k rozhodnutí, kdy použít indexované zobrazení, je podobná logice, kterou používá k určení, kdy použít index na tabulce. Pokud data v indexovaném zobrazení pokrývají celý nebo část příkazu T-SQL a optimalizátor dotazů určí, že index na zobrazení je nízkonákladová přístupová cesta, vybere index bez ohledu na to, zda dotaz odkazuje na zobrazení podle jména.
Když příkaz T-SQL odkazuje na neindexované zobrazení, parser a optimalizátor dotazů analyzují zdroj jak příkazu T-SQL, tak zobrazení a poté je sloučí do jednoho plánu provedení. Příkaz T-SQL a pohled nemají oddělené plány.
Představte si například následující zobrazení:
USE AdventureWorks2025;
GO

CREATE VIEW EmployeeName AS
    SELECT h.BusinessEntityID,
           p.LastName,
           p.FirstName
    FROM HumanResources.Employee AS h
         INNER JOIN Person.Person AS p
             ON h.BusinessEntityID = p.BusinessEntityID;
GO
Na základě tohoto pohledu oba tyto T-SQL příkazy provádějí stejné operace na základních tabulkách a produkují stejné výsledky:
USE AdventureWorks2025;
GO

/* SELECT referencing the EmployeeName view. */
SELECT LastName AS EmployeeLastName,
       SalesOrderID,
       OrderDate
FROM Sales.SalesOrderHeader AS soh
     INNER JOIN dbo.EmployeeName AS EmpN
         ON (soh.SalesPersonID = EmpN.BusinessEntityID)
WHERE OrderDate > '20230531';

/* SELECT referencing the Person and Employee tables directly. */
SELECT LastName AS EmployeeLastName,
       SalesOrderID,
       OrderDate
FROM HumanResources.Employee AS e
     INNER JOIN Sales.SalesOrderHeader AS soh
         ON soh.SalesPersonID = e.BusinessEntityID
     INNER JOIN Person.Person AS p
         ON e.BusinessEntityID = p.BusinessEntityID
WHERE OrderDate > '20230531';
Funkce SQL Server Management Studio (SSMS) Showplan ukazuje, že relační engine vytváří stejný plán provádění pro obě tyto SELECT příkazy.
Použijte tipy při práci se zobrazeními
Pokud umístíte hinty na pohledy v dotazu, mohou kolidovat s jinými hinty, které se objeví, když se pohled rozšíří a přistupuje ke svým základním tabulkám. Když k tomuto konfliktu dojde, dotaz vrátí chybu. Představte si například následující zobrazení, které obsahuje indikaci tabulky v jeho definici.
USE AdventureWorks2025;
GO

CREATE VIEW Person.AddrState
WITH SCHEMABINDING AS
    SELECT a.AddressID,
           a.AddressLine1,
           s.StateProvinceCode,
           s.CountryRegionCode
    FROM Person.Address AS a WITH (NOLOCK), Person.StateProvince AS s
    WHERE a.StateProvinceID = s.StateProvinceID;
Teď předpokládejme, že zadáte tento dotaz:
SELECT AddressID,
       AddressLine1,
       StateProvinceCode,
       CountryRegionCode
FROM Person.AddrState WITH (SERIALIZABLE)
WHERE StateProvinceCode = 'WA';
Dotaz selže, protože nápověda SERIALIZABLE v zobrazení Person.AddrState se při rozbalení šíří do obou tabulek Person.Address a Person.StateProvince v tomto zobrazení. Rozšíření zobrazení však také odhalí nápovědu NOLOCKPerson.Address. Vzhledem k tomu, že dochází ke konfliktu nápověd SERIALIZABLE a NOLOCK, je výsledný dotaz nesprávný.
Nápovědy tabulky PAGLOCK, NOLOCK, ROWLOCK, TABLOCK a TABLOCKX jsou vzájemně v rozporu, stejně jako nápovědy tabulky HOLDLOCK, NOLOCK, READCOMMITTED, REPEATABLEREAD a SERIALIZABLE.
Nápověda se může šířit prostřednictvím úrovní vnořených zobrazení. Předpokládejme například, že dotaz použije nápovědu HOLDLOCK na zobrazení v1. Když v1 je rozšířený, zjistíte, že zobrazení v2 je součástí jeho definice. Definice v2 obsahuje nápovědu k NOLOCK jedné ze svých základních tabulek. Tato tabulka ale také dědí nápovědu HOLDLOCK z dotazu v zobrazení v1. Vzhledem k tomu, že nápovědy NOLOCK a HOLDLOCK jsou v konfliktu, dotaz selže.
Když použijete hint FORCE ORDER v dotazu, který obsahuje zobrazení, pozice zobrazení v uspořádaném konstruktu určuje pořadí spojení tabulek v rámci zobrazení. Například následující dotaz vybere ze tří tabulek a zobrazení:
SELECT * FROM Table1, Table2, View1, Table3
WHERE Table1.Col1 = Table2.Col1
    AND Table2.Col1 = View1.Col1
    AND View1.Col2 = Table3.Col2;
OPTION (FORCE ORDER);
A View1 je definován, jak je ukázáno v následujícím příkladu:
CREATE VIEW View1 AS
    SELECT Colx,
           Coly
    FROM TableA, TableB
    WHERE TableA.ColZ = TableB.Colz;
Pořadí spojení v plánu dotazu je Table1, Table2, TableA, TableB, . Table3
Řešení indexů v zobrazeních
Stejně jako u každého indexu si Database Engine vybírá použití indexovaného pohledu ve svém plánu dotazů pouze tehdy, pokud optimalizátor dotazů rozhodne, že je to pro něj výhodné.
Indexované pohledy můžete vytvářet v jakékoli edici Database Engine. V některých edicích Query Optimizer automaticky zohledňuje indexovaný pohled, zatímco v jiných edicích je potřeba použít tabulkovou nápovědu NOEXPAND. Automatické použití indexovaného pohledu pomocí optimalizátoru dotazů je podporováno pouze v konkrétních edicích SQL Server.
Poznámka:
Azure SQL Database a Azure SQL Managed Instance podporují automatické využívání indexovaných zobrazení bez nutnosti zadat NOEXPAND hint.
Optimalizátor dotazů používá indexovaný pohled, pokud jsou splněny následující podmínky:
- Tyto možnosti relace jsou nastavené na
ON:ANSI_NULLSANSI_PADDINGANSI_WARNINGSARITHABORTCONCAT_NULL_YIELDS_NULLQUOTED_IDENTIFIER
-
NUMERIC_ROUNDABORTvolba relace je nastavena naOFF. - Optimalizátor dotazů najde shodu mezi sloupci indexu zobrazení a prvky v dotazu, například:
- Predikáty podmínky vyhledávání v klauzuli
WHERE - Operace spojení
- Agregační funkce
-
GROUP BYklauzule - Odkazy na tabulky
- Predikáty podmínky vyhledávání v klauzuli
- Odhadované náklady na použití indexu jsou nejnižší ze všech mechanismů přístupu, které optimalizátor dotazů zvažuje.
- Každá tabulka odkazovaná v dotazu (buď přímo, nebo rozšířením zobrazení pro přístup k podkladovým tabulkám), která odpovídá odkazu na tabulku v indexovaném zobrazení, musí mít stejnou sadu tipů použitých v dotazu.
Poznámka:
READCOMMITTED a READCOMMITTEDLOCK nápovědy jsou vždy považovány za odlišné nápovědy v tomto kontextu, bez ohledu na aktuální úroveň izolace transakcí.
Kromě požadavků na SET možnosti a rady tabulek se jedná o stejná pravidla, která optimalizátor dotazů používá k určení, jestli index tabulky pokrývá dotaz. Pro použití indexovaného pohledu nemusíte v dotazu specifikovat nic dalšího.
Dotaz nemusí explicitně odkazovat na indexované zobrazení v FROM klauzuli, aby optimalizátor dotazů používal indexované zobrazení. Pokud dotaz obsahuje odkazy na sloupce v základních tabulkách, které se nacházejí také v indexovaném zobrazení, a Optimalizátor dotazů odhadne, že použití indexovaného zobrazení poskytuje nejnižší náklady na přístup, zvolí Optimalizátor dotazů indexované zobrazení podobně jako volí indexy základních tabulek, když nejsou přímo odkazovány v dotazu. Optimalizátor dotazů může zvolit zobrazení, pokud obsahuje sloupce, na které dotaz neodkazuje, pokud zobrazení nabízí nejnižší cenu pro pokrytí jednoho nebo více sloupců zadaných v dotazu.
Optimalizátor dotazů zpracovává indexované zobrazení odkazované v FROM klauzuli jako standardní zobrazení. Optimalizátor dotazů začleňuje definici zobrazení do dotazu na začátku procesu optimalizace. Potom se provede porovnávání indexovaného zobrazení. Indexované zobrazení lze použít v konečném plánu provádění vybraném optimalizátorem dotazů, nebo místo toho může plán materializovat potřebná data ze zobrazení přístupem k základním tabulkám, na které odkazuje zobrazení. Optimalizátor dotazů zvolí alternativu s nejnižšími náklady.
Použijte tipy s indexovanými zobrazeními
Pomocí nápovědy k dotazu EXPAND VIEWS můžete zabránit použití indexů zobrazení nebo můžete použít NOEXPAND nápovědu k tabulce a vynutit použití indexu pro indexované zobrazení zadané v FROM klauzuli dotazu. Měli byste však nechat optimalizátor dotazů dynamicky určit nejlepší metody přístupu, které se mají použít pro každý dotaz. Omezte využití EXPAND a NOEXPAND na konkrétní případy, kdy testování ukázalo, že výrazně zlepšují výkon.
Možnost
EXPAND VIEWSurčuje, že optimalizátor dotazů nepoužívá pro celý dotaz žádné indexy zobrazení.Když zadáte
NOEXPANDpro zobrazení, optimalizátor dotazů zvažuje použití jakýchkoli indexů definovaných v zobrazení.NOEXPANDurčená prostřednictvím volitelnéINDEX()klauzule přinutí Optimalizátor dotazů, aby použil určené indexy. Můžete specifikovatNOEXPANDpouze pro indexovaný pohled a nemůžete to specifikovat pro pohled, který není indexovaný. Automatické použití indexovaného pohledu optimalizátorem dotazů je podporováno pouze v konkrétních edicích SQL Server.Poznámka:
Azure SQL Database a Azure SQL Managed Instance podporují automatické využívání indexovaných zobrazení bez nutnosti zadat
NOEXPANDhint.
Pokud není v dotazu, který obsahuje zobrazení, zadán ani NOEXPAND ani EXPAND VIEWS, zobrazení se rozbalí pro přístup k podkladovým tabulkám. Pokud dotaz, který tvoří zobrazení, obsahuje nějaké tabulkové hinty, tyto hinty se aplikují na podkladové tabulky. (Tento proces je podrobněji vysvětlen v Rozlišení pohledu.) Pokud je sada nápověd v základních tabulkách pohledu navzájem identická, je dotaz způsobilý pro přiřazení k indexovanému pohledu. Většinou se tyto náznaky shodují, protože jsou přímo převzaty ze zobrazení. Pokud ale dotaz odkazuje na tabulky místo zobrazení a rady použité přímo na tyto tabulky nejsou stejné, pak takový dotaz nemá nárok na porovnávání s indexovaným zobrazením. Pokud se nápovědy INDEX, PAGLOCK, ROWLOCK, TABLOCKX, UPDLOCK nebo XLOCK po rozšíření zobrazení použijí na tabulky odkazované v dotazu, tento dotaz nemá nárok na porovnání s indexovaným zobrazením.
Pokud hint tabulky ve formě INDEX ( index_val [ ,...n] ) odkazuje na zobrazení v dotazu a nezadáte také hint NOEXPAND, bude hint indexu ignorován. Chcete-li určit použití určitého indexu, použijte NOEXPAND.
Obecně, když optimalizátor dotazů spáruje indexované zobrazení s dotazem, aplikuje všechny nápovědy specifikované na tabulkách nebo zobrazeních v dotazu přímo na indexované zobrazení. Pokud optimalizátor dotazů nepoužije indexované zobrazení, propaguje všechny hinty přímo do tabulek uvedených v zobrazení. Pro více informací viz Zobrazit rozlišení. Toto šíření se nevztahuje na nápovědy ke spojení. Použijí se pouze v původní pozici v dotazu. Optimalizátor dotazů nebere v úvahu hinty pro spojování při párování dotazů s indexovanými pohledy. Pokud plán dotazu používá indexované zobrazení, které odpovídá té části dotazu obsahující nápovědu ke spojení, tato nápověda se v plánu nepoužije.
V definicích indexovaných zobrazení nejsou povoleny tipy. Database Engine ignoruje nápovědy uvnitř definic indexovaných pohledů při jejich údržbě nebo při provádění dotazů používajících indexované pohledy.
Další informace najdete v tématu Pokyny pro tabulky.
Řešení potíží s distribuovanými rozdělenými zobrazeními
Procesor dotazů Database Engine optimalizuje výkon distribuovaných rozdělených pohledů. Nejdůležitějším aspektem výkonu distribuovaného rozděleného zobrazení je minimalizace množství dat přenášených mezi členskými servery.
Database Engine vytváří inteligentní, dynamické plány, které efektivně využívají distribuované dotazy k přístupu k datům z vzdálených členských tabulek:
- Procesor dotazů nejprve používá OLE DB k načtení definic omezení kontroly z každé členské tabulky. Tato metoda umožňuje procesoru dotazů mapovat rozložení klíčových hodnot mezi členskými tabulkami.
- Procesor dotazů porovnává rozsahy klíčů specifikované v klauzuli příkazu T-SQL
WHEREs mapou, která ukazuje, jak jsou řádky rozloženy v tabulkách členů. Procesor dotazů pak sestaví plán provádění dotazů, který využívá distribuované dotazy k získání pouze těch vzdálených řádků potřebných k dokončení T-SQL příkazu. Plán provedení je také navržen tak, že jakýkoli přístup ke vzdáleným členským tabulkám, ať už k datům nebo metadatům, je odložen, dokud nejsou informace potřeba.
Představte si například systém, ve kterém Customers je tabulka rozdělená mezi Server1 (CustomerID od 1 do 3299999), Server2 (CustomerID od 33 00000 do 6599999) a Server3 (CustomerID od 66000000 do 9999999).
Zvažte plán provádění vytvořený pro tento dotaz spuštěný na serveru Server1:
SELECT *
FROM CompanyData.dbo.Customers
WHERE CustomerID BETWEEN 3200000 AND 3400000;
Plán provádění pro tento dotaz extrahuje řádky s klíčovými hodnotami z 32000000 až 3299999 z místní členské tabulky a vydá distribuovaný dotaz pro načtení řádků s CustomerID klíčovými hodnotami z 33000000 až 3400000 ze serveru Server2.
Database Engine Query Processor může také zabudovat dynamickou logiku do plánů provádění dotazů pro příkazy T-SQL, u nichž nejsou klíčové hodnoty v době, kdy je třeba plán sestavit, známy. Představte si například tuto uloženou proceduru:
CREATE PROCEDURE GetCustomer
(
    @CustomerIDParameter INT
)
AS
SELECT *
FROM CompanyData.dbo.Customers
WHERE CustomerID = @CustomerIDParameter;
Database Engine nedokáže předpovědět, jakou klíčovou hodnotu parametr @CustomerIDParameter dodává pokaždé, když se procedura vykoná. Protože klíčovou hodnotu nelze předpovědět, procesor dotazů také nemůže předpovědět, ke které členské tabulce musí přistupovat. Pro řešení tohoto případu Database Engine vytváří plán vykonávání s podmíněnou logikou, nazývanou dynamické filtry, která určuje, ke které členské tabulce se přistupuje na základě hodnoty vstupního parametru. Za předpokladu, že uložená procedura GetCustomer byla vykonána na Server1, lze logiku plánu vykonání reprezentovat tak, jak je znázorněno v následujícím výstupu:
IF @CustomerIDParameter BETWEEN 1 and 3299999
   Retrieve row from local table CustomerData.dbo.Customer_33
ELSE IF @CustomerIDParameter BETWEEN 3300000 and 6599999
   Retrieve row from linked table Server2.CustomerData.dbo.Customer_66
ELSE IF @CustomerIDParameter BETWEEN 6600000 and 9999999
   Retrieve row from linked table Server3.CustomerData.dbo.Customer_99
Database Engine někdy vytváří tyto typy dynamických plánů vykonání i pro dotazy, které nejsou parametrizované. Optimalizátor dotazů může parametrizovat dotaz, aby bylo možné znovu použít plán provádění. Pokud optimalizátor dotazů parametrizuje dotaz odkazující na rozdělený pohled, již nemůže předpokládat, že požadované řádky pocházejí ze specifikované základní tabulky. Poté musí použít dynamické filtry v plánu provádění.
Uložená procedura a spuštění triggeru
Database Engine ukládá pouze zdroj pro uložené procedury a triggery. Při prvním spuštění uložené procedury nebo triggeru se zdroj zkompiluje do plánu provádění. Pokud se uložená procedura nebo spouštěč znovu spustí před tím, než je plán provádění odstraněn z paměti, relační stroj rozpozná existující plán a znovu ho použije. Pokud je plán vytěsněn z paměti, vytvoří se nový. Tento proces je podobný procesu, který Database Engine používá pro všechny T-SQL příkazy. Hlavní výkonnostní výhodou uložených procedur a spouštěčů v Database Engine oproti dávkám dynamického T-SQL je, že jejich T-SQL příkazy jsou vždy stejné. Relační modul je proto snadno odpovídá všem existujícím plánům provádění. Uložené procedury a plány aktivačních událostí se snadno znovu používají.
Plán provádění uložených procedur a aktivačních událostí se spouští odděleně od plánu provádění pro dávku volání uložené procedury nebo aktivaci triggeru. Toto rozdělení umožňuje větší opětovné využití uložených procedur a plánů spuštění spouštěčů.
Ukládání do mezipaměti a opakované použití plánu provádění
Database Engine využívá paměť k ukládání jak plánů provádění, tak datových vyrovnávacích pamětí. Procento paměti přidělené plánům vykonávání nebo datovým bufferům se dynamicky upravuje v závislosti na stavu systému. Část paměti, která ukládá plány vykonání, se nazývá plan cache.
Úložiště mezipaměti plánu
Mezipaměť plánu má pro všechny kompilované plány dvě úložiště:
- Cache úložiště Object Plans (OBJCP), určené pro plány týkající se trvale uložených objektů, jako jsou uložené procedury, funkce a triggery.
- Cache store SQL Plans (SQLCP), určený pro plány související s automaticky parametrizovanými, dynamickými nebo připravenými dotazy.
Následující dotaz poskytuje informace o využití paměti pro tato dvě úložiště mezipaměti:
SELECT *
FROM sys.dm_os_memory_clerks
WHERE name LIKE '%plans%';
Cache plánů obsahuje dvě další úložiště, která neukládají plány:
- Mezipaměťové úložiště Bound Trees (PHDR) pro datové struktury používané při kompilaci plánů pro pohledy, omezení a výchozí nastavení. Tyto struktury jsou známé jako bound trees nebo algebrizer trees.
- úložiště mezipaměti Extended Stored Procedures (XPROC) pro předdefinované systémové procedury, jako sp_executesql nebo xp_cmdshell. Tyto uložené procedury používají DLL místo T-SQL příkazů. Cacheovaná struktura obsahuje pouze název funkce a název DLL, kde je procedura implementována.
Součásti plánu spuštění
Plány spuštění Database Engine mají následující hlavní složky:
Zkompilovaný plán (nebo plán dotazů)
Plán dotazu vytvořený procesem kompilace je většinou znovu použitelnou datovou strukturou určenou pouze pro čtení, kterou používá libovolný počet uživatelů. Ukládá informace o:
Fyzické operátory, které implementují operaci popsanou logickými operátory.
Pořadí těchto operátorů, které určuje pořadí přístupu k datům, filtrování a agregaci.
Počet řádků, které odhadem procházejí přes operátory.
Poznámka:
Plán dotazu také uchovává informace o statistických objektech používaných pro odhad kardinality.
Jaké objekty podpory musí být vytvořeny, například pracovní tabulky nebo pracovní soubory v
tempdbsouboru .
Plán dotazu neukládá žádný uživatelský kontext ani informace o běhu. Database Engine určuje počet pracovních vláken pokaždé, když získá plán z plánové cache. Uložený paralelní plán může také běžet sériově.
Kontext spuštění
Každý uživatel, který aktuálně dotaz vykonává, má datovou strukturu, která uchovává data specifická pro jeho provedení, například hodnoty parametrů. Tato datová struktura se nazývá execution context. Datové struktury kontextu provádění se znovu používají, ale jejich obsah není znovu používán. Pokud jiný uživatel spustí stejný dotaz, datové struktury se znovu inicializují s kontextem nového uživatele.
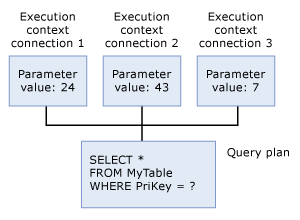
Znovu použít plány pro stejné příkazy
Když Database Engine vykoná jakýkoli T-SQL příkaz, nejprve projde plánovou cache, aby ověřil, zda již existuje plán spuštění pro stejný T-SQL příkaz. Příkaz T-SQL se kvalifikuje jako existující, pokud doslova odpovídá dříve vykonanému příkazu T-SQL s uloženým plánem, znak po znaku. Database Engine znovu použije jakýkoli existující plán, který najde, čímž šetří režijní zátěž spojenou s překompilací příkazu T-SQL. Pokud neexistuje žádný plán vykonání, Database Engine vygeneruje nový plán pro dotaz.
Poznámka:
Mezipaměť plánů neuchovává plány vykonání některých příkazů T-SQL, jako jsou příkazy hromadných operací běžící na rowstore nebo příkazy obsahující velké řetězcové literály. Tyto plány existují pouze během běhu dotazu.
Database Engine používá efektivní algoritmus k nalezení jakýchkoli existujících plánů provádění pro jakýkoli konkrétní příkaz T-SQL. Ve většině systémů jsou minimální zdroje, které tento sken spotřebuje, méně než zdroje, které se šetří opětovným použitím stávajících plánů místo kompilace každého T-SQL příkazu.
Algoritmy pro porovnání nových T-SQL příkazů s existujícími, nepoužívanými plány vykonání v plánové cache vyžadují, aby všechny objektové reference byly plně kvalifikované. Například předpokládejme, že Person je výchozí schéma pro uživatele, který provádí následující SELECT příkazy. I když tento příklad nevyžaduje, abyste tabulku Person plně kvalifikovali pro vykonání, znamená to, že druhý příkaz neodpovídá existujícímu plánu provádění, ale třetí příkaz odpovídá:
USE AdventureWorks2025;
GO

SELECT *
FROM Person;
GO

SELECT *
FROM Person.Person;
GO

SELECT *
FROM Person.Person;
GO
Změna kterékoli z následujících SET možností pro dané provedení ovlivňuje možnost opětovného použití plánů, protože Database Engine provádí constant folding a tyto možnosti ovlivňují výsledky těchto výrazů:
ANSI_DEFAULTSANSI_NULL_DFLT_OFFANSI_NULL_DFLT_ONANSI_NULLSANSI_PADDINGANSI_WARNINGSARITHABORTCONCAT_NULL_YIELDS_NULLDATEFIRSTDATEFORMATFORCEPLANLANGUAGENO_BROWSETABLENUMERIC_ROUNDABORTQUOTED_IDENTIFIER
Ukládání více plánů do mezipaměti pro stejný dotaz
Dotazy a plány provádění jsou v databázovém stroji jednoznačně identifikovatelné, podobně jako otisk prstu:
- Hodnota hash plánu dotazu je binární hodnota hash vypočítaná v plánu provádění pro daný dotaz a slouží k jedinečné identifikaci podobných plánů provádění.
- Dotazovací hash je binární hash hodnota vypočítaná na T-SQL textu dotazu a používá se k jednoznačné identifikaci dotazů.
Zkompilovaný plán lze získat z plánové cache pomocí handle plánu. Tento přechodný identifikátor zůstává konstantní pouze po dobu pobytu plánu v cache. Identifikátor plánu je hodnota hash odvozená ze zkompilovaného plánu celé dávky. Popisovač plánu pro kompilovaný plán zůstává stejný i v případě, že jeden nebo více příkazů v dávce jsou znovu kompilovány.
Poznámka:
Pokud zkompilujete plán pro dávku místo jednoho příkazu, můžete použít popisovač plánu a offsety příkazů k získání plánu pro jednotlivé příkazy v dávce.
DMV sys.dm_exec_requests obsahuje sloupce statement_start_offset a statement_end_offset pro každý záznam. Tyto sloupce odkazují na právě vykonávaný příkaz právě spuštěné dávky nebo trvalého objektu. Další informace viz sys.dm_exec_requests.
sys.dm_exec_query_stats DMV také obsahuje tyto sloupce pro každý záznam. Tyto sloupce označují pozici příkazu v rámci dávky nebo trvale uloženého objektu. Další informace viz sys.dm_exec_query_stats.
Skutečný text dávky T-SQL je uložen v samostatném paměťovém prostoru odděleném od plánové cache, nazývaném SQL Manager cache (SQLMGR). Text T-SQL pro zkompilovaný plán můžete získat z mezipaměti SQL Manageru pomocí identifikátoru SQL. Tento dočasný identifikátor zůstává konstantní pouze tehdy, dokud alespoň jeden plán, který na něj odkazuje, zůstává v plánové cache. SQL handle je hash hodnota odvozená z celého dávkového textu a je zaručeně unikátní pro každou dávku.
Poznámka:
Stejně jako u zkompilovaného plánu je text T-SQL uložen pro každou dávku, včetně komentářů. SQL handle obsahuje MD5 hash celého dávkového textu a je zaručeně unikátní pro každou dávku.
Následující dotaz poskytuje informace o využití paměti pro cache SQL Manageru:
SELECT *
FROM sys.dm_os_memory_objects
WHERE type = 'MEMOBJ_SQLMGR';
Existuje vztah jeden k více mezi SQL handlem a handly plánu. Tato podmínka nastává, když je klíč cache pro zkompilované plány odlišný. Tento rozdíl může nastat kvůli změně možností SET mezi dvěma provedeními stejné dávky.
Zvažte následující uloženou proceduru:
USE WideWorldImporters;
GO

CREATE PROCEDURE usp_SalesByCustomer
(
    @CID INT
)
AS
SELECT *
FROM Sales.Customers
WHERE CustomerID = @CID;
GO

SET ANSI_DEFAULTS ON;
GO

EXECUTE usp_SalesByCustomer 10;
GO
Ověřte, co najdete v mezipaměti plánů, pomocí následujícího dotazu:
SELECT cp.memory_object_address,
       cp.objtype,
       refcounts,
       usecounts,
       qs.query_plan_hash,
       qs.query_hash,
       qs.plan_handle,
       qs.sql_handle
FROM sys.dm_exec_cached_plans AS cp
CROSS APPLY sys.dm_exec_sql_text(cp.plan_handle)
CROSS APPLY sys.dm_exec_query_plan(cp.plan_handle)
     INNER JOIN sys.dm_exec_query_stats AS qs
         ON qs.plan_handle = cp.plan_handle
WHERE text LIKE '%usp_SalesByCustomer%';
GO
Tady je soubor výsledků.
memory_object_address    objtype   refcounts   usecounts   query_plan_hash    query_hash
---------------------   -------  ---------  ---------  ------------------ ------------------
0x000001CC6C534060        Proc      2           1           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D

plan_handle
------------------------------------------------------------------------------------------
0x0500130095555D02D022F111CD01000001000000000000000000000000000000000000000000000000000000

sql_handle
------------------------------------------------------------------------------------------
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
Nyní spusťte uloženou proceduru s jiným parametrem, bez dalších změn v kontextu vykonání:
EXECUTE usp_SalesByCustomer 8;
GO
Znovu ověřte, co najdete v mezipaměti plánu. Tady je soubor výsledků.
memory_object_address    objtype   refcounts   usecounts   query_plan_hash    query_hash
---------------------   -------  ---------  ---------  ------------------ ------------------
0x000001CC6C534060        Proc      2           2           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D

plan_handle
------------------------------------------------------------------------------------------
0x0500130095555D02D022F111CD01000001000000000000000000000000000000000000000000000000000000

sql_handle
------------------------------------------------------------------------------------------
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
Všimněte si, že usecounts hodnota se zvyšuje na 2, což znamená, že stejný cacheovaný plán je znovu použit as-is, protože datové struktury kontextu vykonání jsou znovu použity. Nyní změňte možnost SET ANSI_DEFAULTS a spusťte uloženou proceduru se stejným parametrem.
SET ANSI_DEFAULTS OFF;
GO

EXECUTE usp_SalesByCustomer 8;
GO
Znovu ověřte, co najdete v mezipaměti plánu. Tady je soubor výsledků.
memory_object_address    objtype   refcounts   usecounts   query_plan_hash    query_hash
---------------------   -------  ---------  ---------  ------------------ ------------------
0x000001CD01DEC060        Proc      2           1           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D
0x000001CC6C534060        Proc      2           2           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D

plan_handle
------------------------------------------------------------------------------------------
0x0500130095555D02B031F111CD01000001000000000000000000000000000000000000000000000000000000
0x0500130095555D02D022F111CD01000001000000000000000000000000000000000000000000000000000000

sql_handle
------------------------------------------------------------------------------------------
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
Všimněte si, že ve výstupu sys.dm_exec_cached_plans DMV jsou teď dvě položky:
- Sloupec
usecountsukazuje hodnotu1v prvním záznamu. Tato hodnota představuje plán provedený najednou sSET ANSI_DEFAULTS OFF. - Sloupec
usecountsukazuje hodnotu2ve druhém záznamu. Tato hodnota představuje plán spuštěný pomocíSET ANSI_DEFAULTS ON, protože byl proveden dvakrát. - Jiný
memory_object_addressodkazuje na jiný záznam plánu provádění v mezipaměti plánu. Hodnotasql_handleje však stejná pro obě položky, protože se vztahují ke stejné dávce.- Provádění s
ANSI_DEFAULTSnastaveným naOFFmá novéplan_handle, a je dostupné pro opětovné použití pro volání se stejnou sadouSETmožností. Nový identifikátor plánu je nezbytný, protože kontext provádění byl znovu inicializován kvůli změněným možnostemSET. Tato změna však nespustí překompilaci: oba záznamy odkazují na stejný plán a dotaz, jak dokládají stejné hodnotyquery_plan_hashaquery_hash.
- Provádění s
Tato situace znamená, že máte v cache dva záznamy plánu odpovídající stejné dávce. Zdůrazňuje důležitost zajištění, že možnosti ovlivňující cache plánu pro SET jsou stejné, když jsou stejné dotazy opakovaně vykonávány. Tento přístup optimalizuje opětovné využití plánu a udržuje velikost cache plánu na požadovaném minimu.
Návod
Běžnou nástrahou je, že různé klienty můžou mít pro možnosti různé výchozí hodnoty SET . Například připojení vytvořené přes SQL Server Management Studio automaticky nastaví QUOTED_IDENTIFIER na ON, zatímco SQLCMD nastaví QUOTED_IDENTIFIER na OFF. Provádění stejných dotazů z těchto dvou klientských aplikací vede k více plánům (jak bylo popsáno v předchozím příkladu).
Odebrat plány provádění z mezipaměti plánu
Plány provedení zůstávají v plánové cache, dokud je dostatek paměti na jejich uložení. Když existuje tlak na paměť, Databázový stroj systému SQL Server používá přístup založený na nákladech k rozhodnutí, které plány spuštění odstranit z cache plánu. Pro rozhodnutí založené na nákladech Databázový stroj systému SQL Server zvyšuje a snižuje aktuální nákladovou proměnnou pro každý plán provedení na základě následujících faktorů.
Když uživatelský proces vloží do cache plán spuštění, uživatelský proces nastaví aktuální náklady rovné původním nákladům na kompilaci dotazu. U ad hoc plánů provádění uživatelský proces nastaví aktuální náklady na nulu. Poté pokaždé, když se uživatelský proces odkazuje na plán spuštění, resetuje aktuální náklady na původní náklady na kompilaci. U ad hoc plánů provádění uživatelský proces zvyšuje aktuální náklad. Pro všechny plány je maximální hodnota aktuálních nákladů původní náklady kompilace.
Když existuje tlak na paměť, Databázový stroj systému SQL Server odstraní plány provádění z cache plánů. Chcete-li zjistit, které plány odebrat, databázový stroj SQL Serveru opakovaně kontroluje stav každého plánu provádění a odebere plány, když jejich aktuální náklady jsou nulové. Plán provedení s nulovými aktuálními náklady není automaticky odstraněn, pokud existuje tlak na paměť. Je odstraněn pouze tehdy, když Databázový stroj systému SQL Server plán prozkoumá a aktuální náklad je nulový. Při zkoumání prováděcího plánu posunuje databázový stroj SQL Serveru aktuální náklady směrem k nule tím, že snižuje aktuální náklady, pokud plán není momentálně používán dotazem.
Databázový stroj systému SQL Server opakovaně kontroluje plány provádění, dokud neodstraní dostatek plánů k uspokojení požadavků na paměť. Při zatížení paměti se může náklady plánu vykonání více než jednou zvýšit i snížit. Když tlak na paměť přestane existovat, Databázový stroj systému SQL Server přestane snižovat aktuální hodnotu nákladů na nevyužité plány provádění. Všechny plány provádění zůstávají v mezipaměti plánů, i když jejich náklady jsou nulové.
Databázový stroj SQL Serveru využívá monitor prostředků a uživatelská pracovní vlákna k uvolnění paměti z mezipaměti plánu v reakci na zatížení paměti. Monitor zdrojů a uživatelská pracovní vlákna mohou současně zkoumat plány ke snížení aktuálních nákladů u každého nevyužitého prováděcího plánu. Monitor prostředků odebere plány provádění z mezipaměti plánů, pokud dochází ke globálnímu tlaku na paměť. Uvolní paměť pro prosazení zásad týkajících se systémové paměti, paměti procesu, paměti fondu prostředků a maximální velikosti všech mezipamětí.
Maximální velikost všech mezipamětí je funkce velikosti fondu vyrovnávací paměti a nesmí překročit maximální paměť serveru. Pro více informací o konfiguraci maximální serverové paměti viz max server memory nastavení v sp_configure.
Pracovní vlákna uživatele odeberou plány spuštění z mezipaměti plánu, pokud existuje zatížení paměti v jedné mezipaměti. Vynucují zásady pro maximální velikost jedné mezipaměti a maximální počet položek jedné mezipaměti.
Následující příklady ukazují, které plány provádění se odeberou z mezipaměti plánu:
- Na plán provádění se často odkazuje, takže náklady nikdy nepřejdou na nulu. Plán zůstává v mezipaměti plánů a není odstraněn, ledaže nastane tlak na paměť a aktuální náklady jsou nulové.
- Vloží se ad hoc plán provádění, na který se znovu neodkazuje, než existuje tlak na paměť. Protože ad hoc plány jsou inicializovány s aktuálními náklady nula, Databázový stroj systému SQL Server při zkoumání plánu provádění vidí nulové aktuální náklady a odstraní plán z mezipaměti plánů. Ad hoc plán vykonání zůstává v plánové cache s nulovými aktuálními náklady, pokud není tlak na paměť.
Pokud chcete ručně odebrat jeden plán nebo všechny plány z mezipaměti, použijte DBCC FREEPROCCACHE. Můžete také použít DBCC FREESYSTEMCACHE k vymazání jakékoli cache, včetně plán cache. SQL Server 2016 (13.x) a novější verze, použijte ALTER DATABASE SCOPED CONFIGURATION CLEAR PROCEDURE_CACHE k vymazání mezipaměti procedur (plánu) pro databázi v aktuálním kontextu.
Změna některých konfiguračních nastavení prostřednictvím sp_configure a reconfigure také způsobuje odstranění plánů z cache plánů. Seznam těchto nastavení konfigurace najdete v části Poznámky článku DBCC FREEPROCCACHE . Když provedete tuto změnu konfigurace, do chybového logu se zaznamená následující informační zpráva:
SQL Server has encountered %d occurrence(s) of cachestore flush for the '%s' cachestore (part of plan cache) due to some database maintenance or reconfigure operations.
Rekompilovat plány provádění
Některé změny v databázi mohou učinit plán provádění neefektivním nebo neplatným. Database Engine tyto změny detekuje a označí plán jako neplatný. Je třeba znovu zkompilovat nový plán pro příští připojení, které vykoná dotaz. Podmínky, které plán zneplatňují, zahrnují:
- Změny v tabulce nebo pohledu, na které odkazuje dotaz (
ALTER TABLEaALTER VIEW). - Změny v jedné proceduře, které by odstranily všechny plány pro tuto proceduru z cache (
ALTER PROCEDURE). - Změny všech indexů používaných plánem provádění
- Aktualizace statistik používaných plánem provádění, ať už explicitně generované příkazem, například
UPDATE STATISTICS, nebo generované automaticky. - Odstranění indexu používaného v plánu provádění
- Explicitní volání
sp_recompile. - Velký počet změn klíčů (vygenerovaných
INSERTjinými uživateli neboDELETEpříkazy od jiných uživatelů, kteří upravují tabulku odkazovanou dotazem). - U tabulek s aktivačními událostmi, pokud se výrazně zvětší počet řádků v tabulkách vložených nebo odstraněných.
- Provádění uložené procedury pomocí možnosti
WITH RECOMPILE.
Většina překompilací je nutná buď kvůli správnosti příkazů, nebo k získání potenciálně rychlejšího plánu provádění dotazů.
Když příkaz v rámci dávky spustí rekompilaci, překompiluje se pouze tento příkaz, nikoli celá dávka. Toto pravidlo platí bez ohledu na to, zda je dávka odeslána prostřednictvím uložené procedury, spouštěče, ad hoc dávky nebo připraveného příkazu.
Rekompilace na úrovni příkazů zlepšuje výkon, protože ve většině případů malý počet příkazů způsobuje rekompilace a s nimi spojenou režii z hlediska času CPU a zámků. Tyto sankce se proto neuplatní u ostatních příkazů v dávce, které není třeba znovu kompilovat.
sql_statement_recompile Rozšířená událost (XEvent) hlásí rekompilace na úrovni příkazů. K této události XEvent dochází v případě, že jakýkoli druh dávky vyžaduje rekompilace na úrovni příkazu. Tento požadavek zahrnuje uložené procedury, spouštěče, ad hoc dávky a dotazy. Dávky lze odesílat přes několik rozhraní, včetně sp_executesql, dynamického SQL, metod Prepare nebo metod Execute.
recompile_cause Sloupec sql_statement_recompile XEvent obsahuje celočíselné kód, který označuje důvod rekompilace. Následující seznam obsahuje možné důvody:
- Změněné možnosti kurzoru
- Odložená kompilace
-
FOR BROWSEoprávnění změněno -
OPTION (RECOMPILE)požadovaný - Vyprázdněný parametrizovaný plán
- Došlo ke změně rozděleného zobrazení
- Plán ovlivňující změněnou verzi databáze
- Změna prostředí oznámení dotazu
- V úložišti dotazů chybí plán.
- Selhání vynucení plánu v Query Store
- Změna zásad vynucování plánu pro úložiště dotazů
- Došlo ke změně vzdálené sady řádků
- Změněné schéma
-
SETzměna možnosti - Statistika se změnila
- Dočasná tabulka se změnila.
Poznámka:
Když nastavíte databázovou AUTO_UPDATE_STATISTICS možnost na ON, dotazy se znovu kompilují, když jsou zaměřeny na tabulky nebo indexované pohledy, jejichž statistiky jsou aktualizovány nebo jejichž kardinalita se od posledního spuštění výrazně změnila. Toto chování platí pro standardní uživatelem definované tabulky, dočasné tabulky a vložené a odstraněné tabulky vytvořené triggery DML.
Nastavení AUTO_UPDATE_STATISTICS na OFF tyto rekompilace zastaví, ale zastaralé statistiky obvykle zhoršují výkon dotazů více než samotné rekompilace. Pro více informací viz možnost AUTO_UPDATE_STATISTICS . Vložené a odstraněné tabulky triggerů DML INSTEAD OF jsou vytvořeny v tempdb, takže se řídí nastavením AUTO_UPDATE_STATISTICS objektu tempdb.
Používejte explicitní parametry pro opětovné použití plánu
Používání parametrů, včetně pojmenovaných parametrů v aplikacích ADO.NET a markerů parametrů v aplikacích OLE DB a ODBC, může zvýšit opětovné využití plánů vykonání.
Výstraha
Vždy ověřte vstup uživatele podle typu testování, délky, formátu a rozsahu. Další informace naleznete v tématu SQL injekce.
Jediným rozdílem mezi následujícími dvěma SELECT příkazy jsou hodnoty, které se porovnávají v WHERE klauzuli:
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 1;
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 4;
Jediným rozdílem mezi plány provádění těchto dotazů je hodnota uložená pro porovnání se sloupcem ProductSubcategoryID . Cílem je, aby Database Engine vždy rozpoznal, že příkazy generují v podstatě stejný plán, a plány znovu použil, ale Database Engine tuto podobnost v složitých T-SQL příkazech někdy nezaznamená.
Oddělení konstant od příkazu T-SQL pomocí parametrů pomáhá relačnímu enginu rozpoznat duplicitní plány. Používejte parametry následujícími způsoby:
V T-SQL použijte
sp_executesql:DECLARE @MyIntParm AS INT; SET @MyIntParm = 1; EXECUTE sp_executesql N'SELECT * FROM AdventureWorks2025.Production.Product WHERE ProductSubcategoryID = @Parm', N'@Parm INT', @MyIntParm;Tato metoda je doporučena pro T-SQL skripty, uložené procedury nebo triggery, které dynamicky generují SQL příkazy.
ADO.NET s
SqlClientpoužívá pojmenované parametry, například@Parm. OLE DB a ODBC používají zástupné parametry. Značky parametrů jsou otazníky (?), které nahrazují konstantu v SQL příkazu a jsou vázány na programovou proměnnou. V aplikaci ODBC byste například udělali toto:Použijte
SQLBindParameterk navázání celočíselné proměnné na první místo parametrů v příkazu SQL.Vložte celočíselnou hodnotu do proměnné.
Proveďte příkaz SQL s uvedením značky parametru (
?):SQLExecDirect(hstmt, "SELECT * FROM AdventureWorks2025.Production.Product WHERE ProductSubcategoryID = ?", SQL_NTS);
Zprostředkovatel OLE DB pro SQL Server Native Client a ovladač ODBC pro SQL Server Native Client používají
sp_executesqlk odesílání příkazů do SQL Server, když jsou v aplikacích použity markery parametrů.Vytvářejte uložené procedury, které jsou navrženy tak, aby používaly parametry.
Pokud explicitně nezahrnete parametry do návrhu svých aplikací, můžete se také spolehnout na Query Optimizer, který automaticky parametrizuje určité dotazy pomocí výchozího chování jednoduché parametrizace. Alternativně můžete vynutit optimalizátor dotazů, aby zvážil parametrizaci všech dotazů v databázi nastavením PARAMETERIZATION možnosti ALTER DATABASE příkazu na FORCED.
Jednoduchá parametrizace
V Database Engine se použitím parametrů nebo zástupných symbolů parametrů v T-SQL příkazech zvyšuje schopnost relačního enginu sladit nové T-SQL příkazy s existujícími, dříve zkompilovanými plány vykonání.
Výstraha
Vždy ověřte vstup uživatele podle typu testování, délky, formátu a rozsahu. Další informace naleznete v tématu SQL injekce.
Pokud je T-SQL příkaz vykonán bez parametrů, Database Engine jej interně parametrizuje, aby zvýšil možnost jeho porovnání s existujícím plánem vykonání. Tento proces se nazývá parametrizace. Výchozí je jednoduchá parametrizace a můžete povolit nucenou parametrizaci databáze.
Zvažte tento výrok:
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 1;
Hodnotu 1 na konci příkazu můžete zadat jako parametr. Relační engine sestaví plán provedení pro tuto dávku, jako byste místo hodnoty 1 zadali parametr. Díky této jednoduché parametrizaci Database Engine rozpozná, že následující dva příkazy generují v podstatě stejný plán vykonání a znovu použije první plán pro druhé příkaz:
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 1;
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 4;
Při zpracování složitých T-SQL příkazů může mít relační engine potíže určit, které výrazy lze parametrizovat. Pro zvýšení schopnosti relačního enginu sladit složité T-SQL příkazy s existujícími, nepoužívanými plány vykonání explicitně specifikujte parametry pomocí buď sp_executesql, nebo značek parametrů.
Poznámka:
Když použijete aritmetické operátory +, -, *, / nebo % k implicitnímu nebo explicitnímu převodu konstantních hodnot int, smallint, tinyint nebo bigint na datové typy float, real, decimal nebo numeric, modul Database Engine použije specifická pravidla pro výpočet typu a přesnosti výsledků výrazu. Tato pravidla se liší v závislosti na tom, zda je dotaz parametrizovaný. Podobné výrazy v dotazech proto můžou v některých případech vést k různým výsledkům.
Při výchozím chování jednoduché parametrizace parametrizuje Database Engine relativně malou třídu dotazů. Můžete však určit, že všechny dotazy v databázi budou parametrizovány, s výhradou určitých omezení, nastavením možnosti PARAMETERIZATION příkazu na ALTER DATABASE. Tato změna může zlepšit výkon databází, které zažívají velké množství souběžných dotazů, tím, že snižuje frekvenci kompilací dotazů.
Alternativně můžete určit, že jeden dotaz a všechny ostatní, které jsou syntakticky ekvivalentní, ale liší se pouze v jejich hodnotách parametrů, budou parametrizovány.
Návod
Když používáte řešení pro objektově relační mapování (ORM), jako je Entity Framework (EF), aplikační dotazy jako manuální LINQ dotazy nebo některé surové SQL dotazy nemusí být parametrizovány. Toto omezení ovlivňuje opětovné použití plánů a možnost sledovat dotazy v Query Store. Další informace naleznete v části Ukládání dotazů EF do mezipaměti a parametrizace a EF dotazy v surovém SQL.
Vynucená parametrizace
Výchozí jednoduché parametrizační chování Database Engine můžete přepsat tím, že určíte, že všechny příkazy SELECT, INSERT, UPDATE a DELETE v databázi budou parametrizovány, s určitými omezeními. Povolte nucenou parametrizaci nastavením možnosti PARAMETERIZATION na FORCED v příkazu ALTER DATABASE. Vynucené parametrizace může zlepšit výkon určitých databází snížením frekvence kompilací dotazů a rekompilacemi. Databáze, které mohou těžit z vynucené parametrizace, jsou obecně ty, které mají vysoké objemy souběžných dotazů ze zdrojů, jako jsou aplikace typu point-of-sale.
Když nastavíte možnost PARAMETERIZATION na FORCED, jakákoli literální hodnota, která se objeví v příkazu INSERT, UPDATE, DELETE nebo SELECT, zadaném v jakékoli formě, je během kompilace dotazu převedena na parametr. Výjimky jsou literály, které se zobrazují v následujících konstruktorech dotazu:
-
INSERT...EXECUTEvýroky. - Příkazy uvnitř těchto uložených procedur, triggerů nebo uživatelsky definovaných funkcí. Database Engine již pro tyto rutiny znovu používá plány dotazů.
- Připravené příkazy, které jsou již parametrizovány v klientské aplikaci.
- Příkazy, které obsahují volání metody XQuery, kde se metoda zobrazí v kontextu, kde jeho argumenty by obvykle byly parametrizovány, například
WHEREklauzule. Pokud se metoda zobrazí v kontextu, kde jeho argumenty nebudou parametrizovány, zbytek příkazu je parametrizován. - Příkazy uvnitř kurzoru T-SQL. (
SELECTpříkazy uvnitř kurzorů rozhraní API jsou parametrizovány.) - Zastaralé konstrukce dotazů.
- Jakýkoli příkaz, který běží v kontextu
ANSI_PADDINGneboANSI_NULLSnastaveného naOFF. - Příkazy, které obsahují více než 2 097 literálů, které mají nárok na parametrizaci.
- Příkazy, které odkazují na proměnné, například
WHERE T.col2 >= @bb. - Výrazy, které obsahují dotazovací nápovědu
RECOMPILE. - Příkazy, které obsahují klauzuli
COMPUTE. - Příkazy, které obsahují klauzuli
WHERE CURRENT OF.
Následující dotazovací klauzule nejsou parametrizovány. V těchto případech nejsou parametrizovány pouze klauzule. Jiné klauzule v rámci stejného dotazu mohou být způsobilé pro vynucené parametrizace.
-
<select_list>jakéhokoliSELECTpříkazu. Tento seznam zahrnujeSELECTseznamy poddotazů aSELECTseznamy v příkazechINSERT. - Poddotazové výrazy
SELECT, které se objeví uvnitřIFvýrazu. - Klauzule
TOP,TABLESAMPLE,HAVING,GROUP BY,ORDER BY,OUTPUT...INTOneboFOR XMLdotazu. - Argumenty, buď přímé, nebo jako dílčí výrazy, k
OPENROWSET,OPENQUERY,OPENDATASOURCE,OPENXML, nebo jakýkoliFULLTEXToperátor. - Argumenty vzoru a escape_character v klauzuli
LIKE. - Argument stylu klauzule
CONVERT. - Celočíselné konstanty uvnitř
IDENTITYklauzule. - Konstanty zadané pomocí syntaxe rozšíření ODBC
- Výrazy, které lze konstantně vyhodnotit a které jsou argumenty operátorů
+,-,*,/a%. Při zvažování způsobilosti pro nucenou parametrizaci považuje Database Engine výraz za konstantně foldovatelný, pokud platí některá z následujících podmínek:- Ve výrazu se nezobrazují žádné sloupce, proměnné ani poddotazy.
- Výraz obsahuje klauzuli
CASE.
- Argumenty klauzulí query hint, včetně argumentu number_of_rows klauzule query hint
FAST, argumentu number_of_processors klauzule query hintMAXDOPa argumentu number klauzule query hintMAXRECURSION.
Parametrizace probíhá na úrovni jednotlivých T-SQL příkazů. Jinými slovy, jednotlivé výroky v dávce jsou parametrizovány. Po kompilaci se parametrizovaný dotaz vykoná v kontextu dávky, ve které byl původně odeslán. Pokud je plán provedení dotazu uložen v mezipaměti, můžete zjistit, zda byl dotaz parametrizován, odkazem na sloupec sql dynamického zobrazení pro správu sys.syscacheobjects. Pokud je dotaz parametrizován, názvy a datové typy parametrů jsou před textem odeslané dávky v tomto sloupci, například (@1 TINYINT).
Poznámka:
Názvy parametrů jsou libovolné. Uživatelé nebo aplikace by se neměli spoléhat na konkrétní pořadí pojmenování. Dále se mezi verzemi SQL Server a kumulativními aktualizacemi (CU) mohou měnit následující položky: názvy parametrů, volba literálů, které jsou parametrizovány, a rozestupy v parametrizovaném textu.
Datové typy parametrů
Když Database Engine parametrizuje literály, parametry jsou převedeny na následující datové typy:
- Celočíselné literály, jejichž velikost by jinak zapadla do datového typu int, se parametrizují na int. Větší celočíselné literály, které jsou součástí predikátů zahrnujících jakýkoli srovnávací operátor (zahrnuje
<,<=,=,!=,>,BETWEEN,<>,ALL,SOME,!>,!<,ANY,>=aIN) parametrizují na numeric(38,0). Větší literály, které nejsou součástí predikátů zahrnujících srovnávací operátory, parametrizují na numeric, jehož přesnost je právě tak velká, aby odpovídala jeho velikosti, a jehož škála je 0. - Číselné literály s pevnou desetinnou čárkou, které jsou součástí predikátů zahrnujících operátory porovnání, parametrizují na numeric, jehož přesnost je 38 a jehož škála je právě dostatečně velká na to, aby unesla jeho velikost. Číselné literály s pevnou desetinnou čárkou, které nejsou součástí predikátů zahrnujících srovnávací operátory, se parametrizují na numeric, jejichž přesnost a škála jsou právě dostatečně velké, aby unesly jeho velikost.
- Literály s plovoucí desetinnou čárkou se parametrizují na float(53).
- Ne-Unicode literály řetězců parametrizují na varchar(8000), pokud se literál vejde do 8 000 znaků, a na varchar(max), pokud je větší než 8 000 znaků.
- Unicode stringové literály parametrizují na nvarchar(4000), pokud se literál vejde do 4 000 Unicode znaků, a na nvarchar(max), pokud je literál větší než 4 000 znaků.
- Binární literály parametrizují na varbinary(8000), pokud se literál vejde do 8 000 bajtů. Pokud je větší než 8 000 bajtů, převede se na varbinary(max).
- Peněžní literály se parametrizují na peníze.
Pokyny pro použití vynucené parametrizace
Zvažte následující body, když nastavíte PARAMETERIZATION volbu na FORCED:
- Nucená parametrizace mění literální konstanty v dotazu na parametry při kompilaci dotazu. Optimalizátor dotazů proto může zvolit neoptimální plány pro dotazy. Optimalizátor dotazů je konkrétně méně pravděpodobné, že se dotaz shoduje s indexovaným zobrazením nebo indexem ve počítaném sloupci. Může také zvolit neoptimální plány dotazů v dělených tabulkách a distribuovaných rozdělených zobrazeních. Nepoužívejte nucenou parametrizaci v prostředích, která silně spoléhají na indexované pohledy a indexy na vypočítaných sloupcích. Obecně by tuto
PARAMETERIZATION FORCEDmožnost měli používat pouze zkušení databázoví profesionálové poté, co zjistí, že nemá nepříznivý vliv na výkon. - Distribuované dotazy, které odkazují na více než jednu databázi, mají nárok na vynucenou parametrizaci, pokud je tato možnost nastavená na
PARAMETERIZATIONv databázi, v jejímž kontextu dotaz běží. - Nastavení volby
PARAMETERIZATIONnaFORCEDvyprázdní všechny plány dotazů z cache plánů databáze, kromě těch, které se právě kompilují, rekompilují nebo běží. Plány dotazů, které se kompilují nebo běží během změny nastavení, jsou parametrizovány při dalším spuštění dotazu. - Nastavení
PARAMETERIZATIONtéto možnosti je online operace, která nevyžaduje žádné výhradní zámky na úrovni databáze. - Aktuální nastavení
PARAMETERIZATIONtéto možnosti se zachová při opětovném připojení nebo obnovení databáze.
Chování nucené parametrizace lze přepsat tím, že určíte, že se má jednoduchá parametrizace použít pro jeden dotaz a u všech ostatních dotazů, které jsou syntakticky ekvivalentní, ale liší se pouze hodnotami parametrů. Naopak můžete určit, že vynucená parametrizace bude provedena pouze na sadě syntakticky ekvivalentních dotazů, i když je vynucená parametrizace v databázi zakázána. K tomuto účelu použijte plan guides.
Poznámka:
Pokud je možnost PARAMETERIZATION nastavena na FORCED, hlášení chybových zpráv se může lišit od situace, kdy je možnost PARAMETERIZATION nastavena na SIMPLE: více chybových zpráv může být hlášeno v rámci vynucené parametrizace, zatímco méně zpráv by bylo hlášeno v rámci jednoduché parametrizace a čísla řádků, ve kterých k chybám dochází, mohou být hlášena nesprávně.
Pokud je povolená vynucená parametrizace, může stále dojít k jednoduché parametrizaci. Například následující dotaz nelze parametrizovat podle pravidel vynucené parametrizace:
SELECT *
FROM Person.Address
WHERE AddressID = 1 + 2;
Lze však parametrizovat podle jednoduchých pravidel parametrizace. Když je pokus o vynucenou parametrizaci neúspěšný, stále se pokouší jednoduchá parametrizace.
Příprava příkazů SQL
Database Engine podporuje přípravu T-SQL příkazů před vykonáním. Pokud aplikace potřebuje opakovaně spustit příkaz T-SQL, může použít databázové API k tomu, aby:
- Připravte prohlášení pouze jednou. Tento krok kompiluje příkaz T-SQL do plánu vykonání.
- Spouštějte předkompilovaný plán spuštění pokaždé, když je potřeba příkaz spustit. Tento přístup zabraňuje opětovnému kompilování příkazu T-SQL při každém spuštění po prvním provedení. Příprava a spouštění příkazů se řídí funkcemi a metodami rozhraní API. SQL Server Native Client OLE DB Provider a SQL Server Native Client ODBC driver podporují model připravování/spouštění pro provádění příkazů T-SQL. Při přípravě požadavku buď zprostředkovatel, nebo ovladačem pošle příkaz SQL Serveru s požadavkem na přípravu příkazu. Database Engine sestaví plán provedení a vrátí poskytovateli nebo ovladači popisovač tohoto plánu. Při provedení požadavku zašle poskytovatel nebo ovladač serveru žádost na provedení plánu, který je přidružený k popisovači.
Připravené příkazy nemohou vytvářet dočasné objekty v Database Engine. Připravené příkazy nemůžou odkazovat na systémové uložené procedury, které vytvářejí dočasné objekty, jako jsou dočasné tabulky. Tyto postupy se musí provést přímo.
Nadměrné používání modelu prepare/execute může výkon zhoršit. Pokud je příkaz vykonán pouze jednou, přímé provedení vyžaduje pouze jeden síťový přenos tam a zpět se serverem. Příprava a provedení T-SQL příkazu provedeného pouze jednou vyžaduje další síťovou komunikaci: jednu cestu pro přípravu příkazu a jednu cestu pro jeho vykonání.
Příprava příkazu je efektivnější, pokud používáte značky parametrů. Předpokládejme například, že aplikace je občas požádána k načtení informací o produktu z AdventureWorksLT2025 ukázkové databáze. Aplikace může tento úkol zvládnout dvěma způsoby.
Použitím prvního přístupu může aplikace pro každý požadovaný produkt provést samostatný dotaz:
SELECT *
FROM Production.Product
WHERE ProductID = 63;
Při použití druhého přístupu aplikace provádí následující operace:
Připravuje příkaz SQL, který obsahuje parametrický marker (
?).SELECT * FROM Production.Product WHERE ProductID = ?;Připojí proměnnou programu k parametrickému ukazateli.
Pokaždé, když jsou potřebné informace o produktu, dosadí do vázané proměnné hodnotu klíče a provede každý příkaz.
Druhý přístup je efektivnější, pokud se příkaz provádí více než třikrát.
V Database Engine nemá model prepare/execute žádnou významnou výkonnostní výhodu oproti přímému vykonání, protože Database Engine znovu využívá plány vykonávání. Database Engine má efektivní algoritmy pro spárování aktuálních příkazů T-SQL s plány provádění generovanými pro předchozí spuštění stejného příkazu T-SQL. Pokud aplikace vykoná T-SQL příkaz s parametrovými značkami opakovaně, Database Engine znovu použije plán provedení z prvního spuštění pro druhé a následující provedení (pokud plán není odstraněn z mezipaměti plánů). Přípravný a spouštěcí model má stále tyto výhody:
- Nalezení plánu spuštění pomocí identifikátoru je efektivnější než algoritmy používané k porovnávání příkazu T-SQL se stávajícími plány spuštění.
- Aplikace může ovládat, kdy je plán spuštění vytvořen a kdy je znovu použit.
- Model prepare/execute je přenosný do jiných databází, včetně dřívějších verzí SQL Serveru.
Citlivost parametrů
Citlivost parametrů, známá také jako parameter sniffing, označuje proces, kdy Database Engine během kompilace nebo rekompilace sniffuje aktuální hodnoty parametrů a předá je optimalizátoru dotazů, aby potenciálně pomohl generovat efektivnější plány provádění dotazů.
Hodnoty parametrů se při kompilaci nebo rekompilaci zachycují pro následující typy dávek:
- Uložené procedury
- Dotazy odeslané prostřednictvím
sp_executesql - Připravené dotazy
Pro více informací o řešení problémů s parameter sniffingem viz:
- Zkoumání a řešení problémů citlivých na parametry
- Používejte explicitní parametry pro opětovné použití plánu
- Optimalizace plánu citlivého na parametry
- Řešení potíží s dotazy s plánem spouštění dotazů citlivým na parametry ve službě Azure SQL Database
- Řešení potíží s dotazy s plánem spouštění dotazů citlivým na parametry ve službě Azure SQL Managed Instance
Když dotaz v Database Engine použije pokyn OPTION (RECOMPILE), Query Optimizer převede parametry a lokální proměnné na konstanty při kompilaci, které lze vyhodnotit při kompilaci a redukovat na literály. Během kompilace optimalizátor zná a může použít aktuální hodnoty parametrů a lokálních proměnných za běhu, jak existují bezprostředně před tímto příkazem. Direktiva OPTION (RECOMPILE) umožňuje optimalizátoru generovat optimálnější plán dotazů přizpůsobený konkrétním hodnotám a využívat nejlepší podkladové indexy za běhu. U parametrů tento proces neodkazuje na hodnoty, které byly původně předány dávce nebo uložené proceduře, ale jejich hodnoty v době rekompilace. Tyto hodnoty mohou být během procedury upravovány před dosažením příkazu, který zahrnuje RECOMPILE. Toto chování může zlepšit výkon dotazů s vysoce proměnlivými nebo zkreslenými vstupními daty, ale za cenu kompilace dotazu při každém provedení. Tento náklad může být vysoký. Vyhněte se použití pokynu RECOMPILE, aniž byste zhodnotili jeho dopad na celkovou pracovní zátěž.
Lokální proměnné a odhady kardinálnosti
Když dotaz používá lokální proměnné, Database Engine nemůže při kompilaci zjistit jejich hodnoty, takže odhaduje kardinalitu pomocí dostupných statistik nebo heuristik. Pokud existují statistiky, obvykle používá hodnotu Veškerá hustota (označovaná také jako průměrná hustota) ze statistického histogramu k odhadu, kolik řádků odpovídá predikátu. Pokud však pro sloupec nejsou k dispozici žádné statistiky, Database Engine se opírá o heuristické odhady, například při předpokladu 10% selektivity pro predikáty rovnosti a 30% pro nerovnosti a rozsahy. Tyto odhady mohou vést k méně přesným plánům provádění. Tady je příklad dotazu, který používá místní proměnnou.
DECLARE @ProductId AS INT = 100;

SELECT *
FROM Products
WHERE ProductId = @ProductId;
V tomto případě Database Engine nepoužívá hodnotu 100 k optimalizaci dotazu. Používá obecný odhad.
Paralelní zpracování dotazů
Database Engine poskytuje paralelní dotazy pro optimalizaci provádění dotazů a indexovacích operací pro počítače, které mají více než jeden mikroprocesor (CPU). Protože Database Engine může provádět dotazovací nebo indexační operaci paralelně pomocí několika vláken operačního systému, operace se dokončí rychle a efektivně.
Během optimalizace dotazů Database Engine hledá dotazy nebo indexové operace, které by mohly těžit z paralelního provádění. Pro tyto dotazy Database Engine vkládá operátory výměny do plánu provádění dotazu, aby připravil dotaz k paralelnímu provedení. Operátor výměny je operátor v plánu provádění dotazů, který poskytuje správu procesů, redistribuci dat a řízení toku. Operátor výměny zahrnuje logické operátory Distribute Streams, Repartition Streams, a Gather Streams jako podtypy, z nichž jeden nebo více se může zobrazit ve výstupu Showplan plánu dotazu pro dotaz zpracovávaný paralelně.
Důležité
Některé konstrukce brání modulu Database Engine používat paralelismus v celém plánu spuštění nebo v jeho částech.
Konstrukty, které inhibují paralelismus, zahrnují:
| Vytvořit | Popis |
|---|---|
| Skalární UDFs | Pro více informací o skalárních uživatelsky definovaných funkcích viz Vytváření uživatelsky definovaných funkcí. Od SQL Serveru 2019 (15.x) může Databázový stroj systému SQL Server tyto funkce vložit přímo do dotazu a odemknout využití paralelismu při zpracování dotazů. Pro více informací o skalárním UDF inliningu viz Inteligentní zpracování dotazů v SQL databázích. |
| vzdáleného dotazu | Pro více informací o Remote Query viz Referenční příručka logických a fyzických operátorů showplan. |
| Dynamické kurzory | Pro více informací o kurzorech viz DECLARE CURSOR. |
| Rekurzivní dotazy | Další informace o rekurzi najdete v tématech Pokyny pro definování a používání rekurzivních běžných tabulkových výrazů a Rekurze v T-SQL. |
| Funkce vracející tabulku s vícero příkazy (MSTVFs) | Pro více informací o MSTVF viz Vytvoření uživatelsky definovaných funkcí (Databázový stroj). |
TOP klíčové slovo |
Další informace najdete v tématu TOP. |
Plán provádění dotazu může obsahovat Atribut NonParallelPlanReason v elementu QueryPlan , který popisuje, proč se nepoužíval paralelismus. Mezi hodnoty tohoto atributu patří:
| NonParallelPlanReason – hodnota | Popis |
|---|---|
MaxDOPSetToOne |
Maximální stupeň paralelismu je nastaven na 1. |
EstimatedDOPIsOne |
Odhadovaný stupeň paralelismu je 1. |
NoParallelWithRemoteQuery |
U vzdálených dotazů se nepodporuje paralelismus. |
NoParallelDynamicCursor |
Paralelní plány nejsou podporovány pro dynamické kurzory. |
NoParallelFastForwardCursor |
Paralelní plány nejsou podporovány pro kurzory rychlého posuvu. |
NoParallelCursorFetchByBookmark |
Paralelní plány nejsou podporovány pro kurzory, které se načítají záložkou. |
NoParallelCreateIndexInNonEnterpriseEdition |
Paralelní vytváření indexů není podporováno pro edici jiné verze než Enterprise. |
NoParallelPlansInDesktopOrExpressEdition |
Paralelní plánování není podporováno v edici Desktop a Express. |
NonParallelizableIntrinsicFunction |
Dotaz odkazuje na vnitřní funkci, která není paralelizovatelná. |
CLRUserDefinedFunctionRequiresDataAccess |
Paralelismus není podporován pro UDF CLR, který vyžaduje přístup k datům. |
TSQLUserDefinedFunctionsNotParallelizable |
Dotaz odkazuje na uživatelem definovanou funkci T-SQL, která nebyla paralelizovatelná. |
TableVariableTransactionsDoNotSupportParallelNestedTransaction |
Transakce tabulkových proměnných nepodporují vnořené paralelní transakce. |
DMLQueryReturnsOutputToClient |
Dotaz DML vrací výstup klientovi a není paralelizovatelný. |
MixedSerialAndParallelOnlineIndexBuildNotSupported |
Nepodporovaná kombinace sériových a paralelních plánů pro sestavení jednoho online indexu. |
CouldNotGenerateValidParallelPlan |
Ověřování paralelního plánu selhalo, přechod zpět na sériový plán. |
NoParallelForMemoryOptimizedTables |
Paralelismus není podporován pro odkazované tabulky In-Memory OLTP. |
NoParallelForDmlOnMemoryOptimizedTable |
Paralelismus není podporován pro DML v tabulce In-Memory OLTP. |
NoParallelForNativelyCompiledModule |
Paralelismus není podporován pro odkazované na nativně kompilované moduly. |
NoRangesResumableCreate |
Generování rozsahu selhalo u operace obnoveného vytvoření. |
Po vložení operátorů výměny je výsledkem plán provádění paralelního dotazu. Plán provádění paralelních dotazů může používat více než jedno pracovní vlákno. Plán sériového spuštění, který používá neběžný (sériový) dotaz, používá ke spuštění pouze jedno pracovní vlákno. Skutečný počet pracovních vláken použitých paralelním dotazem je určen při inicializaci vykonávání plánu dotazu a závisí na složitosti plánu a míře paralelismu.
Stupeň paralelismu (DOP) určuje maximální počet procesorů, které lze použít k vykonání paralelní úlohy. DOP neudává celkový počet pracovních vláken použitých dotazem. Limit DOP je nastavený na každou úlohu. Nejedná se o limit na každý požadavek nebo dotaz. To znamená, že během paralelního spuštění dotazu může jeden požadavek vytvořit více úloh, které jsou přiřazeny plánovači. V libovolném bodě provádění dotazu může být současně použito více procesorů, než je specifikováno parametrem MAXDOP, když jsou různé úkoly vykonávány současně. Další informace najdete v průvodci architekturou vláken a úloh.
Optimalizátor dotazů nepoužívá paralelní plán provádění dotazu, pokud je splněna některá z následujících podmínek:
Sériový plán provedení je triviální nebo nepřesahuje prahovou hodnotu nákladů pro paralelismus.
Plán sériového spuštění má nižší celkové odhadované náklady podstromu než jakýkoli paralelní plán spuštění prozkoumaný optimalizátorem.
Dotaz obsahuje skalární nebo relační operátory, které nejde spustit paralelně. Některé operátory mohou způsobit spuštění části plánu dotazu v sériovém režimu nebo celý plán spustit v sériovém režimu.
Poznámka:
Celkové odhadované náklady na podstromy paralelního plánu můžou být nižší než prahová hodnota nákladů pro nastavení paralelismu. Jinými slovy, celkové odhadované náklady na podstrom sériového plánu je převýšily a byl zvolen dotazovací plán s nižšími celkovými odhadovanými náklady na podstrom.
Stupeň paralelismu (DOP)
Databázový stroj automaticky zjišťuje nejlepší stupeň paralelismu pro každou instanci paralelního provádění dotazu nebo operace jazyka DDL pro indexy. Tuto hodnotu určuje na základě následujících kritérií:
Zda sql Server běží na počítači, který má více než jeden mikroprocesor nebo procesor, například symetrický multiprocessingový počítač (SMP). Paralelní dotazy můžou používat jenom počítače, které mají více než jeden procesor.
Zda je k dispozici dostatečný počet pracovních vláken. Každá operace dotazu nebo indexu vyžaduje spuštění určitého počtu pracovních vláken. Provádění paralelního plánu vyžaduje více pracovních vláken než sériový plán a počet požadovaných pracovních vláken se zvyšuje o stupeň paralelismu. Když nelze splnit požadavek na pracovní vlákno paralelního plánu pro určitou míru paralelismu, Databázový stroj systému SQL Server automaticky snižuje stupeň paralelismu nebo paralelní plán spuští sériově.
Typ dotazu nebo operace indexu. Indexovací operace, které vytvářejí nebo znovu sestavují index, nebo odstraňují clusterovaný index a dotazy, které používají cykly procesoru, jsou nejvhodnějšími kandidáty pro paralelní plán. Dobrými kandidáty jsou například spojení velkých tabulek, velkých agregací a řazení velkých sad výsledků. Základní dotazy, které se často vyskytují v aplikacích pro zpracování transakcí, zjistí, že dodatečná koordinace potřebná k paralelnímu provedení dotazu převažuje nad potenciálním nárůstem výkonu. Aby bylo možné rozlišovat mezi dotazy, které využívají paralelismus, a dotazy, které nemají prospěch, porovná databázový stroj SQL Serveru odhadované náklady na provedení operace dotazu nebo indexu s prahovou hodnotou nákladů pro hodnotu paralelismu . Uživatelé mohou změnit výchozí hodnotu
5pomocí sp_configure, pokud řádné testování ukáže, že jiná hodnota je pro aktuální pracovní zátěž vhodnější.Zda existuje dostatečný počet řádků ke zpracování. Pokud optimalizátor dotazů zjistí, že počet řádků je příliš nízký, nezavádí operátory výměny pro distribuci řádků. Operace jsou tedy prováděny sériově. Provádění operátorů v sériovém plánu zabraňuje scénářům, kdy náklady na spuštění, distribuci a koordinaci překračují zisky dosažené paralelním spuštěním operátoru.
Zda jsou k dispozici aktuální statistiky. Pokud nejvyšší stupeň paralelismu není možný, zvažují se nižší stupně před opuštěním paralelního plánu. Například když vytvoříte shlukovaný index na pohledu, statistiky nelze vyhodnotit, protože shlukovaný index ještě neexistuje. V tomto případě databázový stroj SQL Serveru nemůže poskytnout nejvyšší stupeň paralelismu pro operaci indexu. Některé operátory, jako je řazení a prohledávání, ale můžou i nadále těžit z paralelního provádění.
Poznámka:
Paralelní indexové operace jsou k dispozici pouze v edicích SQL Server Enterprise, Developer a Evaluation.
V době provádění databázový stroj SQL Serveru určuje, zda aktuální systémové úlohy a informace o konfiguraci dříve popsané umožňují paralelní spouštění. Pokud je zaručeno paralelní provádění, databázový stroj SQL Serveru určí optimální počet pracovních vláken a rozloží provádění paralelního plánu mezi tato pracovní vlákna. Když se spustí operace dotazu nebo indexu na více pracovních vláknech pro paralelní spuštění, použije se stejný počet pracovních vláken, dokud se operace nedokončí. Databázový stroj SQL Serveru znovu přehodnotí optimální počet pracovních vláken pokaždé, když je prováděcí plán získán z mezipaměti. Například jedno provedení paralelního plánu v cache může běžet sériově, pozdější vykonání stejného plánu může použít tři pracovní vlákna a třetí vykonání čtyři pracovní vlákna.
Operátory aktualizace a odstranění v plánu vykonávání dotazů paralelně se provádí sériově, ale klauzule WHERE příkazu UPDATE nebo DELETE se může spustit paralelně. Skutečné změny dat se poté postupně aplikují na databázi.
Od úrovně kompatibility databáze 110 lze SELECT ... INTO příkaz provádět paralelně. Jiné formy insertových operátorů fungují stejně, jak bylo popsáno v předchozích verzích.
Od úrovně kompatibility databáze 130 INSERT ... SELECT lze příkaz provádět paralelně při vkládání do hald nebo indexů clustered columnstore (CCI) a při použití hintu TABLOCK. Vkládání do lokálních dočasných tabulek (identifikovaných předponou TABLOCK) a globálních dočasných tabulek (identifikovaných předponami #) jsou také povolena pro paralelismus pomocí nápovědy ##. Další informace najdete na webu INSERT.
Statické a klíčové kurzory můžou být naplněny plány paralelního spouštění. Chování dynamických kurzorů však může být poskytováno pouze sériovým spuštěním. Optimalizátor dotazů vždy generuje plán sériového spuštění pro dotaz, který je součástí dynamického kurzoru.
Překonání stupňů paralelismu
Stupeň paralelismu nastavuje počet procesorů, které se mají použít při paralelním provádění plánu. Tuto konfiguraci můžete nastavit na různých úrovních:
Na úrovni serveru, a to použitím možnosti konfigurace serveru maximální stupeň paralelismu (
MAXDOP).Platí pro: SQL Server
SQL Server 2019 (15.x) zavedl automatická doporučení pro nastavení
MAXDOPkonfigurace serveru během instalačního procesu. Uživatelské rozhraní nastavení umožňuje buď přijmout doporučená nastavení, nebo zadat vlastní hodnotu. Další informace najdete na stránce Konfigurace databázového stroje – MaxDOP.Úroveň pracovní zátěže pomocí
MAX_DOPmožnosti konfigurace skupiny pracovních zátěží Resource Governor.Platí pro: SQL Server
Na úrovni databáze, pomocí
MAXDOPkonfigurace s rozsahem databáze.Platí pro: SQL Server, Azure SQL Database a Azure SQL Managed Instance
Na úrovni příkazu dotazu nebo indexu pomocí
MAXDOPquery hint neboMAXDOPmožnosti indexu. Například můžete použít možnostMAXDOPk řízení počtu procesorů jeho zvýšením nebo snížením, které jsou vyhrazeny pro online operaci indexu. Tímto způsobem můžete vyvážit zdroje používané indexovou operací s prostředky souběžných uživatelů.Platí pro: SQL Server, Azure SQL Database a Azure SQL Managed Instance
Nastavení volby max degree of parallelism na 0 (výchozí) umožňuje Database Engine využívat všechny dostupné procesory až do maximálně 64 procesorů při spuštění paralelního plánu. Ačkoli Database Engine nastavuje cíl za běhu 64 logických procesorů, když je možnost MAXDOP nastavena na 0, můžete v případě potřeby ručně nastavit jinou hodnotu. Nastavení MAXDOP na 0 pro dotazy a indexy umožňuje Database Engine využívat všechny dostupné procesory až do maximálně 64 procesorů pro dané dotazy nebo indexy při provádění paralelního plánu.
MAXDOP není vynucenou hodnotou pro všechny paralelní dotazy, ale spíše předběžným cílem pro všechny dotazy způsobilé pro paralelismus. To znamená, že pokud není v čase běhu k dispozici dostatek pracovních vláken, dotaz může být vykonán s nižší mírou paralelismu než volba MAXDOP konfigurace serveru.
Návod
Pro více informací viz doporučení MAXDOP s pokyny pro konfiguraci MAXDOP na úrovni serveru, databáze, dotazu nebo hintu.
Příklad paralelního dotazu
Následující dotaz počítá počet objednávek zadaných v konkrétním čtvrtletí, počínaje 1. dubnem 2024, a ve kterých zákazník obdržel alespoň jednu položku objednávky později, než bylo potvrzeno datum. Tento dotaz uvádí počet takových objednávek seskupených podle jednotlivých priorit objednávek a seřazených ve vzestupném pořadí priority.
V tomto příkladu se používají teoretické názvy tabulek a sloupců.
SELECT o_orderpriority,
       COUNT(*) AS Order_Count
FROM orders
WHERE o_orderdate >= '2024/04/01'
      AND o_orderdate < DATEADD(mm, 3, '2024/04/01')
      AND EXISTS (SELECT *
                  FROM lineitem
                  WHERE l_orderkey = o_orderkey
                        AND l_commitdate < l_receiptdate)
GROUP BY o_orderpriority
ORDER BY o_orderpriority;
Předpokládejme, že jsou v tabulkách lineitemorders definovány následující indexy:
CREATE INDEX l_order_dates_idx
    ON lineitem(l_orderkey, l_receiptdate, l_commitdate, l_shipdate);

CREATE UNIQUE INDEX o_datkeyopr_idx
    ON ORDERS(o_orderdate, o_orderkey, o_custkey, o_orderpriority);
Tady je jeden z možných paralelních plánů vygenerovaných pro dříve zobrazený dotaz:
|--Stream Aggregate(GROUP BY:([ORDERS].[o_orderpriority])
                  DEFINE:([Expr1005]=COUNT(*)))
    |--Parallelism(Gather Streams, ORDER BY:
                  ([ORDERS].[o_orderpriority] ASC))
         |--Stream Aggregate(GROUP BY:
                  ([ORDERS].[o_orderpriority])
                  DEFINE:([Expr1005]=Count(*)))
              |--Sort(ORDER BY:([ORDERS].[o_orderpriority] ASC))
                   |--Merge Join(Left Semi Join, MERGE:
                  ([ORDERS].[o_orderkey])=
                        ([LINEITEM].[l_orderkey]),
                  RESIDUAL:([ORDERS].[o_orderkey]=
                        [LINEITEM].[l_orderkey]))
                        |--Sort(ORDER BY:([ORDERS].[o_orderkey] ASC))
                        |    |--Parallelism(Repartition Streams,
                           PARTITION COLUMNS:
                           ([ORDERS].[o_orderkey]))
                        |         |--Index Seek(OBJECT:
                     ([tpcd1G].[dbo].[ORDERS].[O_DATKEYOPR_IDX]),
                     SEEK:([ORDERS].[o_orderdate] >=
                           Apr  1 2024 12:00AM AND
                           [ORDERS].[o_orderdate] <
                           Jul  1 2024 12:00AM) ORDERED)
                        |--Parallelism(Repartition Streams,
                     PARTITION COLUMNS:
                     ([LINEITEM].[l_orderkey]),
                     ORDER BY:([LINEITEM].[l_orderkey] ASC))
                             |--Filter(WHERE:
                           ([LINEITEM].[l_commitdate]<
                           [LINEITEM].[l_receiptdate]))
                                  |--Index Scan(OBJECT:
         ([tpcd1G].[dbo].[LINEITEM].[L_ORDER_DATES_IDX]), ORDERED)
Následující ilustrace ukazuje plán dotazu provedený s mírou paralelismu rovnou 4 a zahrnující spojení dvou tabulek.
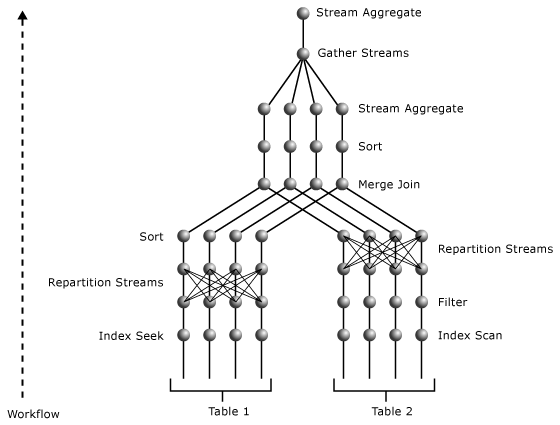
Paralelní plán obsahuje tři operátory paralelismu. Operátor Vyhledávání v indexu o_datkey_ptr i operátor Skenování indexu l_order_dates_idx se provádějí paralelně. Tento proces vytváří několik samostatných datových proudů, které lze určit podle nejbližších operátorů Parallelism nad operátory Index Scan a Index Seek. Oba operátory mění rozdělení typu exchange. Přeskupují data mezi proudy a vytvářejí stejný počet proudů na svém výstupu jako na svém vstupu. Tento počet datových proudů se rovná stupni paralelismu.
Paralelní operátor nad operátorem l_order_dates_idx Index Scan redistribuuje své vstupní toky pomocí hodnoty L_ORDERKEY jako klíče. Tímto způsobem skončí stejné hodnoty L_ORDERKEY ve stejném výstupním datovém proudu. Výstupní datové proudy současně udržují pořadí ve L_ORDERKEY sloupci tak, aby splňovaly vstupní požadavek operátoru Merge Join.
Paralelní operátor nad operátorem Index Seek předěluje své vstupní toky pomocí hodnoty O_ORDERKEY. Protože vstup není seřazen podle hodnot sloupce O_ORDERKEY a tento sloupec je spojovacím sloupcem v operátoru Merge Join, operátor Sort mezi paralelismem a Merge Join zajišťuje, že vstup je pro operátor Merge Join seřazen podle spojovacích sloupců. Operátor Sort , jako je operátor Merge Join, se provádí paralelně.
Nejvrchnější operátor paralelismu shromažďuje výsledky z několika datových proudů do jednoho datového proudu. Částečné agregace prováděné operátorem Agregace datových proudů pod operátorem paralelismu se pak shromáždí do jedné SUM hodnoty pro každou jinou hodnotu operátoru agregace datového O_ORDERPRIORITY proudu nad operátorem paralelismu. Protože tento plán má dva výměnné segmenty s mírou paralelismu rovnou 4, používá osm pracovních vláken.
Pro více informací o operátorech použitých v tomto příkladu viz referenční příručku logických a fyzických operátorů showplanu.
Paralelní operace indexu
Plány dotazů pro indexové operace, které vytvářejí nebo znovu sestavují index, nebo zrušují shlukovaný index, mohou podporovat paralelní, vícevláknové operace na počítačích s více procesory.
Poznámka:
Paralelní operace s indexy jsou dostupné pouze v edici Enterprise.
Database Engine používá stejné algoritmy k určení míry paralelismu (celkového počtu samostatných pracovních vláken, která se mají spustit) pro indexové operace jako pro jiné dotazy. Možnost konfigurace serveru max degree of parallelism nastavuje maximální stupeň paralelismu pro indexovou operaci. Hodnotu MAXDOP pro jednotlivé indexové operace můžete přepsat nastavením indexové volby CREATE INDEX v příkazech ALTER INDEX, DROP INDEX, ALTER TABLE a max degree of parallelism.
Když Databázový stroj systému SQL Server vytváří plán provádění indexu, počet paralelních operací je nastaven na nejnižší hodnotu z těchto hodnot:
- Počet procesorů, neboli CPU, v počítači.
- Číslo uvedené v
max degree of parallelismmožnosti konfigurace serveru. - Počet procesorů CPU, které ještě nejsou nad prahem práce vykonané pro pracovní vlákna SQL Server.
Například na počítači, který má osm CPU, ale kde max degree of parallelism je nastaveno na 6, indexová operace používá maximálně šest paralelních pracovních vláken. Pokud pět procesorů v počítači překročí prahovou hodnotu sql Serveru při sestavení plánu provádění indexu, plán provádění určuje pouze tři paralelní pracovní vlákna.
Hlavní fáze operace s paralelním indexem zahrnují:
- Koordinující pracovní vlákno rychle a náhodně prohledá tabulku, aby odhadla distribuci klíčů indexu. Koordinující pracovní vlákno stanovuje klíčové hranice, které vytvářejí takový počet rozsahů klíčů, který se rovná stupni paralelismu, přičemž každý rozsah klíčů je odhadován tak, aby pokrýval podobný počet řádků. Například pokud je v tabulce čtyři miliony řádků a stupeň paralelizmu je 4, koordinující pracovní vlákno určuje klíčové hodnoty, které ohraničují čtyři sady řádků s 1 milionem řádků v každé sadě. Pokud koordinující pracovní vlákno nedokáže vytvořit dostatek klíčových rozsahů pro využití všech CPU, odpovídajícím způsobem snižuje míru paralelismu.
- Koordinující pracovní vlákno spustí množství pracovních vláken rovnající se stupni paralelních operací a čeká na jejich dokončení. Každé pracovní vlákno prohledá základní tabulku pomocí filtru, který načte pouze řádky s klíčovými hodnotami v rozsahu přiřazeného pracovnímu vláknu. Každé pracovní vlákno vytvoří strukturu indexu pro řádky v jeho rozsahu klíčů. V případě děleného indexu vytvoří každé pracovní vlákno zadaný počet particí. Oddíly nejsou sdíleny mezi pracovními vlákny.
- Po dokončení všech paralelních pracovních vláken koordinující pracovní vlákno spojí indexové podjednotky do jednoho indexu. Tato fáze se vztahuje pouze na offline indexové operace.
Jednotlivé CREATE TABLE nebo ALTER TABLE příkazy mohou mít více omezení, která vyžadují vytvoření indexu. Tyto více operací vytváření indexů se provádí v řadě, i když každá jednotlivá operace vytvoření indexu může být paralelní operací v počítači s více procesory.
Architektura distribuovaných dotazů
Database Engine podporuje dvě metody odkazování na heterogenní zdroje dat OLE DB v T-SQL příkazech:
Názvy propojených serverů
Použijte systémově uložené procedury
sp_addlinkedserverasp_addlinkedsrvlogink přiřazení názvu serveru zdroji dat OLE DB. Na objekty v těchto propojených serverech se můžete odkazovat v příkazech T-SQL se čtyřdílnými názvy. Pokud je například název propojenéhoDeptSQLSrvrserveru definovaný proti jiné instanci SQL Serveru, odkazuje následující příkaz na tabulku na tomto serveru:SELECT JobTitle, HireDate FROM DeptSQLSrvr.AdventureWorks2025.HumanResources.Employee;Můžete také zadat název propojeného serveru ve příkazu
OPENQUERYpro otevření sady řádků ze zdroje dat OLE DB. Pak můžete tuto sadu řádků odkazovat jako na tabulku v příkazech T-SQL.Názvy ad hoc konektorů
Pro méně časté odkazy na datový zdroj specifikujte funkce
OPENROWSETneboOPENDATASOURCEs informacemi potřebnými k připojení k propojenému serveru. Pak můžete odkazovat na sadu řádků stejným způsobem, jako odkazujete na tabulku v příkazech jazyka T-SQL:SELECT a.* FROM OPENROWSET ( 'Microsoft.Jet.OLEDB.4.0', 'MSOffice\Access\Samples\Northwind.mdb'; 'Admin'; '', Employees ) AS a;
Database Engine používá OLE DB ke komunikaci mezi relačním motorem a úložným enginem. Relační engine rozkládá každý T-SQL příkaz na sérii operací na základních řádkových sadách OLE DB, které úložný engine otevírá ze základních tabulek. Tento proces znamená, že relační engine může také otevírat základní sady řádků OLE DB na jakémkoli zdroji dat OLE DB.
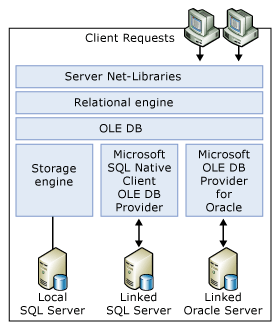
Relační modul používá aplikační programovací rozhraní OLE DB (API) k otevření sad řádků na propojených serverech, načtení řádků a správu transakcí.
Pro každý zdroj dat OLE DB, ke kterému přistupujete jako k propojenému serveru, musí mít server, na kterém běží SQL Server, zprostředkovatele OLE DB. Sada T-SQL operací, které můžete použít proti konkrétnímu zdroji dat OLE DB, závisí na možnostech poskytovatele OLE DB.
Pro každou instanci SQL Server mohou členové pevné role serveru sysadmin povolit nebo zakázat použití ad hoc názvů konektorů pro poskytovatele OLE DB pomocí vlastnosti DisallowAdhocAccess serveru SQL Server. Když povolíte ad hoc přístup, každý uživatel přihlášený k dané instanci může spustit příkazy T-SQL obsahující názvy zprostředkovatelů ad hoc, odkazující na jakýkoli zdroj dat v síti, ke kterému má poskytovatel OLE DB přístup. Pro kontrolu přístupu ke zdrojům dat mohou členové pevné role serveru sysadmin zakázat ad hoc přístup pro daného poskytovatele OLE DB, čímž omezí uživatele pouze na ty datové zdroje, na které odkazují názvy propojených serverů definované administrátory. Ve výchozím nastavení je pro zprostředkovatele OLE DB SYSTÉMU SQL Server povolený ad hoc přístup a pro všechny ostatní zprostředkovatele OLE DB je zakázaný.
Distribuované dotazy umožňují uživatelům přístup k jinému datovému zdroji (například souborům, nerelačním datovým zdrojům jako služba Active Directory a podobně) pomocí bezpečnostního kontextu účtu Windows, pod kterým běží služba SQL Server. SQL Server správně vystupuje pod přihlašovacím jménem pro přihlašovací jména systému Windows. Nicméně toto zosobnění není možné u přihlášení do SQL Server. Toto omezení může potenciálně umožnit uživateli distribuovaného dotazu přístup k jinému datovému zdroji, ke kterému nemá oprávnění, ale účet, pod kterým služba SQL Server běží, má oprávnění. Slouží sp_addlinkedsrvlogin k definování konkrétních přihlášení, která mají oprávnění pro přístup k odpovídajícímu propojenému serveru. Tato kontrola není dostupná pro ad hoc názvy, proto buďte opatrní při povolování poskytovatele OLE DB pro ad hoc přístup.
Pokud je to možné, Database Engine posílá relační operace, jako jsou spojení, omezení, projekce, třídění a operace GROUP BY, do zdroje dat OLE DB. Databázový stroj ve výchozím nastavení neprovádí načítání základní tabulky do SQL Serveru a neprovádí relační operace sám. Database Engine dotazuje poskytovatele OLE DB, aby určil úroveň SQL gramatiky, kterou podporuje, a na základě těchto informací přenáší na poskytovatele co nejvíce relačních operací.
Database Engine specifikuje mechanismus, kterým poskytovatel OLE DB vrací statistiky ukazující, jak jsou klíčové hodnoty rozděleny ve zdroji dat OLE DB. Tento mechanismus umožňuje Database Engine Query Optimizeru lépe analyzovat vzor dat ve zdroji dat podle požadavků každého T-SQL příkazu, čímž zvyšuje schopnost Query Optimizeru generovat optimální plány provádění.
Zpracování dotazů na rozdělených tabulkách a indexech
Database Engine podporuje zpracování dotazů s ohledem na oddíly pro rozdělené tabulky a indexy. Tato sekce popisuje, jak procesor dotazů zpracovává rozdělené objekty, jak interpretovat plány provádění zahrnující rozdělení a osvědčené postupy pro zlepšení výkonu dotazů na rozdělených objektech.
Poznámka:
Rozdělené tabulky a indexy jsou podporovány v edici SQL Server Standard, počínaje SQL Server 2016 (13.x) se sadou Service Pack 1.
Nová operace hledání citlivá na oddíly
V modulu Database Engine procesor dotazů interně vidí rozdělenou tabulku jako vícesloupcový index s PartitionID jako vedoucím sloupcem.
PartitionID je skrytý počítaný sloupec, který interně představuje ID oddílu obsahujícího konkrétní řádek. Například předpokládejme, že tabulka T, definovaná jako T(a, b, c), je rozdělená podle sloupce a a má shlukovaný index na sloupci b. Tato rozdělená tabulka je považována za nerozdělenou tabulku se schématem T(PartitionID, a, b, c) a shlukovaným indexem na složeném klíči (PartitionID, b). Tato reprezentace umožňuje optimalizátoru dotazů provádět operace vyhledávání na základě PartitionID u libovolné rozdělené tabulky nebo indexu.
Eliminace oddílu se teď provádí v této vyhledávací operaci.
Navíc je optimalizátor dotazů rozšířen tak, že lze provést operaci hledání nebo skenování s jednou podmínkou na PartitionID (jako logickém vedoucím sloupci) a případně i na dalších sloupcích indexového klíče. Procesor dotazů pak provede vyhledání na druhé úrovni s jinou podmínkou na jednom nebo více dalších sloupcích pro každou odlišnou hodnotu, která splňuje podmínky pro vyhledání na první úrovni. Tato operace, nazývaná partition skip scan, umožňuje optimalizátoru dotazů provést operaci hledání nebo skenování na základě jedné podmínky k určení oddílů, ke kterým se má přistupovat, a operaci vyhledávání v indexu druhé úrovně uvnitř tohoto operátoru, která vrací řádky z těchto oddílů, které splňují jinou podmínku. Představte si například následující dotaz.
SELECT *
FROM T
WHERE a < 10
      AND b = 2;
Pro tento příklad předpokládejme, že tabulka T, definovaná jako T(a, b, c), je rozdělena podle sloupce a a má shlukovaný index na sloupci b. Následující funkce oddílu definuje hranice oddílu pro tabulku T:
CREATE PARTITION FUNCTION myRangePF1(INT)
    AS RANGE LEFT
    FOR VALUES (3, 7, 10);
Aby bylo možné tento dotaz vyřešit, procesor dotazu provede operaci hledání na první úrovni, aby našel každý oddíl obsahující řádky, které splňují podmínku T.a < 10. Tato operace identifikuje oddíly, ke kterým je třeba přistupovat. V rámci každé identifikované partition procesor provede vyhledávání druhé úrovně do shlukovaného indexu ve sloupci b, aby našel řádky, které splňují podmínku T.b = 2 a T.a < 10.
Následující ilustrace je logickým znázorněním operace partition skip scan. Zobrazuje tabulku T s daty ve sloupcích a a b. Oddíly jsou očíslovány od 1 do 4 s hranicemi oddílů zobrazenými přerušovanými svislými čarami. Operace hledání první úrovně pro oddíly (nezobrazená na ilustraci) určuje, že oddíly 1, 2 a 3 splňují podmínku hledání vyplývající z rozdělení definovaného pro tabulku a predikát ve sloupci a (T.a < 10). Trajektorie posunu druhé úrovně je znázorněna zakřivenou čarou. V podstatě operace prohledává každý z těchto oddílů a hledá řádky, které splňují podmínku b = 2. Celkové náklady na operaci jsou stejné jako náklady na tři samostatná indexová vyhledávání.
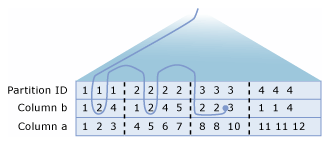
Zobrazení informací o particionování v plánech zpracování dotazů
Prozkoumejte plány provádění dotazů na rozdělených tabulkách a indexech pomocí příkazů SET SHOWPLAN_XML T-SQL SET nebo SET STATISTICS XML, případně použitím grafického výstupu plánu vykonání v SSMS. Například můžete zobrazit plán provedení v době kompilace výběrem Zobrazit odhadovaný plán provedení na panelu nástrojů Editor Power Query a plán běhu volbou Zahrnout skutečný plán provedení.
Použitím těchto nástrojů můžete najít následující informace:
- Operace jako skenování, vyhledávání, vkládání, aktualizace, sloučení a mazání, které přistupují k rozděleným tabulkám nebo indexům.
- Oddíly, k nimž dotaz přistupuje. Například plány provádění za běhu zahrnují celkový počet oddílů, ke kterým bylo přistoupeno, a rozsahy sousedících oddílů, ke kterým se přistupuje.
- Když je operace partition skip scan použita při operaci hledání nebo skenování k získání dat z jednoho nebo více oddílů.
Vylepšení informací o oddílech
Database Engine poskytuje rozšířené informace o dělení oddílů jak pro plány provádění při kompilaci, tak za běhu. Plány provádění teď poskytují následující informace:
- Volitelný
Partitionedatribut, který označuje, že operátor, jako je vyhledávání, skenování, vložení, aktualizace, sloučení nebo mazání, je prováděn na rozdělené tabulce. - Nový
SeekPredicateNewprvek s dílčím prvkemSeekKeys, který obsahujePartitionIDjako úvodní indexový klíčový sloupec a podmínky filtru, které určují rozsah hledání vPartitionID. Přítomnost dvouSeekKeyspodprvků označuje operaci partition skip scan naPartitionID. - Souhrnné informace, které poskytují celkový počet přístupných oddílů. Tyto informace jsou k dispozici pouze v běhových plánech.
Chcete-li předvést, jak se tyto informace zobrazují ve výstupu grafického plánu provádění i výstupu showplan XML, zvažte následující dotaz na dělenou tabulku fact_sales. Tento dotaz aktualizuje data ve dvou oddílech.
UPDATE fact_sales
    SET quantity = quantity - 2
WHERE date_id BETWEEN 20190802 AND 20190902;
Následující obrázek znázorňuje vlastnosti operátora Clustered Index Seek v plánu provádění modulu runtime pro tento dotaz. Pro zobrazení definice tabulky fact_sales a definice rozdělení viz Příklad.
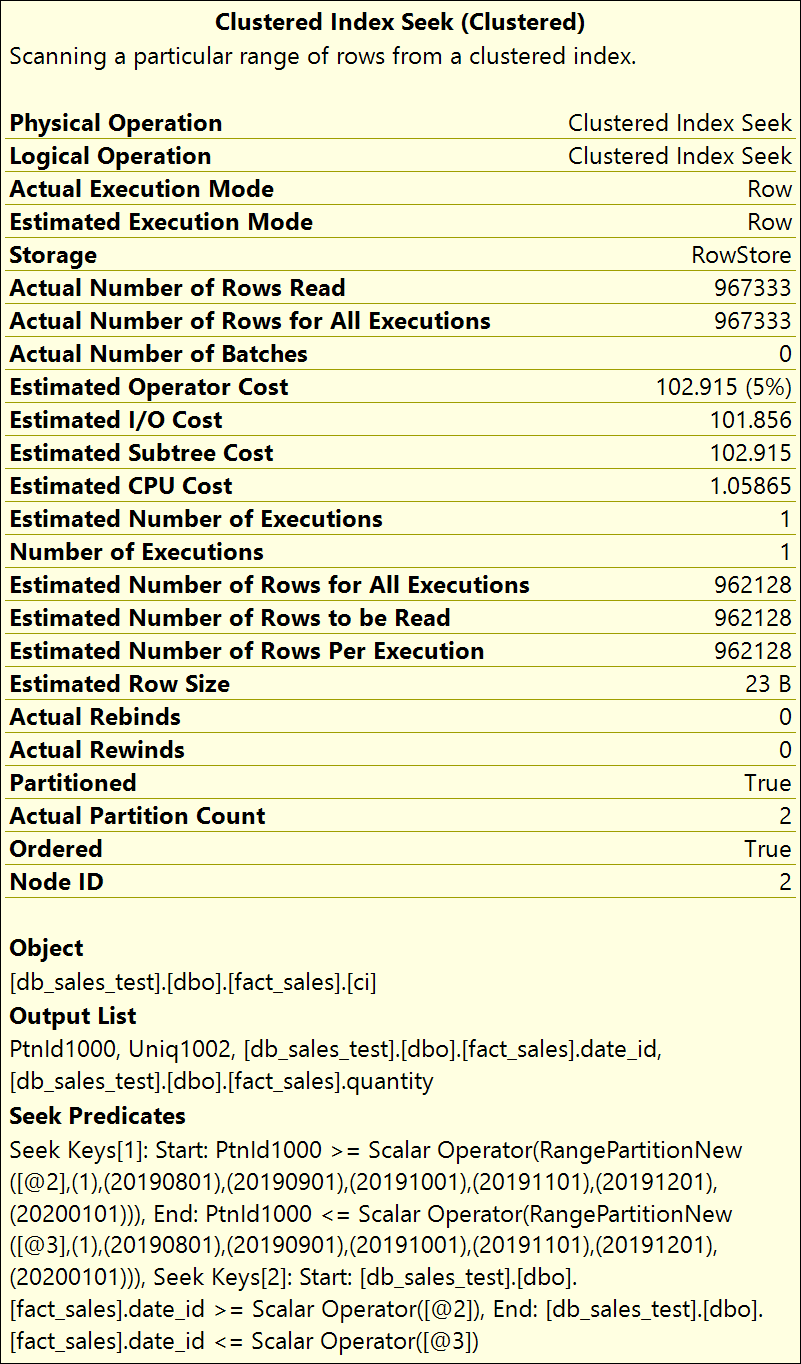
Dělený atribut
Když je na dělené tabulce nebo indexu spuštěn operátor, jako je Index Seek, atribut Partitioned se objeví v plánu kompilace a za běhu a je nastaven na True (1). Atribut se nezobrazí, když je nastaven na False (0).
Atribut Partitioned se může objevit v následujících fyzických a logických operátorech:
- Prohledávání tabulek
- Indexové skenování
- Prohledávání indexu
- Vložit
- Aktualizace
- Vymazat
- Sloučit
Jak je ukázáno na předchozí ilustraci, tento atribut se objevuje ve vlastnostech operátoru, ve kterém je definován. Ve výstupu XML Showplan se tento atribut objevuje jako Partitioned="1" v uzlu RelOp operátoru, ve kterém je definován.
Nový predikát hledání
Ve výstupu XML Showplan se prvek SeekPredicateNew objevuje v operátoru, ve kterém je definován. Může obsahovat až dva výskyty subelementu SeekKeys . První SeekKeys položka určuje operaci hledání na první úrovni na úrovni ID oddílu logického indexu. To znamená, že tato operace seek určuje oddíly, ke kterým je třeba přistupovat, aby byly splněny podmínky dotazu. Druhá SeekKeys položka specifikuje vyhledávání druhé úrovně, které probíhá v každém oddílu identifikovaném při vyhledávání první úrovně.
Souhrnné informace o oddílech
V plánech spouštění za běhu poskytují souhrnné informace o oddílech počet oddílů, ke kterých se přistupuje, a identitu skutečných oddílů, ke kterých se přistupuje. Tyto informace můžete použít k ověření, že správné oddíly jsou ve vyhledávacím dotazu přístupovány a všechny ostatní oddíly jsou vyřazeny z úvahy.
K dispozici jsou následující informace: Actual Partition Counta Partitions Accessed.
Actual Partition Count je celkový počet oddílů, ke kterým dotaz přistupuje.
Partitions Accessed, ve výstupu XML Showplan, je souhrnná informace o oddílu, která se objeví v novém prvku RuntimePartitionSummary v uzlu RelOp operátoru, ve kterém je definován. Následující příklad ukazuje obsah elementu RuntimePartitionSummary , který označuje, že jsou přístupné dva celkové oddíly (oddíly 2 a 3).
<RunTimePartitionSummary>
    <PartitionsAccessed PartitionCount="2" >
        <PartitionRange Start="2" End="3" />
    </PartitionsAccessed>
</RunTimePartitionSummary>
Zobrazte informace o rozdělení pomocí jiných metod showplanu
Metody SHOWPLAN_ALL, SHOWPLAN_TEXT, a STATISTICS PROFILE neoznamují informace o oddílu popsané v tomto článku s následující výjimkou. V rámci SEEK predikátu jsou oddíly, ke které se má přistupovat, identifikovány predikátem rozsahu ve počítaném sloupci představujícím ID oddílu. Následující příklad ukazuje SEEK predikát pro Clustered Index Seek operátor. Oddíly 2 a 3 jsou přístupné a operátor hledání filtruje na řádcích, které splňují podmínku date_id BETWEEN 20190802 AND 20190902.
|--Clustered Index Seek(OBJECT:([db_sales_test].[dbo].[fact_sales].[ci]),
        SEEK:([PtnId1000] >= (2) AND [PtnId1000] <= (3)
                AND [db_sales_test].[dbo].[fact_sales].[date_id] >= (20190802)
                AND [db_sales_test].[dbo].[fact_sales].[date_id] <= (20190902))
                ORDERED FORWARD)
Interpretace plánů provádění pro rozdělené haldy
Dělená halda se považuje za logický index ID oddílu. V plánu provádění je eliminace oddílu na haldě s oddíly reprezentována jako operátor Table Scan s predikátem SEEK na ID oddílu. Následující příklad ukazuje informace poskytnuté Showplanem:
|-- Table Scan (OBJECT: ([db].[dbo].[T]), SEEK: ([PtnId1001]=[Expr1011]) ORDERED FORWARD)
Interpretace plánů provádění pro kolaciovaná spojení
Ke spojení může dojít v případě, že jsou dvě tabulky rozdělené pomocí stejné nebo ekvivalentní funkce dělení a sloupce dělení z obou stran spojení jsou zadány v podmínce spojení dotazu. Optimalizátor dotazů může vygenerovat plán, ve kterém jsou oddíly každé tabulky, které mají stejné ID oddílů, připojeny samostatně. Kompletované spojení můžou být rychlejší než neshromážděná spojení, protože mohou vyžadovat méně paměti a doby zpracování. Optimalizátor dotazů zvolí nekolokovaný plán nebo kolokovaný plán na základě odhadů nákladů.
V kolokačním plánu Nested Loops se spoj čte z jedné nebo více připojených tabulek nebo oddílů indexu z vnitřní strany. Čísla v operátorech Constant Scan představují oddíly.
Pokud se pro dělené tabulky nebo indexy vygenerují paralelní plány pro umístěná spojení, objeví se operátor paralelismu mezi operátory spojení Constant Scan a Nested Loops. V tomto případě několik pracovních vláken na vnější straně spojení každý čte a pracuje na jiném oddílu.
Následující obrázek znázorňuje paralelní plán dotazu pro kolokované spojení.
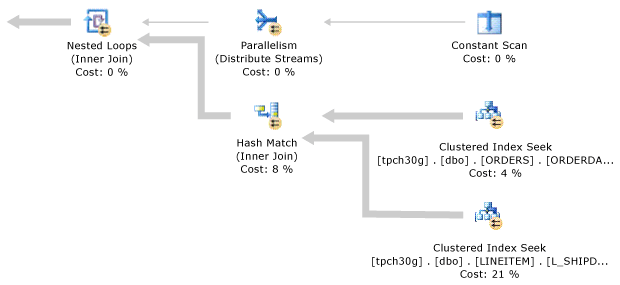
Strategie paralelního spouštění dotazů pro dělené objekty
Procesor dotazů používá strategii paralelního spouštění pro dotazy, které vybírají z dělených objektů. V rámci strategie provádění procesor dotazů určuje oddíly tabulky vyžadované pro dotaz a poměr pracovních vláken k přidělení jednotlivým oddílům. Ve většině případů procesor dotazů přidělí každému oddílu stejný nebo téměř stejný počet pracovních vláken a pak dotaz provede paralelně napříč oddíly. Následující odstavce vysvětlují přidělení pracovních vláken podrobněji.
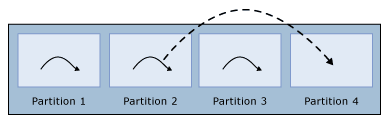
Pokud je počet pracovních vláken menší než počet oddílů, procesor dotazů přiřadí každé pracovní vlákno jinému oddílu, přičemž na začátku ponechá jeden nebo více oddílů bez přiřazeného pracovního vlákna. Když pracovní vlákno dokončí provádění na oddílu, procesor dotazů jej přiřadí k dalšímu oddílu, dokud každý oddíl nedostane jedno pracovní vlákno. Toto přiřazení je jediný případ, kdy procesor dotazů přeřazuje pracovní vlákna do jiných oddílů.
Ukazuje pracovní vlákno přesunuté k nové úloze poté, co dokončí svou práci. Pokud se počet pracovních vláken rovná počtu oddílů, procesor dotazů přiřadí každému oddílu jedno pracovní vlákno. Pracovní vlákno po dokončení není přiděleno do jiného oddílu.
Pokud je počet pracovních vláken větší než počet oddílů, procesor dotazů přidělí každému oddílu stejný počet pracovních vláken. Pokud počet pracovních vláken není přesným násobkem počtu oddílů, procesor dotazů přidělí některým oddílům jedno další pracovní vlákno, aby mohl využít všechna dostupná pracovní vlákna. Pokud je pouze jedna partition, všechny pracovní vlákna jsou přiřazena k této partition. Na následujícím diagramu jsou čtyři oddíly a 14 pracovních vláken. Každá partition má přiřazena tři pracovní vlákna a dvě partition mají jedno extra pracovní vlákno, celkem tedy 14 přiřazení pracovních vláken. Když pracovní vlákno skončí, není znovu přiřazeno k jinému oddílu.
Ačkoliv předchozí příklady naznačují přímočarý způsob alokace vláken pracovníků, skutečná strategie je složitější a zohledňuje i další proměnné, které se vyskytují během provádění dotazu. Například pokud je tabulka rozdělená na oddíly a má shlukovaný index ve sloupci A a dotaz obsahuje predikát WHERE A IN (13, 17, 25), procesor dotazů přidělí jedno nebo více pracovních vláken každé z těchto tří hodnot vyhledávání (A = 13, A = 17 a A = 25) namísto každého oddílu tabulky. Dotaz je nutné provést pouze v oddílech, které tyto hodnoty obsahují, a pokud jsou všechny tyto predikáty vyhledávání ve stejném oddílu tabulky, všechna pracovní vlákna jsou přiřazena ke stejnému oddílu tabulky.
Pro další příklad předpokládejme, že tabulka má čtyři partitiony na sloupci A s hraničními body (10, 20, 30), index ve sloupci B, a dotaz má predikátovou klauzuli WHERE B IN (50, 100, 150). Protože partice tabulky jsou založeny na hodnotách A, mohou se hodnoty B vyskytovat v kterékoli z partic tabulky. Procesor dotazů tedy hledá každou ze tří hodnot B (50, 100, 150) v každém ze čtyř oddílů tabulky. Procesor dotazů přiřazuje pracovní vlákna proporcionálně, aby mohl všech těchto 12 prohledání dotazu provádět paralelně.
Oddíly tabulky založené na sloupci A |
Hledá sloupec B v každém oddílu tabulky |
|---|---|
Oddíl tabulky 1: A < 10 |
B = 50, B = 100, B = 150 |
Oddíl tabulky 2: A >= 10 AND A < 20 |
B = 50, B = 100, B = 150 |
Oddíl tabulky 3: A >= 20 AND A < 30 |
B = 50, B = 100, B = 150 |
Oddíl tabulky 4: A >= 30 |
B = 50, B = 100, B = 150 |
Osvědčené postupy
Pro zlepšení výkonu dotazů, které přistupují k velkému množství dat z velkých rozdělených tabulek a indexů, dodržujte tyto osvědčené postupy:
Rozdělte každý oddíl na mnoho disků. Tento přístup je zvláště relevantní při použití rotujících disků.
Pokud je to možné, použijte server s dostatečnou hlavní pamětí, aby se vešly často používané oddíly nebo všechny oddíly v paměti, abyste snížili náklady na vstupně-výstupní operace.
Pokud se data, na která se dotazujete, nevejdou do paměti, komprimujte tabulky a indexy, abyste snížili náklady na I/O.
Pomocí serveru s rychlými procesory a tolika procesorovými jádry, kolik si můžete dovolit, můžete využít možnosti paralelního zpracování dotazů.
Ujistěte se, že server má dostatečnou šířku pásma V/V kontroleru.
Vytvořte clusterovaný index pro každou velkou dělenou tabulku, abyste mohli využít optimalizace prohledávání stromové struktury B.
Při hromadném načítání dat do rozdělených tabulek se řiďte doporučeními osvědčených postupů v bílé knize The Data Loading Performance Guide.
Příklad
Následující příklad vytvoří testovací databázi obsahující jednu tabulku se sedmi oddíly. Pro zobrazení informací o rozdělení jak pro plány v době kompilace, tak za běhu použijte při provádění dotazů v tomto příkladu nástroje popsané v Zobrazit informace o rozdělení v plánech provádění dotazů.
Poznámka:
Tento příklad vloží do tabulky více než 1 milion řádků. Spuštění tohoto příkladu může trvat několik minut v závislosti na hardwaru. Před provedením tohoto příkladu ověřte, že máte k dispozici více než 1,5 GB místa na disku.
USE master;
GO

IF DB_ID(N'db_sales_test') IS NOT NULL
    DROP DATABASE db_sales_test;
GO

CREATE DATABASE db_sales_test;
GO

USE db_sales_test;
GO

CREATE PARTITION FUNCTION pf_range_fact(INT)
    AS RANGE RIGHT
    FOR VALUES (20190801, 20190901, 20191001, 20191101, 20191201, 20200101);
GO

CREATE PARTITION SCHEME ps_fact_sales
    AS PARTITION pf_range_fact
    ALL TO ([PRIMARY]);
GO

CREATE TABLE fact_sales
(
    date_id INT,
    product_id INT,
    store_id INT,
    quantity INT,
    unit_price NUMERIC (7, 2),
    other_data CHAR (1000)
) ON ps_fact_sales (date_id);
GO

CREATE CLUSTERED INDEX ci
    ON fact_sales(date_id);
GO

PRINT 'Loading...';

SET NOCOUNT ON;

DECLARE @i AS INT;

SET @i = 1;

WHILE (@i < 1000000)
    BEGIN
        INSERT INTO fact_sales
        VALUES (20190800 + (@i % 30) + 1, @i % 10000, @i % 200, RAND() - 25, (@i % 3) + 1, '');
        SET @i += 1;
    END
GO

DECLARE @i AS INT;

SET @i = 1;

WHILE (@i < 10000)
    BEGIN
        INSERT INTO fact_sales
        VALUES (20190900 + (@i % 30) + 1, @i % 10000, @i % 200, RAND() - 25, (@i % 3) + 1, '');
        SET @i += 1;
    END

PRINT 'Done.';
GO

-- Two-partition query.
SET STATISTICS XML ON;
GO

SELECT date_id,
       SUM(quantity * unit_price) AS total_price
FROM fact_sales
WHERE date_id BETWEEN 20190802 AND 20190902
GROUP BY date_id;
GO

SET STATISTICS XML OFF;
GO

-- Single-partition query.
SET STATISTICS XML ON;
GO

SELECT date_id,
       SUM(quantity * unit_price) AS total_price
FROM fact_sales
WHERE date_id BETWEEN 20190801 AND 20190831
GROUP BY date_id;
GO

SET STATISTICS XML OFF;
GO
Související obsah
- Odkaz na operátory logického a fyzického plánu zobrazení
- přehled rozšířených událostí
- osvědčené postupy pro monitorování úloh pomocí úložiště dotazů
- Odhad kardinality (SQL Server)
- inteligentní zpracování dotazů v databázích SQL
- Priorita operátorů (Transact-SQL)
- přehled plánu provádění
- Performance Center pro databázový stroj SQL Serveru a službu Azure SQL Database