Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
Platí pro: SQL Server 2019 a starší služby Analysis Services Azure Analysis Services
 Fabric/ Power BI Premium
Důležité
Dolování dat bylo v SQL Serveru 2017 Analysis Services zastaralé a nyní ukončeno ve službě SQL Server 2022 Analysis Services. Dokumentace se neaktualizuje pro zastaralé a ukončené funkce. Další informace najdete v tématu Zpětná kompatibilita služby Analysis Services.
Toto téma popisuje obsah modelu dolování, který je specifický pro modely používající algoritmus Microsoft Decision Trees. Obecné vysvětlení obsahu modelu dolování pro všechny typy modelů naleznete v tématu Obsah modelu dolování (Analysis Services - Data Mining). Je důležité si uvědomit, že algoritmus Rozhodovací stromy Microsoftu je hybridní algoritmus, který může vytvářet modely s velmi různými funkcemi: rozhodovací strom může představovat asociace, pravidla nebo dokonce lineární regresi. Struktura stromu je v podstatě stejná, ale způsob interpretace informací bude záviset na účelu, pro který jste vytvořili model.
Principy struktury modelu rozhodovacích stromů
Model rozhodovacích stromů má jeden nadřazený uzel, který představuje model a jeho metadata. Pod nadřazeným uzlem jsou nezávislé stromy, které představují předvídatelné atributy, které vyberete. Pokud například nastavíte model rozhodovacího stromu tak, aby předpověděl, jestli si zákazníci něco koupí, a poskytnete vstupy pro pohlaví a příjmy, vytvoří model jeden strom pro atribut nákupu s mnoha větvemi, které rozdělují podmínky související s pohlavím a příjmem.
Pokud ale přidáte samostatný předvídatelný atribut pro účast v programu zákaznické odměny, algoritmus vytvoří dva samostatné stromy pod nadřazeným uzlem. Jeden strom obsahuje analýzu nákupu a druhý strom obsahuje analýzu programu Customer Rewards. Pokud k vytvoření modelu přidružení použijete algoritmus Rozhodovací stromy, vytvoří algoritmus samostatný strom pro každý predikovaný produkt a strom obsahuje všechny ostatní kombinace produktů, které přispívají k výběru cílového atributu.
Poznámka:
Pokud váš model obsahuje více stromů, můžete v prohlížeči Microsoft Tree Viewer zobrazit jenom jeden strom najednou. V prohlížeči Obecný strom obsahu se ale v rámci stejném modelu zobrazují všechny stromy současně.
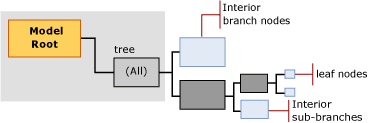
Strom pro každý předvídatelný atribut obsahuje informace, které popisují, jak vstupní sloupce, které zvolíte, ovlivňují výsledek tohoto konkrétního předvídatelného atributu. Každý strom směřuje k uzlu (NODE_TYPE = 9), který obsahuje předvídatelný atribut, za kterým následuje řada uzlů (NODE_TYPE = 10), které představují vstupní atributy. cs-CZ: Atribut odpovídá sloupci na úrovni případu nebo hodnotám sloupců ve vnořené tabulce, což jsou obecně hodnoty ve sloupci Klíč ve vnořené tabulce.
Vnitřní a listové uzly představují rozdělené podmínky. Strom se může vícekrát rozdělit na základě stejného atributu. Například model TM_DecisionTree se může rozdělit na [Roční příjem] a [Počet dětí] a potom znovu rozdělit na [Roční příjem] dále dolů ve stromu.
Algoritmus Rozhodovací stromy Microsoftu může také obsahovat lineární regrese ve všech nebo částech stromu. Pokud je atribut, který modelujete, souvislý číselný datový typ, může model vytvořit uzel regresního stromu (NODE_TYPE = 25), kdykoli je možné modelovat lineární vztah mezi atributy. V tomto případě uzel obsahuje regresní vzorec.
Pokud má však předvídatelný atribut diskrétní hodnoty nebo pokud byly číselné hodnoty rozděleny do kbelíku nebo diskretizovány, model vždy vytvoří klasifikační strom (NODE_TYPE =2). Klasifikační strom může mít více větví nebo vnitřních uzlů stromu (NODE_TYPE =3) pro každou hodnotu atributu. Rozdělení však nemusí nutně odpovídat každé hodnotě atributu.
Algoritmus Rozhodovací stromy Microsoftu neumožňuje průběžné datové typy jako vstupy; pokud tedy některé sloupce mají souvislý číselný datový typ, hodnoty jsou diskretizovány. Algoritmus provádí vlastní diskretizaci v okamžiku rozdělení pro všechny průběžné atributy.
Poznámka:
SQL Server Analysis Services automaticky zvolí metodu pro rozdělení spojitých atributů; můžete však řídit diskretizaci spojitých hodnot ve vstupech nastavením typu obsahu sloupce dolovací struktury na Discretized a pak nastavením vlastnosti DiscretizationBucketCount nebo DiscretizationMethod.
Obsah modelu pro model rozhodovacích stromů
Tato část obsahuje podrobnosti a příklady pouze pro tyto sloupce v obsahu modelu dolování, které mají zvláštní význam pro modely rozhodovacích stromů. Informace o sloupcích pro obecné účely v sadě řádků schématu a vysvětlení terminologie modelu dolování naleznete v tématu Obsah modelu dolování (Analysis Services - Data Mining).
Katalog modelů
Název databáze, ve které je model uložený.
MODEL_NAME
Název modelu
NÁZEV_ATTRIBUTU
Název atributu, který odpovídá tomuto uzlu.
NODE_NAME
Vždy stejné jako NODE_UNIQUE_NAME.
NODE_UNIQUE_NAME
Jedinečný identifikátor uzlu v rámci modelu. Tuto hodnotu nelze změnit.
U modelů rozhodovacího stromu se jedinečné názvy řídí následující konvencí, která se nevztahuje na všechny algoritmy:
Podřízené uzly každého konkrétního uzlu budou mít stejnou šestnáctkovou předponu následovanou jiným šestnáctkovým číslem, které představuje sekvenci podřízeného uzlu v rámci nadřazeného objektu. K odvození cesty můžete použít předpony.
NODE_TYPE
V modelech rozhodovacího stromu se vytvoří následující typy uzlů:
| Typ uzlu | Description |
|---|---|
| 1 (model) | Kořenový uzel pro model. |
| 2 (strom) | Kořenový uzel pro klasifikační stromy v modelu Označeno jako "Vše". |
| 3 (interiér) | Hlava vnitřní větve, která se nachází v klasifikačním stromu nebo regresním stromu. |
| 4 (distribuce) | Uzel typu list, který se nachází ve stromu klasifikace nebo ve stromu regrese |
| 25 (regresní strom) | Nadřazený uzel pro regresní strom v rámci modelu. Označeno jako "Vše". |
NODE_CAPTION
Přátelský název pro účely zobrazení.
Při vytváření modelu se hodnota NODE_UNIQUE_NAME automaticky použije jako titulek. Hodnotu NODE_CAPTION ale můžete změnit tak, aby se zobrazovaný název clusteru aktualizoval buď prostřednictvím kódu programu, nebo pomocí prohlížeče. Titulek se automaticky vygeneruje modelem. Obsah titulku závisí na typu modelu a typu uzlu.
V modelu rozhodovacích stromů mají NODE_CAPTION a NODE_DESCRIPTION různé informace v závislosti na úrovni stromu. Další informace a příklady najdete v tématu Titulek uzlu a Popis uzlu.
CHILDREN_CARDINALITY
Odhad počtu podřízených uzlů, které uzel má.
Nadřazený uzel Určuje počet předvídatelných atributů, které byly modelovány. Pro každý předvídatelný atribut se vytvoří strom.
Uzel stromu Uzel Vše pro každý strom vám řekne, kolik hodnot se pro cílový atribut použilo.
Pokud je cílový atribut diskrétní, hodnota se rovná počtu jedinečných hodnot plus 1 pro chybějící stav.
Pokud je předvídatelný atribut průběžný, hodnota vám řekne, kolik kbelíků bylo použito k modelování průběžného atributu.
Listové uzly Vždy 0.
PARENT_UNIQUE_NAME
Jedinečný název nadřazeného uzlu. Hodnota NULL se vrátí pro všechny uzly na kořenové úrovni.
Popis_uzlu
Popis uzlu.
V modelu rozhodovacích stromů mají NODE_CAPTION a NODE_DESCRIPTION různé informace v závislosti na úrovni stromu.
Další informace a příklady najdete v tématu Titulka uzlu a Popis uzlu.
NODE_RULE
Popis xml pravidla, které popisuje cestu k aktuálnímu uzlu z jeho bezprostředního nadřazeného uzlu.
Další informace a příklady najdete v tématu Pravidlo uzlu a Mezní pravidlo.
MARGINAL_RULE
Popis XML pravidla, které popisuje cestu z nadřazeného uzlu modelu k aktuálnímu uzlu.
Další informace najdete v tématu Pravidlo uzlu a Mezní pravidlo.
NODE_PROBABILITY
Pravděpodobnost přidružená k tomuto uzlu.
Další informace naleznete v tématu Pravděpodobnost.
MARGINAL_PROBABILITY
Pravděpodobnost dosažení uzlu z nadřazeného uzlu.
Další informace naleznete v tématu Pravděpodobnost.
NODE_DISTRIBUTION
Tabulka obsahující histogram pravděpodobnosti uzlu. Informace v této tabulce se liší v závislosti na tom, jestli je předvídatelný atribut souvislou nebo diskrétní proměnnou.
Kořenový uzel modelu Tato tabulka je prázdná.
(Všezahrnující uzel) Obsahuje souhrn celého modelu.
Vnitřní uzel Obsahuje agregované statistiky pro listové uzly.
Uzel typu list Obsahuje podporu a pravděpodobnost pro predikované výsledky za předpokladu všech podmínek v cestě vedoucí k aktuálnímu uzlu typu list.
Regresní uzel Obsahuje regresní vzorec, který představuje vztah mezi vstupy a předvídatelným atributem.
Další informace najdete v tématu Distribuce uzlů pro diskrétní atributy a distribuci uzlů pro průběžné atributy.
NODE_SUPPORT
Počet případů, které podporují tento uzel.
MSOLAP_MODEL_COLUMN
Označuje sloupec, který obsahuje předvídatelný atribut.
MSOLAP_NODE_SCORE
Zobrazí skóre přidružené k uzlu. Další informace najdete v tématu Skóre uzlu.
MSOLAP_NODE_SHORT_CAPTION
Popisek použitý pro účely zobrazení.
Poznámky
Model rozhodovacích stromů nemá samostatný uzel, který ukládá statistiky pro celý model, na rozdíl od hraničního uzlu statistiky nalezeného v modelu naive Bayes nebo neurální sítě. Místo toho model vytvoří samostatný strom pro každý předvídatelný atribut s uzlem (Vše) v horní části stromu. Každý strom je nezávislý na ostatních. Pokud váš model obsahuje pouze jeden předvídatelný atribut, existuje pouze jeden strom, a proto pouze jeden (vše) uzel.
Každý strom, který představuje výstupní atribut, je navíc rozdělen do vnitřních větví (NODE_TYPE = 3), které představují rozdělení. Každý z těchto stromů obsahuje statistiky o rozdělení cílového atributu. Kromě toho každý uzel typu list (NODE_TYPE = 4) obsahuje statistiky, které popisují vstupní atributy a jejich hodnoty spolu s počtem případů podpory jednotlivých párů atribut-hodnota. Proto v libovolné větvi rozhodovacího stromu můžete snadno zobrazit pravděpodobnosti nebo distribuci dat, aniž byste museli dotazovat zdrojová data. Každá úroveň stromu nutně představuje součet jeho bezprostředních podřízených uzlů.
Příklady načtení těchto statistik najdete v tématu Příklady dotazů modelu rozhodovacích stromů.
Příklad struktury rozhodovacího stromu
Pokud chcete zjistit, jak rozhodovací strom funguje, zvažte příklad, například scénář kupujícího kol AdventureWorks. Za předpokladu, že předvídatelným atributem jsou nákupy zákazníků, algoritmus rozhodovacích stromů se snaží najít jeden sloupec dat, mezi všemi zadanými vstupy, které nejúčinněji zjistí zákazníky, kteří si pravděpodobně koupí kolo a ti, kteří si pravděpodobně nenakoupí kolo. Model může například zjistit, že Věk je nejlepším indikátorem nákupního chování. Konkrétně, že zákazníci starší než 30 let jsou velmi pravděpodobné, že si koupí kolo, a všichni ostatní zákazníci pravděpodobně nebudou nakupovat. V tomto scénáři model vytvoří rozdělení na atributu Age. To znamená, že strom se dělí na dvě větve, jedna obsahující zákazníky ve věku 30 let a druhá obsahující zákazníky do 30 let. Nové větve jsou ve struktuře modelu reprezentovány jako dva nové vnitřní stromy (NODE_TYPE = 3).
Pro každou větev model nadále hledá další atributy, které se mají použít při odlišování zákazníků. Pokud v datech není dostatek důkazů, aby mohli pokračovat ve vytváření podskupin zákazníků, model přestane strom vytvářet. Model také zastaví vytváření stromu vždy, když je počet případů v uzlu příliš malý na pokračování, bez ohledu na to, jak dobré je rozdělení, nebo pokud je hodnota nulová či chybí. Tím, že zastavíte růst stromu dříve, zabráníte modelu v příliš úzkém trénování na jednu konkrétní sadu dat.
Každý vnitřní uzel stromu obsahuje uzly typu list, které poskytují podrobný rozklad výsledků s ohledem na aktuální výsledky klasifikace. Můžete například mít vnitřní uzel, který představuje Věk >= 30 a Pohlaví = Muž. Uzel pro tuto skupinu ukazuje, kolik zákazníků v této kategorii zakoupilo nebo si něco nekoupili. Klasifikace může například obsahovat následující rozdělení stromu:
| Vnitřní strom | Split |
|---|---|
| Věk >= 30 | Věk >= 30 a pohlaví = muž |
| Věk >= 30 a pohlaví = Žena | |
| Věk 30 let < | Věk < 30 a pohlaví = muž |
| Věk < 30 a pohlaví = Žena |
Když použijete model rozhodovacího stromu pro predikci, model převezme atributy, které mu zadáte jako argumenty, a sleduje cestu atributů směrem dolů přes strom. Obecně platí, že všechny předpovědi přejdou na list a vnitřní uzly se používají pouze pro klasifikaci.
Uzel typu list má vždy NODE_TYPE 4 (distribuce) a obsahuje histogram, který sděluje pravděpodobnost každého výsledku (nákup nebo nekupování) vzhledem k zadaným atributům. Pokud například požádáte o předpověď pro nového zákazníka, který je mužem nad 60, model vyhledá odpovídající uzel (věk > 30 a pohlaví = muž) a vrátí pravděpodobnost zadaného výsledku. Tyto pravděpodobnosti jsou uloženy v tabulce NODE_DISTRIBUTION pro uzel.
Pokud je předvídatelný atribut spojité číslo, algoritmus se pokusí vytvořit regresní vzorec, který modeluje vztah mezi předvídatelným atributem a vstupy.
Titulek uzlu a Popis uzlu
Titulek uzlu a popis uzlu v modelu rozhodovacího stromu obsahují podobné informace. Popis uzlu je ale úplnější a obsahuje další informace, když se přesunete blíž k uzlům typu list. Titulky uzlu i popis uzlu jsou lokalizované řetězce.
| Sloupec | Description |
|---|---|
| Zobrazí atribut, který odlišuje daný uzel vzhledem k nadřazenému uzlu. Titulek uzlu definuje podmnožinu populace na základě podmínky rozdělení. Například pokud bylo rozdělení na základě [Věk] a jednalo se o třísložkové rozdělení, popisky uzlů pro tři podřízené uzly mohou být "[Věk] < 40", "40 <= [Věk] < 50", "[Věk] >= 50". | |
| NODE_DESCRIPTION | Obsahuje úplný seznam atributů, které rozlišují tento uzel od jiných uzlů počínaje nadřazeným uzlem modelu. Například Název produktu = Apple a Color = Červená. |
Pravidlo uzlu a okrajové pravidlo
Sloupce NODE_RULE a MARGINAL_RULE obsahují stejné informace jako sloupce NODE_CAPTION a NODE_DESCRIPTION, ale představují informace jako fragmenty XML. Verze XML pravidla uzlu odpovídá úplné cestě, zatímco dílčí pravidlo označuje nejnovější rozdělení.
Atribut reprezentovaný fragmentem XML může být jednoduchý nebo složitý. Jednoduchý atribut obsahuje název sloupce modelu a hodnotu atributu. Pokud sloupec modelu obsahuje vnořenou tabulku, atribut vnořené tabulky je reprezentován jako zřetězení názvu tabulky, hodnoty klíče a atributu.
Poznámka:
SQL Server SQL Server Analysis Services podporuje verzi 2.0 standardu PMML s rozšířeními pro podporu použití vnořené tabulky. Pokud vaše data obsahují vnořené tabulky a vygenerujete verzi modelu PMML, označí se všechny prvky v modelu, které obsahují predikáty, jako rozšíření.
Distribuce uzlů pro diskrétní atributy
V modelu rozhodovacích stromů tabulka NODE_DISTRIBUTION obsahuje užitečné statistiky. Typ statistiky ale závisí na tom, jestli strom predikuje diskrétní nebo souvislý atribut. Tato část popisuje význam statistik distribuce uzlů pro diskrétní atributy.
Název atributu a hodnota atributu
Ve stromu klasifikace název atributu vždy obsahuje název předvídatelného sloupce. Tato hodnota vám řekne, co strom predikuje. Vzhledem k tomu, že jeden strom vždy představuje jeden předvídatelný atribut, tato hodnota se opakuje v celém stromu.
V případě diskrétního datového typu obsahuje pole hodnoty atributu seznam možných hodnot předvídatelného sloupce a chybějící hodnotu.
Support
Hodnota podpory pro každý uzel udává, kolik případů je v tomto uzlu zahrnuto. Na úrovni (Vše) byste měli vidět úplný počet případů, které byly použity k trénování modelu. Pro každé rozdělení ve stromu je hodnota podpory počet případů, které byly seskupeny do uzlu stromu. Součet případů v koncových uzlech musí odpovídat počtu případů v nadřazeném uzlu stromu.
U uzlů, které představují průběžné atributy, může přítomnost hodnot null v datech vést k některým neintuitivním výsledkům. Pokud existují například m případy, vypočítá se střední hodnota jako součet(všechny případy)/n, kde n je číslo menší než m a m-n označuje počet případů s chybějícími hodnotami. Podpora je také reprezentována jako n.
Pravděpodobnost
Pravděpodobnost spojená s každým uzlem vám ukazuje pravděpodobnost, že jakýkoliv případ z celé datové sady skončí v tomto konkrétním uzlu. Skóre pravděpodobnosti se vypočítávají jak pro strom jako celek, tak pro okamžité rozdělení.
Následující tabulka například ukazuje velmi jednoduchý model s 100 případy.
| Vnitřní strom | Případy | Uzel typu list | Případy | Pravděpodobnost relativní vzhledem k nadřazenému uzlu | Pravděpodobnost vzhledem k hornímu uzlu |
|---|---|---|---|---|---|
| Věk >= 30 | 60 | Věk >= 30 a pohlaví = muž | 50 | 50/60 = ,83 | 50/100 = ,5 |
| Věk >= 30 a pohlaví = Žena | 10 | 10/60 = ,16 | 10/100 = ,10 | ||
| Věk 30 let < | 40 | Věk < 30 a pohlaví = muž | 30 | 30/40 = ,75 | 30/100 = ,30 |
| Věk < 30 a pohlaví = Žena | 10 | 10/40 = ,25 | 10/100 = ,10 |
Ve všech modelech se provádí malá úprava, aby se zohlednily možné chybějící hodnoty. U spojitých atributů je každá hodnota nebo oblast hodnot reprezentována jako stav (například Věk <30, Věk = 30 a Věk >30) a pravděpodobnosti se počítají takto: stav existuje (hodnota = 1), existuje nějaký jiný stav (hodnota = 0), stav chybí. Další informace o tom, jak se pravděpodobnosti upraví tak, aby představovaly chybějící hodnoty, najdete v tématu Chybějící hodnoty (Analysis Services – Dolování dat).
Pravděpodobnosti pro každý uzel se vypočítají téměř přímo z rozdělení následujícím způsobem:
Pravděpodobnost = (podpora stavu + podpora pro předchozí stav) / (podpora uzlu plus podpora předchozího uzlu)
Služba SQL Server Analysis Services používá pravděpodobnosti pro každý uzel k porovnání uložené pravděpodobnosti s předchozí pravděpodobností, aby určila, jestli cesta z nadřazeného k podřízeného uzlu značí silné odvozování.
Při vytváření předpovědí musí být pravděpodobnost rozdělení vyvážena s pravděpodobností uzlu, aby se pravděpodobnosti vyhladily. Pokud například rozdělení ve stromu odděluje případy poměrem 9000/1000, strom je velmi nevyvážený. V důsledku toho by predikce pocházející z malé větve neměla mít stejnou váhu jako předpověď pocházející z větve s mnoha případy.
Odchylka
Rozptyl je míra, jak jsou hodnoty ve vzorku rozptýlené vzhledem k očekávanému rozdělení. Pro diskrétní hodnoty je rozptyl 0 podle definice.
Informace o tom, jak se vypočítá rozptyl pro souvislé hodnoty, naleznete v tématu Obsah modelu dolování pro lineární regresní modely (Analysis Services – Dolování dat).
Typ hodnoty
Sloupec typu hodnoty poskytuje informace o významu číselné hodnoty uvedené v ostatních sloupcích v tabulce NODE_DISTRIBUTION. Pomocí typu hodnoty v dotazech můžete načíst konkrétní řádky z vnořených tabulek. Příklady najdete v příkladech dotazů modelu rozhodovacích stromů.
Z typů v výčtu MiningValueType se v klasifikačních stromech používají následující typy.
| Typ hodnoty | Description |
|---|---|
| 1 (Chybí) | Označuje počet, pravděpodobnost nebo jinou statistiku související s chybějícími hodnotami. |
| 4 (diskrétní) | Označuje počet, pravděpodobnost nebo jinou statistiku související s diskrétní nebo diskretizovanou hodnotou. |
Pokud model obsahuje souvislý předvídatelný atribut, strom může obsahovat také typy hodnot, které jsou jedinečné pro regresní vzorce. Seznam hodnotových typů, které se používají v regresních stromech, naleznete v tématu Obsah modelu těžby pro lineární regresní modely (Analysis Services – Dolování dat).
Skóre uzlu
Skóre uzlu představuje mírně odlišné informace na každé úrovni stromu. Obecně platí, že skóre je číselná hodnota, která vám říká, jak kvalitní rozdělení bylo dosaženo použitím podmínky k rozdělení. Hodnota je reprezentována jako dvojitá, kde je lepší vyšší hodnota.
Podle definice má uzel modelu a všechny uzly typu list skóre 0.
Pro uzel (Vše), který představuje horní část každého stromu, obsahuje sloupec MSOLAP_NODE_SCORE nejlepší skóre rozdělení v celém stromu.
Pro všechny ostatní uzly ve stromu (s výjimkou uzlů typu list) skóre pro každý uzel představuje nejlepší skóre rozdělení pro aktuální uzel, od něhož se odečte skóre rozdělení nadřazeného uzlu. Skóre rozdělení nadřazeného uzlu by obvykle mělo být lepší než skóre rozdělení kteréhokoli z jeho podřízených uzlů. Je to proto, že model rozhodovacích stromů se v ideálním případě rozdělí na nejdůležitější atributy.
Poznámka:
Pokud vytvoříte model rozhodovacích stromů, který má průběžné i diskrétní předvídatelné atributy, zobrazí se v uzlech (Všechny) zcela odlišné skóre, které představují každý typ stromu. Každý model by měl být považován za nezávislý a metody použité pro regresi bodování se zcela liší od metod používaných pro klasifikaci bodování. Hodnoty skóre uzlu nelze porovnat.
Regresní uzly v rámci modelu rozhodovacího stromu
Pokud model rozhodovacích stromů obsahuje předvídatelný atribut s průběžnými číselnými daty, algoritmus Rozhodovací stromy Microsoftu hledá oblasti v datech, ve kterých je vztah mezi predikovaným stavem a vstupními proměnnými lineární. Pokud je algoritmus úspěšný při hledání lineární relace, vytvoří speciální strom (NODE_TYPE = 25), který představuje lineární regresi. Tyto regresní uzly stromu jsou složitější než uzly, které představují diskrétní hodnoty.
Regrese obecně mapuje změny v souvislé závislé (předvídatelné proměnné) jako funkci změn ve vstupech. Pokud závislá proměnná obsahuje nějaké souvislé vstupy a vztah mezi vstupem a predikovanou hodnotou je dostatečně stabilní, aby se počítal jako spojnicový graf, uzel pro regresi obsahuje vzorec.
Pokud je ale vztah mezi vstupem a predikovanou hodnotou nelineární, vytvoří se rozdělení stejně jako standardní rozhodovací strom. Předpokládejme například, že A je předvídatelný atribut a B a C jsou vstupy, kde C je typ souvislé hodnoty. Pokud je vztah mezi A a C poměrně stabilní v částech dat, ale nestabilní v jiných případech, algoritmus vytvoří rozdělení, které bude představovat různé oblasti dat.
| Podmínka rozdělení | Výsledek v uzlu |
|---|---|
| pokud n < 5 | Relace se dá vyjádřit jako rovnice 1. |
| pokud n mezi 5 a 10 | Bez rovnice |
| pokud n > 10 | Relace se dá vyjádřit jako rovnice 2. |
Další informace o regresních uzlech naleznete v Obsahu těžebního modelu pro lineární regresní modely (Služby analýzy - Dolování dat).
Viz také
Obsah modelu dolování (Analysis Services – Dolování dat)
Prohlížeče modelů dolování dat
Dotazy na dolování dat
Algoritmus rozhodovacích stromů Microsoftu