Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
Tento obsah platí pro:🟩v4.0 (GA) | Předchozí verze:🟦v3.1 (GA)🟥v3.0 (vyřazení)🟥v2.1 (vyřazení)
Tento obsah platí pro:🟥v3.0 (vyřazení) | Nejnovější verze:🟪v4.0 (GA)🟪v3.1 (GA) | Předchozí verze:🟥v2.1 (vyřazení)
Tento obsah platí pro:🟥v2.1 | Nejnovější verze:🟪v4.0 (GA)
Model účtenky Document Intelligence kombinuje výkonné funkce optického rozpoznávání znaků (OCR) s modely hlubokého učení, které analyzují a extrahují klíčové informace z prodejních účtenek. Účtenky můžou mít různé formáty a kvalitu včetně tištěných a rukou psaných účtenek. Rozhraní API extrahuje klíčové informace, jako je název obchodníka, telefonní číslo obchodníka, datum transakce, daň a celkový součet transakcí a vrací strukturovaná data JSON. Model účtenek v4.0 (GA) podporuje další pole, včetně ReceiptType, TaxDetails.NetAmountTaxDetails.Description, TaxDetails.Rate a CountryRegion spolu s extrahováním tabulek DPH na obecných účtech hotelů.
Extrakce údajů z účtenek
Digitalizace účtenek zahrnuje transformaci různých typů účtenek, včetně naskenovaných, fotografovaných a tištěných kopií, do digitálního formátu pro zjednodušené zpracování podřízeného procesu. Mezi příklady patří správa výdajů, analýza chování spotřebitelů, automatizace daní atd. Použití technologie Document Intelligence s technologií OCR (Optické rozpoznávání znaků) může extrahovat a interpretovat data z těchto různých formátů účtenek. Zpracování funkce Document Intelligence zjednodušuje proces převodu, ale také výrazně zkracuje čas a úsilí, což usnadňuje efektivní správu dat a načítání.
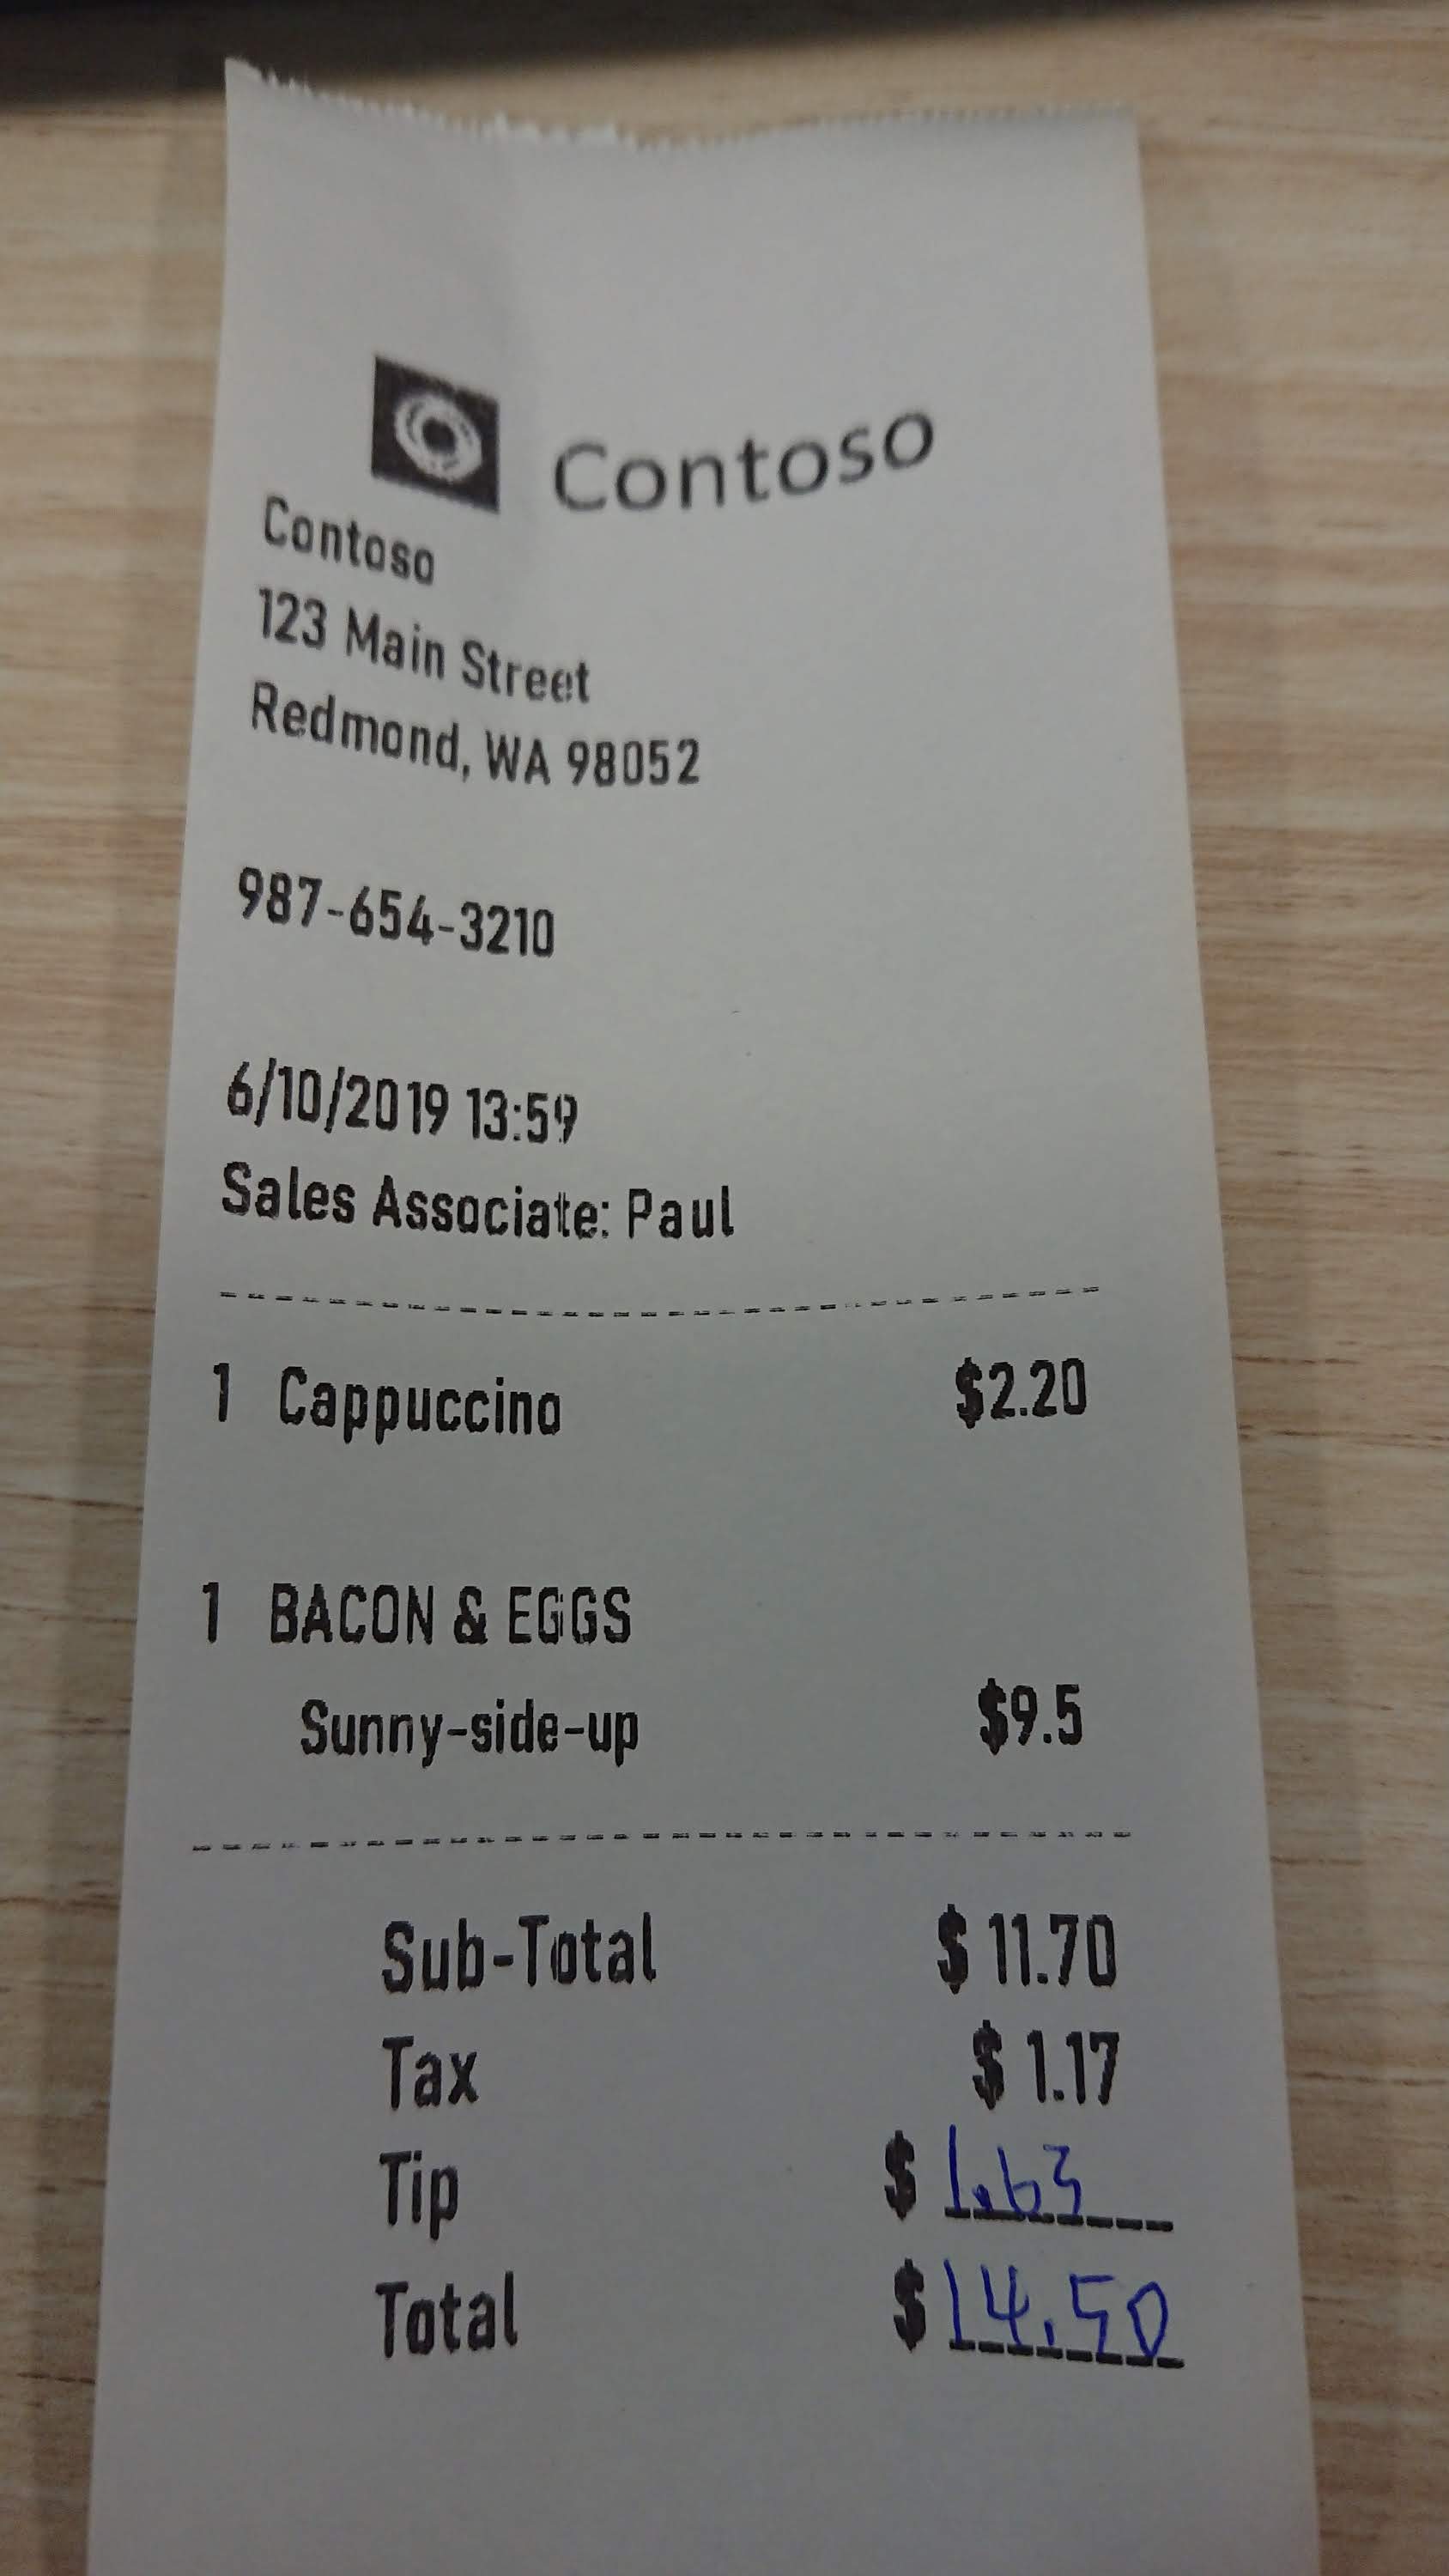
Ukázková účtenka zpracovaná s využitím nástroje Document Intelligence Studio:

Ukázková účtenka zpracována pomocí nástroje Document Intelligence Sample Labeling:

Možnosti vývoje
Document Intelligence v4.0: 2024-11-30 (GA) podporuje následující nástroje, aplikace a knihovny:
| Funkce | Zdroje | ID modelu |
|---|---|---|
| Model účtenek | • |
předem připravený doklad |
Document Intelligence v3.1 podporuje následující nástroje, aplikace a knihovny:
| Funkce | Zdroje | ID modelu |
|---|---|---|
| Model účtenek | • |
předem připravený doklad |
Document Intelligence v3.0 podporuje následující nástroje, aplikace a knihovny:
| Funkce | Zdroje | ID modelu |
|---|---|---|
| Model účtenek | • |
předem připravený doklad |
Document Intelligence v2.1 podporuje následující nástroje, aplikace a knihovny:
| Funkce | Zdroje |
|---|---|
| Model účtenek | • Nástroj Document Intelligence pro označování • REST API • klientská knihovna SDK • Document Intelligence kontejner Docker |
Požadavky na vstup
Podporují se následující formáty souborů.
| Model | soubor PDF | Obrázek: JPEG/JPG, PNG, BMP, TIFF, HEIF |
Office: Word (DOCX), Excel (XLSX), PowerPoint (PPTX), HTML |
|---|---|---|---|
| Číst | ✔ | ✔ | ✔ |
| Rozložení | ✔ | ✔ | ✔ |
| Obecný dokument | ✔ | ✔ | |
| Předem sestavené | ✔ | ✔ | |
| Vlastní extrakce | ✔ | ✔ | |
| Vlastní klasifikace | ✔ | ✔ | ✔ |
- Fotky a skenování: Nejlepších výsledků dosáhnete tak, že poskytnete jednu jasnou fotku nebo vysoce kvalitní skenování na dokument.
- SOUBORY PDF a TIFF: U souborů PDF a TIFF je možné zpracovat až 2 000 stránek. (S předplatným úrovně Free se zpracovávají pouze první dvě stránky.)
- Velikost souboru: Velikost souboru pro analýzu dokumentů je 500 MB pro placenou úroveň (S0) a 4 MB pro bezplatnou úroveň (F0).
- Rozměry obrázku: Rozměry musí být mezi 50 pixely x 50 pixelů a 10 000 pixelů x 10 000 pixelů.
- Zámky hesel: Pokud jsou soubory PDF uzamčené heslem, musíte zámek před odesláním odebrat.
- Výška textu: Minimální výška extrahovaného textu je 12 pixelů pro obrázek o velikosti 1024 x 768 pixelů. Tento rozměr odpovídá přibližně 8bodovému textu při 150 bodech na palec.
- Trénování vlastního modelu: Maximální počet stránek pro trénovací data je 500 pro vlastní model šablony a 50 000 pro vlastní neurální model.
- Trénování vlastního modelu extrakce: Celková velikost trénovacích dat je 50 MB pro model šablony a 1 GB pro neurální model.
- Trénování modelu vlastní klasifikace: Celková velikost trénovacích dat je 1 GB s maximálně 10 000 stránkami. V případě 2024-11-30 (GA) je celková velikost trénovacích dat 2 GB s maximálně 10 000 stránkami.
- Typy souborů Office (DOCX, XLSX, PPTX):: Maximální limit délky řetězce je 8 milionů znaků.
- Podporované formáty souborů: JPEG, PNG, PDF a TIFF.
- Podporovaný počet stran pro PDF a TIFF: Funkce Document Intelligence může zpracovat až 2 000 stránek pro předplatitele standardní úrovně nebo pouze první dvě stránky pro předplatitele bezplatné úrovně.
- Podporovaná velikost souboru: menší než 50 MB; minimální pixely 50 x 50 px; maximálně 10 000 × 10 000 pixelů.
Extrakce dat účtenkového modelu
Podívejte se, jak funkce Document Intelligence extrahuje data, včetně času a data transakcí, informací o obchodních údajích a součtů částky z účtenek. Potřebujete následující zdroje informací:
Předplatné Azure – můžete vytvořit zdarma.
Instance Document Intelligence na portálu Azure. K vyzkoušení služby můžete použít cenovou úroveň Free (
F0). Po nasazení prostředku vyberte Přejít k prostředku a získejte klíč a koncový bod.

Poznámka
Document Intelligence Studio je k dispozici s rozhraními API v3.1 a v3.0 a novějšími verzemi.
Na domovské stránce nástroje Document Intelligence Studio vyberte Potvrzení.
Můžete analyzovat ukázkové potvrzení nebo nahrát vlastní soubory.
Vyberte tlačítko Spustit analýzu a v případě potřeby nakonfigurujte možnosti Analyzovat:

Nástroj pro označování vzorků Document Intelligence
Přejděte na Document Intelligence Sample Tool.
Na domovské stránce ukázkového nástroje vyberte dlaždici Použít předem vytvořený model pro získání dat.

V rozevírací nabídce vyberte typ formuláře , který chcete analyzovat.
Vyberte adresu URL souboru, který chcete analyzovat, z následujících možností:
V poli Zdroj vyberte adresu URL z rozevírací nabídky, vložte vybranou adresu URL a vyberte tlačítko Načíst .

Do pole koncový bod služby Document Intelligence vložte koncový bod, který jste získali s předplatným Document Intelligence.
Do pole s klíčem vložte klíč, který jste získali z prostředku Document Intelligence.

Vyberte Spustit analýzu. Nástroj pro označování vzorků Document Intelligence volá předdefinované rozhraní API Analyze a analyzuje dokument.
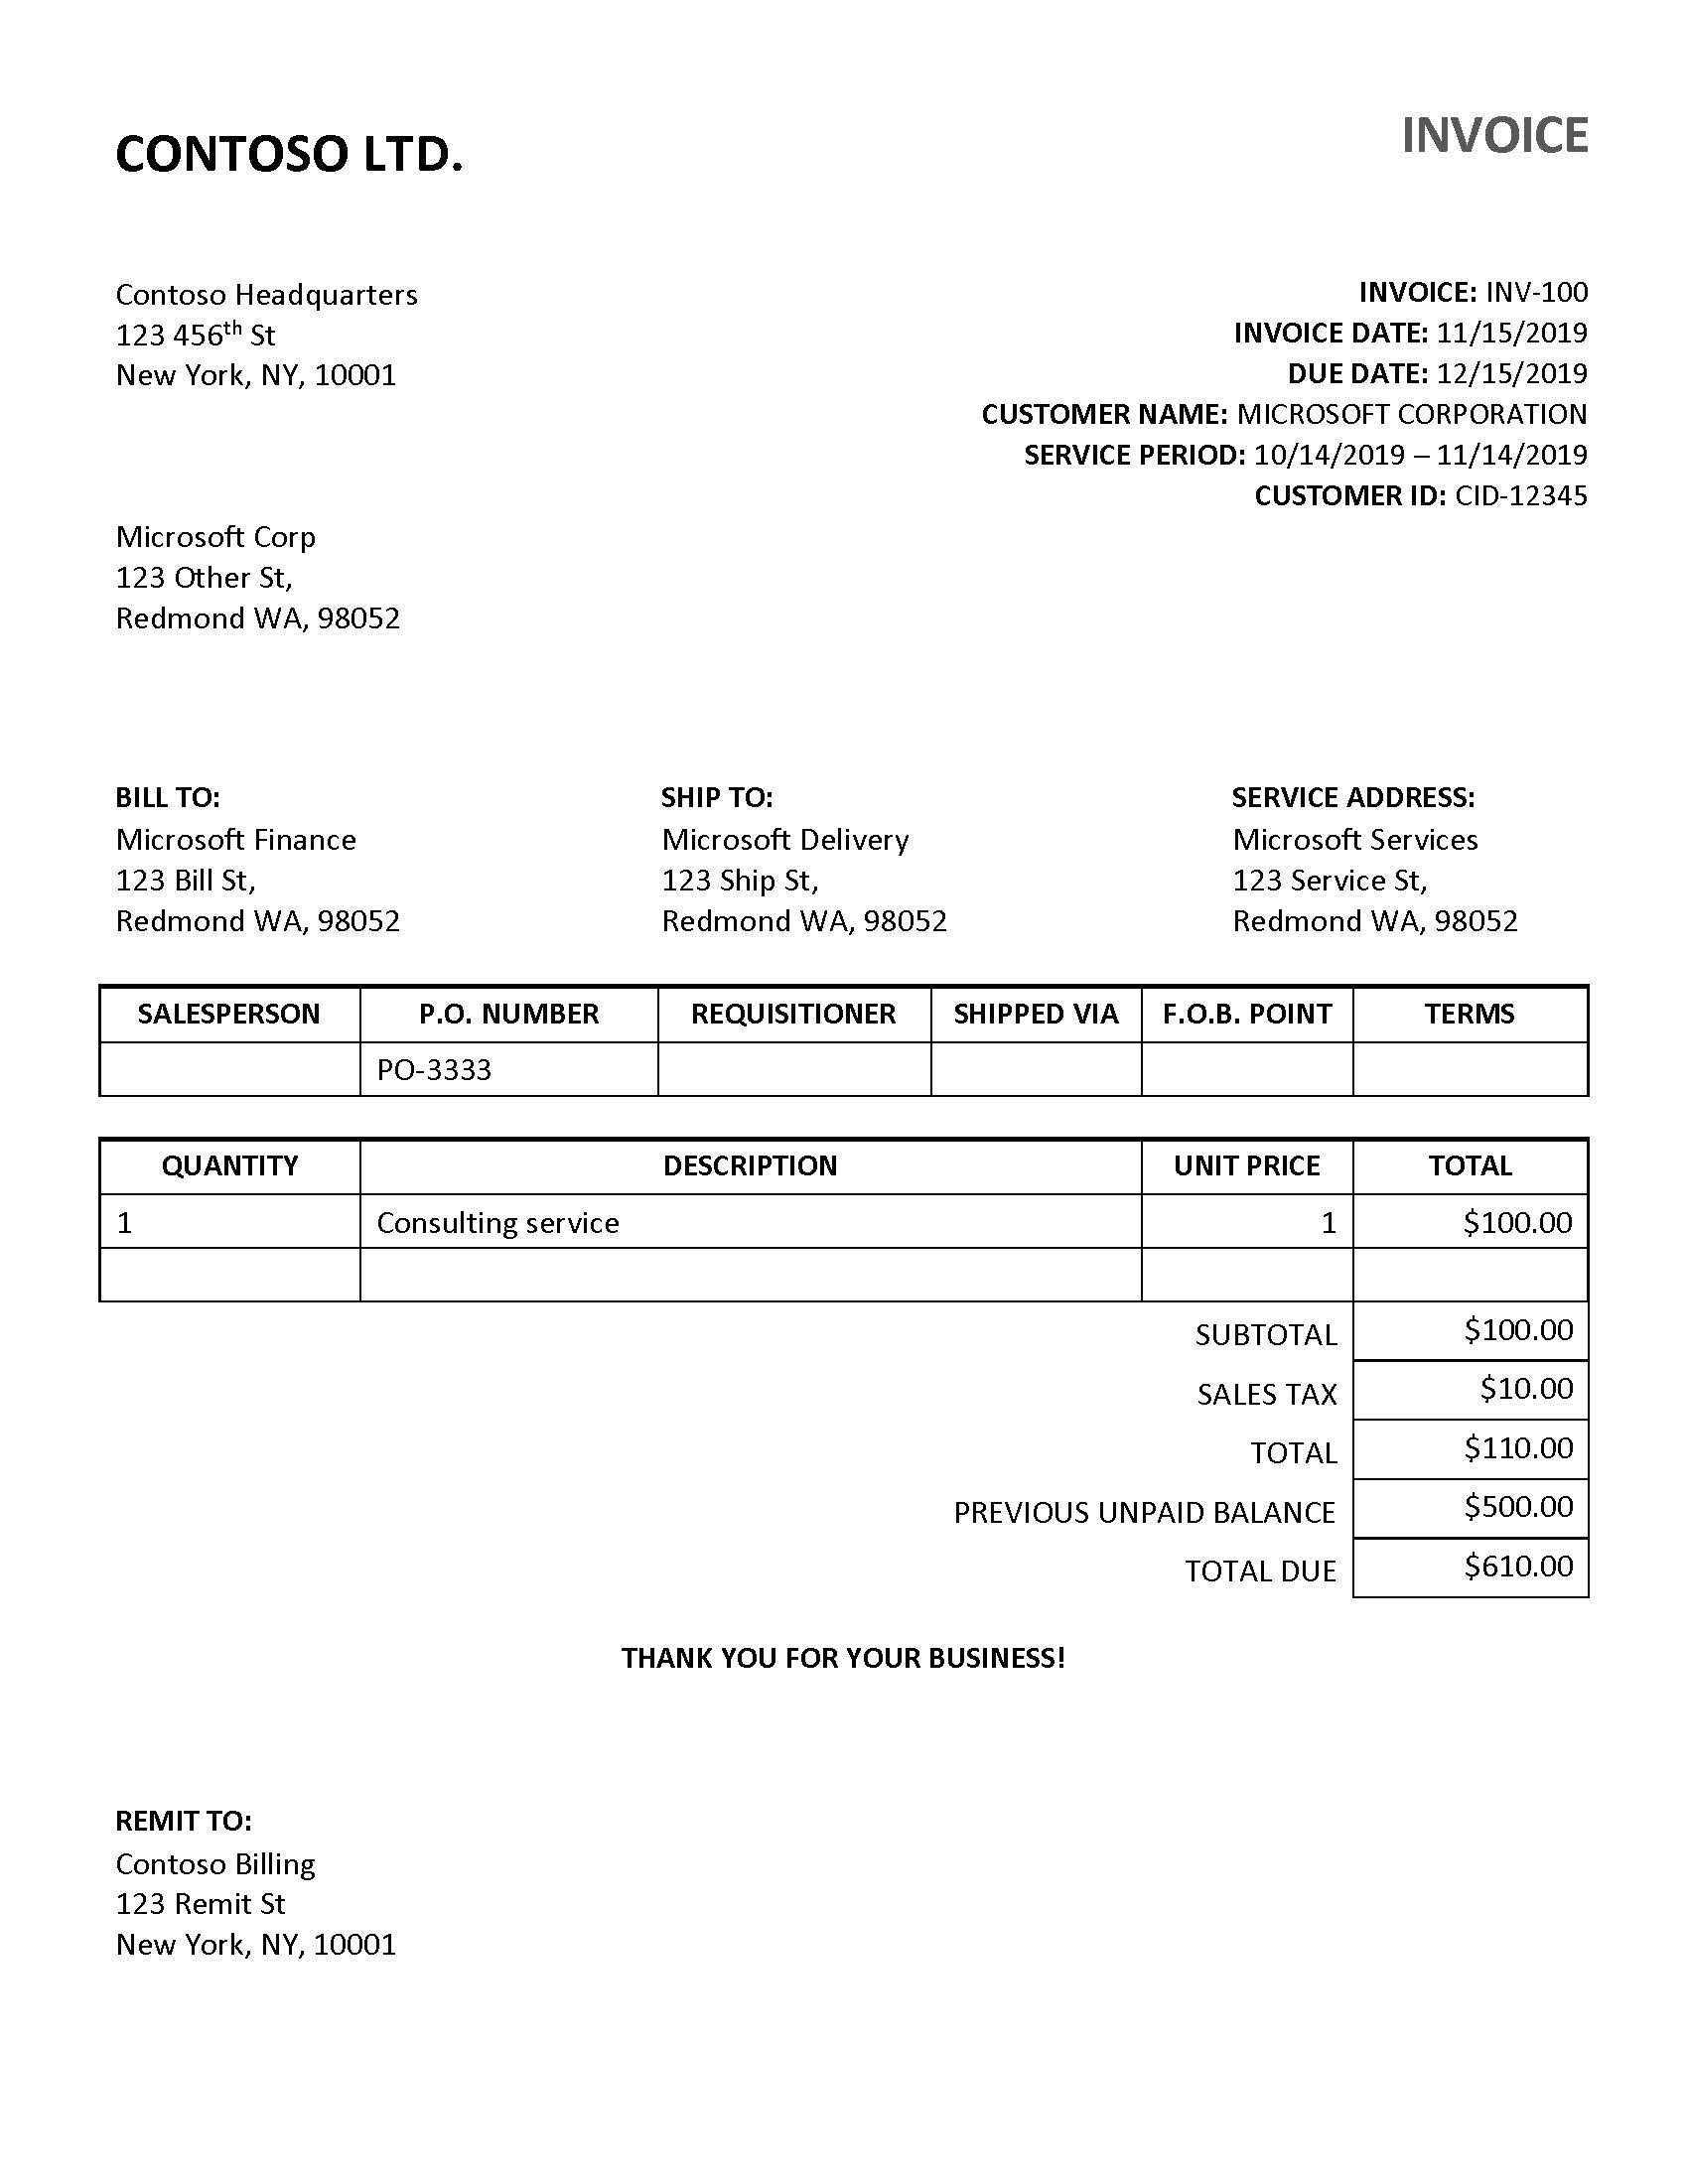
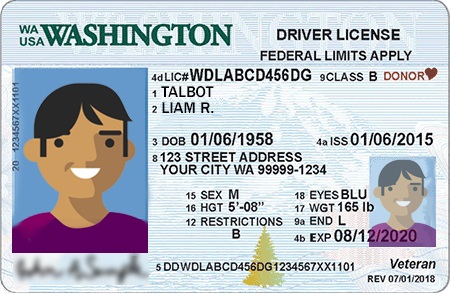
Prohlédněte si výsledky – prohlédněte si páry klíč-hodnota extrahované, řádkové položky, zvýrazněný text extrahovaný a zjištěné tabulky.


Poznámka
Nástroj Sample Labeling nepodporuje formát souboru BMP. Jedná se o omezení nástroje, nikoli služby Document Intelligence.
Podporované jazyky a národní prostředí
Úplný seznam podporovaných jazyků najdete na naší stránce podpory předem připravených modelů .
Extrakce polí
Pole podporovaná pro extrakci dokumentů jsou uvedena na stránce modelu příjmového schématu v ukázkovém úložišti na GitHubu.
| Jméno | Typ | Popis | Standardizovaný výstup |
|---|---|---|---|
| TypDokladu | Řetězec | Typ potvrzení o prodeji | Položkový seznam |
| MerchantName | Řetězec | Název obchodníka vydávajícího účtenku | |
| Telefonní číslo obchodníka | Telefonní číslo | Uvedené telefonní číslo obchodníka | +1 xxx xxx xxxx |
| AdresaObchodníka | Řetězec | Uvedená adresa obchodníka | |
| Datum transakce | Datum | Datum vystavení potvrzení | yyyy-mm-dd |
| Čas transakce | Čas | Čas vydání účtenky | hh-mm-ss (24 hodin) |
| Celkem | Číslo (USD) | Celkový součet příjmu za celou transakci | Dvojciferný číslo s desetinnou čárkou |
| Dílčí součet | Číslo (USD) | Mezisoučet příjmu, často před uplatněním daní | Dvojciferný číslo s desetinnou čárkou |
| Daň | Číslo (USD) | Celková daň z příjmu (často daň z prodeje nebo ekvivalent). Přejmenováno na TotalTax ve verzi 2022-06-30. | Dvojciferný číslo s desetinnou čárkou |
| Tip | Číslo (USD) | Tip zahrnutý kupujícím | Dvojciferný číslo s desetinnou čárkou |
| Položky | Pole objektů | Extrahované řádkové položky s názvem, množstvím, jednotkovou cenou a extrahovanou celkovou cenou | |
| Jméno | Řetězec | Popis položky Přejmenováno na "Popis" ve verzi 2022-06-30. | |
| Množství | Číslo | Množství každé položky | Dvojciferný číslo s desetinnou čárkou |
| Cena | Číslo | Individuální cena každé jednotky položky | Dvojciferný číslo s desetinnou čárkou |
| Celková cena | Číslo | Celková cena řádkové položky | Dvojciferný číslo s desetinnou čárkou |
Průvodce migrací a rozhraní REST API verze 3.1
- Postupujte podle našeho průvodce migrací Document Intelligence v3.1 a zjistěte, jak používat verzi v3.1 ve vašich aplikacích a pracovních postupech.
Další kroky
Zkuste pomocí nástroje Document Intelligence Studio zpracovat vlastní formuláře a dokumenty.
Dokončete rychlý start s funkcí Document Intelligence a začněte vytvářet aplikaci pro zpracování dokumentů ve zvoleném vývojovém jazyce.
Zkuste zpracovat vlastní formuláře a dokumenty pomocí nástroje Document Intelligence Sample Labeling.
Dokončete rychlý start s funkcí Document Intelligence a začněte vytvářet aplikaci pro zpracování dokumentů ve zvoleném vývojovém jazyce.