Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
Efektivní umístění a optimalizace úloh GPU často vyžaduje přehled o využití a výkonu prostředků. Spravované metriky GPU v AKS (Preview) poskytují automatizované shromažďování a vystavení dat o využití GPU, paměti a výkonu ve fondech uzlů s podporou GPU NVIDIA. To umožňuje správcům platformy optimalizovat prostředky clusteru a vývojářům ladit a debugovat úlohy s omezenou ruční instrumentací.
V tomto článku se dozvíte o metrikách GPU shromážděných exportérem NVIDIA Data Center GPU Manager (DCGM) s plně spravovaným fondem uzlů s podporou GPU ve verzi Preview ve službě Azure Kubernetes Service (AKS).
Důležité
Funkce AKS ve verzi Preview jsou k dispozici na bázi samoobsluhy a dobrovolného přihlášení. Ukázky jsou poskytovány "jak jsou" a "podle aktuální dostupnosti" a jsou vyloučené ze smluv o úrovni služeb a omezené záruky. Předběžné verze AKS jsou částečně pokryty zákaznickou podporou podle možností. Proto tyto funkce nejsou určené pro produkční použití. Další informace najdete v následujících článcích podpory:
Požadavky
- Cluster AKS s plně spravovaným fondem uzlů s podporou GPU (náhled) a je potřeba zajistit, že jsou GPU plánovatelné.
- Ukázková úloha GPU nasazená ve fondu uzlů.
- Azure managed Prometheus povoleno ve vašem clusteru AKS.
Ověřte, že jsou nainstalované spravované komponenty GPU.
Po vytvoření spravovaného fondu uzlů NVIDIA GPU (Preview) podle těchto pokynů ověřte, že se softwarové komponenty GPU nainstalovaly pomocí příkazu az aks nodepool show :
az aks nodepool show \
    --resource-group <resource-group-name> \
    --cluster-name <cluster-name> \
    --name <node-pool-name> \
Výstup by měl obsahovat následující hodnoty:
  ...
  "gpuProfile": {
      "driver": "Install",
      "driverType": "",
      "nvidia": {
          "managementMode": "Managed",
          ...
          ...
      }
  },
...
...
Úprava sběru metrik GPU ve spravovaném Azure Prometheus
Vytvořte a použijte objekt ConfigMap, který umožňuje profil scraping pro metriky NVIDIA GPU z dcgm-exporter v agentu Azure Monitor v rámci oboru názvů kube-system podobně, jako je následující:
cat <<EOF | kubectl create -f -
kind: ConfigMap
apiVersion: v1
data:
  schema-version:
    v1
  config-version:
    ver1
  default-scrape-settings-enabled: |-
    dcgmexporter = true
metadata:
  name: ama-metrics-settings-configmap
  namespace: kube-system
EOF
Note
Po použití tohoto objektu ConfigMap v clusteru AKS se všechny existující a nové fondy uzlů NVIDIA GPU přidané do clusteru automaticky sešrotují.
Zakázání automatického scrapování metrik GPU ve Azure spravovaném systému Prometheus
Pokud chcete zakázat sběr metrik NVIDIA DCGM agentem Prometheus (AMA) spravovaným Azure Monitor, upravte stejnou mapu ConfigMap. Vaše úlohy GPU nejsou ovlivněné.
Spusťte následující příkaz:
kubectl edit configmap ama-metrics-settings-configmap -n kube-system
Aktualizujte nastavení z true na false:
...
...
default-scrape-settings-enabled: |-
  dcgmexporter = false
...
...
Metriky NVIDIA DCGM se už nezobrazují v Azure Monitor nebo Průzkumníku metrik.
Monitorování metrik GPU na portálu Azure
Po vytvoření pracovního prostoru Azure Monitor pro cluster AKS přejděte na portál Azure a otevřete Azure Monitor> a Nástěnky s Grafanou ve vašem pracovním prostoru Azure Monitor.
Pomocí panelu hledání vyfiltrujte řídicí panel
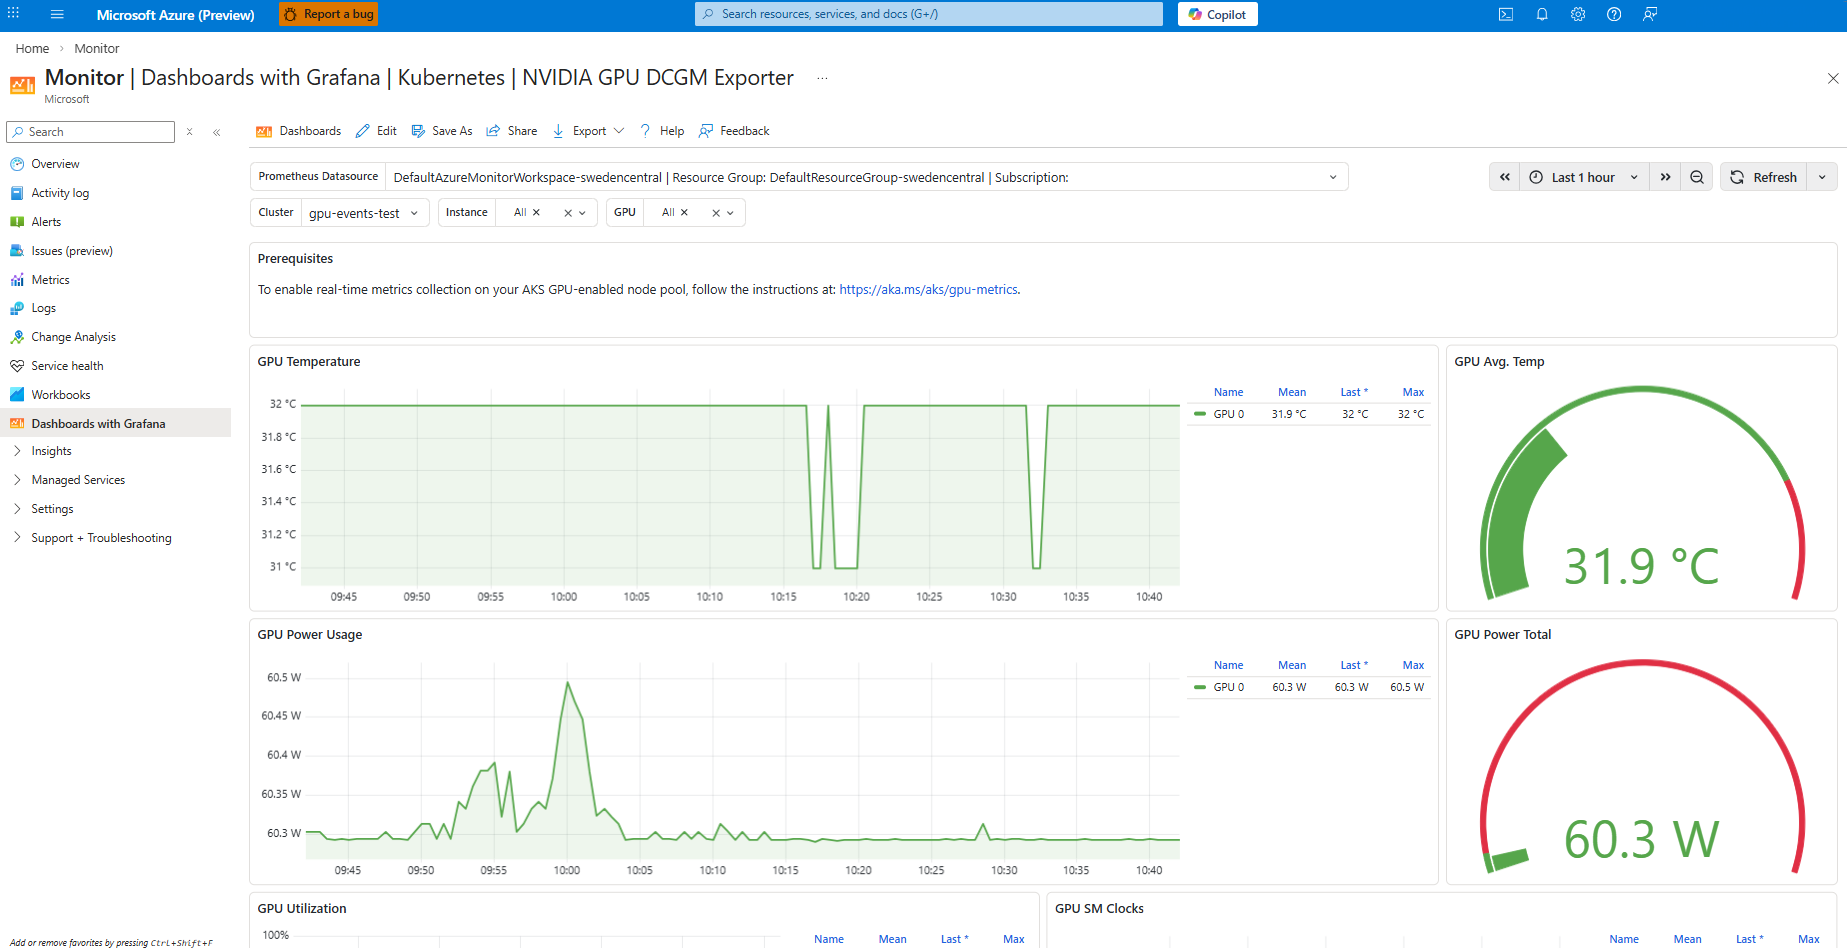
Kubernetes | NVIDIA GPU DCGM ExporterGrafana se značkouAzure-managed.Vyberte tento řídicí panel a potvrďte, že
ClusteraPrometheus Datasourceodpovídají vašim fondům uzlů s podporou GPU. Teď můžete zobrazit metriky GPU v reálném čase, jak je znázorněno na následujícím obrázku:
Pochopení metrik GPU
Metriky využití GPU
Metriky využití GPU ukazují procento času, po který jádra GPU aktivně zpracovávají. Vysoké hodnoty označují, že GPU je silně využívané, což je obecně žádoucí pro úlohy, jako je trénování nebo zpracování dat. Interpretace této metriky by měla zvážit typ úlohy: Trénování umělé inteligence obvykle udržuje vysoké využití, zatímco odvozování může mít přerušované využití z důvodu nárazového provozu.
Využití paměti: Zobrazuje procento používané paměti GPU. Vysoké využití paměti bez vysokého využití GPU může indikovat úlohy vázané na paměť, kde GPU čeká na přenosy paměti. Nízké využití paměti s nízkým využitím může naznačovat, že úloha je příliš malá, aby plně využívala GPU.
Efektivita streaming multiprocesorů (SM): Určuje, jak efektivně jsou využívána jádra GPU. Nízká efektivita SM značí, že jádra jsou nečinná nebo nedostatečně využitá kvůli nevyváženosti úloh nebo neoptimálnímu návrhu jádra. Vysoká efektivita je ideální pro aplikace náročné na výpočetní výkon.
Metriky paměti
Využití šířky pásma paměti: Odráží, kolik teoretické šířky pásma paměti se spotřebovává. Vysoké využití šířky pásma s nízkým využitím výpočetních prostředků může značit zatížení vázané na paměť. Naopak vysoké využití výpočetních prostředků i šířky pásma paměti naznačuje dobře vyváženou úlohu.
Chyby paměti: Sleduje chyby kódu pro opravu chyb (ECC), pokud je tato funkce povolená. Velký počet chyb může značit snížení výkonu hardwaru nebo tepelné problémy a měly by být monitorovány kvůli spolehlivosti.
Metriky teploty a výkonu
Teplota GPU: Označuje provozní teplotu GPU. Trvalé vysoké teploty můžou aktivovat tepelné omezování, což snižuje výkon. Ideální interpretace této metriky zahrnuje pozorování teploty vzhledem k teplotním limitům a chladicí kapacitě GPU.
Využití napájení: Zobrazuje okamžité odběry energie. Porovnání využití energie s TDP (tepelně designový výkon) pomáhá pochopit, jestli se GPU tlačí do svých limitů. Náhlé poklesy výkonu můžou znamenat omezování nebo nedostatečné využití.
Hodiny a metriky četnosti
GPU Clock: Skutečná provozní frekvence GPU. V kombinaci s využitím to pomáhá určit, jestli je GPU v porovnání s jeho potenciálem omezování nebo podvýkonné.
Takt paměti: Provozní frekvence paměti GPU. Úlohy vázané na paměť mohou těžit z vyšších paměťových hodin; Neshoda mezi využitím paměti a výpočetních prostředků může zvýraznit kritické body.
Metriky PCIe a NVLink
Šířka pásma PCIe: Měří propustnost přes sběrnici PCIe. Nízké využití u náročných úloh může naznačovat, CPU-GPU komunikace není kritickým bodem. Vysoké využití může odkazovat na omezení přenosu dat, která mají vliv na výkon.
Šířka pásma NVLink: Tato metrika se podobá šířce pásma PCIe, ale je specifická pro propojení NVLink a relevantní v systémech s více GPU pro komunikaci mezi GPU. Vysoké využití NVLink s nízkým využitím SM může značit zpoždění synchronizace nebo přenosu dat.
Metriky chyb a spolehlivosti
Neaktivní (Odložené) stránky a chyby XID: Sledujte chyby paměti GPU a kritická selhání. Časté výskyty signalizují potenciální hardwarové chyby a vyžadují pozornost pro dlouhotrvající úlohy.
Pokyny k interpretaci
Metriky DCGM by se měly interpretovat kontextově s typem vaší úlohy v AKS. Úloha náročná na výpočetní výkon by měla v ideálním případě vykazovat vysoké využití GPU a SM, vysokého využití šířky pásma paměti, stabilní teploty pod prahovými teplotami omezení a spotřebu energie blízko, ale pod TDP.
Úlohy vázané na paměť můžou ukazovat vysoké využití paměti a šířku pásma, ale nižší využití výpočetních prostředků. Anomálie, jako je nízké využití s vysokou teplotou nebo spotřebou energie, často značí omezování, neefektivní plánování nebo kritické body na úrovni systému.
Monitorování trendů v průběhu času místo jednotlivých snímků je důležité. Náhlé poklesy využití nebo špičky v chybách často odhalí základní problémy předtím, než ovlivní produkční úlohy. Porovnání metrik napříč několika GPU může také pomoct identifikovat odlehlé hodnoty nebo nesprávné chování zařízení v uzlovém fondu. Pochopení těchto metrik v kombinaci, nikoli izolace, poskytuje nejjasnější přehled o efektivitě GPU a výkonu úloh.
Běžné metriky GPU
Pro výkon fondů uzlů GPU v Kubernetes se běžně vyhodnocují následující metriky NVIDIA DCGM:
| Název metriky GPU | Meaning | Typický rozsah / indikátor | Tip k využití |
|---|---|---|---|
DCGM_FI_DEV_GPU_UTIL |
Využití GPU (% čas, kdy jsou aktivní jádra GPU) | 0–100% (vyšší je lepší) | Monitorování jednotlivých uzlů a podů; nízké hodnoty můžou znamenat kritické body procesoru nebo vstupně-výstupních operací. |
DCGM_FI_DEV_SM_UTIL |
Efektivita streamovacího multiprocesoru (% aktivních jader) | 0–100% | Nízké hodnoty s vysokým využitím paměti označují úlohu vázanou na paměť |
DCGM_FI_DEV_FB_USED |
Používaná paměť Framebuffer (bajty) | 0 až celková paměť | Použití limitů paměti GPU podů a sledování využití paměti pro jednotlivé pody |
DCGM_FI_DEV_FB_FREE |
Volné paměti GPU (bajty) | 0 až celková paměť | Užitečné pro plánování a zabránění chybám OOM |
DCGM_FI_DEV_MEMORY_UTIL |
Využití paměti (%) | 0–100% | Kombinování s využitím GPU nebo SM za účelem určení úloh vázaných na paměť |
DCGM_FI_DEV_MEMORY_CLOCK |
Aktuální frekvence paměti (MHz) | 0 až max paměťová frekvence | Nízké hodnoty při vysokém využití paměti mohou naznačovat škrcení. |
DCGM_FI_DEV_POWER_USAGE |
Okamžité využití energie (Watty) | 0 až TDP | Poklesy během vysokého využití můžou znamenat omezování. |
DCGM_FI_DEV_TEMPERATURE |
Teplota GPU (°C) | ~30–85°C normální | Upozornění na trvalé vysoké teploty |
DCGM_FI_DEV_NVLINK_RX |
Využití šířky pásma nvLink (%) | 0–100% | Kritický bod synchronizace s více GPU, pokud je vysoké s nízkým využitím SM |
DCGM_FI_DEV_XID_ERRORS |
Kritické chyby GPU hlášené ovladačem | Obvykle 0 | Vyžaduje se okamžité šetření; může znečistit uzel v Kubernetes. |
Další informace o celé sadě metrik GPU najdete v upstream dokumentaci NVIDIA DCGM.
Další kroky
- Informace o osvědčených postupech pro pozorovatelnost GPU v AKS
- Sledování stavu uzlu GPU pomocí detektoru problémů uzlů (NPD)
- Vytvořte fondy uzlů GPU s více instancemi ve vašem clusteru AKS