Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
Tato příručka ukazuje, jak ověřit odolnost clusteru Valkey nasazeného ve službě Azure Kubernetes Service (AKS) pomocí architektury pro zátěžové testování Locust. Prochází vytvořením testovacího klienta, jeho nasazením do AKS, simulováním selhání a analýzou chování clusteru.
Poznámka:
Tento článek obsahuje odkazy na hlavní termín (primární), což je termín, který už Microsoft nepoužívá. Když se termín odebere ze softwaru Valkey, odebereme ho z tohoto článku.
Sestavení ukázkové klientské aplikace pro Valkey
Následující kroky ukazují, jak sestavit ukázkovou klientskou aplikaci pro Valkey.
Ukázková klientská aplikace používá architekturu zátěžového testování Locust k simulaci úlohy na clusteru Valkey, který jste nakonfigurovali a nasadili. Kód Pythonu implementuje uživatelskou třídu Locust, která se připojuje ke clusteru Valkey a provádí operaci "set" a "get". Tuto třídu můžete rozšířit a implementovat složitější operace.
Poznámka:
Doporučujeme používat nejbezpečnější dostupný tok ověřování. Tok ověřování popsaný v tomto postupu vyžaduje velmi vysoký stupeň důvěryhodnosti v aplikaci a nese rizika, která nejsou přítomna v jiných tocích. Tento tok byste měli použít jenom v případě, že jiné bezpečnější toky, jako jsou spravované identity, nejsou přijatelné.
Pomocí následujících příkazů vytvořte soubor Dockerfile a
requirements.txtumístěte ho do nového adresáře:mkdir valkey-client cd valkey-client cat > Dockerfile <<EOF FROM python:3.10-slim-bullseye COPY requirements.txt . COPY locustfile.py . RUN pip install --upgrade pip && pip install --no-cache-dir -r requirements.txt EOF cat > requirements.txt <<EOF valkey locust EOFlocustfile.pyVytvořte soubor, který obsahuje kód klientské aplikace Valkey:cat > locustfile.py <<EOF import time from locust import between, task, User, events,tag, constant_throughput from valkey import ValkeyCluster from random import randint class ValkeyLocust(User): wait_time = constant_throughput(50) host = "valkey-cluster.valkey.svc.cluster.local" def __init__(self, *args, **kwargs): super(ValkeyLocust, self).__init__(*args, **kwargs) self.client = ValkeyClient(host=self.host) def on_stop(self): self.client.close() @task @tag("set") def set_value(self): self.client.set_value("set_value") @task @tag("get") def get_value(self): self.client.get_value("get_value") class ValkeyClient(object): def __init__(self, host, *args, **kwargs): super().__init__(*args, **kwargs) with open("/etc/valkey-password/valkey-password-file.conf", "r") as f: self.password = f.readlines()[0].split(" ")[1].strip() self.host = host self.vc = ValkeyCluster(host=self.host, port=6379, password=self.password, username="default", cluster_error_retry_attempts=0, socket_timeout=2, keepalive=1 ) def set_value(self, key, command='SET'): start_time = time.perf_counter() try: result = self.vc.set(randint(0, 1000), randint(0, 1000)) if not result: result = '' length = len(str(result)) total_time = (time.perf_counter()- start_time) * 1000 events.request.fire( request_type=command, name=key, response_time=total_time, response_length=length, ) except Exception as e: total_time = (time.perf_counter()- start_time) * 1000 events.request.fire( request_type=command, name=key, response_time=total_time, response_length=0, exception=e ) result = '' return result def get_value(self, key, command='GET'): start_time = time.perf_counter() try: result = self.vc.get(randint(0, 1000)) if not result: result = '' length = len(str(result)) total_time = (time.perf_counter()- start_time) * 1000 events.request.fire( request_type=command, name=key, response_time=total_time, response_length=length, ) except Exception as e: total_time = (time.perf_counter()- start_time) * 1000 events.request.fire( request_type=command, name=key, response_time=total_time, response_length=0, exception=e ) result = '' return result EOF
Sestavte a odešlete Docker image na ACR
Pomocí příkazu sestavte image Dockeru a nahrajte ji do služby Azure Container Registry (ACR
az acr build).az acr build --image valkey-client --registry ${MY_ACR_REGISTRY} .Pomocí příkazu
az acr repository listověřte, že byl obraz úspěšně odeslán.az acr repository list --name ${MY_ACR_REGISTRY} --output tableVýstup by měl zobrazit
valkey-clientobrázek, jak je znázorněno v následujícím příkladu:Result ---------------- valkey-client
Nasazení ukázkového klientského podu do AKS
Pomocí příkazu
Podvytvořtekubectl applykterý používá image klienta Valkey vytvořený v předchozím kroku. Specifikace podu obsahuje svazek CSI služby Secret Store s heslem Valkey, které klient používá pro připojení ke clusteru Valkey.kubectl apply -f - <<EOF --- kind: Pod apiVersion: v1 metadata: name: valkey-client namespace: valkey spec: affinity: nodeAffinity: requiredDuringSchedulingIgnoredDuringExecution: nodeSelectorTerms: - matchExpressions: - key: agentpool operator: In values: - nodepool1 containers: - name: valkey-client image: ${MY_ACR_REGISTRY}.azurecr.io/valkey-client command: ["locust", "--processes", "4"] volumeMounts: - name: valkey-password mountPath: "/etc/valkey-password" volumes: - name: valkey-password csi: driver: secrets-store.csi.k8s.io readOnly: true volumeAttributes: secretProviderClass: "valkey-password" EOFPřesměrujte port 8089 pro přístup k webovému rozhraní Locust na vašem místním počítači pomocí příkazu
kubectl port-forward.kubectl port-forward -n valkey valkey-client 8089:8089Přejděte k webovému rozhraní Locust na
http://localhost:8089a spusťte test. Můžete upravit počet uživatelů a rychlost spuštění pro simulaci úlohy v clusteru Valkey. Následující graf využívá 100 uživatelů a rychlost spawnu 10: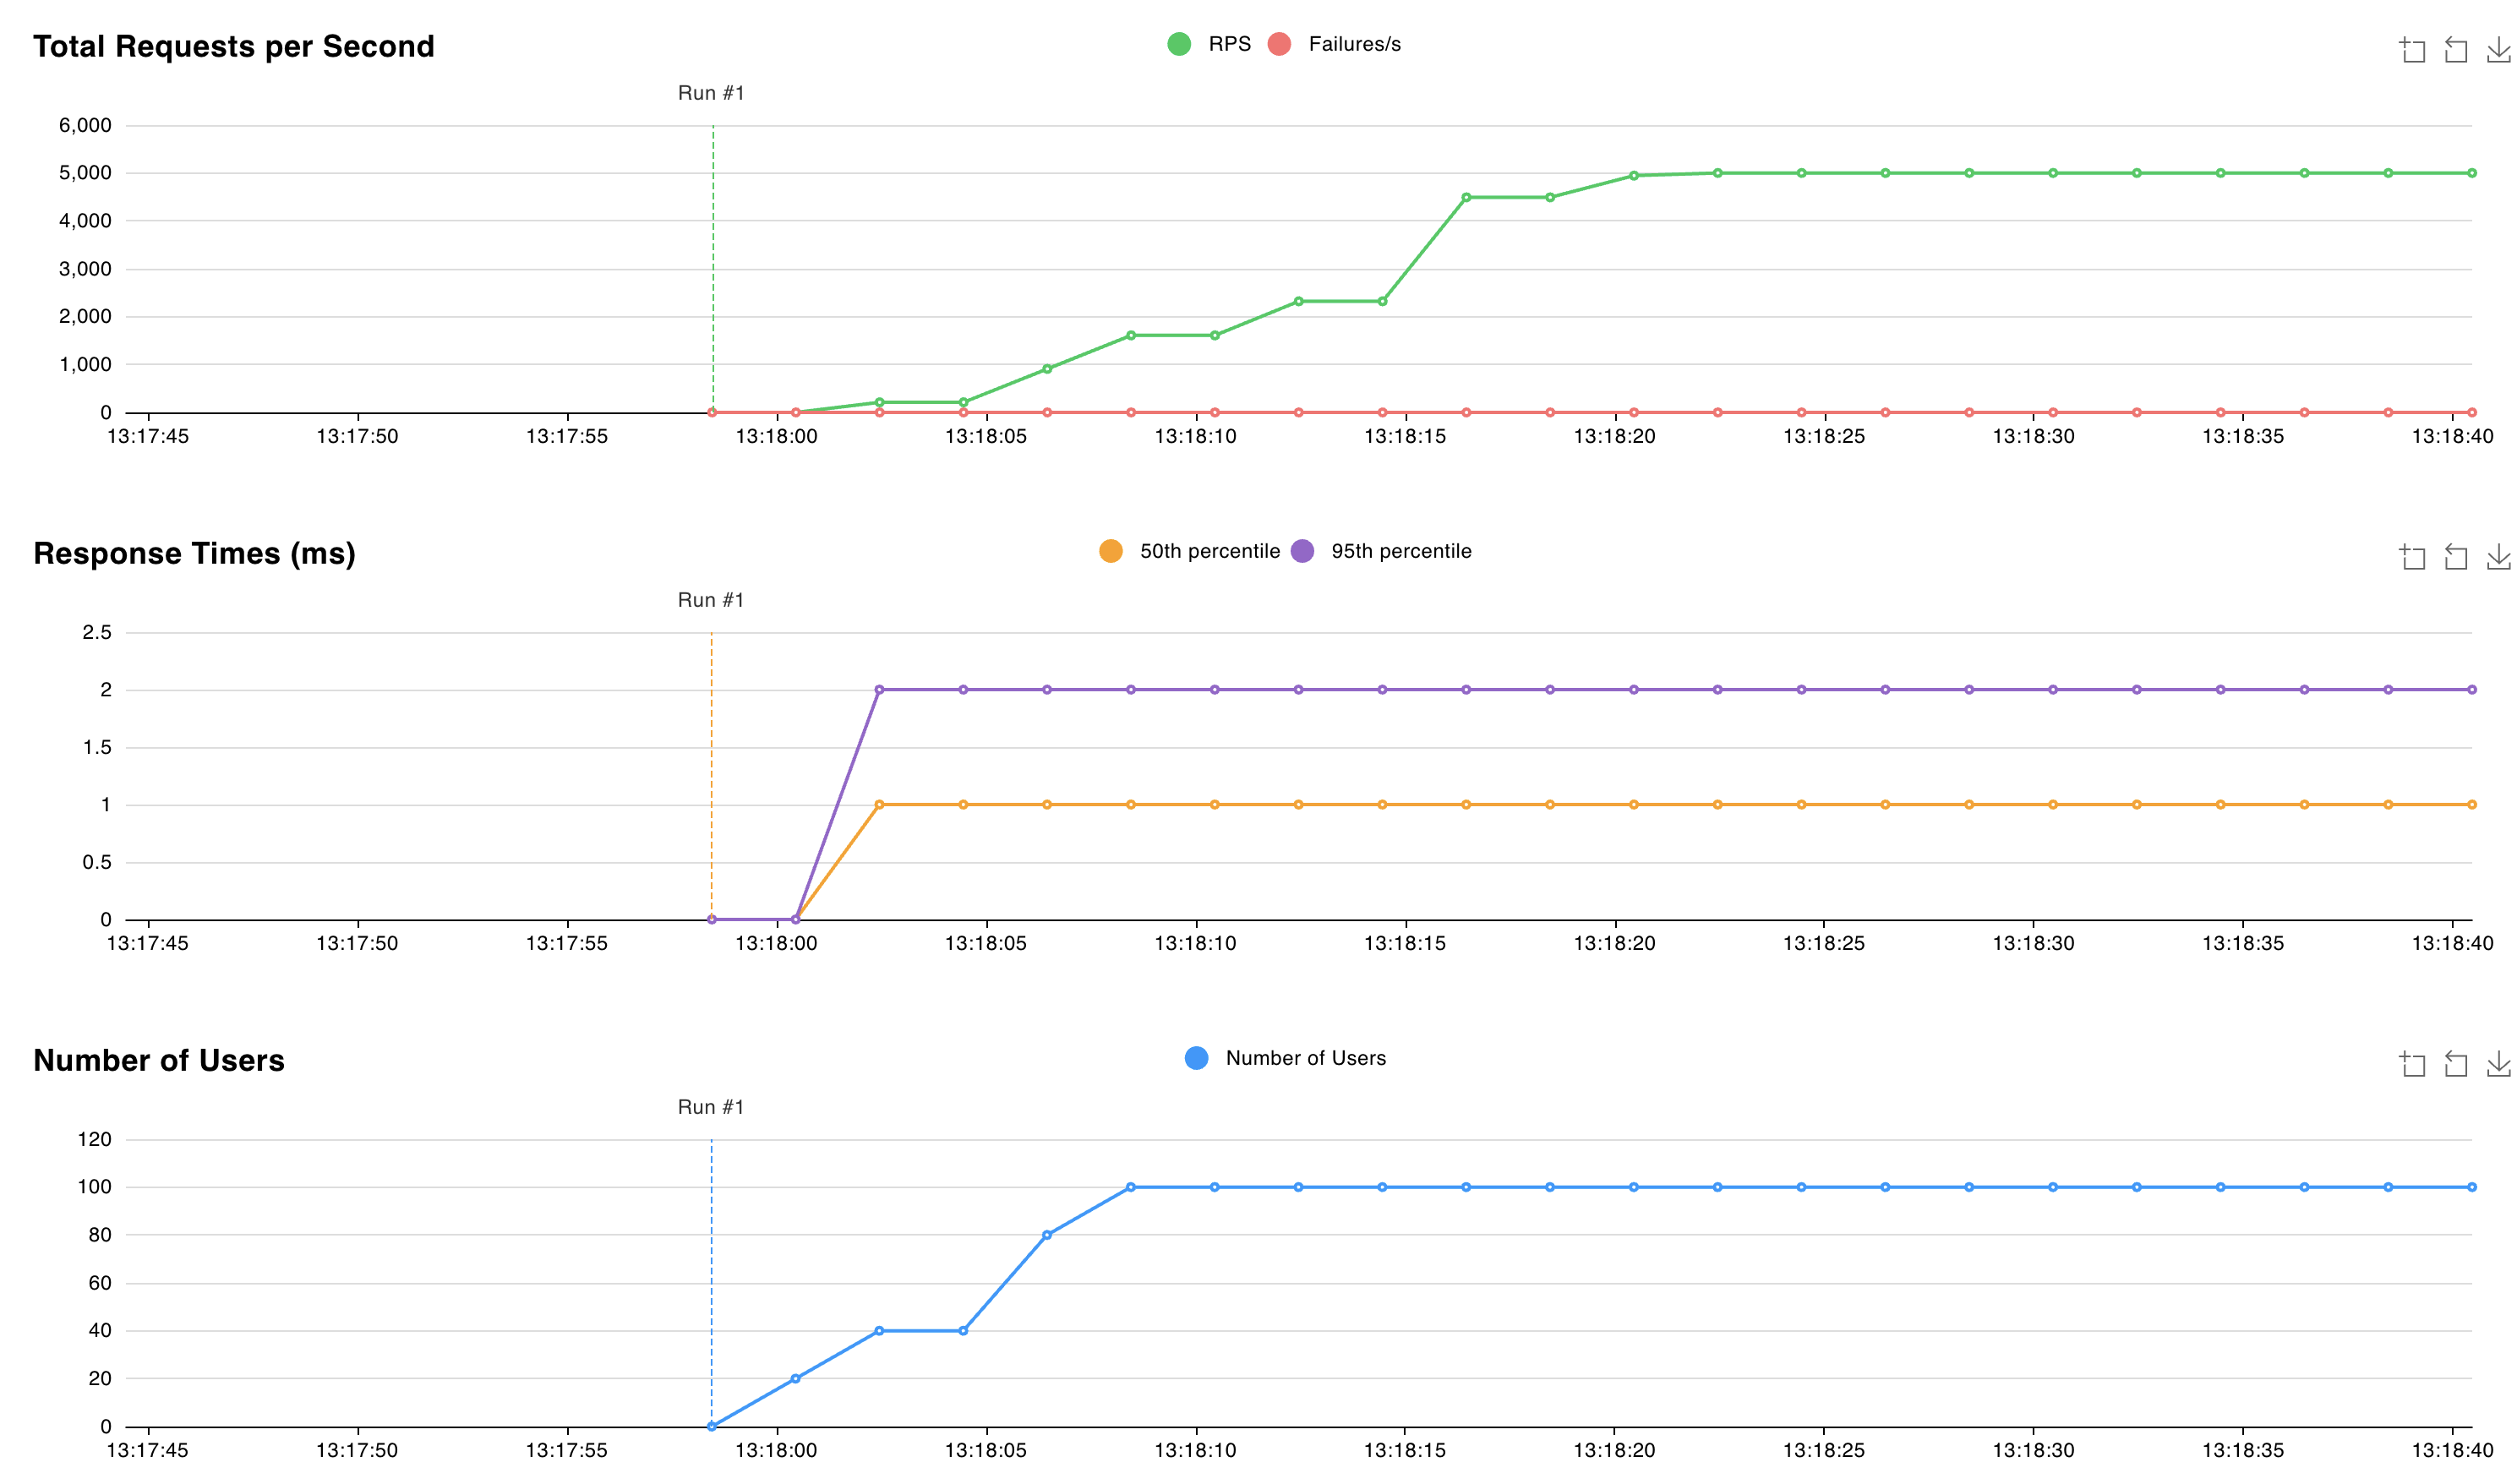
Simulace selhání a sledování chování clusteru Valkey
Simulujte výpadek odstraněním
StatefulSetpomocí příkazukubectl deletes příznakem--cascade=orphan. Cílem je odstranit jeden pod bez okamžitého opětovnéhoStatefulSetvytvoření odstraněného podu.kubectl delete statefulset valkey-masters --cascade=orphanvalkey-masters-0Odstraňte pod pomocíkubectl delete podpříkazu.kubectl delete pod valkey-masters-0Pomocí příkazu zkontrolujte seznam podů
kubectl get pods.kubectl get podsVýstup by měl znamenat, že pod
valkey-masters-0byl odstraněn. Ostatní pody by měly být veRunningstavu, jak je znázorněno v následujícím příkladu:NAME READY STATUS RESTARTS AGE valkey-client 1/1 Running 0 6m34s valkey-masters-1 1/1 Running 0 16m valkey-masters-2 1/1 Running 0 16m valkey-replicas-0 1/1 Running 0 16m valkey-replicas-1 1/1 Running 0 16m valkey-replicas-2 1/1 Running 0 16mPomocí příkazu
kubectl logs valkey-replicas-0získejte protokoly z poduvalkey-replicas-0.kubectl logs valkey-replicas-0Ve výstupu vidíme, že úplná událost trvá přibližně 18 sekund:
1:S 05 Nov 2024 12:18:53.961 * Connection with primary lost.
1:S 05 Nov 2024 12:18:53.961 * Caching the disconnected primary state.
1:S 05 Nov 2024 12:18:53.961 * Reconnecting to PRIMARY 10.224.0.250:6379
1:S 05 Nov 2024 12:18:53.961 * PRIMARY <-> REPLICA sync started
1:S 05 Nov 2024 12:18:53.964 # Error condition on socket for SYNC: Connection refused
1:S 05 Nov 2024 12:18:54.910 * Connecting to PRIMARY 10.224.0.250:6379
1:S 05 Nov 2024 12:18:54.910 * PRIMARY <-> REPLICA sync started
1:S 05 Nov 2024 12:18:54.912 # Error condition on socket for SYNC: Connection refused
1:S 05 Nov 2024 12:18:55.920 * Connecting to PRIMARY 10.224.0.250:6379
[..CUT..]
1:S 05 Nov 2024 12:19:10.056 * Connecting to PRIMARY 10.224.0.250:6379
1:S 05 Nov 2024 12:19:10.057 * PRIMARY <-> REPLICA sync started
1:S 05 Nov 2024 12:19:10.058 # Error condition on socket for SYNC: Connection refused
1:S 05 Nov 2024 12:19:10.709 * Node c44d4b682b6fb9b37033d3e30574873545266d67 () reported node 9e7c43890613cc3ad4006a9cdc0b5e5fc5b6d44e     () as not reachable.
1:S 05 Nov 2024 12:19:10.864 * NODE 9e7c43890613cc3ad4006a9cdc0b5e5fc5b6d44e () possibly failing.
1:S 05 Nov 2024 12:19:11.066 * 10000 changes in 60 seconds. Saving...
1:S 05 Nov 2024 12:19:11.068 * Background saving started by pid 29
1:S 05 Nov 2024 12:19:11.068 * Connecting to PRIMARY 10.224.0.250:6379
1:S 05 Nov 2024 12:19:11.068 * PRIMARY <-> REPLICA sync started
1:S 05 Nov 2024 12:19:11.069 # Error condition on socket for SYNC: Connection refused
29:C 05 Nov 2024 12:19:11.090 * DB saved on disk
29:C 05 Nov 2024 12:19:11.090 * Fork CoW for RDB: current 0 MB, peak 0 MB, average 0 MB
1:S 05 Nov 2024 12:19:11.169 * Background saving terminated with success
1:S 05 Nov 2024 12:19:11.884 * FAIL message received from ba36d5167ee6016c01296a4a0127716f8edf8290 () about     9e7c43890613cc3ad4006a9cdc0b5e5fc5b6d44e ()
1:S 05 Nov 2024 12:19:11.884 # Cluster state changed: fail
1:S 05 Nov 2024 12:19:11.974 * Start of election delayed for 510 milliseconds (rank #0, offset 7225807).
1:S 05 Nov 2024 12:19:11.976 * Node d43f370a417d299b78bd1983792469fe5c39dcdf () reported node 9e7c43890613cc3ad4006a9cdc0b5e5fc5b6d44e     () as not reachable.
1:S 05 Nov 2024 12:19:12.076 * Connecting to PRIMARY 10.224.0.250:6379
1:S 05 Nov 2024 12:19:12.076 * PRIMARY <-> REPLICA sync started
1:S 05 Nov 2024 12:19:12.076 * Currently unable to failover: Waiting the delay before I can start a new failover.
1:S 05 Nov 2024 12:19:12.078 # Error condition on socket for SYNC: Connection refused
1:S 05 Nov 2024 12:19:12.581 * Starting a failover election for epoch 15.
1:S 05 Nov 2024 12:19:12.616 * Currently unable to failover: Waiting for votes, but majority still not reached.
1:S 05 Nov 2024 12:19:12.616 * Needed quorum: 2. Number of votes received so far: 1
1:S 05 Nov 2024 12:19:12.616 * Failover election won: I'm the new primary.
1:S 05 Nov 2024 12:19:12.616 * configEpoch set to 15 after successful failover
1:M 05 Nov 2024 12:19:12.616 * Discarding previously cached primary state.
1:M 05 Nov 2024 12:19:12.616 * Setting secondary replication ID to c0b5b2df8a43b19a4d43d8f8b272a07139e0ca34, valid up to offset:     7225808. New replication ID is 029fcfbae0e3e4a1dccd73066043deba6140c699
1:M 05 Nov 2024 12:19:12.616 * Cluster state changed: ok
Během tohoto 18sekundového časového intervalu vidíme, že selhávají zápisy do shardu, který patří k odstraněnému podu, a cluster Valkey volí nový primární uzel. Latence požadavků během tohoto časového intervalu stoupá na 60 ms.
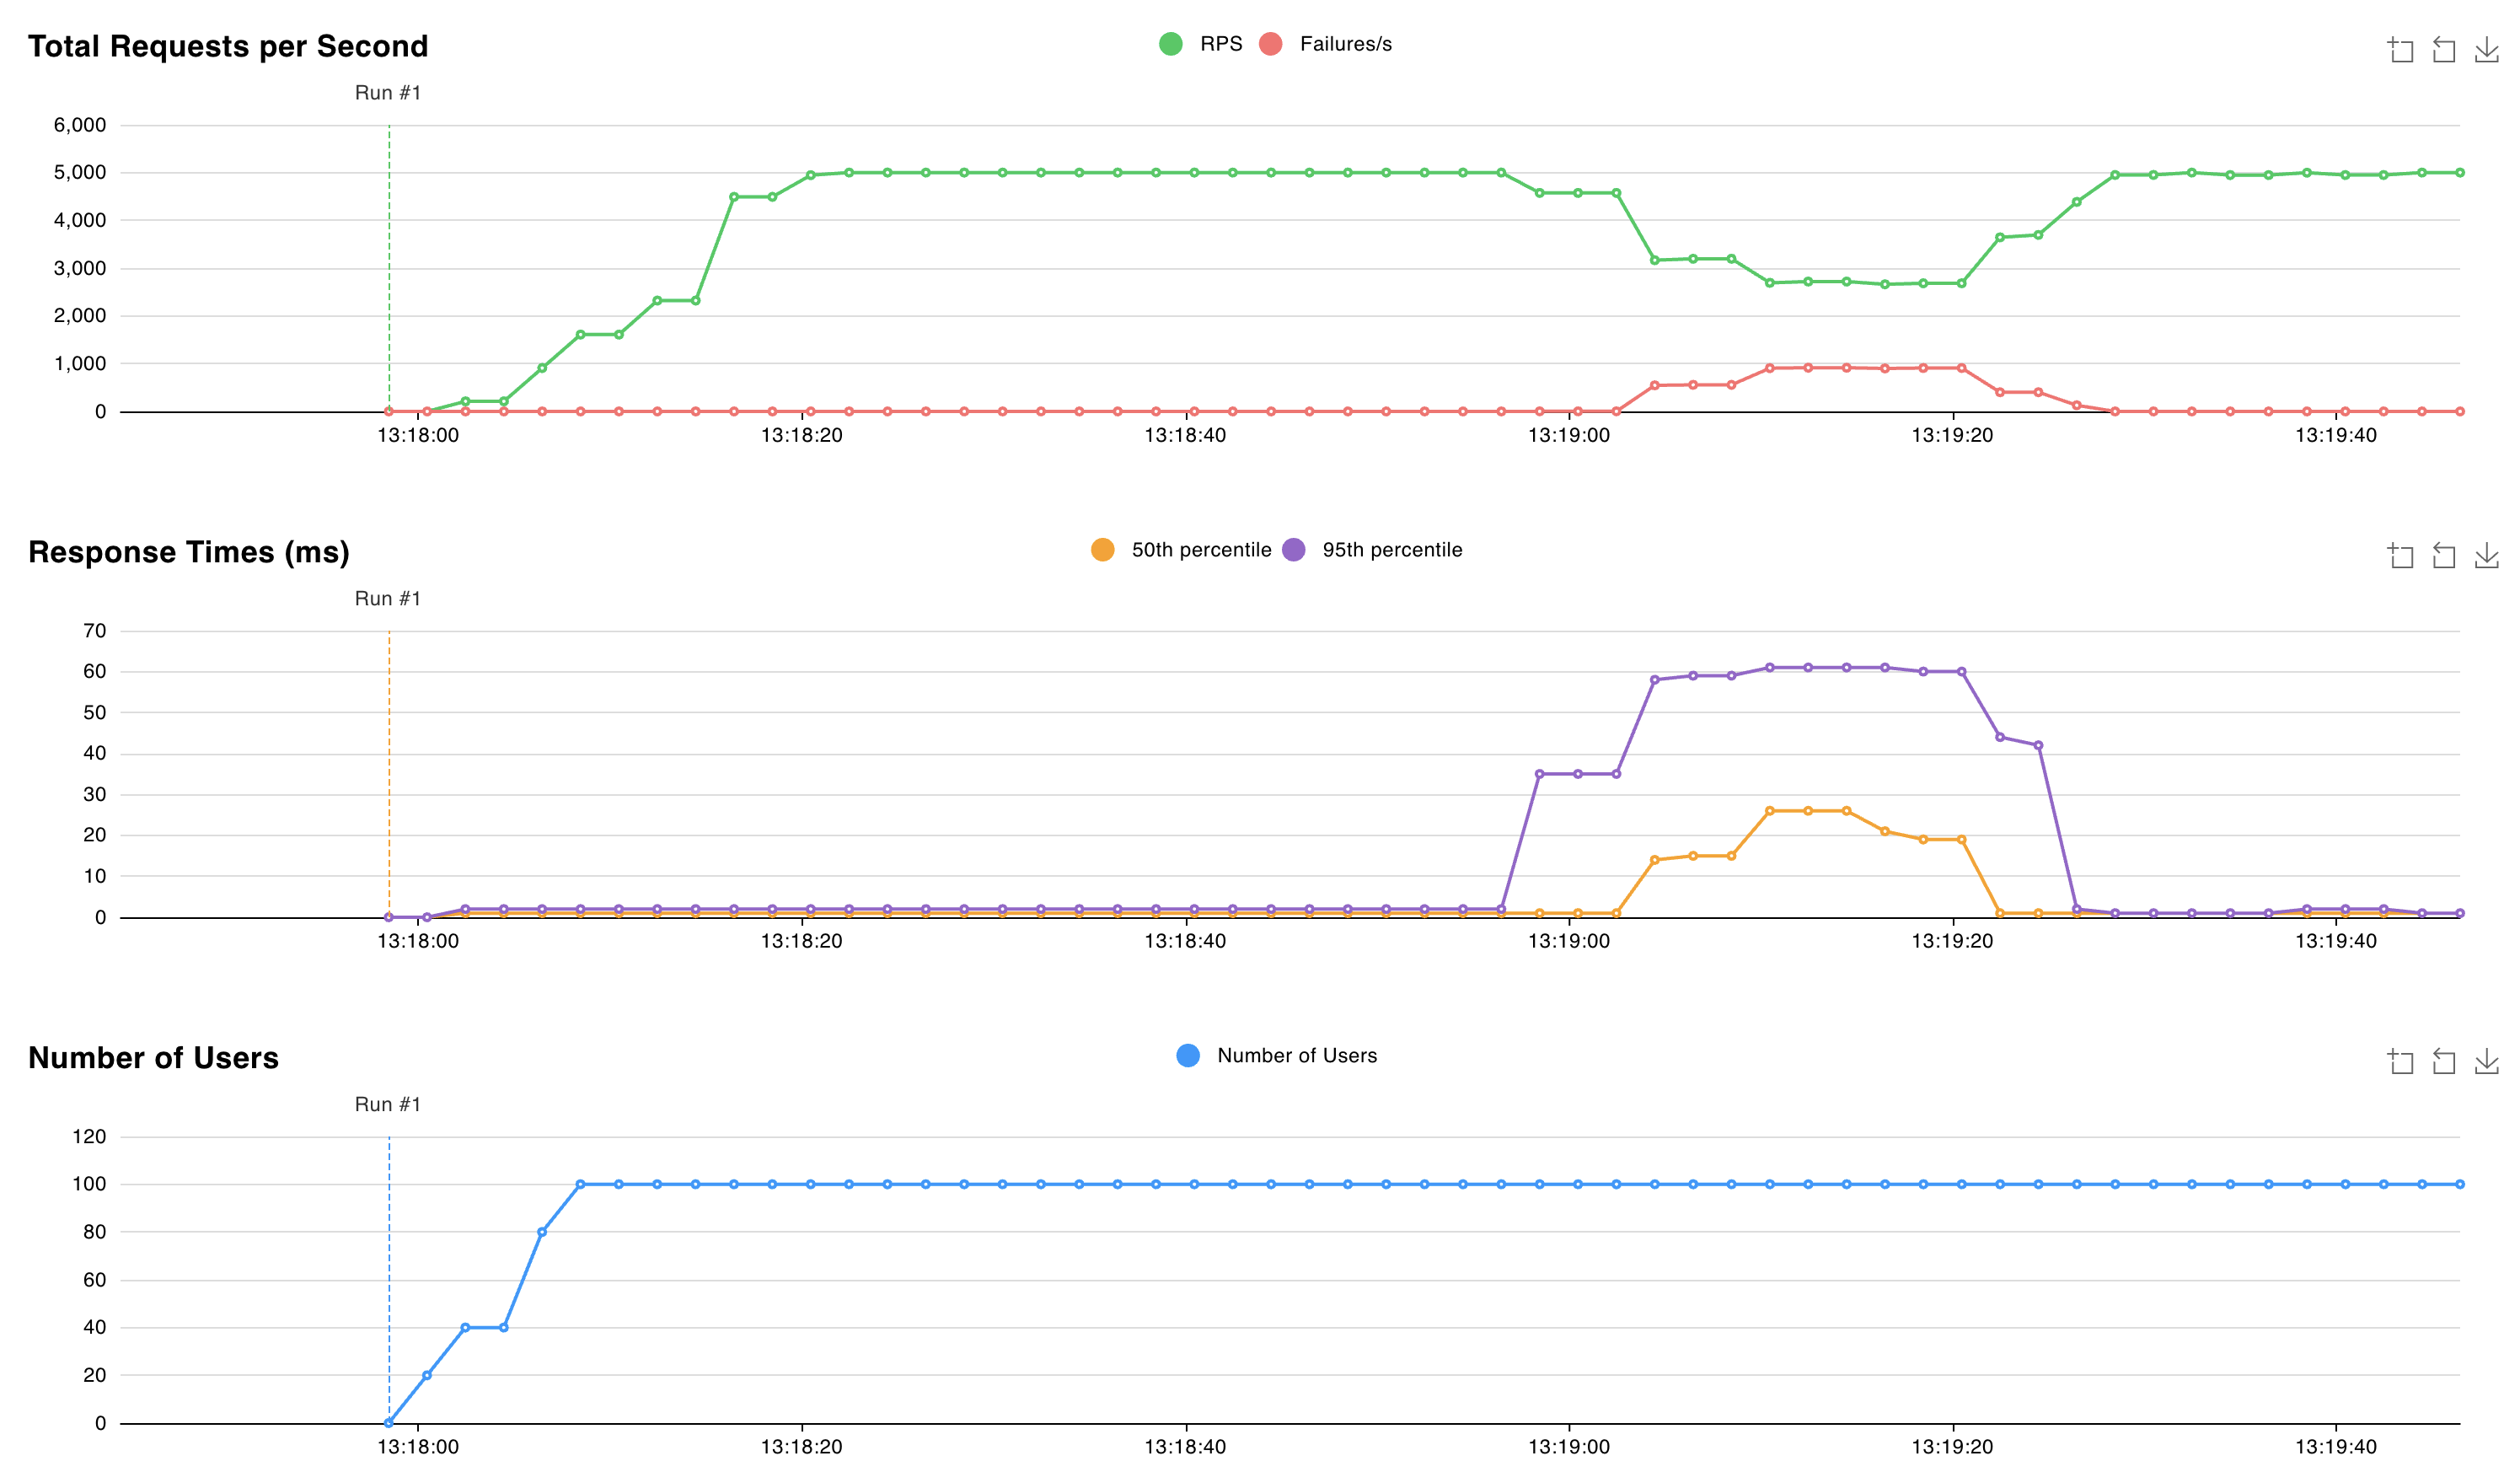
Po zvolení nového primárního serveru bude cluster Valkey nadále obsluhovat požadavky s latencí přibližně 2 ms.
Další krok
Přispěvatelé
Microsoft udržuje tento článek. Následující přispěvatelé ho původně napsali:
- Nelly Kiboi | Servisní technik
- Saverio Proto | Hlavní technik zákaznického prostředí