Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
Important
Tato funkce je v beta verzi. Pro jeho použití musí správce pracovního prostoru zapnout Agent Memory Sessions na stránce Previews. Viz Manage Azure Databricks preview.
Agentní paměť dává agentům dlouhodobou paměť, která přetrvává napříč konverzacemi. Azure Databricks ukládá paměť v Lakebase a spravuje za vás úložiště, indexaci a vyhledávání, takže vaši agenti si mohou pamatovat uživatelské preference, minulá rozhodnutí a nashromážděný kontext bez toho, abyste provozovali databázi.
Note
Během období Preview jsou vám účtovány poplatky za podkladovou instanci Lakebase, která ukládá vaše záznamy v paměti. Za samotnou paměť agenta nejsou účtovány žádné další poplatky. Ceny se mohou v průběhu ukázky měnit.
Používejte paměť agenta, když chcete, aby vaši agenti mohli:
- Pamatujte na uživatelské preference, fakta a rozhodnutí v různých konverzacích.
- Personalizujte odpovědi na základě toho, co se agent naučil v předchozích sezeních.
- Sdílejte nahromaděné znalosti napříč agenty a projekty.
- Zlepšení přesnosti a efektivity v průběhu času
Paměť agentů funguje s agenty postavenými na jakémkoli frameworku. Pro krátkodobou historii konverzace v rámci jedné interakce použijte relace agenta.
Požadavky
- Nainstalujte Python 3.10 nebo novější, abyste mohli používat AgentKit SDK. AgentKit SDK je Databricks Python klient pro agentní API, který používají níže uvedené příklady. REST API můžete také volat přímo z jakéhokoliv jazyka, bez nutnosti Python.
- Pro použití
memory_store.put()nebomemory_store.list(path=...), nainstalujtedatabricks-agentbricksverzi 0.6.0 a vyšší.
Jak funguje agentní paměť
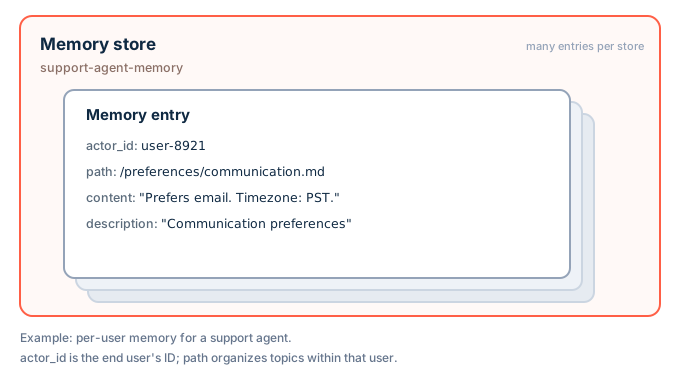
Paměť agenta má dvě úrovně:
- Paměťové úložiště je kontejner v rámci pracovního prostoru pro paměti agenta. Vytvoření obchodu automaticky zajišťuje zálohující úložiště Lakebase. Na obchod odkazujete podle jeho ID obchodu, které zvolíte při jeho vytvoření.
-
Paměťový záznam je samostatná položka obsahu v úložišti. Každý záznam má volný text
content, zkratkudescriptionpoužívanou pro vyhledávání a sadu polí, která jej organizují a rozdělují:-
actor_id(povinné): komu paměť patří, například koncovému uživateli nebo jinému agentovi. -
session_id(volitelné): relace, ke které paměť patří. Nechte to nenastavené pro paměť, která se vztahuje na aktérovy relace. -
path(vyžadováno): Cesta podobná souborovému systému, která organizuje položky uvnitř aktéra, například/preferences/response-style.md.
-
Prvek je jednoznačně identifikován kombinací actor_id, session_id, a path. Stejná cesta pod dvěma různými relacemi nebo pod relací a bez relace obsahuje dva samostatné záznamy.
Záznamy se dostanou do úložiště dvěma způsoby: váš agent nebo aplikace je zapíše přímo, nebo je paměťová pipeline destiluje z konverzací v úložišti relací.
Vyhledávání
Vyvolejte paměť dvěma způsoby:
- Vypsat položky pro aktéra, volitelně filtrované podle
session_id, předponypathnebo přesnéhopath. Použijte to k prohlížení nebo zobrazení indexu toho, co agent ví. - Vyhledejte záznamy o herci pomocí dotazu v přirozeném jazyce. Vyhledávání vrací nejrelevantnější položky seřazené podle skóre relevance.
session_id Filtr u kterékoliv operace vrací pouze položky uložené s danou relací. Nevrací záznamy uložené bez relace/session.
Začínáme
Příklady AgentKit SDK a REST API nastavují paměť agenta pro podpůrného agenta: vytvoří paměťové úložiště, uloží uživatelovu preferenci a vyvolají ji v pozdější konverzaci. Příklad CLI Agent Bricks propojuje paměťové úložiště s agentem, kterého vytvoříte a nasadíte pomocí CLI. Vyberte si klienta, který odpovídá vašemu projektu. ID paměťového úložiště musí mít 3 až 56 znaků, začínat malým písmenem, končit písmenem nebo číslem a obsahovat pouze malá písmena, čísla a pomlčky.
AgentKit SDK
AgentKit SDK je Python klient Databricks pro agentní API, distribuovaný v balíčkudatabricks-agentbricks. Autentizuje se pomocí Databricks SDK WorkspaceClient.
Nainstalujte AgentKit SDK:
pip install databricks-agentbricksVytvořte paměťové úložiště pro svého agenta.
AgentKitClientAutentizuje se svýmiWorkspaceClientpřihlašovacími údaji:from databricks.sdk import WorkspaceClient from databricks_agentkit import AgentKitClient client = AgentKitClient(WorkspaceClient()) memory_store = client.memory_stores.create("support-agent-memory")Uložte vzpomínku poté, co agent zjistí něco trvalého o uživateli.
actor_idurčuje, čí je tato paměť,pathji uspořádává v rámci daného aktéra adescriptionzlepšuje vybavení:memory_store.add( actor_id="user-123", path="/preferences/communication.md", content="Prefers email over phone. Timezone: PST. Enterprise subscription.", description="User 123 communication preferences", )add()selže, pokud v této cestě jižALREADY_EXISTSexistuje záznam. Pro vytvoření záznamu nebo aktualizaci stávajícího volejtememory_store.put()se stejnými argumenty.Vzpomínky uživatele si vybavte v pozdější konverzaci pomocí vyhledávání v přirozeném jazyce:
results = memory_store.search(actor_id="user-123", query="communication preferences", limit=10)
REST API
Klienti volají REST API pod adresou /api/2.0/agents/memory-stores. Volejte ji přímo v jiných jazycích než v Pythonu.
Vygenerujte OAuth token pomocí Databricks CLI:
databricks auth login --host ${DATABRICKS_HOST}
export DATABRICKS_TOKEN=$(databricks auth token | jq -r .access_token)
Vytvořte paměťové úložiště pro svého agenta:
curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores?managed_memory_store_id=support-agent-memory" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \
  -d '{"description": "Support agent memory"}'
Uložte uživateli paměťový záznam.
actor_idurčuje, čí paměť to je,pathji organizuje adescriptionzlepšuje vybavování:curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores/support-agent-memory/entries" \ -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \ -d '{"actor_id": "user-123", "path": "/preferences/communication.md", "content": "Prefers email over phone.", "description": "Communication preferences"}'Pokud na dané cestě již existuje záznam, požadavek selže s
ALREADY_EXISTS(HTTP 409). Pro aktualizaci stávajícího záznamu ho vyhledejte podle cesty. Vyhledání vrací záznamy cesty pro každou relaci, takže vyberte ten, jehožsession_idse shoduje. Poslední segment jehonameje ID záznamu:curl -G "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores/support-agent-memory/entries" \ -H "Authorization: Bearer ${DATABRICKS_TOKEN}" \ --data-urlencode "actor_id=user-123" --data-urlencode "path=/preferences/communication.md"Poté aktualizujte obsah záznamu podle jeho ID:
curl -X PATCH "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores/support-agent-memory/entries/<entry-id>?update_mask=content" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \
  -d '{"content": "Prefers email over phone. Timezone: PST."}'
Vyvolejte vzpomínky uživatele pomocí vyhledávání v přirozeném jazyce:
curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores/support-agent-memory/entries:search" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \
  -d '{"actor_id": "user-123", "query": "communication preferences"}'
Agentní cihly
Pokud vytvoříte svého agenta s CLI Agent Bricks, v agent.tomlagentbricks init deklaruje paměťové úložiště.
agentbricks deploy Vytvoří úložiště, pokud ještě neexistuje, a umožní nasazenému agentovi přístup k němu.
Zvolte cestu:
Začít s prázdným nastavením (většina agentů): Nasaďte agenta.
agentbricks deployvytváří paměťové úložiště, které deklaroval/oagentbricks init. Pro nasazení agenta jménemmy-agent, spusť následující:agentbricks deploy my-agentZačněte s paměťmi už ve store: Nejprve vytvořte store, přidejte záznamy, pak svažte store s agentem a nasaďte.
Pro vytvoření obchodu s názvem
my-agent-memory, spusťte následující. Výstup obsahuje ID obchodu, generovaný identifikátor oddělený od názvu obchodu:agentbricks memory stores create --name my-agent-memoryChcete-li přidat položku, spusťte následující a nahraďte
<store-id>ID obchodu z předchozího kroku:agentbricks memory entries create --store <store-id> --actor-id you@example.com \ --path /preferences/style.md --content "Prefers Python and concise answers with code examples."Pro svázání úložiště a nasazení agenta spusťte následující.
agentbricks memory bindnahradí název obchodu vagent.toml, aagentbricks deploynajde existující obchod podle názvu a použije ho místo vytvoření nového:agentbricks memory bind my-agent-memory agentbricks deploy my-agent
--path je klíč položky v úložišti, ne soubor ve vašem počítači.
--actor-id je uživatel, kterému paměť patří. Nasazený agent používá e-mail přihlášeného uživatele jako identitu aktéra, takže vyplňte každý záznam e-mailem uživatele, který s agentem komunikuje.
V CLI memory bind Agent Bricks a agentbricks deploy odkazují na úložiště podle jeho jména. Příkazy, které působí na jednom úložišti, například memory entries create, přijímají vygenerované ID úložiště.
Dejte svému agentovi paměťové nástroje
Aby agent mohl rozhodnout, kdy uložit a odvolat paměť, zabalte klientské operace do nástrojů a instruujte agenta, kdy je má použít, ve svém systémovém promptu. Nastavte v důvěryhodném aplikačním kódu hodnotu actor_id z ověřené identity koncového uživatele. Nikdy nenechte model vybírat, čí paměť bude číst nebo zapisovat.
Následující příklad zahrnuje AgentKit SDK memory_store z Get Start jako nástroje pro OpenAI Agents SDK.
from agents import Agent, function_tool

def make_memory_tools(memory_store, actor_id: str):
    @function_tool
    def search_memory(query: str) -> str:
        """Search long-term memory for relevant facts about the user."""
        results = memory_store.search(actor_id=actor_id, query=query, limit=10)
        return "\n\n".join(f"{r.memory.path}: {r.memory.content}" for r in results) or "No memory found."

    @function_tool
    def save_memory(path: str, content: str, description: str = "") -> str:
        """Save a durable, long-term memory about the user, replacing any memory at the same path."""
        memory_store.put(actor_id=actor_id, path=path, content=content, description=description or None)
        return f"Saved memory at {path}"

    @function_tool
    def list_memories() -> str:
        """List the paths and descriptions of the user's long-term memories."""
        memories = memory_store.list(actor_id=actor_id)
        return "\n".join(f"{m.path}: {m.description}" if m.description else m.path for m in memories) or "No memory found."

    @function_tool
    def forget_memory(path: str) -> str:
        """Delete the long-term memory at a path, such as when the user asks you to forget it."""
        memories = list(memory_store.list(actor_id=actor_id, path=path))
        for memory in memories:
            memory.delete()
        return f"Forgot memory at {path}" if memories else f"No memory at {path}"

    return [search_memory, save_memory, list_memories, forget_memory]

agent = Agent(
    name="Support agent",
    instructions="Save durable user preferences, recall them when relevant, and forget them when the user asks.",
    tools=make_memory_tools(memory_store, actor_id="user-123"),
)
put() vytvoří záznam nebo nahrazuje obsah záznamu, který již na této cestě je. Pro přidání obsahu jako nových řádků místo toho předejte append=True.
put() není atomové, takže souběžné zápisy na stejnou cestu mohou způsobit, že jeden přepíše druhý.
list(path=...) vrací záznamy na této přesné cestě v každé relaci, takže forget_memory také smaže všechny záznamy uložené na cestě v rámci relace.
Stejný vzorec funguje i s Claude Agent SDK a dalšími frameworky: zabalit operace search, put, list a delete daného úložiště do podoby typu nástroje frameworku.
Pokud také spustíte paměťovou pipeline na stejném paměťovém úložišti, pipeline může přepsat, sloučit, rozdělit nebo smazat záznamy, které agent ukládá pro jakéhokoli aktéra, kterého zpracovává.
Oddělená a zabezpečená paměť
V úložišti pomocí actor_id rozlišíte, komu které vzpomínky patří. Každý seznam i každé vyhledávání jsou omezeny na jedno actor_id, takže zvolte strategii, která odpovídá tomu, co si váš agent potřebuje pamatovat:
-
Soukromá paměť pro každého uživatele: Nastavena
actor_idna ověřenou identitu koncového uživatele. Každý uživatel dostane svůj vlastní oddíl a agent si vybaví pouze záznamy tohoto uživatele.- Příklad: Agent podpory si pamatuje komunikační preference jednoho uživatele a jeho předchozí tikety.
-
Sdílená paměť pro skupinu: Nastavte
actor_idpevný klíč, který si zvolíte, například ID týmu, projektu nebo organizace. Všichni čtou a píší stejné vzpomínky.- Příklad: Týmový agent si pamatuje sdílený slovník firemních termínů a interních konvencí.
-
Rozdělení paměti podle něčeho jiného: Vytvořte
actor_idz vlastních hodnot, například z ID tenanta nebouser:projectkompozitu.-
Příklad: Aplikace s více tenanty nastaví
actor_idna{tenant}:{user}, aby uživatelé každého zákazníka zůstali navzájem izolovaní.
-
Příklad: Aplikace s více tenanty nastaví
Nastavte actor_id v aplikačním kódu v kontextu důvěryhodného volajícího: ověřenou identitu koncového uživatele pro paměť pro jednotlivé uživatele nebo důvěryhodný klíč týmu nebo projektu pro sdílenou paměť. Nikdy nenechte modelku to zvolit. Pokud vaše strategie závisí na identitě koncového uživatele, odmítejte požadavky, které ji neobsahují, namísto použití sdílené actor_id jako záložní možnosti.
Warning
actor_id odděluje vzpomínky, ale není to kontrola přístupu. Paměťová úložiště jsou omezena na pracovní prostor, takže jakýkoli principal, který se dostane do úložiště, může číst a zapisovat každý záznam napříč všemi aktéry. Obchod, ne herec, je bezpečnostní hranicí. Pro přísnou izolaci mezi nájemci a uživateli vytvořte samostatné paměťové úložiště pro každou hranici.
Aby jiný principál, například zástupce vašeho agenta, mohl použít úložiště, udělte mu přístup pomocí operacememory_store.grant_permission(principal_id) grant-permission (v AgentKit SDK). Přístup může udělit pouze tvůrce obchodu nebo správce pracovního prostoru. Viz Správa oprávnění pro paměť agenta a úložiště relací pro úrovně oprávnění, podporované operace a příklady.
Limitations
- Paměť agenta poskytuje pouze dlouhodobou paměť. Historii krátkodobých konverzací naleznete v části relace agentů.
- Vyhledávání řadí záznamy podle relevance, přičemž kombinuje fulltext (BM25) a sémantické párování přes obsah a popis každého záznamu. Vrací až 100 záznamů a nepodporuje stránkování.
- Kontrola přístupu je vynucována na úrovni obchodu. Řízení přístupu pro jednotlivé záznamy a jednotlivé aktéry není dostupné.
- Řízení přístupu do obchodu zahrnuje vstupy do obchodu. Každý uživatel pracovního prostoru může vypisovat a získávat paměťová úložiště včetně jejich ID a popisů.
- Nemůžete změnit ID obchodu poté, co ho založíte. Aktualizovat lze pouze
description.