Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
Genie Migrate využívá Genie Code k převodu existujícího SQL z dialektů jako T-SQL, Snowflake, Redshift, Oracle, BigQuery a Teradata do kódu běžícího na Azure Databricks. Také převádí pracovní zátěže pro extrakci, transformaci a načítání (ETL) z Informatica PowerCenter (Beta) do notebooků Databricks. Organizujete svou práci v migračním projektu a vyberete cílový rámec pro výstup: Databricks SQL dotazy nebo Databricks notebooky (Beta), které používají DataFrame API. Genie Migrate analyzuje každý zdrojový skript, ověřuje převedený výstup a iterativně opravuje chyby před zápisem výsledků do složky workspace.
Genie Migrate je součástí nástrojů Databricks pro migraci pracovních zátěží z existujících datových skladů a ETL nástrojů do Azure Databricks. Převádí vaše SQL skripty a ETL pipeline, zatímco organizujete a sledujete práci v migračním projektu.
Jak to funguje
Převod zahájíte vytvořením projektu migrace ve vašem pracovním prostoru. Projekt sleduje stav každého souboru a poskytuje jedno místo pro správu migrace.
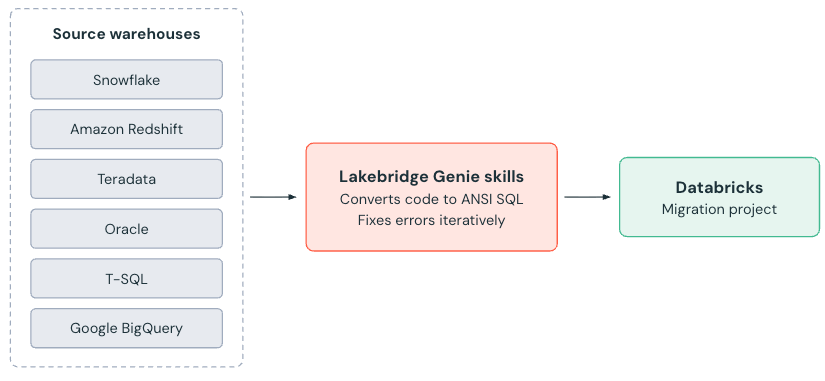
Když provedete konverzi, Genie Code nasadí subagenty, kteří převádějí soubory současně. Každý subagent analyzuje zdrojový dialekt a generuje ekvivalentní kód pro cílový rámec projektu (Databricks SQL nebo Databricks notebook). Poté zkontroluje převedený kód:
- Syntaxe: Kontroluje, že převedený kód běží na Azure Databricks bez chyb.
-
Sémantický záměr: Kontroluje, zda převedený kód zachovává obchodní logiku zdroje, například stejná spojení tabulek a
WHEREklauzule.
Když kontrola selže, subagent kód upraví a znovu jej zkontroluje. Genie Code také aplikuje vaše vlastní skills při převodu souborů. Přečtěte si Vytvoření vlastní dovednosti (volitelné). Převedené soubory se zapisují přímo do složky pracovního prostoru, kterou zadáte pro projekt.
Pomocí příkazu v konverzaci Genie Code můžete také převést jeden soubor nebo složku bez projektu /migrate .
Requirements
- Vaše stávající SQL nebo XML soubory musí být přístupné ve vašem workspace, buď nahrané jako workspace soubory, nebo otevřené v editoru.
- Váš pracovní prostor musí splňovat požadavky genie Code. Viz Genie Code.
- Pro použití cílového rámce Notebooks, analýzy projektů a původu nebo konverze Informatica PowerCenter, které jsou v beta fázi, musí správce pracovního prostoru zapnout Experimentální funkce Migration Projects na stránce Náhledy . Viz Manage Azure Databricks preview.
Podporované zdroje
Převodník podporuje následující SQL dialekty:
- T-SQL
- Snowflake SQL
- Redshift SQL
- Oracle
- BigQuery
- Teradata
Když vytváříte migrační projekt pro SQL dialekt, vyberte jeden z následujících cílových frameworků:
- DBSQL: ANSI-kompatibilní Databricks SQL dotazy.
-
Notebooky (beta): Databricks notebooky využívající DataFrame API, s
spark.sql, pokud je logika v SQL přehlednější.
Important
Podpora zdrojů PowerCenter Informatica je v beta verzi. Pro jeho použití musí správce pracovního prostoru zapnout Experimentální funkce migrace projektů na stránce Náhledy . Viz Manage Azure Databricks preview.
Převodník také podporuje Informatica PowerCenter jako ETL zdroj.
Informatica Intelligent Správa dat Cloud (IDMC) a Informatica Intelligent Cloud Services (IICS) nejsou podporovány. Genie Migrate převádí objekty v exportu Informatica, jako jsou workflow a mapování, do notebooků Databricks, takže projekty Informatica vždy používají cílový rámec Notebooks.
Pro přípravu pracovních postupů Informatica pro konverzi je exportujte z PowerCenter Repository Manager ve formátu PowerMart XML. Exportujte na úrovni workflow a zahrňte závislé objekty, jako jsou mapování, relací, mapplety a worklety. Nezahrňujte do exportu přihlašovací údaje.
Převeďte svůj kód
Následující kroky popisují, jak převést SQL skripty a ETL pipeline v migračním projektu.
Krok 1: Nahrání zdrojových souborů
Nahrajte své stávající SQL soubory (.sql) nebo ETL exporty (.xml) pomocí prohlížeče souborů workspace, nebo použijte Databricks CLI k hromadnému nahrání adresáře skriptů.
Krok 2: Vytvoření projektu migrace
Vytvořte projekt migrace z pracovního prostoru:
- Klikněte na
 >Migrační projekt.
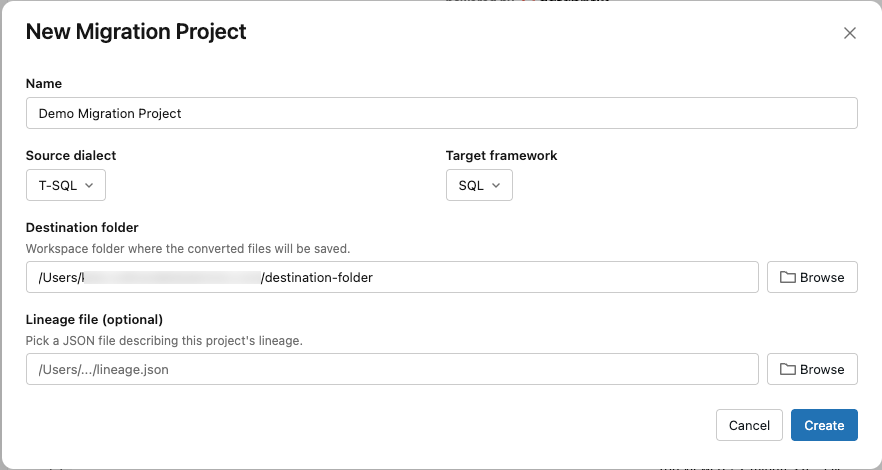
- Zadejte název projektu.
- Pomocí selektorů rozevíracího seznamu vyberte dialekt Zdroje a cílovou architekturu. Pro cílový rámec zvolte DBSQL pro generování Databricks SQL dotazů nebo Notebooks (Beta) pro generování Databricks notebooků. Pokud zvolíte Informatica jako zdrojový dialekt, cílový rámec je nastaven na Notebooks.
- Zadejte cestu k souboru do cílové složky. Kliknutím na Procházet vyberte cíl ze seznamu dostupných složek pracovního prostoru.
- Klikněte na Vytvořit.
Krok 3: Přidání souborů do projektu
V novém projektu:
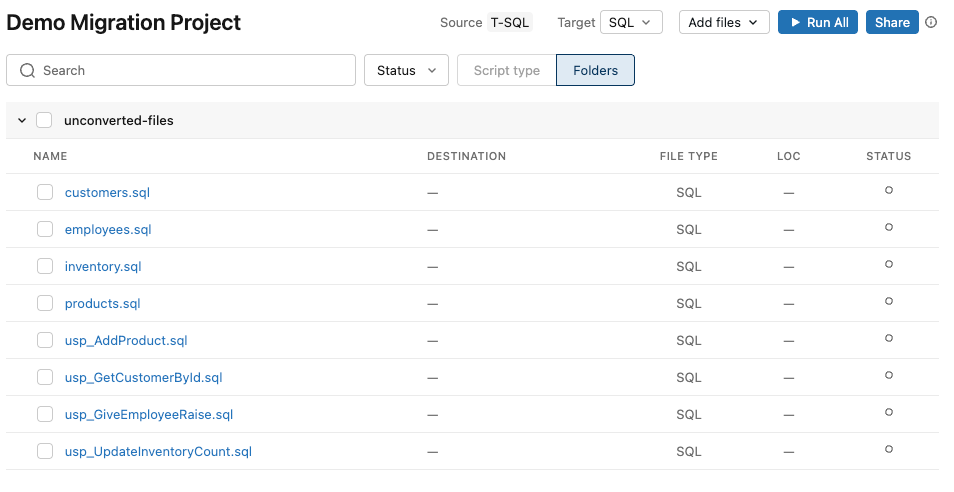
- Klikněte na Přidat soubory>+ Přidat soubory.
- Vyberte zdrojovou složku nebo soubor z pracovního prostoru.
V projektech Informatica se přidávají pouze .xml soubory. Soubory jiných typů jsou přeskočeny.
Záložka Soubory uvádí každý soubor s jeho typem souboru, počtem řádků a stavem konverze. Projekty Informatica se otevírají na záložce Inventář , která uvádí každý export s objekty, které obsahuje.
Krok 4: Zkontrolujte složitost kódu a historii (Beta)
Important
Tato funkce je v beta verzi. Pro jeho použití musí správce pracovního prostoru zapnout Experimentální funkce migrace projektů na stránce Náhledy . Viz Manage Azure Databricks preview.
Analyzujte projekt, abyste si prohlédli složitost kódu a závislosti mezi soubory, než začnete převádět. Analýza je volitelná u SQL projektů a povinná pro projekty Informatica.
Analyzovat projekt SQL:
- V projektu klikněte na Analyzovat vše. Pokud projekt nemá historii návaznosti, výchozí akcí je Analyzovat vše. Jinak vyberte Analyzovat vše z rozbalovacího menu tlačítka. Analýza pokrývá každý soubor v projektu, i když vyberete soubory.
- Počkejte, až analýza skončí. Chcete-li zrušit probíhající analýzu, klikněte na Stop. Po dokončení analýzy se tlačítko změní na Převést vše.
- Klikněte na zdrojový soubor pro otevření jeho hodnocení složitosti a klikněte na Lineage pro otevření grafu závislostí, který zobrazuje vzájemně závislé soubory a tabulky, jež musíte migrovat dohromady.
Pro analýzu projektu Informatica klikněte na Analyzovat vše na záložce Inventář . Analýza rozděluje každý export na jeho pracovní postupy, worklety, mapování a mapplety. Musíte analyzovat export, než ho můžete převést.
Krok 5: Spuštění převodu
V projektech Informatica vybíráte a převádíte workflow, mapování a další objekty, které analýza vytváří, nikoli nahrané .xml exporty.
Pro převod konkrétních souborů je vyberte a klikněte na Převést vybrané. Pro převod všech souborů v projektu vymažte výběr a klikněte na Převést vše. Genie Code zahájí konverzaci, spustí migrační dovednost a nasadí subagenty, aby souběžně převedly soubory. Každý převedený soubor se v projektu zobrazí jako propojený soubor. Každý soubor ukazuje jeden z následujících stavů:
- Šedá: Soubor ještě nebyl převeden (Nebyl spuštěn, Frontován ani Zastaven). Během převodu souboru se zobrazí spinner.
- Nevyplněná zelená: Soubor byl převeden bez problémů (Převedeno).
- Vyplněno zeleně: Zkontrolovali jste a přijali převedený soubor (Zkontrolováno).
- Žlutá: Soubor byl převeden, ale obsahuje položky vyžadující akci, které je potřeba zkontrolovat.
- Červená barva: Konverze selhala (Chyba).
Každý běh převede až 500 souborů. Pokud zařadíte do fronty více než 500 souborů, prvních 500 nepřevedených souborů se zpracuje v aktuální dávce. Po dokončení dávky začněte konverzi znovu, abyste převedli dalších 500.
Krok 6: Kontrola výsledků převodu
Pro SQL projekty Databricks klikněte na převedený soubor a otevřete v SQL editoru inline diff, který zobrazí každou část zdrojového kódu nad navrhovaným Databricks SQL, který ji nahrazuje. Přijměte všechny navrhované změny nebo zkontrolujte a přijměte jednotlivé úpravy. Pro projekty Notebooks klikněte na převedený soubor a otevřete vygenerovaný notebook Databricks. V případě skriptů, které se nepodaří převést, upravte kód v editoru nebo požádejte Genie Code, aby znovu ověřil nebo zopakuje konkrétní oddíly. Jakmile budete spokojeni, spusťte převedený SQL nebo notebook, abyste potvrdili, že běží na Azure Databricks. Pokud se stejná chyba objeví ve více souborech, zachyťte opravu v vlastní dovednosti a spusťte tyto soubory znovu. Přečtěte si Vytvoření vlastní dovednosti (volitelné).
U projektů Informatica porovnejte každý vygenerovaný notebook s odpovídajícím PowerCenter mapováním. Zkontrolujte zdrojové a cílové tabulky, joiny, filtry a skupiny routerů, lookupy, logiku Update Strategy a parametry. Než použijete převedený pipeline v produkci, spusťte ho na neprodukčních datech a porovnejte výsledky jako počet řádků a agregace klíčů s výstupem workflow PowerCenter.
Vytvoření vlastní dovednosti (volitelné)
Vlastní dovednosti umožňují kódovat obchodní pravidla, která Genie Code použije automaticky při každém převodu. Můžete je použít ke zpracování proprietárních datových typů, vynucení upřednostňovaných cílových vzorů nebo k zachycení oprav, které provedete opakovaně. Dovednost migrace je dovednost Genie Code, takže ji můžete vytvořit a spravovat stejným způsobem jako jakoukoli jinou dovednost. Další podrobnosti najdete v článku Rozšíření kódu Genie pomocí dovedností agenta.
Nemusíte si před prvním převodem definovat všechny své dovednosti. Většina pravidel, která by měla dovednost zachytit, se vyjasní až po prohlédnutí prvních výsledků. Typický pracovní postup je:
- Převeďte reprezentativní sadu souborů.
- Prohlédněte si soubory s akčními položkami nebo chybami a hledejte chyby, které se opakují napříč soubory, například stejný nepodporovaný datový typ, funkce nebo vzor pojmenování.
- Vytvořte skill, který uloží opravu každé opakující se chyby.
- Vyberte pouze dotčené soubory a klikněte na Převést vybrané. Genie Code aplikuje novou dovednost na tyto soubory.
Tento cyklus opakujte při převádění další části svého kódu. Genie Code aplikuje každou dovednost na pozdější konverze v pracovním prostoru, takže jedna oprava pokrývá i jiné soubory se stejným vzorem.
Dovednosti můžete vytvořit z nastavení Genie Code nebo z konverzace Genie Code. Použijte cestu nastavení pro složité dovednosti, které obsahují podrobné pokyny, příklady nebo podpůrné soubory. Použijte chatovací cestu pro rychlé dovednosti s jediným pravidlem.
Nastavení kódu Genie
Vytvořte dovednost jako soubor, abyste mohli vytvořit podrobné pokyny a verzi ve složce Git:
Na panelu Genie Code klikněte na
 Nastavení a potom klikněte na
 Otevřete složku dovedností.
Vytvořte složku pro svou dovednost v rámci cesty dovedností pracovního prostoru .
Workspace/.assistant/skills/Například:Workspace/.assistant/skills/sql-migration/.Ve složce skillu vytvořte soubor
SKILL.mds požadovanou hlavičkou a pravidly konverze. Příklady:--- name: sql-migration description: Conversion rules to apply when migrating legacy SQL to ANSI SQL. --- Always convert the custom type MYDATE to TIMESTAMP_NTZ.
Genie Code převezme dovednost při příštím spuštění převodu.
Chat Genie Code
Popište pravidlo převodu, které chcete kódovat, a potom požádejte Genie Code, aby ho uložil:
Tip
Always convert our custom type MYDATE to TIMESTAMP_NTZ. Save this as a custom migration skill.
Genie Code vytvoří a zaregistruje dovednost a použije ji pro budoucí převody v pracovním prostoru.
Zobrazit aktivní dovednosti:
Tip
Show me my migration skills
Odebrání dovednosti:
Tip
Delete the migration skill for [description]
Dovednosti pracovního prostoru se ukládají na úrovni pracovního prostoru a sdílejí se mezi všemi uživateli v pracovním prostoru.
Tipy pro testování
V rámci své agentické smyčky převaděč analyzuje každý zdrojový skript, ověřuje, že převedený výstup je syntakticky platný a sémanticky ekvivalentní zdroji, a iterativně opravuje části, které neprojdou ověřením, před zapsáním výsledků. Následující tipy vám pomůžou zkontrolovat a získat důvěru ve výstup:
- Dávkový převod: Převeďte malou dávku dvou až pěti souborů v jedné relaci, abyste ověřili, že převod více souborů funguje od začátku do konce.
- Ověření syntaxe: Po převodu spusťte výstup v editoru NEBO poznámkovém bloku SQL Databricks a ověřte, že se spustí bez chyb.
-
Hraniční případy: Zahrňte skript s konstruktory specifickými pro dialekt, jako jsou funkce oken T-SQL, Snowflake
QUALIFYnebo RedshiftLISTAGG, abyste viděli, jak převaděč zpracovává jiné než triviální vzory. - Sémantická správnost: Spusťte původní a převedené dotazy na ekvivalentní testovací data a porovnejte výsledky. Ověřte, že je výstup sémanticky správný, nejen syntakticky platný.