Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
Adaptivní spouštění dotazů (AQE) je opětovná optimalizace dotazů, ke které dochází během provádění dotazu.
Před spuštěním dotazu optimalizátor vybere plán dotazu na základě odhadů velikosti dat. Tyto odhady mohou být nesprávné, pokud chybí nebo jsou tabulkové statistiky zastaralé, pokud jsou data zkreslená, nebo pokud jde o pozdější kroky složitého dotazu. Plán postavený na špatných odhadech může používat pomalou strategii joinu, vytvořit příliš mnoho malých úkolů po shuffle nebo vytvořit několik nadměrně velkých úkolů, které zdrží celou fázi. AQE tyto problémy řeší tím, že během probíhání dotazu znovu optimalizuje plán na základě skutečné velikosti dat.
Na konci každého shuffle nebo broadcast má Azure Databricks přesné statistiky pro dosud vytvořená data. AQE využívá tyto statistiky k výběru lepší fyzické strategie, optimálního počtu a velikosti post-shuffle oddílů nebo k aplikaci optimalizací, které jinak vyžadují hinty dotazu, například zpracování nevyváženého spojení.
Funkce AQE je ve výchozím nastavení povolená. Nemusíte měnit své dotazy, abyste z toho měli prospěch. Zkontrolujte, zda AQE nezměnilo plán dotazu, když řešíte pomalý dotaz. Nastavte AQE jen tehdy, když výchozí nastavení neodpovídají vaší pracovní zátěži. Viz Plány dotazů a Konfigurace.
Schopnosti
AQE má čtyři hlavní vlastnosti:
- Dynamicky změní třídící sloučené spojení na hash spojení s všesměrovým přenosem.
- Dynamicky slučuje oddíly (kombinování malých oddílů do rozumně velkých oddílů) po shuffle výměně. Velmi malé úlohy mají horší propustnost vstupně-výstupních operací a mají tendenci mít větší nároky na plánování režie a nastavení úloh. Kombinace malých úloh šetří prostředky a zlepšuje propustnost clusteru.
- Dynamicky zpracovává distribuční zkreslení v operacích spojení přes řazení a shuffle hash spojení tím, že rozděluje (a replikací v případě potřeby) úkoly se zkreslením do zhruba rovnoměrně velkých úkolů.
- Dynamicky detekuje a propaguje prázdné relace, které jsou částmi dotazu, ale nevracejí žádné řádky.
Podporované dotazy
AQE se vztahuje na dotazy, které splňují obě tyto podmínky:
- Nejedná se o streamovaný dotaz.
- Dotaz obsahuje alespoň jednu operaci exchange (obvykle ze spojení, agregace nebo okenní funkce), alespoň jeden poddotaz nebo obojí.
AQE znovu optimalizuje každý podporovaný dotaz, ale výsledek může být stejný plán, jaký optimalizátor zkompiloval před spuštěním dotazu. Chcete-li zjistit, zda AQE změnilo plán dotazu, viz Plány dotazů.
Plány dotazů
Použité dotazy AQE obsahují jeden nebo více AdaptiveSparkPlan uzlů, obvykle jako kořenový uzel každého hlavního dotazu nebo dílčího dotazu. Každý AdaptiveSparkPlan uzel má svůj isFinalPlan příznak. Příznak má hodnotu false před spuštěním dotazu i během jeho provádění a změní se na true, když dotaz skončí.
Pro zobrazení plánu dotazu použijte uživatelské rozhraní Spark, DataFrame.explain(), nebo SQL EXPLAIN. Každý z nich ukazuje jiné informace o tom, jak AQE mění plán.
Uživatelské rozhraní Sparku
Diagram plánu dotazu v rozhraní Spark ukazuje nejaktuálnější plán a aktualizuje se během běhu dotazu. Uzly, které už běžely a mají metriky, se nemění. Uzly, které se ještě nespustily, se mohou změnit, jak AQE plán znovu optimalizuje.
Tento příklad ukazuje diagram plánu dotazu:
diagram plánu dotazu 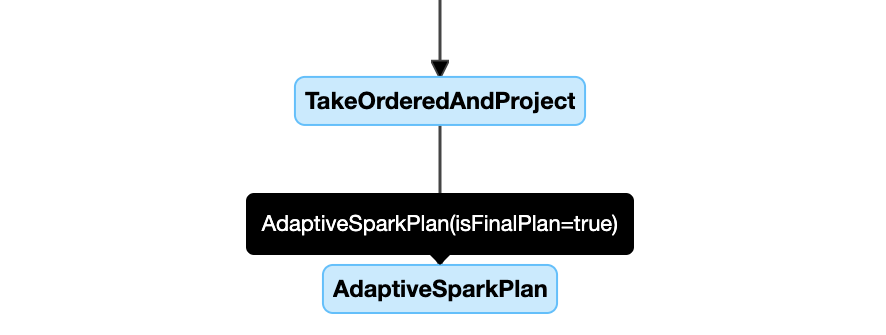
DataFrame.explain()
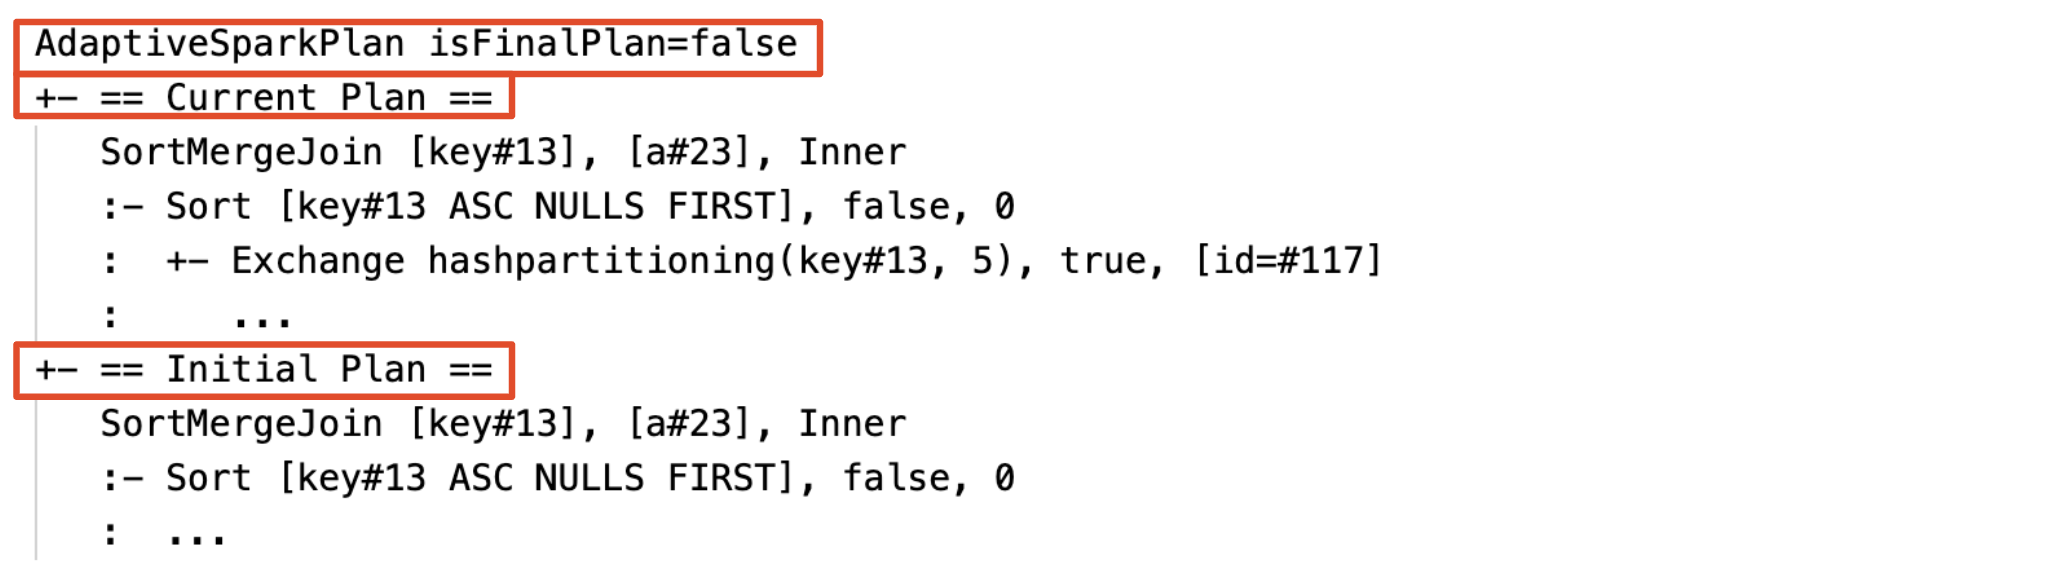
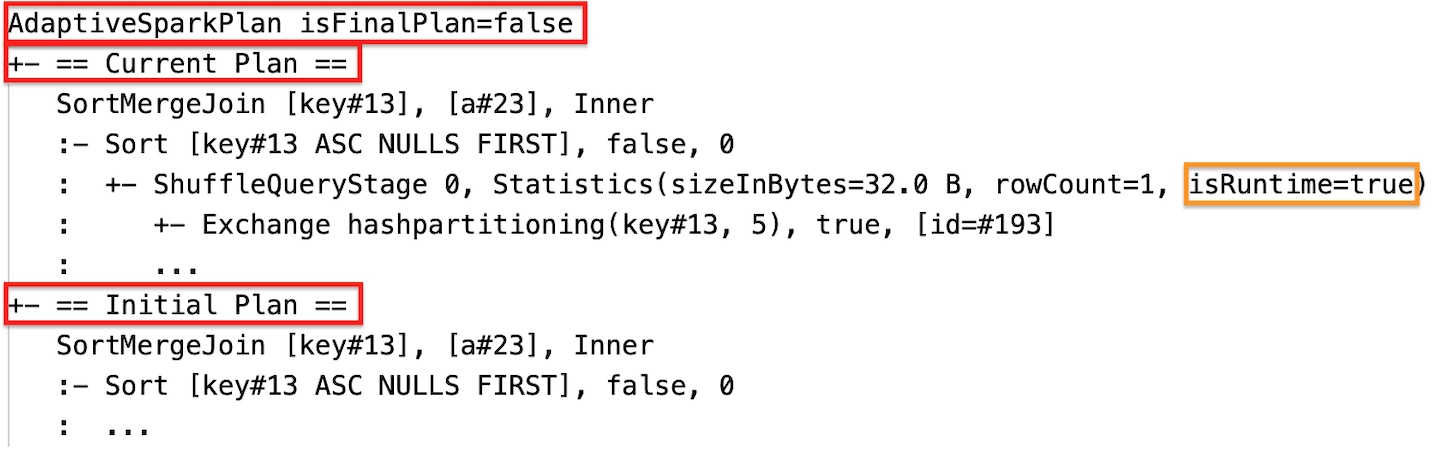
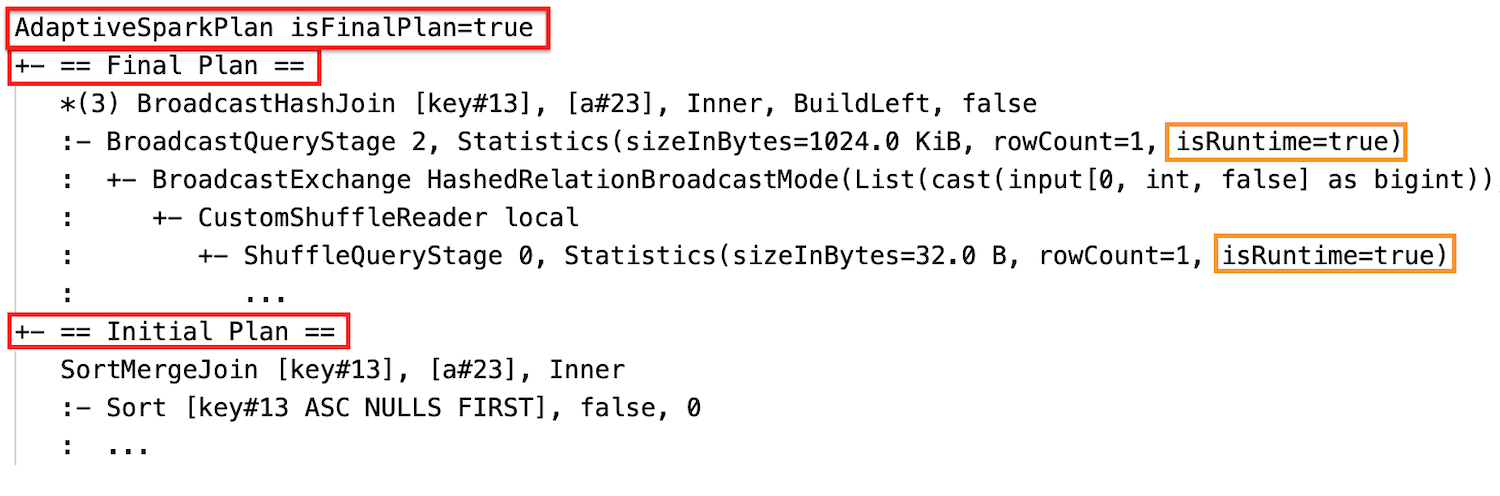
DataFrame.explain() ukazuje dva plány pod každým AdaptiveSparkPlan uzlem: počáteční plán, před tím, než AQE aplikuje jakékoli optimalizace, a aktuální plán. Současný plán se mění během běhu dotazu a stává se finálním plánem, když dotaz skončí.
Výstup obsahuje datové statistiky pro každou fázi zamíchání a broadcastu. Statistiky závisí na tom, zda etapa již proběhla:
- Před spuštěním etapy a během jejího běhu je
isRuntimefalsea statistiky jsou odhady z doby kompilace. Například:Statistics(sizeInBytes=1024.0 KiB, rowCount=4, isRuntime=false). - Po spuštění fáze je
isRuntimetruea statistiky jsou měření doby běhu. Například:Statistics(sizeInBytes=658.1 KiB, rowCount=2.81E+4, isRuntime=true).
Tyto screenshoty ukazují DataFrame.explain() výstup před, během a po provedení:
Před spuštěním
Během spouštění
Po spuštění
SQL EXPLAIN
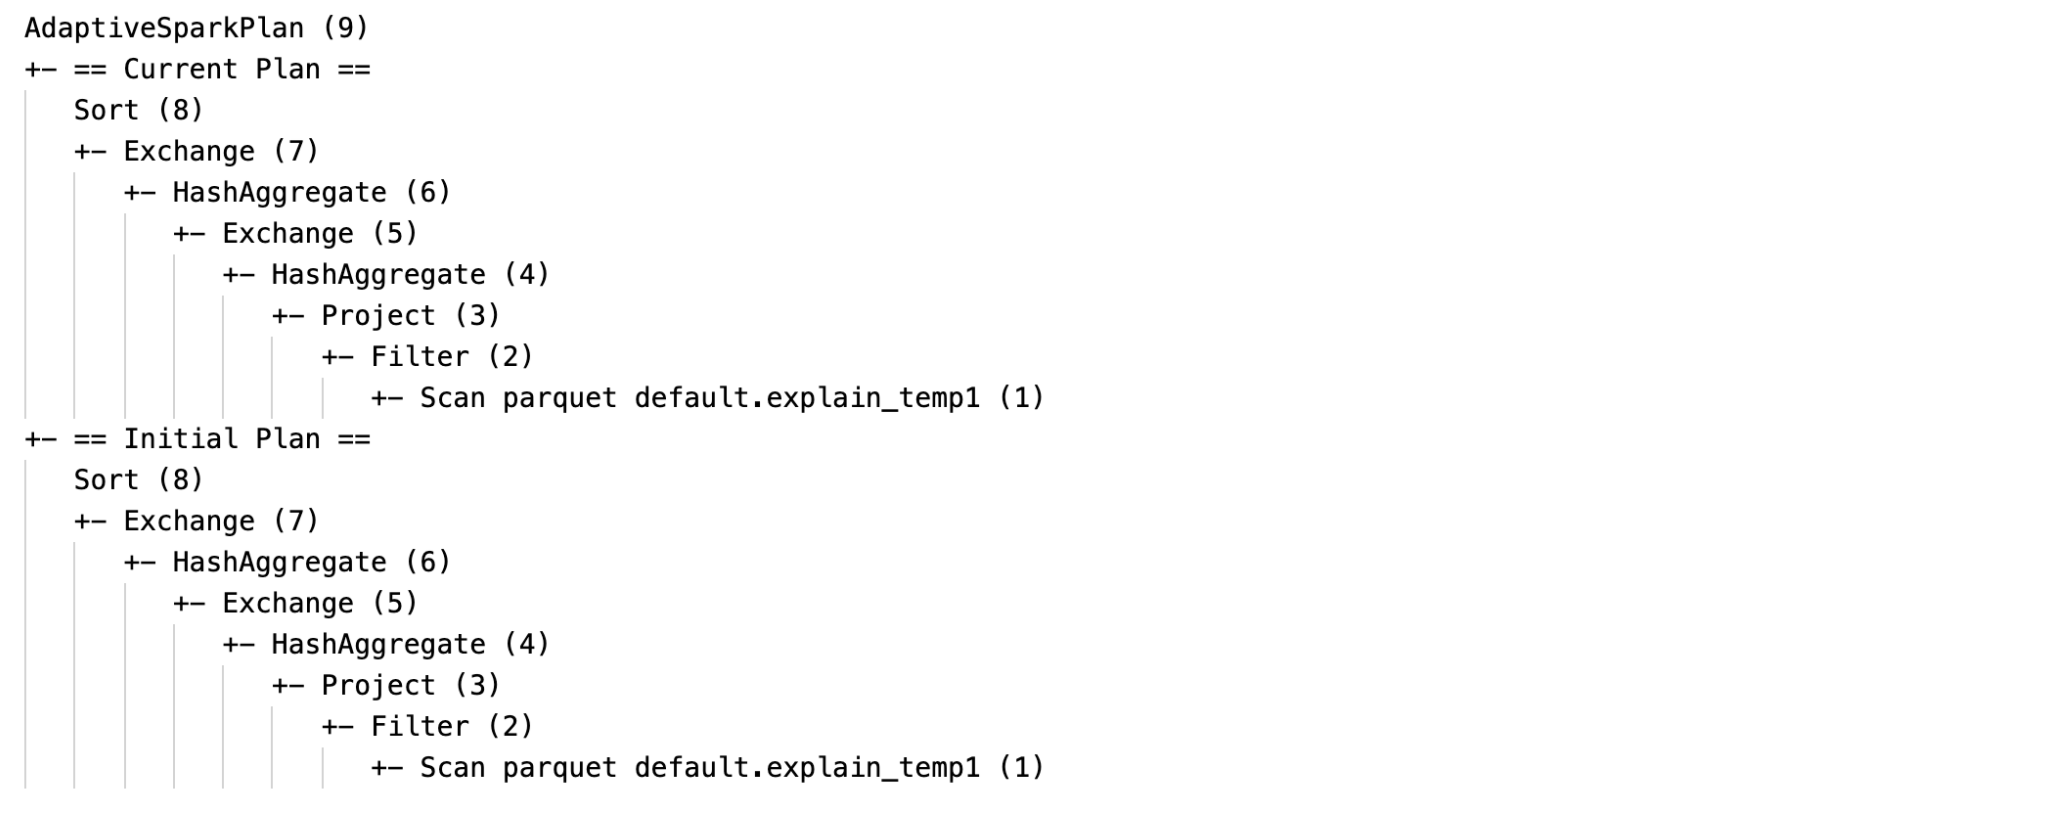
SQL EXPLAIN dotaz nespustí, takže AQE ho nemůže znovu optimalizovat. Výstup ukazuje pouze počáteční plán, který se může lišit od plánu, který AQE spouští.
Tento příklad ukazuje SQL EXPLAIN výstup:
Identifikujte aplikované optimalizace v plánu dotazu
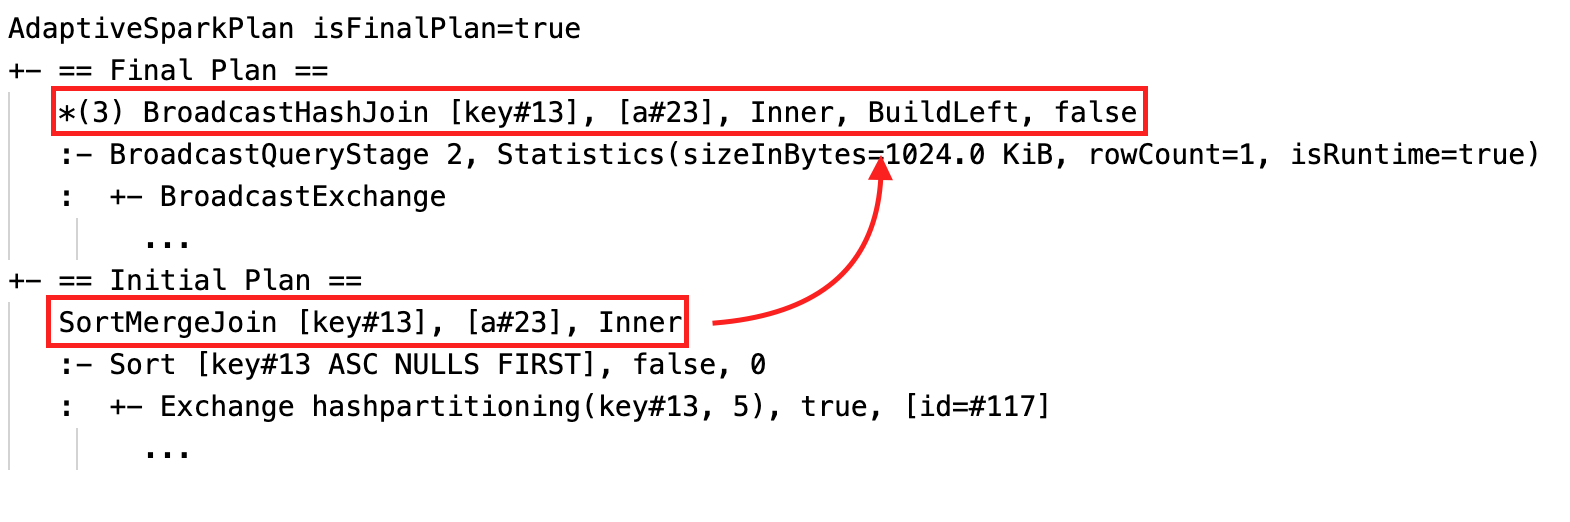
Když AQE aplikuje optimalizaci, plán dotazů se změní. Pro identifikaci, které optimalizace měly efekt, porovnejte aktuální nebo finální plán s původním plánem. Každá optimalizace mění plán specifickým způsobem:
Změna strategie spojení Současný nebo konečný plán má jiný fyzický spojovací uzel než původní plán.
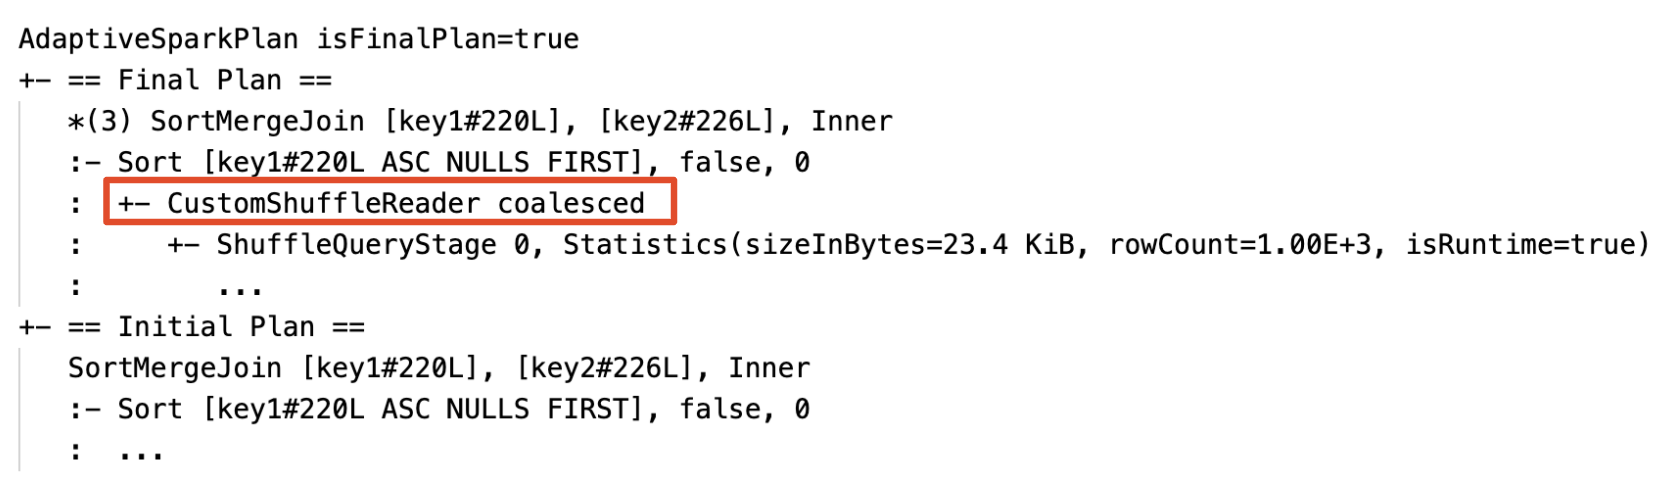
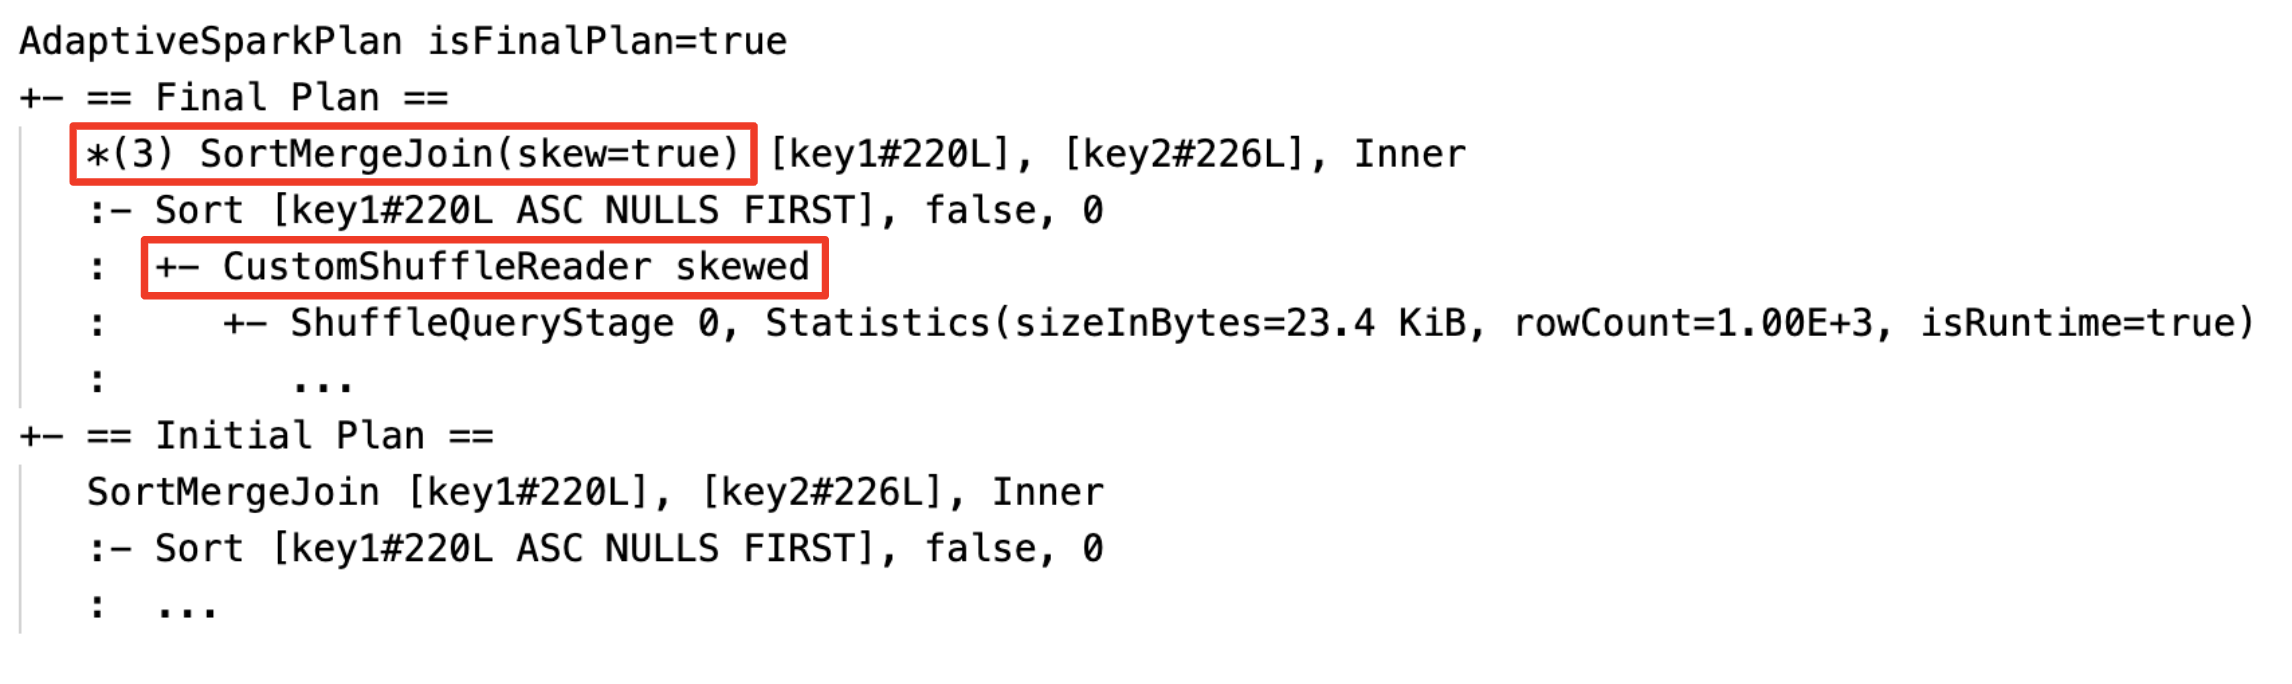
Slučování oddílů. Plán obsahuje uzel
CustomShuffleReaders vlastnostíCoalesced.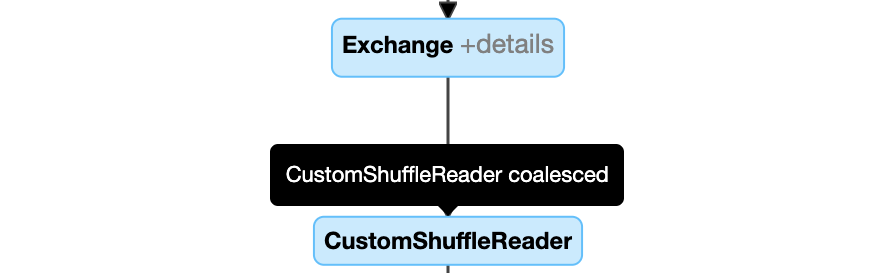
Zpracování skew joinu. Plán obsahuje uzel
SortMergeJoins polemisSkewnastaveným natrue.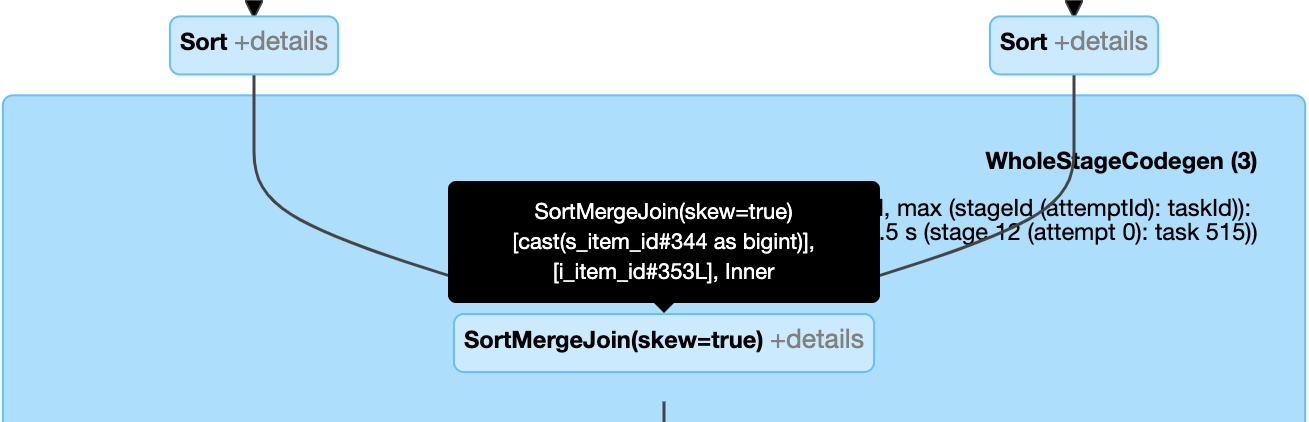
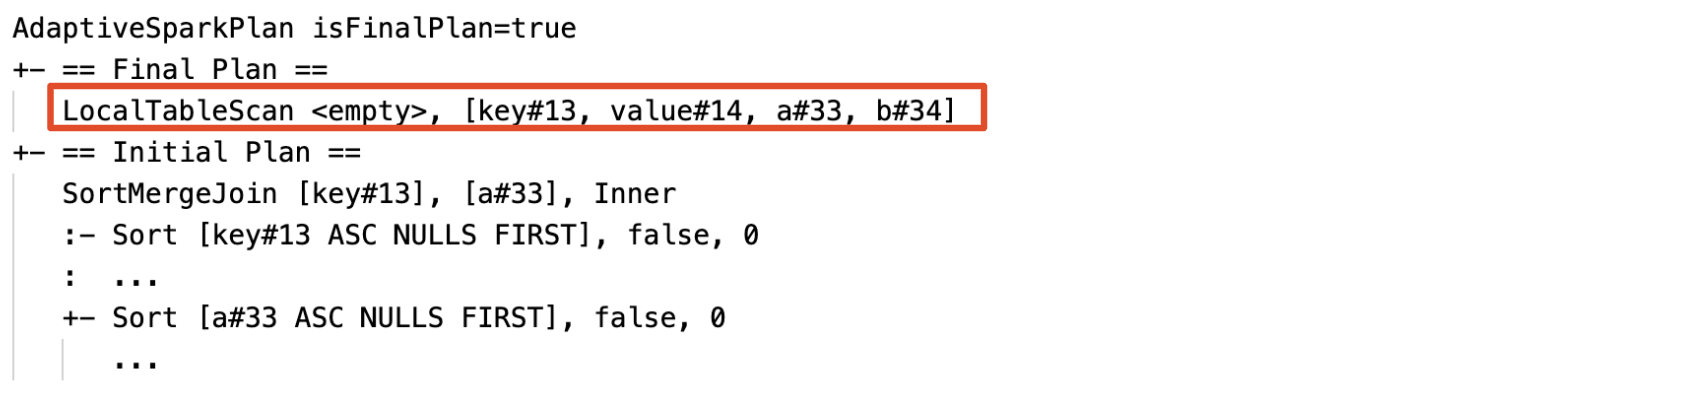
Šíření prázdných relací. Uzel
LocalTableScans prázdným polem relací nahrazuje část nebo celý plán.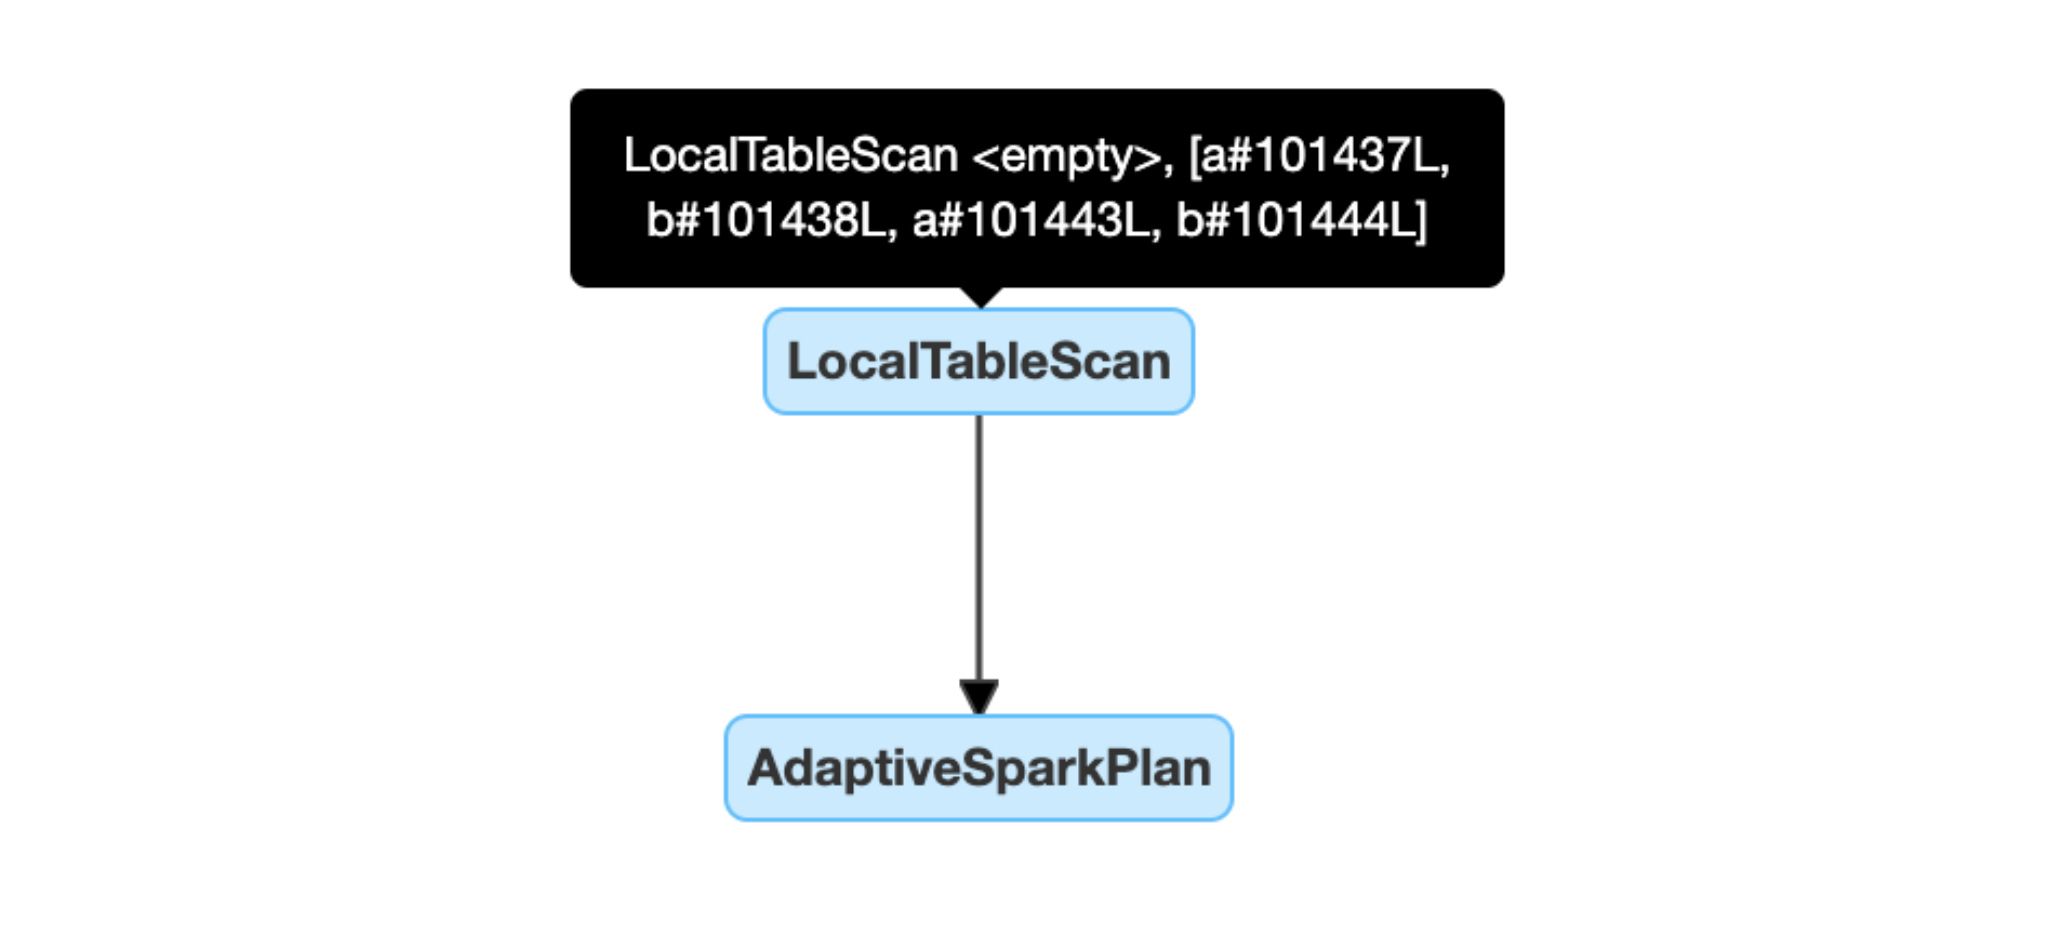
Konfigurace
Tyto konfigurační vlastnosti Apache Spark ovládají chování AQE. Většina pracovních zátěží nemusí měnit výchozí nastavení.
Povolte AQE a dolaďte jednotlivé optimalizace
Použijte tyto vlastnosti k zapnutí nebo vypnutí AQE a k ladění automaticky optimalizovaného shuffle, přepínání broadcast join a propagace prázdných relací:
| Vlastnost | Typ | Výchozí | Description |
|---|---|---|---|
spark.databricks.optimizer.adaptive.enabled |
Boolean |
true |
Zapíná nebo vypíná adaptivní spouštění dotazů. |
spark.sql.shuffle.partitions |
Integer |
200 |
Výchozí počet oddílů, které se mají použít při přeskupení dat pro spojování nebo agregaci. Nastavte to na auto, čímž povolíte automaticky optimalizované míchání, které nastavuje toto číslo na základě plánu dotazu a velikosti vstupních dat dotazu.U strukturovaného streamování tuto hodnotu nemůžete měnit mezi restarty dotazu ze stejného místa kontrolního bodu. |
spark.databricks.adaptive.autoBroadcastJoinThreshold |
Byte String |
30MB |
Velikost prahu pro přepnutí ze sort merge join na broadcast hash join za běhu. |
spark.databricks.adaptive.emptyRelationPropagation.enabled |
Boolean |
true |
Zapne nebo vypne dynamické šíření prázdných relací. |
Dynamicky zlučovat oddíly
| Vlastnost | Typ | Výchozí | Description |
|---|---|---|---|
spark.sql.adaptive.coalescePartitions.enabled |
Boolean |
true |
Zapne nebo vypne shlukování oddílů. |
spark.sql.adaptive.advisoryPartitionSizeInBytes |
Byte String |
64MB |
Cílová velikost po sloučení. Sloučené oddíly jsou blízko této velikosti, ale nejsou větší. |
spark.sql.adaptive.coalescePartitions.minPartitionSize |
Byte String |
1MB |
Minimální velikost oddílů po sjednocení. Shlukované oddíly nejsou menší než tato velikost. |
spark.sql.adaptive.coalescePartitions.minPartitionNum |
Integer |
Dvojnásobek počtu clusterových jader | Minimální počet oddílů po sloučení. Tuto vlastnost nenastavujte, protože její nastavení přepisuje spark.sql.adaptive.coalescePartitions.minPartitionSize. |
Dynamické zpracování zkoseného spojení
| Vlastnost | Typ | Výchozí | Description |
|---|---|---|---|
spark.sql.adaptive.skewJoin.enabled |
Boolean |
true |
To zapíná nebo vypíná zpracování skew joinů. |
spark.sql.adaptive.skewJoin.skewedPartitionFactor |
Integer |
5 |
Násobitel mediánu velikosti oddílu, který musí oddíl překročit, aby byl považován za zkosený. |
spark.sql.adaptive.skewJoin.skewedPartitionThresholdInBytes |
Byte String |
256MB |
Minimální velikost, kterou musí oddíl překročit, aby byl považován za nevyvážený. |
AQE považuje oddíl za nevyvážený pouze tehdy, když platí obě tyto podmínky: (partition size > skewedPartitionFactor * median partition size) a (partition size > skewedPartitionThresholdInBytes).
Nejčastější dotazy
Proč AQE nevysílala malou tabulku spojení?
Pokud je tabulka menší než spark.databricks.adaptive.autoBroadcastJoinThreshold, ale AQE ji nešíří, zkontrolujte tyto příčiny:
- Typ spojení nepodporuje vysílání. Některé typy spojů nemohou distribuovat jednu stranu. Například AQE nemůže rozesílat levou stranu
LEFT OUTER JOIN. - Tabulka má mnoho prázdných particí. Většina úkolů při spojení typu sort-merge se dokončí rychle nebo zpracování nevyváženého spojení optimalizuje spojení. AQE nemění sort merge join na broadcast hash join, pokud je procento neprázdných oddílů nižší než
spark.sql.adaptive.nonEmptyPartitionRatioForBroadcastJoin.
Měl bych stále používat hint broadcast joinu s aktivovaným AQE?
Ano, pokud svůj dotaz dobře znáte. Broadcast join, který optimalizátor plánuje před spuštěním dotazu, obvykle funguje lépe než ten, který AQE plánuje za běhu. AQE nemusí přepnout na broadcast join, dokud neprovede shuffle na obou stranách spojení, což je chvíle, kdy zjistí skutečné velikosti tabulek.
AQE respektuje hinty dotazu stejným způsobem jako statická optimalizace a stále aplikuje dynamické optimalizace, které hinty dotazu neovlivňují.
Mám použít nápovědu ke skew join nebo AQE skew join pro zpracování skew join?
Použijte zpracování skew joinů AQE. Je to automatické a obvykle funguje lépe než direktiva SKEW JOIN.
Proč mi AQE nepřeuspořádalo joiny?
AQE nepřeřazuje joiny za běhu. Pro zlepšení pořadí spojení shromážděte tabulkové statistiky, aby optimalizátor založený na nákladech mohl zvolit lepší plán. Viz optimalizátor založený na ceně.
Proč AQE nerozpoznal nerovnoměrnou distribuci dat?
AQE považuje oddíl za nevyvážený pouze tehdy, když platí obě tyto podmínky:
- Partition je větší než
spark.sql.adaptive.skewJoin.skewedPartitionThresholdInBytes(výchozí256MB). - Oddíl je větší než
spark.sql.adaptive.skewJoin.skewedPartitionFactornásobek mediánové velikosti oddílu (výchozí5).
AQE také zpracovává nevyváženost dat pouze ve spojeních založených na shuffle, což jsou sort-merge joiny a shuffle hash joiny. Nikdy neoptimalizuje skew při broadcast joinech. Pro joiny založené na shuffle určuje typ spojení, kterou stranu může AQE optimalizovat:
| Typ spojení | Optimalizovaný sklon na levé straně | Zešikmení optimalizované na pravé straně |
|---|---|---|
INNER |
Yes | Yes |
CROSS |
Yes | Yes |
LEFT OUTER |
Yes | No |
RIGHT OUTER |
No | Yes |
LEFT SEMI |
Yes | No |
LEFT ANTI |
Yes | No |
FULL OUTER |
No | No |
Dědictví
Spark 1.6 zavedl funkci zvanou adaptivní provádění, ale AQE ve Spark 3.0 je jiná funkce. Adaptivní exekuce ve Spark 1.6 pouze dynamicky slučuje partice. AQE je framework, který plánuje a přeplánovává dotazy na základě statistik za běhu a podporuje všechny optimalizace uvedené na této stránce.