Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
Spark SQL využívá optimalizátor založený na nákladech (CBO) k výběru efektivních plánů dotazů. CBO používá tabulkové a sloupcové statistiky, jako je velikost tabulky a rozložení dat, k odhadu nákladů alternativních plánů a výběru plánu s nejnižšími odhadovanými náklady. To je nejdůležitější u dotazů s více spojeními, kde špatný plán může být řádově pomalejší než ten dobrý.
CBO je ve výchozím nastavení zapnuté, ale záleží na statistikách. Pokud chybí nebo jsou statistiky zastaralé, CBO může zvolit neefektivní pořadí připojení nebo strategii připojení. Sbírejte tabulkové a sloupcové statistiky a udržujte je aktuální. Viz Shromažďování statistik.
Doporučené postupy
Abychom CBO pomohli vybrat efektivní plány dotazů, dodržujte tyto postupy:
- Shromažďujte statistiky pro tabulky používané v dotazech s více spojeními. Pokud použijete prediktivní optimalizaci na řízených tabulkách Unity Catalog, statistiky se za vás sbírají. Viz Shromažďovat statistiky.
- Zkontrolujte plány dotazů , když je dotaz s více spoji pomalejší, než se očekává. Chybějící nebo nepřesné statistiky jsou častou příčinou. Viz Ověření plánů dotazů.
- Odstraňte statistiky nebo deaktivujte CBO jen proto, abyste zmírnili konkrétní plánovací problém, který statistiky způsobují. Podívejte se na Vypnout optimalizátor založený na ceně.
Shromažďování statistik
Abyste získali plnou výhodu CBO, je důležité shromáždit statistiky sloupců i statistiky tabulek . Pomocí příkazu můžete ANALYZE TABLE ručně shromažďovat statistiky.
Tip
Abyste udrželi statistiky aktuální, spusťte ANALYZE TABLE po zápisu do tabulky.
Použít ANALYZE
Prediktivní optimalizace automaticky spouští příkaz ANALYZEpro shromažďování statistik v tabulkách spravovaných Katalogem Unity. Databricks doporučuje povolit prediktivní optimalizaci pro všechny spravované tabulky Katalogu Unity, aby se zjednodušila údržba dat a snížily náklady na úložiště. Viz ANALYZE TABLE ... VÝPOČETNÍ STATISTIKA.
Statistiky optimalizátoru můžete odstranit, aby se na ně optimalizátor již nespoléhal, například ke zmírnění problému s plánováním způsobeného těmito statistikami. Viz ANALYZE TABLE ... DROP STATISTICS.
Ověřte plány dotazů
Plán dotazů můžete ověřit několika způsoby.
EXPLAIN příkaz
Pokud chcete zkontrolovat, jestli plán používá statistiky, použijte příkaz EXPLAINSQL .
Pokud statistiky chybí, nemusí být plán dotazu optimální.
== Optimized Logical Plan ==
Aggregate [s_store_sk], [s_store_sk, count(1) AS count(1)L], Statistics(sizeInBytes=20.0 B, rowCount=1, hints=none)
+- Project [s_store_sk], Statistics(sizeInBytes=18.5 MB, rowCount=1.62E+6, hints=none)
   +- Join Inner, (d_date_sk = ss_sold_date_sk), Statistics(sizeInBytes=30.8 MB, rowCount=1.62E+6, hints=none)
      :- Project [ss_sold_date_sk, s_store_sk], Statistics(sizeInBytes=39.1 GB, rowCount=2.63E+9, hints=none)
      :  +- Join Inner, (s_store_sk = ss_store_sk), Statistics(sizeInBytes=48.9 GB, rowCount=2.63E+9, hints=none)
      :     :- Project [ss_store_sk, ss_sold_date_sk], Statistics(sizeInBytes=39.1 GB, rowCount=2.63E+9, hints=none)
      :     :  +- Filter (isnotnull(ss_store_sk) && isnotnull(ss_sold_date_sk)), Statistics(sizeInBytes=39.1 GB, rowCount=2.63E+9, hints=none)
      :     :     +- Relation[ss_store_sk,ss_sold_date_sk] parquet, Statistics(sizeInBytes=134.6 GB, rowCount=2.88E+9, hints=none)
      :     +- Project [s_store_sk], Statistics(sizeInBytes=11.7 KB, rowCount=1.00E+3, hints=none)
      :        +- Filter isnotnull(s_store_sk), Statistics(sizeInBytes=11.7 KB, rowCount=1.00E+3, hints=none)
      :           +- Relation[s_store_sk] parquet, Statistics(sizeInBytes=88.0 KB, rowCount=1.00E+3, hints=none)
      +- Project [d_date_sk], Statistics(sizeInBytes=12.0 B, rowCount=1, hints=none)
         +- Filter ((((isnotnull(d_year) && isnotnull(d_date)) && (d_year = 2000)) && (d_date = 2000-12-31)) && isnotnull(d_date_sk)), Statistics(sizeInBytes=38.0 B, rowCount=1, hints=none)
            +- Relation[d_date_sk,d_date,d_year] parquet, Statistics(sizeInBytes=1786.7 KB, rowCount=7.30E+4, hints=none)
Důležité
Statistika rowCount je obzvláště důležitá pro dotazy s více spojeními. Pokud rowCount chybí, znamená to, že neexistuje dostatek informací k výpočtu (to znamená, že některé požadované sloupce nemají statistiky).
V Databricks Runtime 16.0 a vyšších výstup EXPLAIN příkazu uvádí odkazované tabulky, které mají chybějící, částečné a úplné statistiky, například:
== Optimizer Statistics (table names per statistics state) ==
  missing = date_dim, store
  partial =
  full    = store_sales
Corrective actions: consider running the following command on all tables with missing or partial statistics
  ANALYZE TABLE <table-name> COMPUTE STATISTICS FOR ALL COLUMNS
Uživatelské rozhraní Spark SQL
Na stránce uživatelského rozhraní Spark SQL můžete zobrazit spuštěný plán a přesnost statistiky.
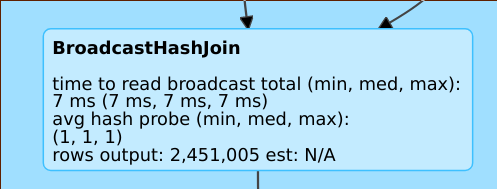
Řádek, například rows output: 2,451,005 est: N/A znamená, že tento operátor vytváří přibližně 2M řádky a nebyly k dispozici žádné statistiky.
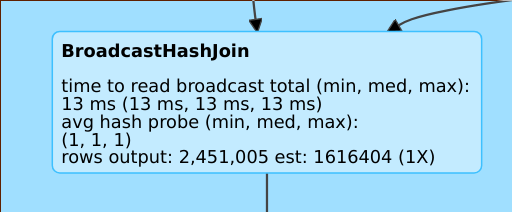
Řádek, například rows output: 2,451,005 est: 1616404 (1X) znamená, že tento operátor vytváří přibližně 2M řádků, přičemž odhad byl přibližně 1,6M a faktor odhadu chyby byl 1.
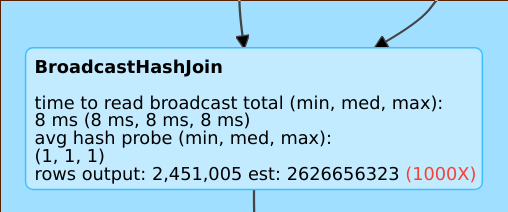
Řádek jako rows output: 2,451,005 est: 2626656323 znamená, že tento operátor vytváří přibližně 2 miliony řádků, zatímco odhad byl 2 miliardy řádků, takže chybový faktor odhadu byl 1 000.
Vypněte optimalizátor založený na nákladech
CBO je ve výchozím nastavení povolené. CBO zakážete změnou příznaku spark.sql.cbo.enabled .
spark.conf.set("spark.sql.cbo.enabled", false)