Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
Important
Položky označené jako náhled v tomto článku jsou aktuálně ve verzi Preview. Tato verze Preview se poskytuje bez smlouvy o úrovni služeb a Microsoft ji nedoporučuje pro produkční úlohy. Některé funkce nemusí být podporované nebo můžou mít omezené možnosti. Další informace najdete v dodatečných podmínkách použití pro verze Preview v Microsoft Azure.
Important
Interaktivní školení vyžaduje výslovné schválení přístupu. Před vytvořením trénovací relace požádejte o přístup prostřednictvím registračního formuláře ve verzi Preview a počkejte na schválení.
Interaktivní trénování (Preview) je rozhraní API pro vytváření vlastních cyklů následného trénování nad modely s otevřenými vahami v Microsoft Foundry. Experiment můžete ovládat v Pythonu. Foundry provádí vzorkování modelů a aktualizace přizpůsobení s nízkým pořadím (LoRA) na bezserverových GPU.
Pro posilované učení (RL) váš kód řídí sběr rolloutů, odměny, výhody a plánování aktualizací. Stejné primitivy podporují učení pod dohledem, učení z preferencí, destilaci a workflowy s vlastní ztrátovou funkcí.
Kdy ji použít
Interaktivní trénování použijte, když je samotná smyčka trénování součástí vašeho výzkumu:
- Potřebujete vlastní signál učení. Poskytnout ukázky, vypočítat odměny a výhody nebo sestavit lokální ztrátu pro učení preferencí nebo jiné cíle.
- Váš model komunikuje s prostředím. Koordinujte odpovědi modelu, volání nástrojů, pozorování a odměny ve vaší řídicí aplikaci.
- Potřebujete mít kontrolu nad jednotlivými aktualizacemi. Vyberte dávky, masky tokenů, nastavení ztráty a parametry optimalizátoru. Rozhodněte se, kdy se mají shromáždit gradienty a použít aktualizaci.
- Chcete zkontrolovat a přizpůsobit experiment. Odeberte vzorek z aktuálního adaptéru, vyhodnoťte jej na vyhrazených testovacích výzvách a vyberte další výzvy na základě pozorovaných výsledků.
- Potřebujete zachovat postup a pokračovat. Uložte stav adaptéru a optimalizátoru a pak obnovte kompatibilní relaci. Zachovejte pozici datové sady a další stav experimentu v driveru.
Spravované jemné ladění také podporuje hodnotitele pro doladění pomocí posilovaného učení. Interaktivní trénování si vyberte, když potřebujete mít kontrolu nad smyčkou, ne jen nad nastavením hodnoticího nástroje nebo úlohy. Viz volbu přístupu ke školení.
Kdo co dělá
Váš program v Pythonu je spouštěcí program pro trénování. Připraví vstupy a koordinuje experiment. Foundry udržuje stav modelu a adaptéru a provádí požadované operace.
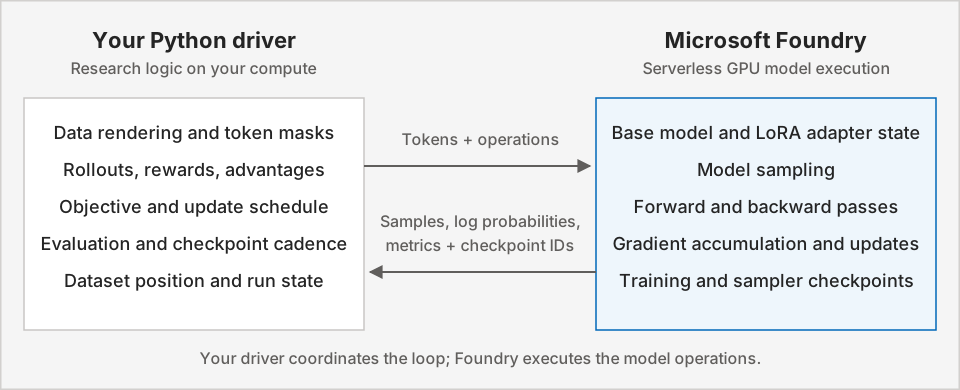
Váš driver může běžet na CPU, včetně vašeho vlastního počítače nebo výpočetního prostředí. Model odměny nebo prostředí, které přidáte, může mít vlastní požadavky na výpočetní prostředky. Nechte řidiče běžet během správy smyčky.
Základní koncepty a primitivy
Sezení je stavové: výpočet gradientu, aktualizace optimalizátoru a vzorkování jsou samostatné operace na vybraném modelu a adaptéru. Toto oddělení umožňuje zvolit, kdy shromažďovat data, akumulovat gradienty, aktualizovat a vyhodnocovat.
| Obytný blok | Jak funguje |
|---|---|
| Trénovací relace a adaptér LoRA |
FineTuningSession.create inicializuje podporovaný základní model s konfigurací adaptéru. Sezení obsahuje stav používaný následujícími operacemi. |
| Tokenizovaná dávka a masky |
Datum přenáší vstupy modelu a vstupy funkce ztráty. Masky vyberou, které tokeny přispívají k učení, například tokeny pomocníka, a nikoli prompty nebo pozorování nástrojů. |
| Vzorkování |
sample generuje odpovědi z vybraného checkpointu sampleru. Vstupy RL párují vzorkované tokeny s logaritmy pravděpodobností rolloutu a advantage hodnotami odvozenými od odměny. |
| Průchody vpřed a vzad |
forward vrátí výstupy funkce ztráty podle příkladu bez akumulace gradientů.
forward_backward vypočítá vybraný cíl a shromažďuje gradienty. Nepoužije aktualizaci optimalizátoru. |
| Aktualizace optimalizátoru |
optim_step použije kumulované gradienty s parametry Adam. Zvolíte, kdy aktualizovat a jakou rychlost učení použít. |
| Checkpoint sampleru |
save_weights_for_sampler připraví váhy adaptéru pro generování. Aktualizujte tyto váhy po aktualizaci před vzorkováním z aktualizovaného adaptéru. |
| Kontrolní bod tréninku |
save_weights uchovává váhy adaptéru a stav optimalizátoru.
FineTuningSession.create_from_checkpoint pokračuje v trénování v kompatibilní relaci. |
Sada SDK zahrnuje cross_entropy pro aktualizace v rámci učení s učitelem a ztrátové funkce pro RL, jako jsou importance_sampling a ppo. Tyto ztráty jsou primitivy ztráty, nikoli předdefinované end-to-end algoritmy. Informace o vstupních kontraktech a složení vlastních ztrát najdete v tématu Klíčové koncepty.
Jak funguje smyčka RL
Představte si experiment zaměřený na matematické uvažování: váš model generuje několik odpovědí na každý problém a program ohodnocuje jejich správnost. Názorný příklad najdete v Začínáme.
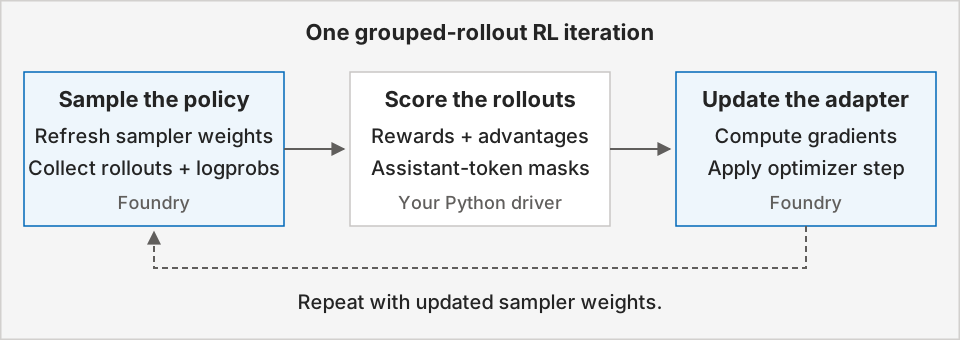
Před první aktualizací vytvořte oddělenou referenční základnu a otestujte svou funkci odměny. Pak to zopakujte:
- Připravte aktuální zásady pro vzorkování. Uložte váhy sampleru z trénovacího adaptéru a pak pro každou výzvu shromážděte několik odpovědí nebo rollouty.
- Ohodnoťte a porovnejte odpovědi. Funkce odměny přiřadí každému rolloutu skóre. Odečtěte střední odměnu skupiny promptů, aby vznikla advantage každého rolloutu.
- Připravte výukový signál. Zarovnejte vzorkované tokeny asistenta s logaritmickými pravděpodobnostmi rolloutu a advantážemi jejich průběhu. Vylučte z výukového signálu prompty a pozorování prostředí.
- Vypočítat gradienty. Odešlete dávku do
forward_backwardpomocíimportance_sampling. Před aktualizací, která jej využívá, dokončete výpočet gradientu. - Aktualizujte adaptér. Zavolejte
optim_step, pak aktualizujte váhy vzorkovníku před shromažďováním odpovědí z aktualizované zásady. - Vyhodnoťte a zachovejte průběh Porovnejte správnost na validačních datech s baseline a uložte kontrolní body trénování ve zvoleném intervalu.
Začínáme
Vyberte výchozí bod, který odpovídá vašemu úkolu:
- Rychlý start: Podle ukázky rychlého startu naklonujte úložiště a spusťte krátký recept na posilované učení.
- Vyzkoušejte další recepty: Další příklady trénování najdete v úložišti ukázek pro vyladění .
- Vyhledání operace: Pro funkce a klíčové parametry použijte přehled SDK (Preview).
- Pochopte trénovací smyčku: Přečtěte si Klíčové koncepty o odměnách, výhodách, maskách tokenů a kontrolních bodech.
Podporované modely a oblasti
Podívejte se na přehled vyladění podporovaných modelů a podporovaných oblastí.