Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
Flex processing (Preview) poskytuje inferenci se slevou 50 % oproti standardnímu zpracování pro úlohy, které snášejí pomalejší odezvu a občasnou nedostupnost prostředků. Zvolte zpracování Flex pro jednotlivý požadavek rozhraní Responses API nebo Chat Completions API nastavením service_tier na flex.
Flexibilní zpracování používejte pro neinteraktivní a práci s nižší prioritou, jako jsou hodnocení modelů, rozšiřování dat, analýza dokumentů a asynchronní pracovní postupy aplikací. Pro úlohy citlivé na latenci nebo úlohy citlivé na kapacitu použijte standardní zpracování, zpracování priority nebo zřízenou propustnost.
Important
Se zavedením zpracování Flex se požadavky, které nastavují service_tier na flex, zpracovávají pouze tehdy, když vybraný model podporuje zpracování Flex. Nepodporovaný model vrátí http 400 invalid_request_error a nepřejde zpět na standardní zpracování. Na režim Flex processing se nevztahuje SLA latence ani SLA služby.
Předpoklady
Předplatné služby Azure. Vytvořte si ho zdarma.
Prostředek Azure OpenAI s podporovaným modelem nasazeným s využitím typu globálního standardního nasazení.
Koncový bod prostředku a klíč API nebo přihlašovací údaje Microsoft Entra ID. Příklady v tomto článku používají klíč rozhraní API uložený v
AZURE_OPENAI_API_KEYproměnné prostředí.Pracovní zátěž, která dokáže tolerovat proměnlivou latenci a přechodné odpovědi oznamující nedostupnost prostředků.
Python 3.10 nebo novější a balíček OpenAI Python pro příklady Python:
pip install --upgrade openai
Odeslání žádosti Flex
Nastavte service_tier na flex v každém požadavku, který by měl používat zpracování Flex. Hodnota model je název nasazení modelu Azure.
Python
Následující příklad odešle požadavek Flex pomocí rozhraní API pro odpovědi:
import os

from openai import OpenAI

AZURE_OPENAI_ENDPOINT = "https://YOUR-RESOURCE-NAME.openai.azure.com"

# Create a client with a longer timeout for Flex requests.
openai = OpenAI(
    base_url=f"{AZURE_OPENAI_ENDPOINT}/openai/v1/",
    api_key=os.environ["AZURE_OPENAI_API_KEY"],
    timeout=900.0,
)

# Send a request for Flex processing.
response = openai.responses.create(
    model="YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    input="Analyze these records and summarize the recurring themes.",
    service_tier="flex",
)

print(response.output_text)
print(f"Processed by service tier: {response.service_tier}")
<generated-analysis>
Processed by service tier: flex
Odpověď obsahuje vygenerovanou analýzu a úroveň služby, která požadavek zpracovává.
Referenční informace:Rozhraní API pro odpovědi
REST
Následující příklad odešle stejný požadavek přímo do rozhraní API pro odpovědi:
curl -X POST https://YOUR-RESOURCE-NAME.openai.azure.com/openai/v1/responses \
  -H "Content-Type: application/json" \
  -H "api-key: $AZURE_OPENAI_API_KEY" \
  -d '{
    "model": "YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    "input": "Analyze these records and summarize the recurring themes.",
    "service_tier": "flex"
  }'
{
    "service_tier": "flex",
    "status": "completed",
    "output": [<response-output>]
}
Pokud chcete ověřit, která úroveň požadavek zpracuje, zkontrolujte service_tier pole v úspěšné odpovědi.
Reference:Referenční příručka k REST API Responses
Volba možnosti zpracování
Flexibilní, standardní a prioritní zpracování jsou volbami na úrovni služeb pro online požadavky rozhraní API. Dávková a zřízená propustnost jsou samostatné možnosti nasazení a nákupu.
| Option | Jak ho vyberete | Latence a dostupnost | Model nákladů | Nejvhodnější pro |
|---|---|---|---|---|
| Flexibilní zpracování | Nastavte service_tier na úroveň požadavku flex. |
Proměnná latence. Požadavky můžou vracet HTTP 429, pokud není k dispozici kapacita Flex. | 50% slevy ve srovnání se standardními sazbami tokenů. Platí také slevy za tokeny uložené v mezipaměti. | Vyhodnocení, rozšiřování, offline analýza a práce na pozadí odolné proti zpoždění |
| Standardní zpracování | Nastavte úroveň service_tier požadavku na defaultnebo použijte úroveň Standard nakonfigurovanou pro nasazení. |
Online zpracování s nejlepším úsilím pro obecné úlohy | Standardní sazba pro platby za token | Vývojové, testovací a produkční úlohy s proměnlivým provozem |
| Přednostní zpracování | Nakonfigurujte prioritu pro nasazení nebo nastavte na úrovni požadavku service_tier na priority. |
Nižší a konzistentnější latence s definovaným cílem pro podporované modely. | Prioritní sazba za token. | Online aplikace citlivé na latenci bez závazku rezervované kapacity |
| Batch | Odešle asynchronní dávkovou úlohu do nasazení služby Batch. | Cílová doba dokončení výsledků je do 24 hodin. Není stanoven žádný cíl pro latenci v reálném čase. | Zvýhodněná dávková sazba. | Velké offline úlohy, které nevyžadují okamžitou odpověď. |
| Zřízená propustnost | Vytvořte nasazení se zřízenou kapacitou a kupte nebo si rezervujte jednotky zřízené propustnosti (PTU). | Rezervovaná kapacita s předvídatelnou propustností a latencí | Hodinové účtování PTU nebo rezervace Azure. | Vysokoobsádní úlohy kritické pro produkční prostředí. |
Pokud platí všechny následující podmínky, zvolte flex processing:
- Vaše úloha dokáže tolerovat delší a proměnlivé doby zpracování.
- Dáváte přednost nižším nákladům před předvídatelnou latencí.
- Vaše aplikace může opakovat přechodné selhání nebo směrovat neúspěšný požadavek na standardní zpracování.
- Podporuje se vybraný model a kontext požadavku.
Nepoužívejte funkci Flex Processing, pokud platí některá z následujících podmínek:
- Uživatel čeká na interaktivní odpověď.
- Požadavek se musí dokončit v rámci cíle přísné latence.
- Vaše aplikace nemůže tolerovat nebo opakovat přechodné odpovědi HTTP 429.
- Vyžadujete rezervovanou kapacitu zpracování nebo předvídatelnou propustnost.
Flexibilní zpracování má následující vlastnosti:
-
Výběr na úrovni požadavku: U každého požadavku, který má používat zpracování Flex, nastavte
service_tiernaflex. - Bez samostatného nasazení: Požadavky Standard a Flex odesílejte do stejného nasazení Global Standard a pro každý požadavek vyberte příslušnou úroveň.
- Podporovaná rozhraní API: Použijte rozhraní API pro odpovědi nebo rozhraní API pro dokončování chatu.
- Synchronní odpověď: Volání rozhraní API zůstává synchronní, i když dokončení úlohy může trvat déle. Zpracování Flex není totéž co Batch API.
- Dostupnost závislá na kapacitě: Požadavek může vrátit HTTP 429, pokud není k dispozici kapacita Flex.
-
Žádný automatický návrat na režim Standard: Pokud je zpracování Standard přijatelné, musí aplikace explicitně zopakovat požadavek s parametrem
service_tiernastaveným nadefault. - Sdílená kvóta: Požadavky Flex a Standard používají kvótu přiřazenou k nasazení globálního standardu.
- Stejná kvalita výstupu modelu: Flex používá stejný základní model jako Standard. Úroveň zpracování mění latenci, dostupnost a cenu, nikoli kvalitu modelu.
Note
Vstupní a výstupní tokeny Flex mají 50% slevu ve srovnání s odpovídajícími standardními sazbami tokenů. Oprávněné vstupní tokeny uložené v mezipaměti obdrží také příslušné slevy za tokeny v mezipaměti. Aktuální sazby najdete v části Ceny Azure OpenAI.
Kontrola podporovaných modelů
Flex processing má při spuštění omezenou dostupnost modelů.
gpt-5.6-sol je první podporovaný model. Následující tabulka uvádí podporované modely. Microsoft přidá další modely, jakmile bude k dispozici podpora.
| Model | Version | Typ nasazení | Dostupnost v regionu |
|---|---|---|---|
gpt-6.1-sol |
2026-09-29 |
Global Standard | Všechny Azure oblasti, ve kterých je k dispozici globální standard |
gpt-6-sol |
2026-09-22 |
Global Standard | Všechny Azure oblasti, ve kterých je k dispozici globální standard |
gpt-6-luna |
2026-09-22 |
Global Standard | Všechny Azure oblasti, ve kterých je k dispozici globální standard |
gpt-6-astra |
2026-09-03 |
Global Standard | Všechny Azure oblasti, ve kterých je k dispozici globální standard |
gpt-5.6-sol |
2026-07-09 |
Global Standard | Všechny Azure oblasti, ve kterých je k dispozici globální standard |
gpt-5.6-luna |
2026-07-09 |
Global Standard | Všechny Azure oblasti, ve kterých je k dispozici globální standard |
gpt-5.6-terra |
2026-07-09 |
Global Standard | Všechny Azure oblasti, ve kterých je k dispozici globální standard |
Před odesláním žádosti Flex zkontrolujte tuto tabulku. Nepředpokládáme, že model nebo nová verze modelu podporují flexibilní zpracování, protože podporuje standardní nebo prioritní zpracování. Nepodporovaný model vrátí http 400. Abyste předešli narušení provozu aplikace, implementujte na úrovni aplikace záložní mechanismus pro zpracování Standard, pokud jsou ceny a výkon úrovně Standard přijatelné.
Návrat ke standardnímu zpracování
Při nedostupnosti kapacity Flex nedojde k automatickému směrování požadavku na standard. Pokud je dokončení požadavku důležitější než zachování cenového modelu Flex, zkuste požadavek odeslat znovu s hodnotou default nastavenou u service_tier.
Následující příklad používá zásadu upřednostnění dokončení. Nejprve se pokusí o zpracování Flex a po jakékoli odpovědi s kódem HTTP 429 provede ještě jeden pokus se standardním zpracováním:
import os

from openai import OpenAI, RateLimitError

AZURE_OPENAI_ENDPOINT = "https://YOUR-RESOURCE-NAME.openai.azure.com"

# Create a client with a longer timeout for Flex requests.
openai = OpenAI(
    base_url=f"{AZURE_OPENAI_ENDPOINT}/openai/v1/",
    api_key=os.environ["AZURE_OPENAI_API_KEY"],
    timeout=900.0,
)

request = {
    "model": "YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    "input": "Analyze these records and summarize the recurring themes.",
}

# Try Flex processing, and fall back to Standard after an HTTP 429 response.
try:
    response = openai.responses.create(**request, service_tier="flex")
except RateLimitError:
    response = openai.responses.create(**request, service_tier="default")

print(response.output_text)
print(f"Processed by service tier: {response.service_tier}")
<generated-analysis>
Processed by service tier: <flex-or-default>
Přepnutí na Standard mění cenové a výkonnostní charakteristiky požadavku. Tento model použijte pouze v případě, že úloha může přijímat ceny standardu.
Odpověď HTTP 429 může znamenat nedostupnou kapacitu Flex nebo limit kvóty. Protože zpracování Flex a Standard sdílejí kvótu, může požadavek Standard také selhat, pokud byla příčinou původní odpovědi kvóta. Použijte limity opakování a ve své aplikaci zpracujte druhý RateLimitError. Když služba vrátí identifikátor chyby specifický pro Flex, použijte jej k omezení fallbacku pouze na odpovědi související s kapacitou.
Pro úlohy, u nichž je prioritou co nejnižší cena, zkuste před přechodem na záložní možnost znovu spustit zpracování Flex s exponenciální prodlevou. U pracovních zátěží, u nichž je prioritou doba dokončení, přejděte po první chybě kapacity Flex zpět na Standard.
Referenční informace:RateLimitError
Zpracování chyb Flex
Odlište trvalé chyby požadavků od přechodných chyb kapacity.
| Stav HTTP | Error | Cause | Doporučené zpracování |
|---|---|---|---|
| 400 | invalid_request_error |
Vybraný model, verze modelu, délka kontextu, rozhraní API nebo konfigurace požadavků nepodporuje flexibilní zpracování. | Neopakujte stejný požadavek beze změny. Vyberte podporovaný model nebo délku kontextu, případně akci zkuste znovu s parametrem service_tier nastaveným na default. |
| 408 | Časový limit požadavku vypršel | Požadavek se nedokončí v rámci nakonfigurovaného časového limitu klienta nebo služby. Požadavky Flex mohou trvat déle než standardní požadavky. | Použijte delší časový limit klienta. Zkuste to znovu s ohraničeným exponenciálním zpoždováním. Pokud je doba dokončení důležitější než cena Flex, zkuste to znovu se standardem. |
| 429 | Prostředek není k dispozici nebo je omezený četností | Kapacita Flex je dočasně nedostupná, nebo požadavek překročil příslušný limit počtu požadavků. Flexibilní kapacita je předběžná, takže dočasná nedostupnost je pravděpodobnější během špičky. | Pokud požadavek překročil limit rychlosti, zvyšte limit rychlosti nasazení global Standard přiřazením větší kvóty. Tuto kvótu sdílí Flex a Standard. Pokud předplatné nemá dostatečnou kvótu pro úlohu s velkou propustností, požádejte o navýšení kvóty. Pokud je kapacita Flex dočasně nedostupná, opakujte pokus s exponenciálním prodlužováním intervalů mezi pokusy a náhodnou odchylkou, přesuňte časově méně citlivé úlohy do období mimo špičku, například na noci během pracovního týdne nebo na víkendy, nebo opakujte pokus s hodnotou default nastavenou na service_tier. Respektujte Retry-After, pokud je přítomen. |
| 500, 502, 503 nebo 504 | Dočasná chyba služby | Dočasný problém se službou nebo bránou zabránil dokončení. | Zkuste to znovu s ohraničeným exponenciálním zpoždováním. Neposílejte neomezený počet opakování. |
| 401 nebo 403 | Chyba ověřování nebo autorizace | Přihlašovací údaje chybí, jsou neplatné, vypršela platnost nebo nemají přístup k prostředku. | Opravte přiřazení přihlašovacího údaje nebo role. Neopakujte pokus, dokud se konfigurace nezmění. |
| 404 | Nasazení nebylo nalezeno. | Název nasazení nebo koncový bod jsou nesprávné. | Ověřte, že se model shoduje s názvem nasazení a že základní URL směřuje na správný prostředek Azure OpenAI. |
Note
Požadavek Flex, který byl odmítnut, protože není k dispozici zpracovatelská kapacita, není účtován. Můžete si ale všimnout méně dostupné kapacity omezení rychlosti, protože požadavky Flex a Standard sdílejí kvótu přiřazenou k nasazení Global Standard.
Pro http 408, 429 a přechodné odpovědi 5xx použijte exponenciální zpoždování s náhodným zpožděním. Nastavte maximální počet opakování a maximální zpoždění, aby neúspěšný požadavek nezůstal v nevázané smyčce opakování.
- Zachovejte
Retry-After, pokud jej odpověď obsahuje. - V opačném případě počkejte po dobu exponenciálně se prodlužující prodlevy s náhodnou odchylkou.
- Opakujte operaci Flex pouze v případě, že zpoždění zůstává pro úlohu přijatelné.
- Pokud je limit opakování vyčerpán a aplikace umožňuje vyšší náklady tarifu Standard, přepněte na Standard.
- Pokud zpožděné zpracování Flex ani náhradní řešení Standard nesplňuje požadavky aplikace, vrátí explicitní selhání.
Nezkoušejte opakovaně stejný nepodporovaný požadavek Flex. Opakování proběhne úspěšně až po změně modelu, délky kontextu, konfigurace rozhraní API nebo úrovně služby.
Sledování využití a nákladů
Pomocí metrik Azure Monitor můžete porovnat provoz Flex a Standard ve stejném nasazení. Monitorujte objem požadavků, spotřebu tokenů, latenci, selhání a rychlost, s jakou požadavky Flex spadají do standardu ve vaší aplikaci.
Přihlaste se do Azure Portalu.
Přejděte na prostředek Azure OpenAI a vyberte Metriky.
Přidejte metriku Azure OpenAI Požadavky. Můžete také přidat latenci Azure OpenAI, využití Azure OpenAI a metriky chyb.
Přidejte filtr, kde ServiceTierRequest se rovná
flex.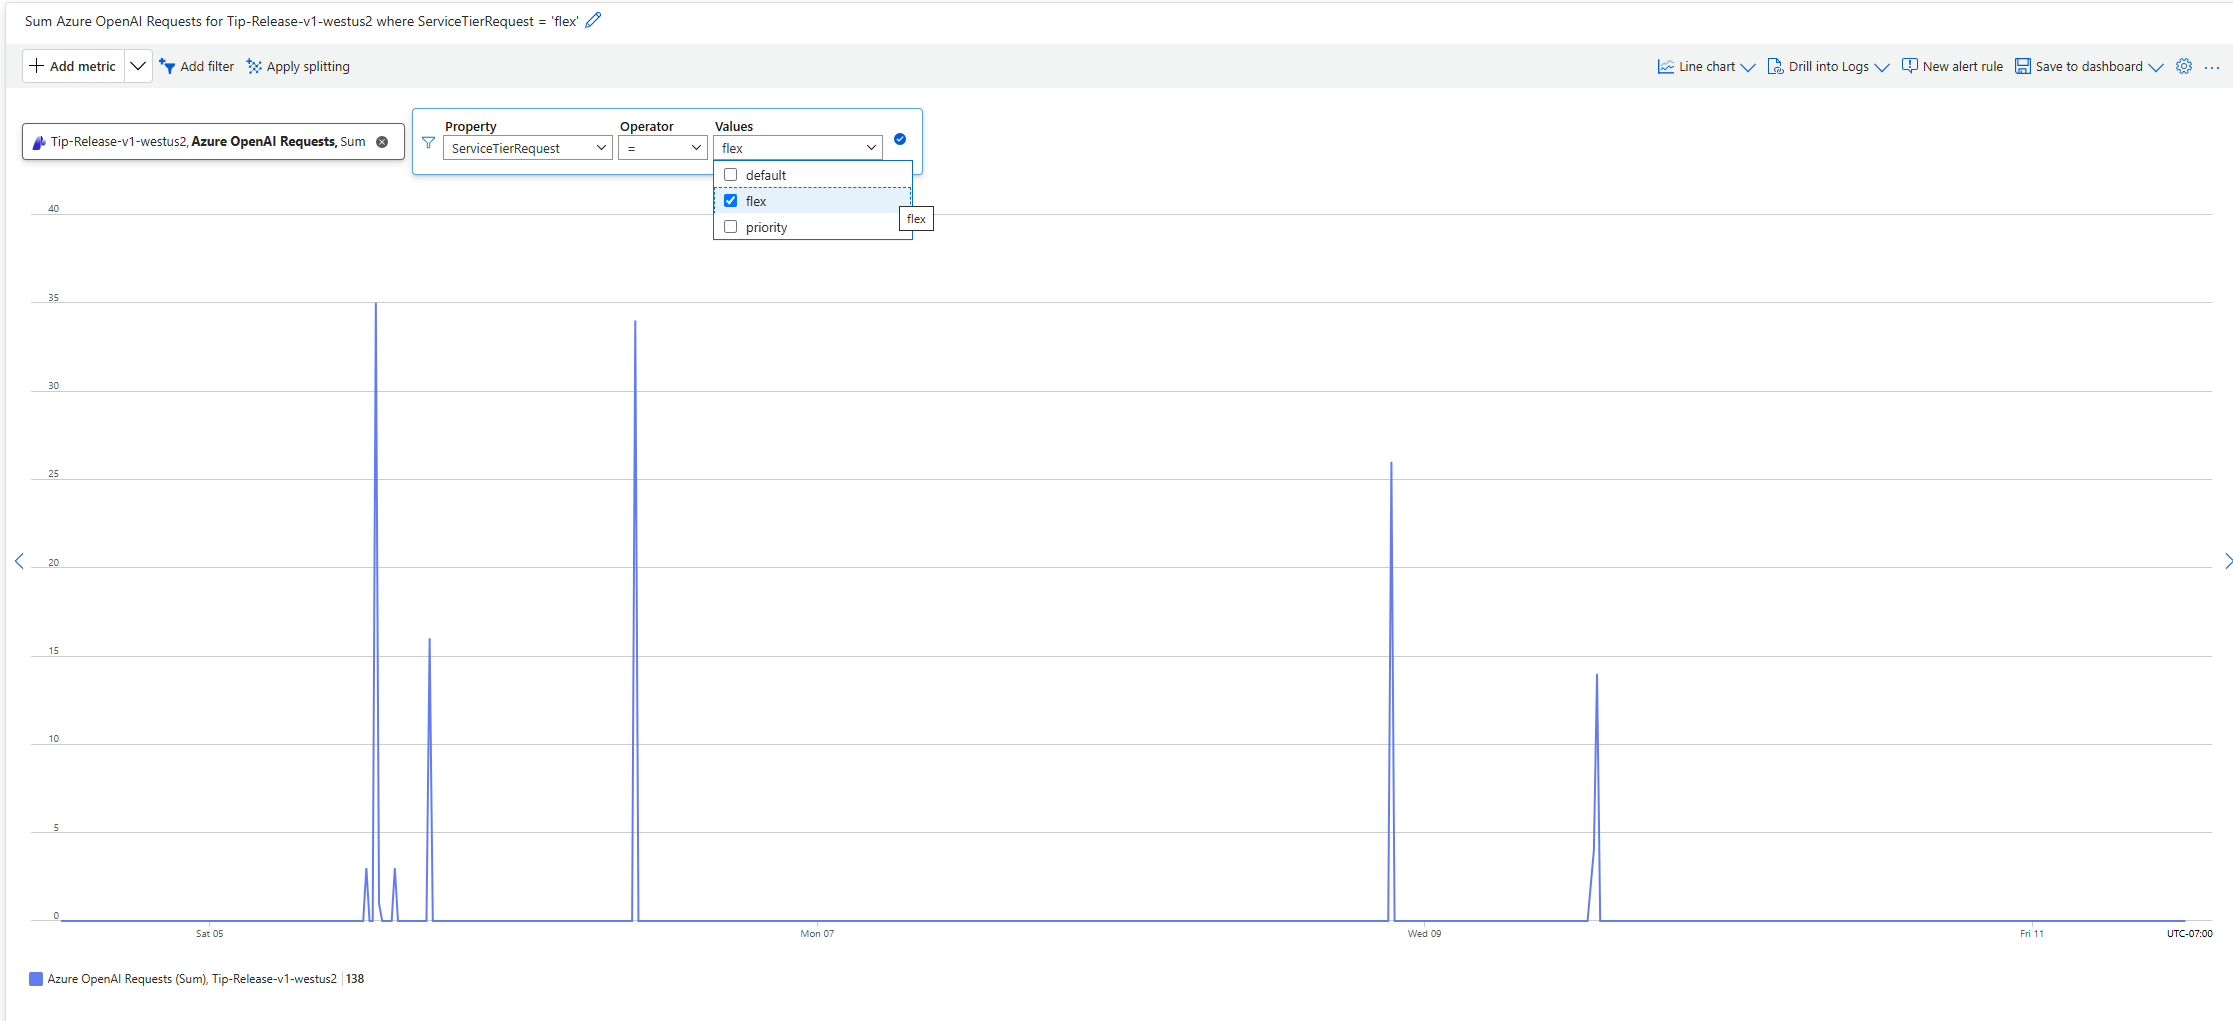
Vytvářejte upozornění na trvalé odpovědi HTTP 429, zvýšenou míru chyb a latenci, která překračuje rozpočet opakování vaší úlohy.
Sledujte následující signály pro každou úlohu:
| Signál | Proč na tom záleží |
|---|---|
| Počet požadavků Flex | Zobrazuje míru přijetí a směrovaný provoz ke zpracování s nižšími náklady. |
| Úspěšná míra požadavků Flex | Ukazuje, jak často kapacita Flex přijímá a vyplňuje požadavky. |
| Rychlost HTTP 429 | Zobrazuje období, kdy je omezená kapacita Flex nebo kvóta nasazení. |
| Standardní počet a míra náhradních položek | Zobrazuje přínos pro spolehlivost a dodatečné náklady plynoucí ze záložního mechanismu řízeného aplikací. |
| Vstupní, vstupní a výstupní tokeny uložené v mezipaměti | Podporuje alokaci nákladů a ověřuje dopad ukládání promptů do mezipaměti. |
| Kompletní latence | Pomáhá určit, jestli je úloha vhodná pro Flex. |
Počet kódů HTTP 400 invalid_request_error |
Identifikuje nepodporované modely, verze modelů, délky kontextu nebo konfigurace požadavků. |
Další informace o monitorování nasazení modelů najdete v tématu Monitorování Azure OpenAI.
Využití Flex se účtuje pomocí vyhrazených měřičů Flex, aby bylo možné je odlišit od standardního využití. Pomocí analýzy nákladů můžete zkontrolovat náklady na tokeny Flex podle prostředků a nasazení.
- Na portálu Azure otevřete analýzu nákladů a fakturace>.
- Filtrujte na předplatné, skupinu prostředků nebo prostředek Azure OpenAI, který obsahuje nasazení.
- Seskupením nebo filtrováním podle měřiče oddělte využití Flex od standardního využití.
- Přidejte filtr fakturačních značek , vyberte nasazení a zvolte název nasazení.
- Porovnejte úspory nákladů u varianty Flex s náklady při návratu k variantě Standard a s požadavky na dokončení pracovního zatížení.
Vstupní a výstupní tokeny Flex jsou účtovány za 50 % odpovídajících standardních sazeb. Ukládání promptů do mezipaměti může dále snížit náklady na způsobilé vstupní tokeny uložené v mezipaměti. Požadavek Flex, který byl odmítnut, protože není k dispozici zpracovatelská kapacita, není účtován.
Použití osvědčených postupů pro produkční prostředí
- Nastavte delší časový limit. Požadavky Flex mohou trvat déle než standardní požadavky. Začněte časovým limitem klienta, který je vhodný pro vaši úlohu, například 15 minut, a otestujte s reprezentativními výzvami.
- Použijte omezený počet opakovaných pokusů. Omezte počet opakování a celkovou uplynulou dobu.
- Přidejte jitter. Nastavte prodlevy mezi opakovanými pokusy náhodně, aby se zabránilo synchronizovaným špičkám opakovaných pokusů.
- Explicitně určete záložní variantu. Nastavte
service_tiernadefaultnamísto spoléhání na implicitní chování. - Sledujte zpracovávanou vrstvu. Poznamenejte si hodnotu odpovědi
service_tiers latencí, stavem, využitím tokenu a údaji o nákladech. - Oddělte interaktivní provoz a provoz na pozadí. Uživatelské požadavky ponechte na úrovni Standard, Priority nebo vyhrazené propustnosti, pokud není přijatelná proměnlivá latence služby Flex.
- Umožňuje řídit duplicitní práci. Ujistěte se, že aplikace po vypršení časového limitu na straně klienta několikrát neodesílala stejnou logickou úlohu.
- Cesty selhání testů. Před použitím flex processingu v produkčních pracovních postupech ověřte zpracování pro http 400, 408, 429 a přechodné odpovědi 5xx.
- Před upgrademi zkontrolujte podporu modelu. Náhradní model nebo verze modelu automaticky nedědí podporu Flex.
Přepsat úroveň služby pomocí hlavičky požadavku
Hlavičku x-ms-service-tier požadavku použijte, když brána, proxy nebo centralizovaná vrstva směrování potřebuje vybrat úroveň služby bez kontroly nebo úpravy textu požadavku. Hlavička může také omezit změny spojené s migrací u aplikací, které již volí úroveň služby OpenAI prostřednictvím hlavičky požadavku.
Hlavička přijímá následující hodnoty:
| Hodnota záhlaví | Požadovaná úroveň zpracování |
|---|---|
flex |
Flex |
priority |
Priorita |
default |
Standard |
auto |
Priorita |
Pokud je hlavička přítomná a platná, má přednost před service_tier hodnotou v textu požadavku.
| Vstup záhlaví | Vstup textu požadavku | Chování a výstup |
|---|---|---|
| Záhlaví vynecháno | Platná service_tier hodnota |
Tělo požadavku určuje vrstvu. Úspěšná odpověď uvádí zpracovanou vrstvu v service_tier. |
| Platná hodnota záhlaví | Libovolná hodnota nebo vynechána | Hlavička vybere požadovanou úroveň. Úspěšná odpověď uvádí zpracovanou vrstvu v service_tier. |
| Nepodporovaná hodnota hlavičky | Libovolná hodnota nebo vynechána | Požadavek vrátí http 400. Služba se nevrátí k hodnotě textu požadavku. |
Tento příklad požaduje zpracování Flex pomocí hlavičky. Hlavička přepíše hodnotu default v těle požadavku:
curl -X POST https://YOUR-RESOURCE-NAME.openai.azure.com/openai/v1/responses \
  -H "Content-Type: application/json" \
  -H "api-key: $AZURE_OPENAI_API_KEY" \
  -H "x-ms-service-tier: flex" \
  -d '{
    "model": "YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    "input": "Analyze these records and summarize the recurring themes.",
    "service_tier": "default"
  }'
{
    "service_tier": "flex",
    "status": "completed",
    "output": [<response-output>]
}
Přepisující hlavička neposkytuje automatické záložní řešení. Neplatná hodnota hlavičky nebo úroveň, kterou vybrané nasazení nepodporuje, vrátí hodnotu HTTP 400.