Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
Azure DocumentDB je plně spravovaná databázová služba NoSQL pro moderní vývoj aplikací s kompatibilitou MongoDB. Azure DocumentDB podporuje konfiguraci vysoké dostupnosti (HA) s synchronně replikovanými replikami aktivního pohotovostního režimu a redundancí zón. Poskytuje také volitelnou repliku jen pro čtení v jiné oblasti Azure a automatické zálohování s uchováváním do určitého bodu v čase, které chrání před náhodnou ztrátou dat.
Při používání Azure je spolehlivost sdílenou odpovědností. Microsoft nabízí celou řadu možností, které podporují odolnost a obnovení. Zodpovídáte za pochopení toho, jak tyto možnosti fungují ve všech službách, které používáte, a výběrem možností, které potřebujete ke splnění vašich obchodních cílů a cílů dostupnosti.
Tento článek popisuje, jak zajistit odolnost Azure DocumentDB vůči různým potenciálním výpadkům a problémům, včetně přechodných chyb, výpadků zón dostupnosti, výpadků oblastí a údržby služeb. Popisuje také způsob zálohování a poskytuje klíčové informace o HA a replikaci mezi oblastmi.
Doporučení pro produkční nasazení pro spolehlivost
Seznam doporučení ke zlepšení spolehlivosti clusteru najdete v tématu Osvědčené postupy pro vysokou dostupnost (HA) a replikaci mezi oblastmi v Azure DocumentDB.
Přehled architektury spolehlivosti
Tato část popisuje některé důležité aspekty fungování služby, které jsou z hlediska spolehlivosti nejrelevantní. Tato část představuje logickou architekturu, která obsahuje některé prostředky a funkce, které nasazujete a používáte. Popisuje také fyzickou architekturu, která poskytuje podrobnosti o tom, jak služba funguje v zákulisí.
Logická architektura
Primárním prostředkem, který nasadíte, je cluster Azure DocumentDB. Pro každý cluster zvolíte úroveň výpočetních prostředků a nakonfigurujete úložiště. Vybraná úroveň určuje možnosti dostupné pro funkce spolehlivosti, jako je vysoká dostupnost (HA), a ovlivňuje také způsob plánování kapacity pro scénáře odolnosti.
Aplikace se připojují ke clusteru pomocí připojovacích řetězců a koncových bodů. Azure DocumentDB poskytuje koncové body připojení pro operace čtení a zápisu a, pokud jsou nakonfigurovány, také koncové body pro clustery replik pro čtení. Tyto koncové body umožňují vaší aplikaci nadále používat stabilní způsoby připojení, zatímco služba na pozadí řídí přepnutí při selhání.
V každém clusteru jsou vaše data uspořádaná jako databáze, kolekce a dokumenty. Tento datový model kompatibilní s MongoDB je základem pro rozhodování o návrhu na úrovni úloh, jako je strategie horizontálního dělení, vzory čtení a zápisu a rozsah zálohování a obnovení.
Fyzická architektura
Azure DocumentDB provozuje váš cluster na střepech, které představují uzly (virtuální počítače), na nichž služba běží. Můžete nasadit jeden shard nebo škálovat na více shardů. Nasazení několika shardů zlepšuje kapacitu pro škálování, ale samo o sobě neposkytuje vysokou dostupnost.
Když povolíte vysokou dostupnost, Azure DocumentDB vytvoří odpovídající sadu pohotovostních fragmentů. Každý primární střep má záložní střep. Služba synchronně replikuje data mezi jednotlivými dvojicemi primární–záložní a v případě selhání primárního shardu povýší záložní shard. Další informace o vysoké dostupnosti najdete v tématu Vysoká dostupnost v Azure DocumentDB.
Azure DocumentDB používá Azure Storage pro odolnost střepů. Je-li vysoká dostupnost zakázána, každý shard používá místně redundantní úložiště (LRS). LRS udržuje tři kopie dat, ale není odolné vůči ztrátě zóny dostupnosti. Podrobnosti o odolnosti LRS najdete v části Souhrn možností redundance.
Další informace najdete v tématu Dostupnost a zotavení po havárii (DR) v Azure DocumentDB: Na pozadí.
Odolnost proti přechodným chybám
Přechodné chyby jsou krátká, přerušovaná selhání ve složkách. V distribuovaném prostředí, jako je cloud, se vyskytují často a jsou normální součástí provozu. Přechodné chyby se opravují po krátké době. Je důležité, aby vaše aplikace mohly zpracovávat přechodné chyby, obvykle opakováním ovlivněných požadavků.
Všechny aplikace hostované v cloudu by měly postupovat podle Azure pokynů pro zpracování přechodných chyb, když komunikují s libovolnými rozhraními API, databázemi a dalšími komponentami hostovanými v cloudu. Další informace viz Doporučení pro zpracování přechodných selhání.
Azure DocumentDB je kompatibilní s protokolem MongoDB, takže aplikace se obvykle připojují pomocí ovladačů MongoDB. Jste zodpovědní za konfiguraci nastavení opakovaných pokusů ovladače vaší aplikace tak, aby zvládalo přechodná selhání, zejména přerušení připojení a krátkodobá přerušení zápisu během převzetí služeb při selhání. Postupujte podle těchto pokynů:
Používejte ovladače MongoDB, které podporují automatické opakování při dočasných výpadcích připojení.
Nakonfigurujte opakované pokusy s exponenciálně se prodlužující prodlevou a omezte počet pokusů.
Pokud je to možné, navrhněte operace zápisu tak, aby byly idempotentní, aby jejich opakování bylo bezpečné. Obecné pokyny k implementaci idempotence najdete v modelu idempotentního příjemce.
Odolnost proti chybám zóny dostupnosti
Zóny dostupnosti jsou fyzicky oddělené skupiny datacenter v rámci oblasti Azure. Když jedna zóna selže, mohou služby přejít na jednu ze zbývajících zón.
Pokud chcete používat podporu zón dostupnosti v Azure DocumentDB, povolte vysokou dostupnost (HA). Když v oblasti, která podporuje zóny dostupnosti, povolíte vysokou dostupnost, váš cluster se stane zónově redundantním, protože Azure DocumentDB umístí záložní shardy do jiné zóny dostupnosti, než ve které se nacházejí jejich primární shardy. Záložní shardy nepřijímají požadavky klientů, dokud jejich primární shard neselže.
Pokud zakážete HA, Azure DocumentDB neumísťuje pohotovostní shardy do jiné zóny dostupnosti, takže selhání zóny dostupnosti může způsobit nedostupnost clusteru.
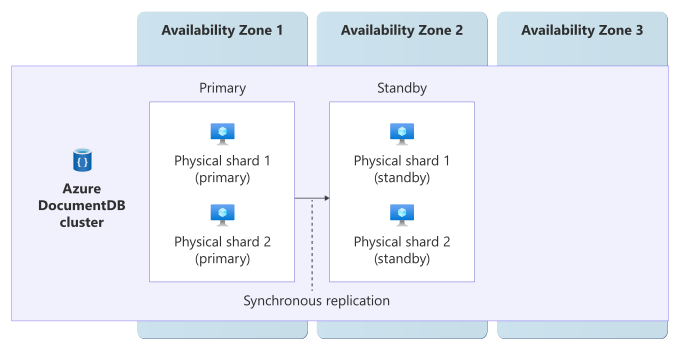
Diagram znázorňuje jeden Azure cluster DocumentDB napříč třemi zónami dostupnosti. Dva primární fyzické shardy jsou v zóně dostupnosti č. 1 a jejich odpovídající záložní fyzické shardy jsou v zóně dostupnosti č. 2. Šipky mezi každým primárním a pohotovostním střepem znázorňují synchronní replikaci. Zóna dostupnosti 3 v tomto příkladu neobsahuje žádné shardy.
Požadavky
Podpora oblastí: Pokud chcete používat zóny dostupnosti s Azure DocumentDB, zvolte oblast, která podporuje Azure DocumentDB i zóny dostupnosti. Zkontrolujte dostupné produkty podle oblastí a porovnejte je s oblastmi, které podporují zóny dostupnosti.
Vysoká dostupnost: Na clusteru musíte povolit HA. HA vyžaduje, aby cluster používal výpočetní úroveň M30 (nebo vyšší).
Úvahy
I když některá Azure rozhraní API DocumentDB zahrnují odkazy na režimy nasazení se stejnou zónou, Azure DocumentDB nepodporuje nasazení vysoké dostupnosti se stejnou zónou. Služba podporuje zónově redundantní nasazení vysoké dostupnosti.
Distribuce instancí napříč zónami
Microsoft pro cluster vybere dvě zóny dostupnosti. V zónově redundantních nasazeních vysoké dostupnosti Azure DocumentDB umístí všechny primární horizontální oddíly do jedné zóny a všechny pohotovostní horizontální oddíly v druhé zóně.
Cost
Pokud je povolena funkce vysoké dostupnosti, Azure DocumentDB vytvoří pro každý primární horizontální oddíl záložní horizontální oddíl, což zvyšuje náklady na výpočetní prostředky a úložiště vašeho clusteru. V regionech, které podporují zóny dostupnosti, HA také zajišťuje redundanci clusteru napříč zónami. V některých režimech nasazení je v Azure DocumentDB ve výchozím nastavení povolena vysoká dostupnost. U produkčních úloh nechte HA zapnuté. Pro vývojové a testovací úlohy můžete zakázat HA a snížit tak náklady. Podrobnosti o cenách najdete v článku Ceny Azure DocumentDB.
Konfigurujte podporu zón dostupnosti
Vytvořte nový zónově redundantní cluster Azure DocumentDB: Když vytvoříte cluster v oblasti, která podporuje zóny dostupnosti, povolte vysokou dostupnost (HA), aby byl cluster zónově redundantní. Podrobný postup najdete v tématu Rychlý start: Vytvoření clusteru Azure DocumentDB pomocí portálu Azure.
Povolte redundanci zón u existujícího clusteru Azure DocumentDB: HA můžete povolit u existujícího clusteru. Pokud je v clusteru Azure DocumentDB povolená nebo zakázaná vysoká dostupnost, neexistuje žádný výpadek databáze. Podrobné kroky najdete v tématu Škálování clusteru Azure DocumentDB.
Chování, když jsou všechny zóny v pořádku
Tato část popisuje, co očekávat při konfiguraci clusteru Azure DocumentDB pro vysokou dostupnost v oblasti, která podporuje zóny dostupnosti, a všechny zóny jsou funkční.
Operace napříč zónami: Primární horizontální oddíly obsluhují všechny požadavky klientů. Záložní shardy v jiné zóně dostupnosti nepřijímají požadavky klientů, pokud nedojde k selhání primárního uzlu.
Replikace dat mezi zónami: Replikace mezi primárními a záložními shardy je synchronní. Zápisy jsou trvale uloženy v primárním i záložním shardu dříve, než služba vrátí odpověď.
Chování při selhání zóny
Tato část popisuje, co očekávat při konfiguraci clusteru Azure DocumentDB pro vysokou dostupnost v oblasti, která podporuje zóny dostupnosti, a v jedné z zón dojde k výpadku.
Detekce a reakce: Microsoft za vás monitoruje stav fragmentů a zajišťuje detekci i přepnutí při selhání. Pokud se primární horizontální oddíl stane nedostupným kvůli výpadku zóny, Azure DocumentDB automaticky zvýší pohotovostní horizontální oddíl a pak znovu sestaví redundanci vytvořením nového pohotovostního horizontálního oddílu.
Oznámení: Microsoft vás při výpadku zóny automaticky neoznámí. Můžete ale použít Azure Service Health k pochopení celkového stavu služby, včetně jakýchkoli selhání zón, a můžete nastavit upozornění služby Service Health, která vás upozorní na problémy.
Aktivní požadavky: Právě zpracovávané požadavky, které nebyly potvrzeny před failoverem, mohou selhat a klient je musí zopakovat. Pokud vaše aplikace zpracovává přechodné chyby, obvykle se tyto pokusy automaticky dokončí.
Očekávaná ztráta dat: Azure DocumentDB replikuje data synchronně mezi primárním a záložním shardem, takže se nepředpokládá žádná ztráta dat.
Očekávaný výpadek: U operací čtení se neočekává žádný výpadek. Při operacích zápisu může během dokončování failoveru dojít ke krátkému přerušení. Pokud vaše aplikace opakuje přechodné chyby správně, obvykle se zobrazí jako krátké zpomalení.
Redistribuce: Connection string se nezmění, takže klienti budou dál používat stejný koncový bod. Služba automaticky přesměruje provoz na povýšené záložní shardy a znovu vytvoří nové záložní shardy.
Obnovení zóny
Když se zóna dostupnosti obnoví, Azure DocumentDB automaticky obnoví normální operace napříč všemi zónami používanými clusterem.
Testování poruch zón
Platforma Azure DocumentDB spravuje směrování provozu, převzetí služeb při selhání a obnovu zón pro zónově redundantní clustery. Nemusíte zahajovat ani ověřovat procesy při selhání zóny dostupnosti.
Odolnost proti selháním v celé oblasti
Každý cluster Azure DocumentDB nasadíte v jedné Azure oblasti. Pokud chcete podporovat odolnost proti selháním oblasti, nakonfigurujte replikaci mezi oblastmi přidáním jednoho clusteru repliky do jiné oblasti.
Replikace mezi oblastmi
Azure DocumentDB podporuje replikaci mezi oblastmi prostřednictvím clusteru replik. Cluster replik se ve vaší skupině prostředků zobrazí jako samostatný cluster. Tento cluster repliky můžete použít k zotavení po havárii a škálování čtení. Azure DocumentDB automaticky a asynchronně replikuje změny dat z primárního clusteru do clusteru repliky.
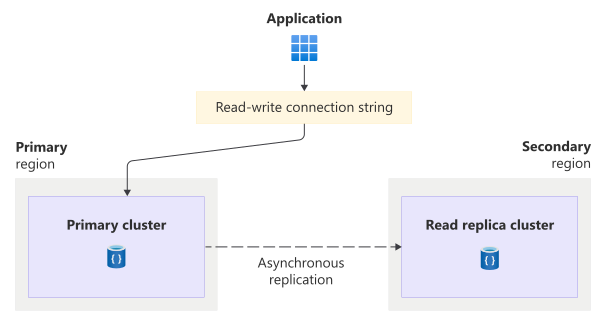
Diagram znázorňuje aplikaci, která se připojuje prostřednictvím připojovací řetězec pro čtení a zápis k primárnímu clusteru v primární oblasti. Čárkovaná šipka znázorňuje asynchronní replikaci z primárního clusteru do clusteru repliki určené pro čtení v sekundárním regionu.
Pokud vaše primární oblast selže, může být cluster repliky povýšen tak, aby se stal clusterem pro čtení i zápis. Globální připojovací řetězec pro čtení i zápis se automaticky aktualizuje tak, aby ukazoval na povýšený cluster.
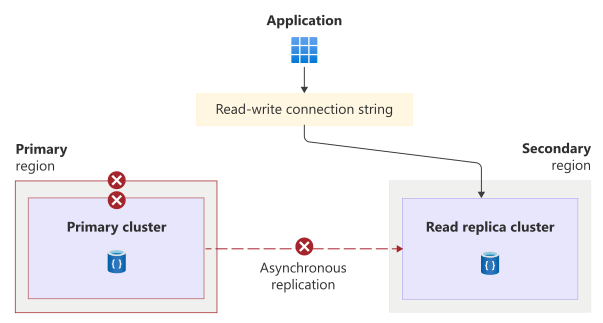
Diagram znázorňuje aplikaci, která se po povýšení připojuje prostřednictvím připojovacího řetězce pro čtení i zápis ke clusteru replik v sekundární oblasti. Symboly selhání označují primární cluster, primární oblast a bývalou cestu asynchronní replikace.
Tato část shrnuje aspekty spolehlivosti pro replikaci mezi oblastmi. Další informace najdete v tématu Správa replikace mezi oblastmi a stejnou oblastí v clusteru Azure DocumentDB a osvědčených postupech replikace napříč oblastmi a replikací stejné oblasti v Azure DocumentDB.
Přepnutí při selhání mezi oblastmi
Azure DocumentDB podporuje tři režimy povýšení:
Vynucené povýšení: Okamžitě povýší cluster replik tak, aby přijímal operace zápisu, a přesměruje příchozí provoz zápisu prostřednictvím globálního připojovacího řetězce pro čtení i zápis. Tento režim minimalizuje výpadky, ale může vést ke ztrátě dat, protože přijde o všechny neplicitované zápisy.
Automatické převzetí služeb při selhání spravované službou: Cluster můžete nakonfigurovat tak, aby využíval automatické převzetí služeb při selhání spravované službou. Microsoft monitoruje primární cluster a automaticky aktivuje vynucené povýšení, pokud primární cluster není v pořádku.
Elegantní povýšení: Zabraňuje ztrátě dat, ale vyžaduje určitý výpadek při replikaci nereplicitovaných zápisů. Řádné povýšení vyžaduje, aby oba clustery byly v pořádku, takže ho nemůžete provést během výpadku oblasti.
Další informace najdete v tématu Režimy převzetí služeb při selhání napříč oblastmi v Azure DocumentDB.
Požadavky
Podpora oblastí: Replikaci mezi oblastmi můžete použít ve všech Azure oblastech, které podporují Azure DocumentDB.
Úroveň výpočetních prostředků: Replikace mezi oblastmi vyžaduje úroveň výpočetních prostředků M30 nebo vyšší.
Úvahy
Přístup k síti: Clustery replik nezdědí nastavení sítě z primárního clusteru. Pravidla brány firewall nebo privátní koncové body nakonfigurujte samostatně také na clusteru repliky a před přepnutím při selhání otestujte připojení. Další informace najdete v tématu Průběžné zápisy, operace čtení replik clusteru a připojovací řetězce.
Podpora funkcí: Clustery replik nepodporují obnovení k určitému bodu v čase (PITR) ani vysokou dostupnost v oblasti.
Pokud je na primárním clusteru povolená HA, jste zodpovědní za její opětovné povolení na povýšeném clusteru.
Další informace najdete v tématu omezení a kvóty služby Azure DocumentDB.
Cost
Replikace mezi oblastmi zvyšuje náklady na výpočetní prostředky a prostředky úložiště clusteru repliky. Platí také poplatky za přenos dat mezi oblastmi. Podrobnosti o cenách najdete na stránkách ceny služby Azure DocumentDB a ceny za šířku pásma.
Nakonfigurujte podporu pro více oblastí
Vytvoření clusteru repliky: Pokud chcete povolit replikaci mezi oblastmi, vytvořte cluster repliky z primárního clusteru. Cluster repliky můžete vytvořit při vytváření primárního clusteru nebo potom. Postup najdete v tématu Správa replikace mezi oblastmi a stejnou oblastí v clusteru Azure DocumentDB.
Konfigurace automatického převzetí služeb při selhání: Pokud chcete Azure automaticky zvýšit úroveň repliky během výpadků primární oblasti, povolte převzetí služeb při selhání spravované službou. Další informace najdete v tématu Povolení převzetí služeb při selhání spravované službou.
Note
Microsoft obvykle spustí službou spravované převzetí služeb při selhání pouze v krajních situacích, jako je výpadek celé oblasti nebo velký počet dotčených zákazníků. Před aktivací převzetí služeb při selhání může dojít ke zpoždění. Pokud potřebujete rychle obnovit dostupnost, doporučujeme, abyste proces převzetí služeb při selhání řídili pomocí vynuceného povýšení iniciovaného zákazníkem.
Chování, když jsou všechny oblasti v pořádku
Tato část popisuje, co očekávat při konfiguraci clusteru Azure DocumentDB pro replikaci mezi oblastmi a všechny oblasti jsou funkční.
Operace mezi oblastmi: Primární cluster obsluhuje veškerý provoz čtení a zápisu. Cluster replik obsluhuje provoz určený pouze pro čtení, který můžete využít k horizontálnímu škálování úloh čtení nebo k zachování čtecího provozu lokálně v konkrétním regionu. Globální připojovací řetězec pro čtení i zápis vždy odkazuje na aktuální zapisovatelný cluster, takže klienti nemusí sledovat, která oblast je primární.
Replikace dat mezi oblastmi: Replikace mezi primárním clusterem a clusterem repliky je asynchronní. Zápisy jsou v primárním clusteru zapsány a potvrzeny klientovi předtím, než jsou replikovány do clusteru replik. Tento přístup zabraňuje tomu, aby síťová latence mezi oblastmi ovlivnila výkon zápisu. Vzhledem k tomu, že replikace je asynchronní, lze mezi primárním clusterem a replikačními clustery očekávat určité zpoždění replikace a během vynuceného převzetí služeb při selhání může dojít ke ztrátě nezreplikovaných zápisů.
Chování při selhání oblasti
Tato část popisuje, co očekávat, když nakonfigurujete cluster DocumentDB Azure pro replikaci mezi oblastmi a dojde k výpadku v oblasti primárního clusteru.
Detekce a reakce: Odpovědnost za detekci výpadku a reakci na něj závisí na typu mechanismu převzetí služeb při selhání, který váš cluster používá.
- Pokud je povoleno přepnutí při selhání spravované službou, Azure DocumentDB zjistí výpadek a automaticky provede nucené povýšení clusteru replik.
- Pokud není službou spravované převzetí služeb při selhání povoleno, jste zodpovědní za zjištění výpadku a spuštění nuceného povýšení.
Další informace najdete v tématu Režimy převzetí služeb při selhání napříč oblastmi v Azure DocumentDB.
Oznámení: Microsoft vás při výpadku oblasti automaticky neoznámí. Můžete ale použít Azure Service Health, abyste porozuměli celkovému stavu služby, včetně jakýchkoli selhání oblastí, a můžete nastavit upozornění služby Služba Health, která vás upozorní na problémy.
Aktivní požadavky: Všechny aktivní požadavky na neúspěšnou primární oblast můžou selhat. Po dokončení přepnutí při selhání by se aplikace měly znovu připojit a opakovat požadavky vůči clusteru povýšenému na primární.
Očekávaná ztráta dat: Převzetí služeb při selhání oblasti je neplánované, takže neplicitované zápisy můžou být ztraceny, protože replikace je asynchronní.
Očekávaná doba výpadku: Celková doba výpadku závisí na době detekce, režimu převzetí služeb po selhání a chování klienta při opětovném připojení.
U vynuceného povýšení iniciovaného zákazníkem zahrnuje celkový výpadek dobu potřebnou ke zjištění výpadku a zahájení procesů odezvy a také čas dokončení povýšení.
Po zahájení povýšení se obvykle dokončí během několika minut.
Přesměrování: Globální připojovací řetězec pro čtení i zápis po povýšení automaticky odkazuje na nově povýšený cluster. Aplikace, které používají připojovací řetězce specifické pro cluster, mohou vyžadovat aktualizace konfigurace, aby směrovali provoz do clusteru, který je v pořádku.
Obnovení oblasti
Azure DocumentDB se po obnovení automaticky nepřepne zpět do původní oblasti. Chcete-li vrátit operace zápisu do původní oblasti, proveďte po opětovném nastavení preferované topologie další povýšení. Použijte řízené povýšení, abyste zabránili ztrátě dat během failbacku. Hladký přechod vyžaduje krátký výpadek a můžete jej provést v době, kterou si zvolíte, například během okna údržby. Další informace najdete v tématu Aktivace řádné povýšení.
Testování selhání regionů
Pravidelně testujte proces zotavení po havárii zvýšením úrovně clusteru repliky v řízeném prostředí.
Pomocí vynucené propagace simulujte chování při výpadku. Výsledkem tohoto testu může být ztráta dat, proto zvažte spuštění tohoto testu v neprodukčním prostředí. Další informace najdete v tématu Aktivace vynuceného povýšení.
Pokud chcete zabránit ztrátě dat, použijte řádné povýšení pro plánované přechodové postupy. Další informace najdete v tématu Aktivace řádné povýšení.
Zálohování a obnovení
Replikace a podpora zón dostupnosti pomáhají udržovat cluster dostupný během selhání infrastruktury. Azure DocumentDB automaticky provádí průběžné zálohování, které řeší jiné riziko povolením obnovení k určitému bodu v čase (PITR) po náhodném odstranění nebo úpravě dat. Azure DocumentDB provádí zálohování, aniž by to mělo vliv na výkon nebo dostupnost databázových operací. Další informace o tom, jak replikace a zálohování řeší různá rizika, najdete v tématu Redundance, replikace a zálohování.
Azure DocumentDB ukládá zálohy odděleně od zdrojových dat. V oblastech, které podporují zóny dostupnosti, ukládá služba snímky zálohování do tří zón dostupnosti. Azure DocumentDB tyto zálohy spravuje a nemůžete je exportovat. Služba uchovává zálohy po dobu 35 dnů pro aktivní clustery, 7 dní pro aktivní clustery s možností nárazového škálování (M10, M20, M25) a 7 dnů pro odstraněné clustery.
Zálohu můžete obnovit do nového clusteru. Až to uděláte, musíte provést sadu úloh po obnovení.
Další informace naleznete v tématu Obnovení clusteru v Azure DocumentDB.
Odolnost vůči údržbě služeb
Microsoft pravidelně používá aktualizace služeb a provádí další údržbu. Platforma Azure tyto aktivity zpracovává automaticky a zajišťuje, aby byla údržba pro vás bezproblémová a transparentní. Během událostí údržby není očekáván výpadek, pokud jste nebyli informováni prostřednictvím plánované údržby služby Azure Service Health.
Události plánované údržby můžou stále způsobit krátká přechodná selhání klientských operací. Aplikace by měla tyto události zpracovat pomocí pokynů pro opakování v části Odolnost proti přechodným chybám.
Smlouva o úrovni služeb
Smlouva o úrovni služeb (SLA) pro služby Azure popisuje očekávanou dostupnost každé služby a podmínky, které musí vaše řešení splnit, aby bylo dosaženo očekávané dostupnosti. Další informace najdete v článku SLA pro online služby.
Pro Azure DocumentDB platí smlouvy SLA o dostupnosti pouze v případě, že má váš cluster povolenou vysokou dostupnost (HA). Smlouvy SLA s jinou dostupností platí pro následující konfigurace:
Clustery s podporou vysoké dostupnosti, které využívají více Azure oblastí pomocí replikace mezi oblastmi.
Clustery s podporou vysoké dostupnosti v jednom regionu