Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
Microsoft Fabric prostředí poskytují flexibilní konfiguraci pro spouštění úloh Sparku. Knihovny poskytují opakovaně použitelný kód pro poznámkové bloky a definice úloh Sparku. Kromě integrovaných knihoven, které jsou součástí každého modulu runtime Sparku, můžete do Fabric prostředí nainstalovat veřejné a vlastní knihovny.
Poznámka:
Přejděte do pracovního prostoru, kde se nachází vaše prostředí, vyberte možnosti správy prostředí a knihovny v levém navigačním podokně. Pokud prostředí nemáte vytvořené, přečtěte si téma Vytvoření, konfigurace a použití prostředí ve Fabricu.
Integrované knihovny
Ve Fabric je každá verze běhového prostředí předem nahrána s kurátorovanou sadou předdefinovaných knihoven, které jsou optimalizované pro výkon, kompatibilitu a zabezpečení napříč Pythonem, R, Javou a Scalou. Stránka Vestavěné knihovny v prostředí umožňuje procházet a prohledávat tyto předinstalované knihovny na základě vybraného běhového prostředí.
Tyto knihovny se ve výchozím nastavení instalují v každém prostředí a není možné je změnit. Budou dostupné, pokud v tomto prostředí spustíte poznámkový blok nebo definici úlohy Sparku.
Pokud chcete zobrazit seznam předinstalovaných balíčků a jejich verzí pro každý modul runtime, přečtěte si téma Apache Spark runtime v Fabric.
Poznámka:
Přístupy pro jednotlivé poznámkové bloky, jako je složka Zdroje poznámkového bloku a vložené příkazy pro instalaci (například %pip install nebo %conda install v buňce kódu), jsou ruční, obor relace nebo obor poznámkového bloku, a nejsou ovlivněné publikováním prostředí. Můžete je použít pro rychlé jednorázové přidávání knihoven během interaktivního vývoje.
Důležité
Fabric podporuje různé způsoby správy balíčků. Další možnosti a osvědčené postupy najdete v tématu Správa knihoven Apache Spark ve Fabric. Pokud váš pracovní prostor používá síťové funkce, jako je ochrana odchozího přístupu pracovního prostoru nebo spravované virtuální sítě, je přístup k veřejným úložištím, jako je PyPI, zablokovaný. Pokyny najdete v tématu Spravování knihoven s omezeným přístupem k síti v Fabric. Pokud předdefinované verze knihovny nevyhovují vašim potřebám, můžete je přepsat zadáním požadované verze v oddílu externího úložiště nebo nahráním vlastních balíčků.
Externí úložiště
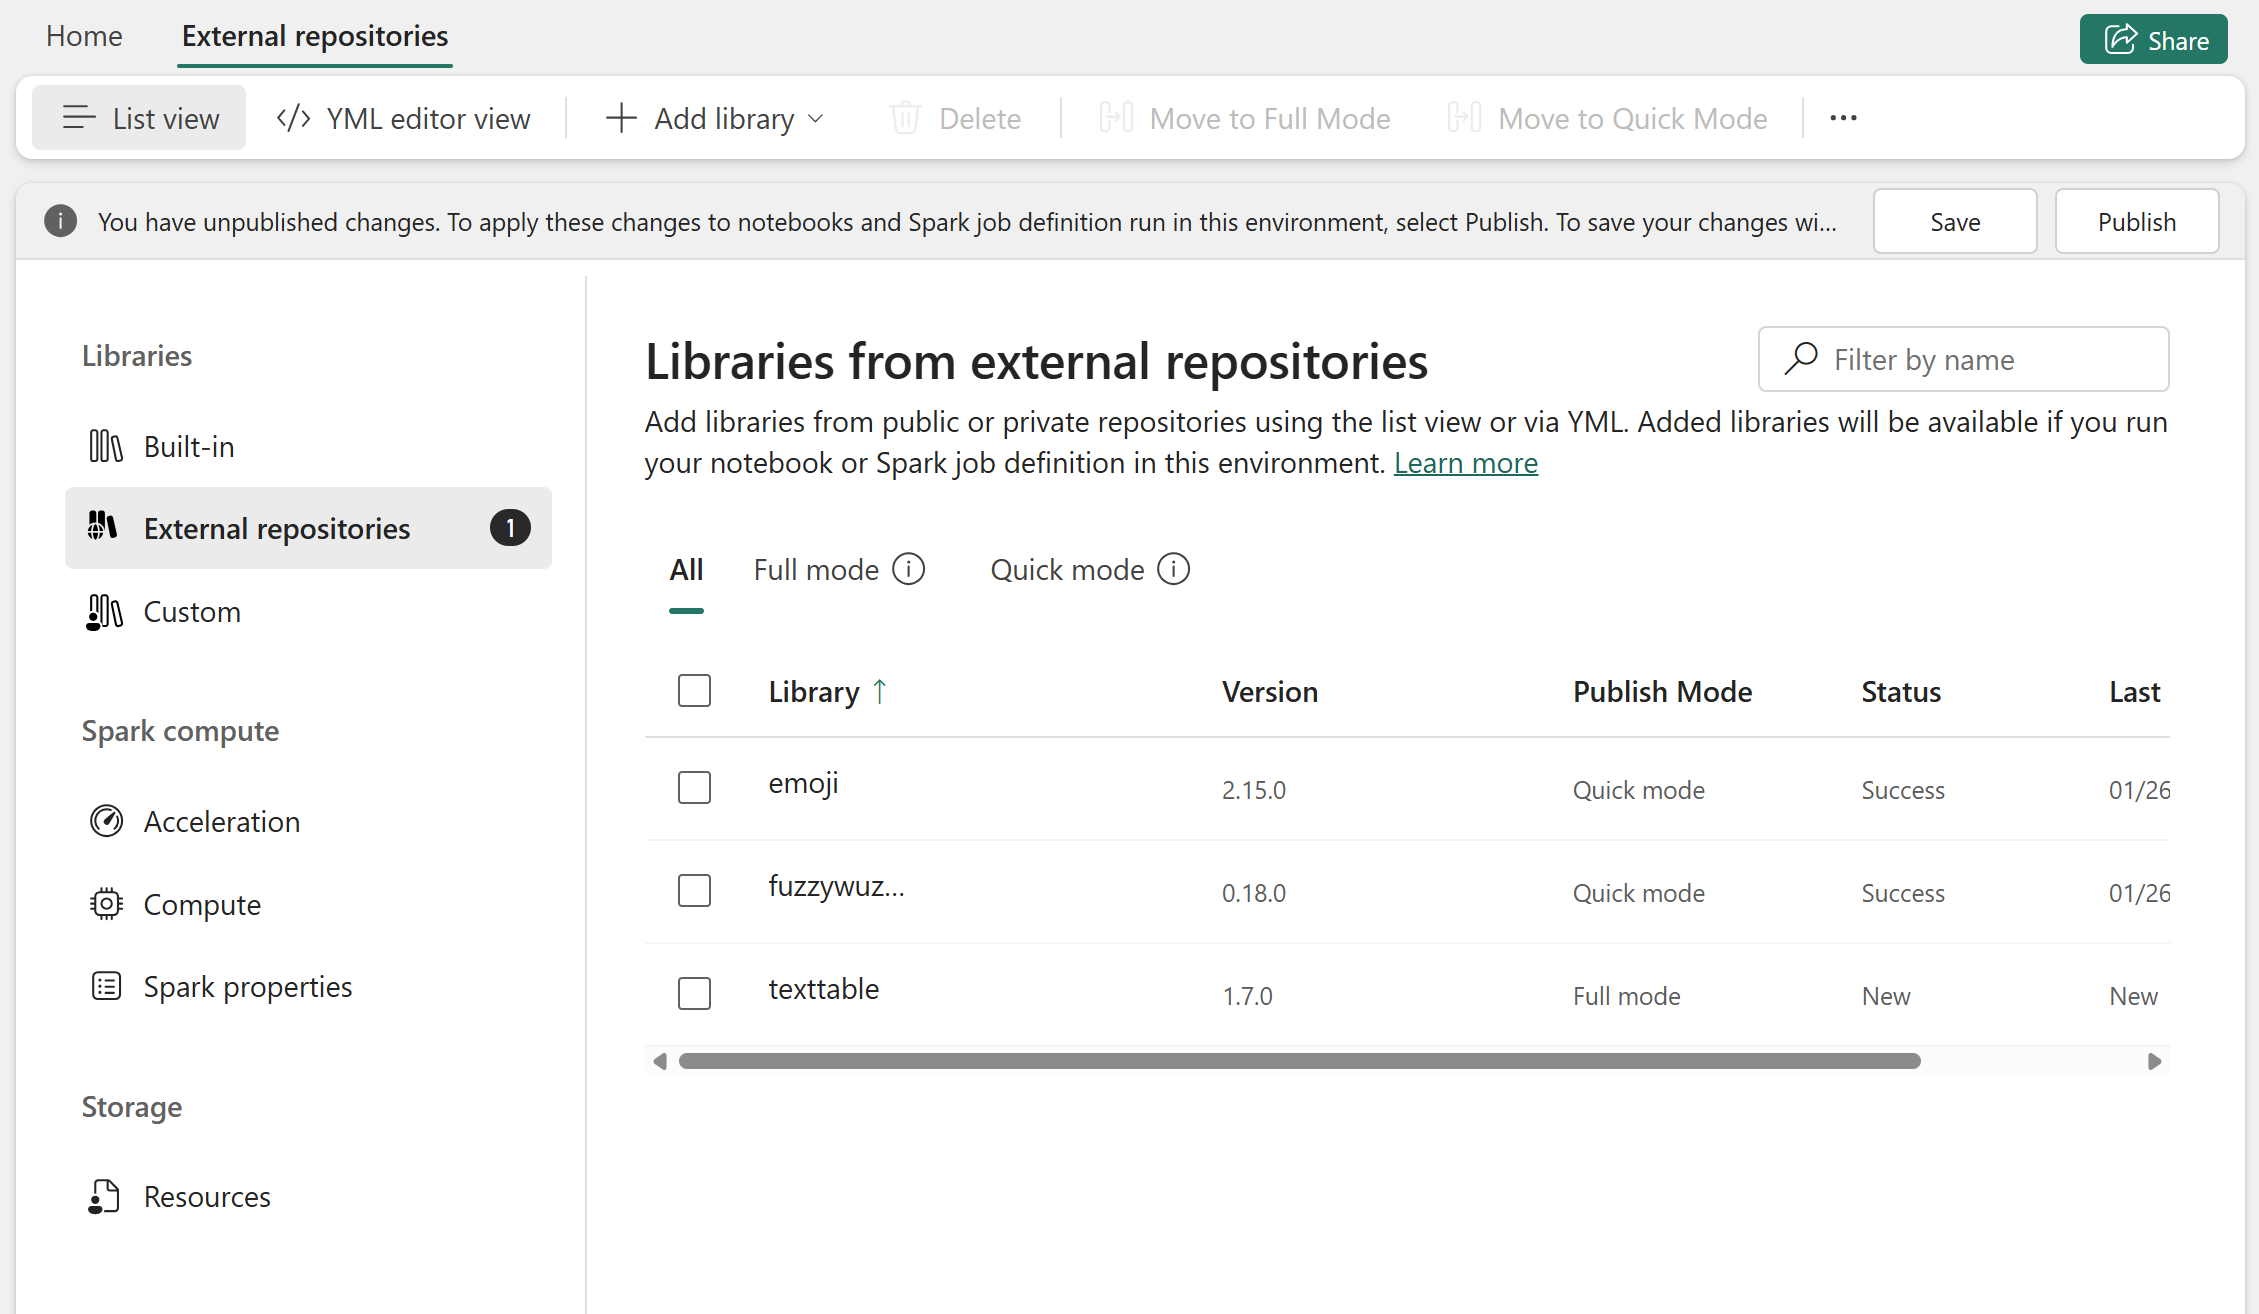
Můžete přidávat knihovny z veřejných úložišť, jako jsou PyPI, Conda a Maven nebo z privátních úložišť. Možnosti režimu zdroje a publikování se liší v závislosti na typu úložiště. Když přidáte knihovnu, vyberete režim publikování (úplný nebo rychlý). Podrobnosti o tom, jak jednotlivé režimy fungují, najdete v tématu Výběr režimu publikování pro knihovny.
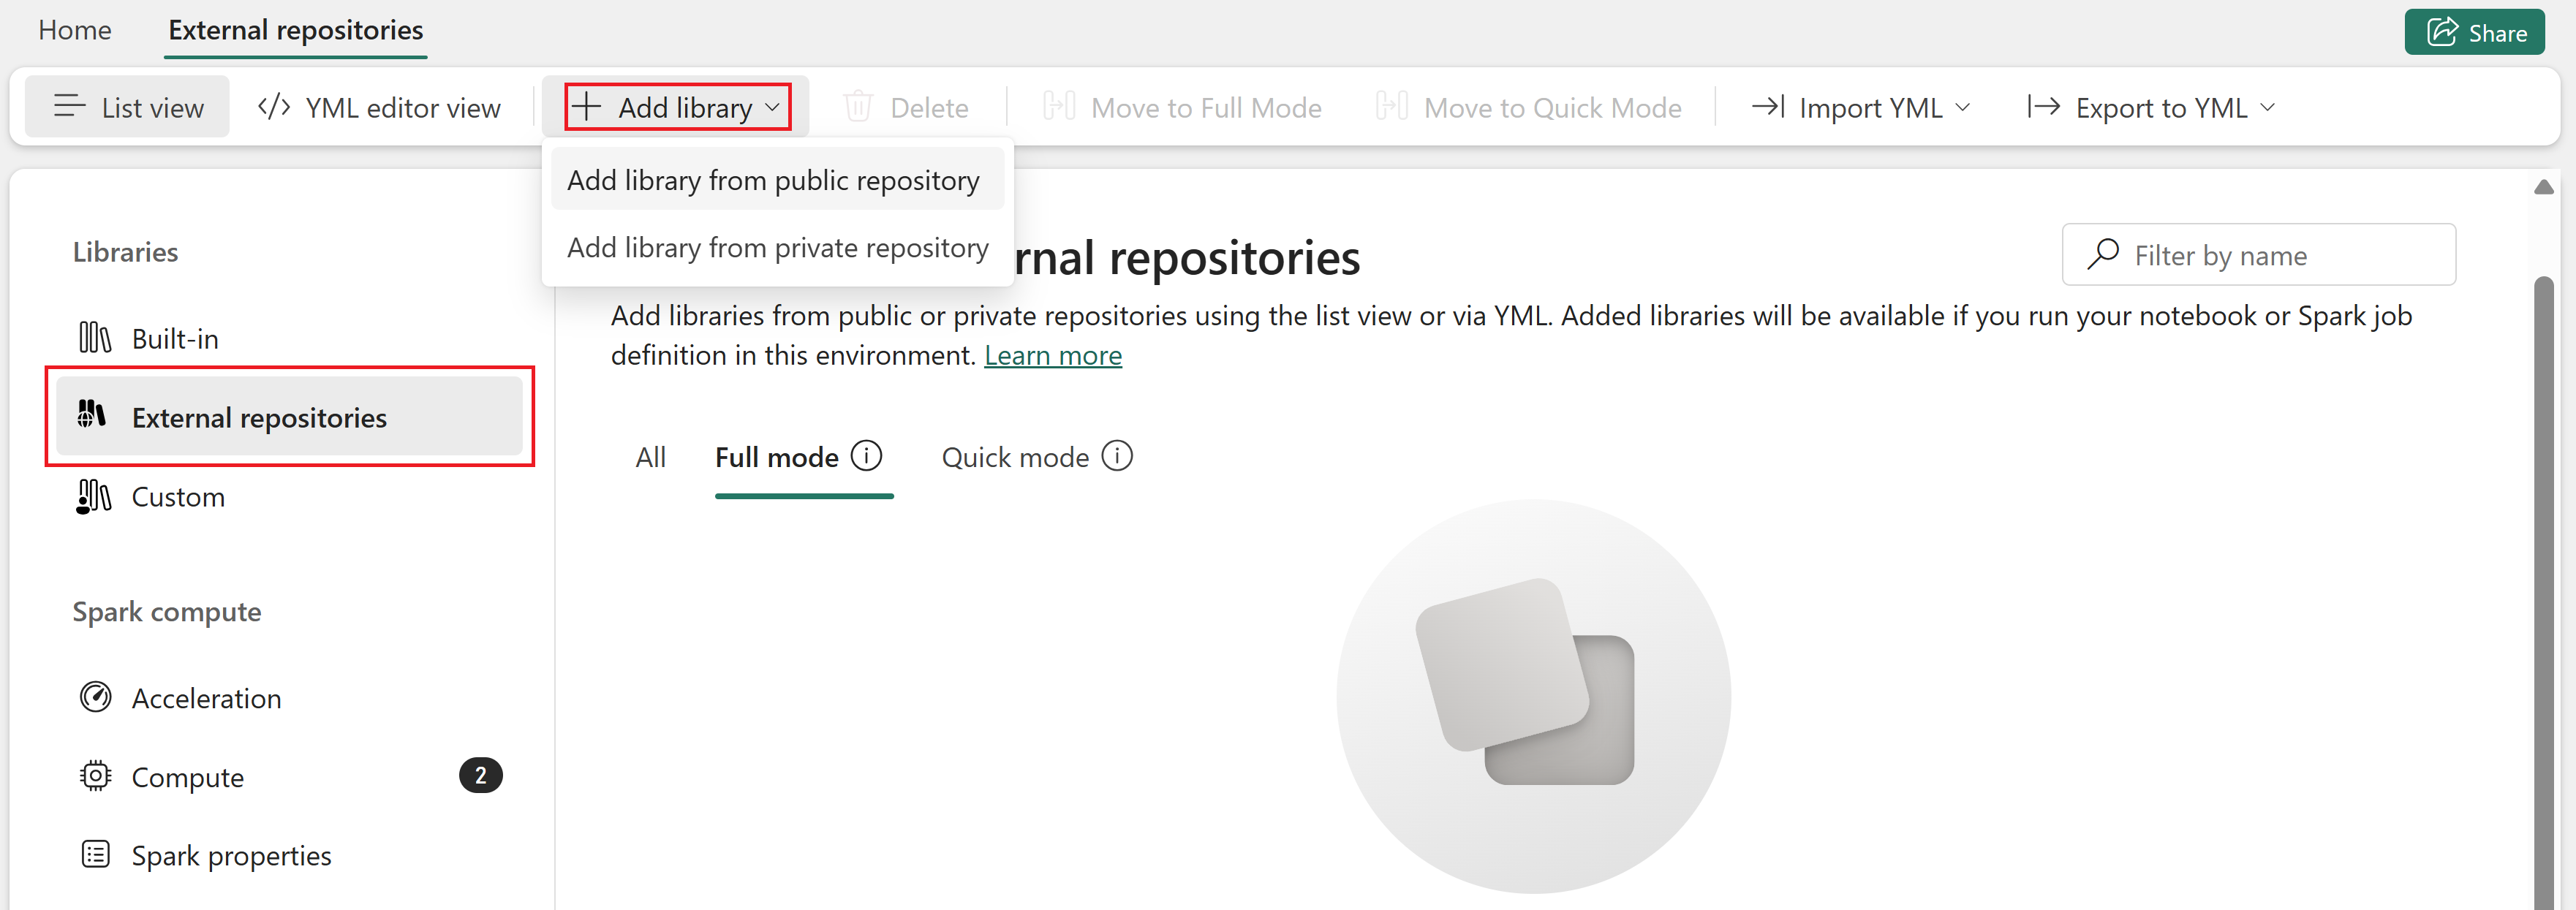
Přidání knihovny z veřejného úložiště Python
Veřejná úložiště umožňují instalovat balíčky z PyPI nebo Conda.
Na kartě Externí úložiště vyberte Přidat knihovnu.
Vyberte Přidat knihovnu z veřejného úložiště.
Vyberte zdroj (PyPI nebo Conda).
Do vyhledávacího pole zadejte název knihovny. Při psaní navrhuje vyhledávací pole oblíbené knihovny, ale seznam je omezený. Pokud knihovnu nevidíte, zadejte jeho úplný název.
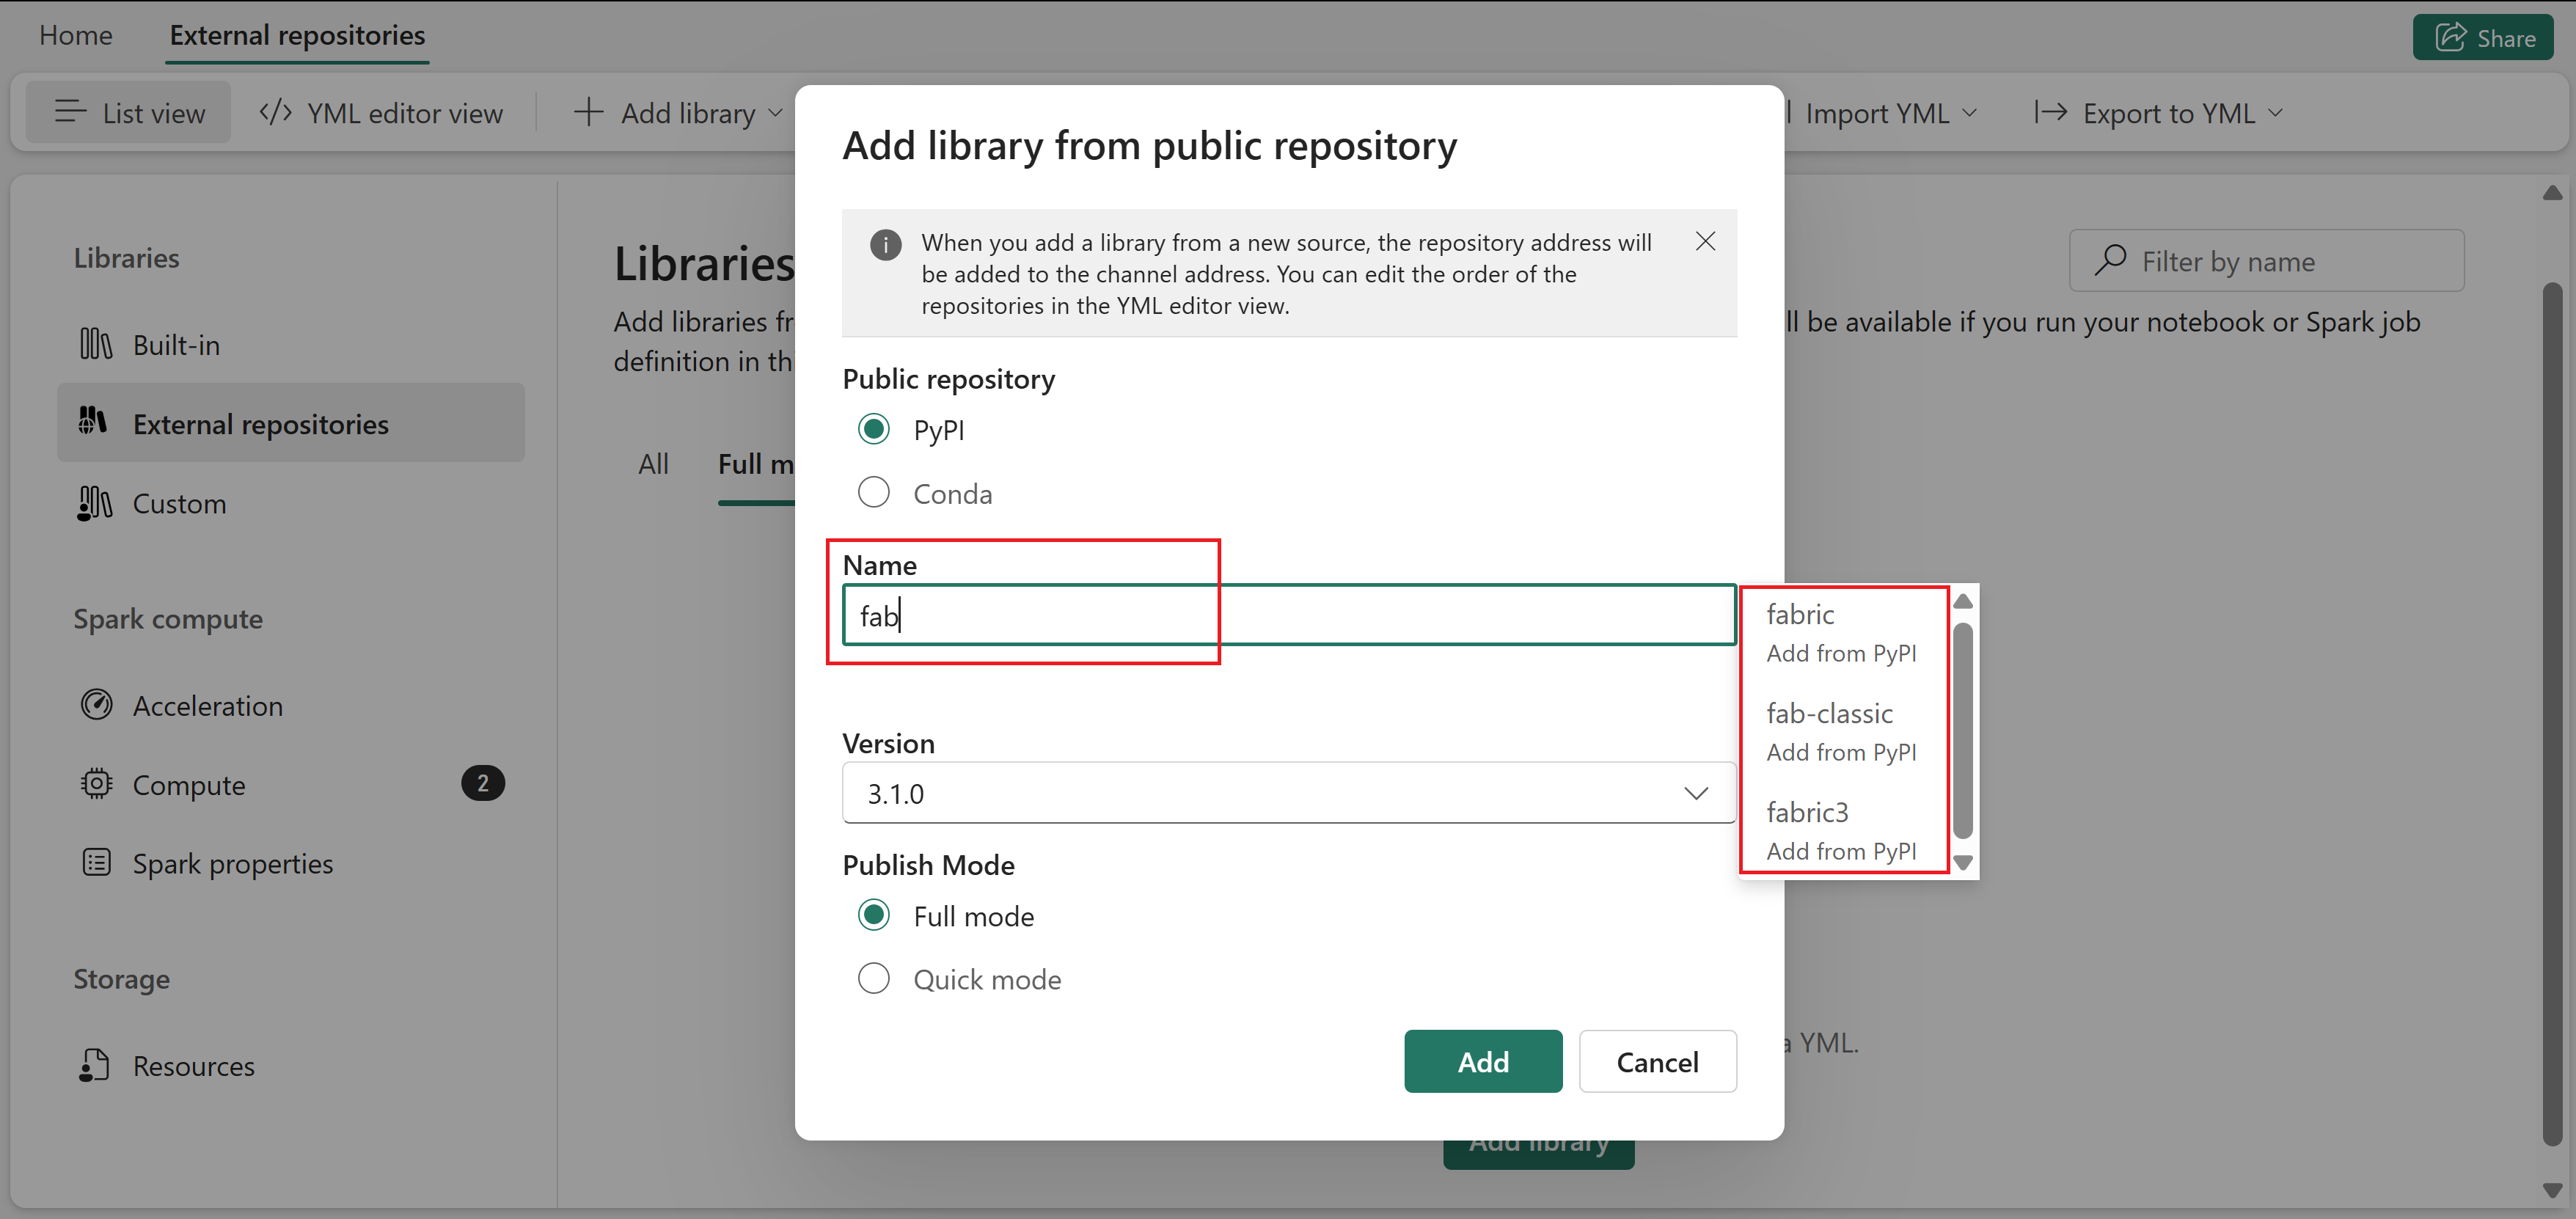
Pokud se název knihovny najde, zobrazí se dostupné verze.
Vyberte verzi a pak prostředí uložte a publikujte.
Přidání knihovny z Mavenu
Fabric podporuje instalaci knihoven přímo z úložišť Maven. Uděláte to tak, že vytvoříte soubor POM se seznamem závislostí Mavenu, které chcete nainstalovat, a nahrajte ho do prostředí.
Na kartě Externí úložiště vyberte Importovat pom.xml.
V místním adresáři vyberte soubor pom.xml.
Poznámka:
- Import pom.xml se podporuje jenom ve Sparku 4.0 a novějším.
- Import pom.xml se podporuje jenom v režimu full. V tomto režimu Fabric provádí řešení závislostí a detekci konfliktů pro balíčky Maven. Pokud je nějaká knihovna nekompatibilní s modulem runtime, zobrazí se po publikování chyba.
- Import pom.xml není v pracovních prostorech s povolenou ochranou odchozího přístupu podporován. V těchto pracovních prostorech stáhněte požadované knihovny z Mavenu a místo toho je nahrajte jako vlastní knihovny.
Přidání knihovny z privátního úložiště
Privátní úložiště umožňují instalovat balíčky pomocí pip nebo conda.
Na kartě Externí úložiště vyberte Přidat knihovnu.
Vyberte Přidat knihovnu z privátního úložiště.
Vyberte zdroj (pip nebo conda).
Zadejte název a verzi knihovny. Nezapomeňte přesně zadat název a verzi knihovny, protože hledání knihoven v privátních úložištích, jak píšete, není podporované. Nesprávné informace o balíčku způsobí selhání publikování.
Přidání knihoven z úložiště artefaktů v Azure
Kanály artefaktů Azure můžou být určeny pro projekt (soukromý) nebo pro organizaci (veřejná). Fabric podporuje oba rozsahy. Bez ohledu na viditelnost informačního kanálu v Azure DevOps se Fabric vždy připojuje prostřednictvím ověřeného připojení data Factory, takže musíte nastavit připojení i pro veřejné informační kanály.
Poznámka:
Instalace knihoven z úložiště artefaktů Azure je podporována ve Sparku 3.5. Není podporováno v pracovních prostorech s povolenou ochranou Private Link nebo s povolenou ochranou odchozího přístupu.
Nastavte připojení k Azure Artifact Feed
Prostředí neukládá přihlašovací údaje přímo. Místo toho vytvoříte připojení prostřednictvím konektoru Data Factory a odkazujete na něj pomocí ID připojení v souboru YML. Přečtěte si další informace o informačním kanálu artefaktů Azure.
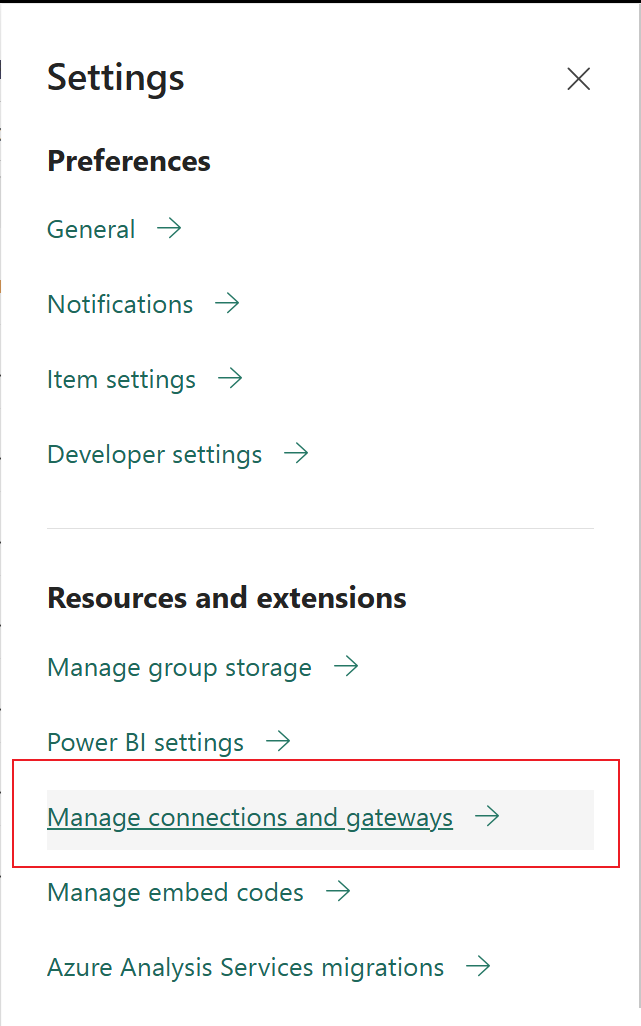
V pravém horním rohu portálu Fabric vyberte ikonu ozubeného kola Nastavení a pak vyberte Spravovat připojení a brány.
Vytvořte nové připojení. Vyberte + Nový a pak jako typ vyberte Cloud a jako typ připojení zvolte Azure Kanál artefaktů (Preview).
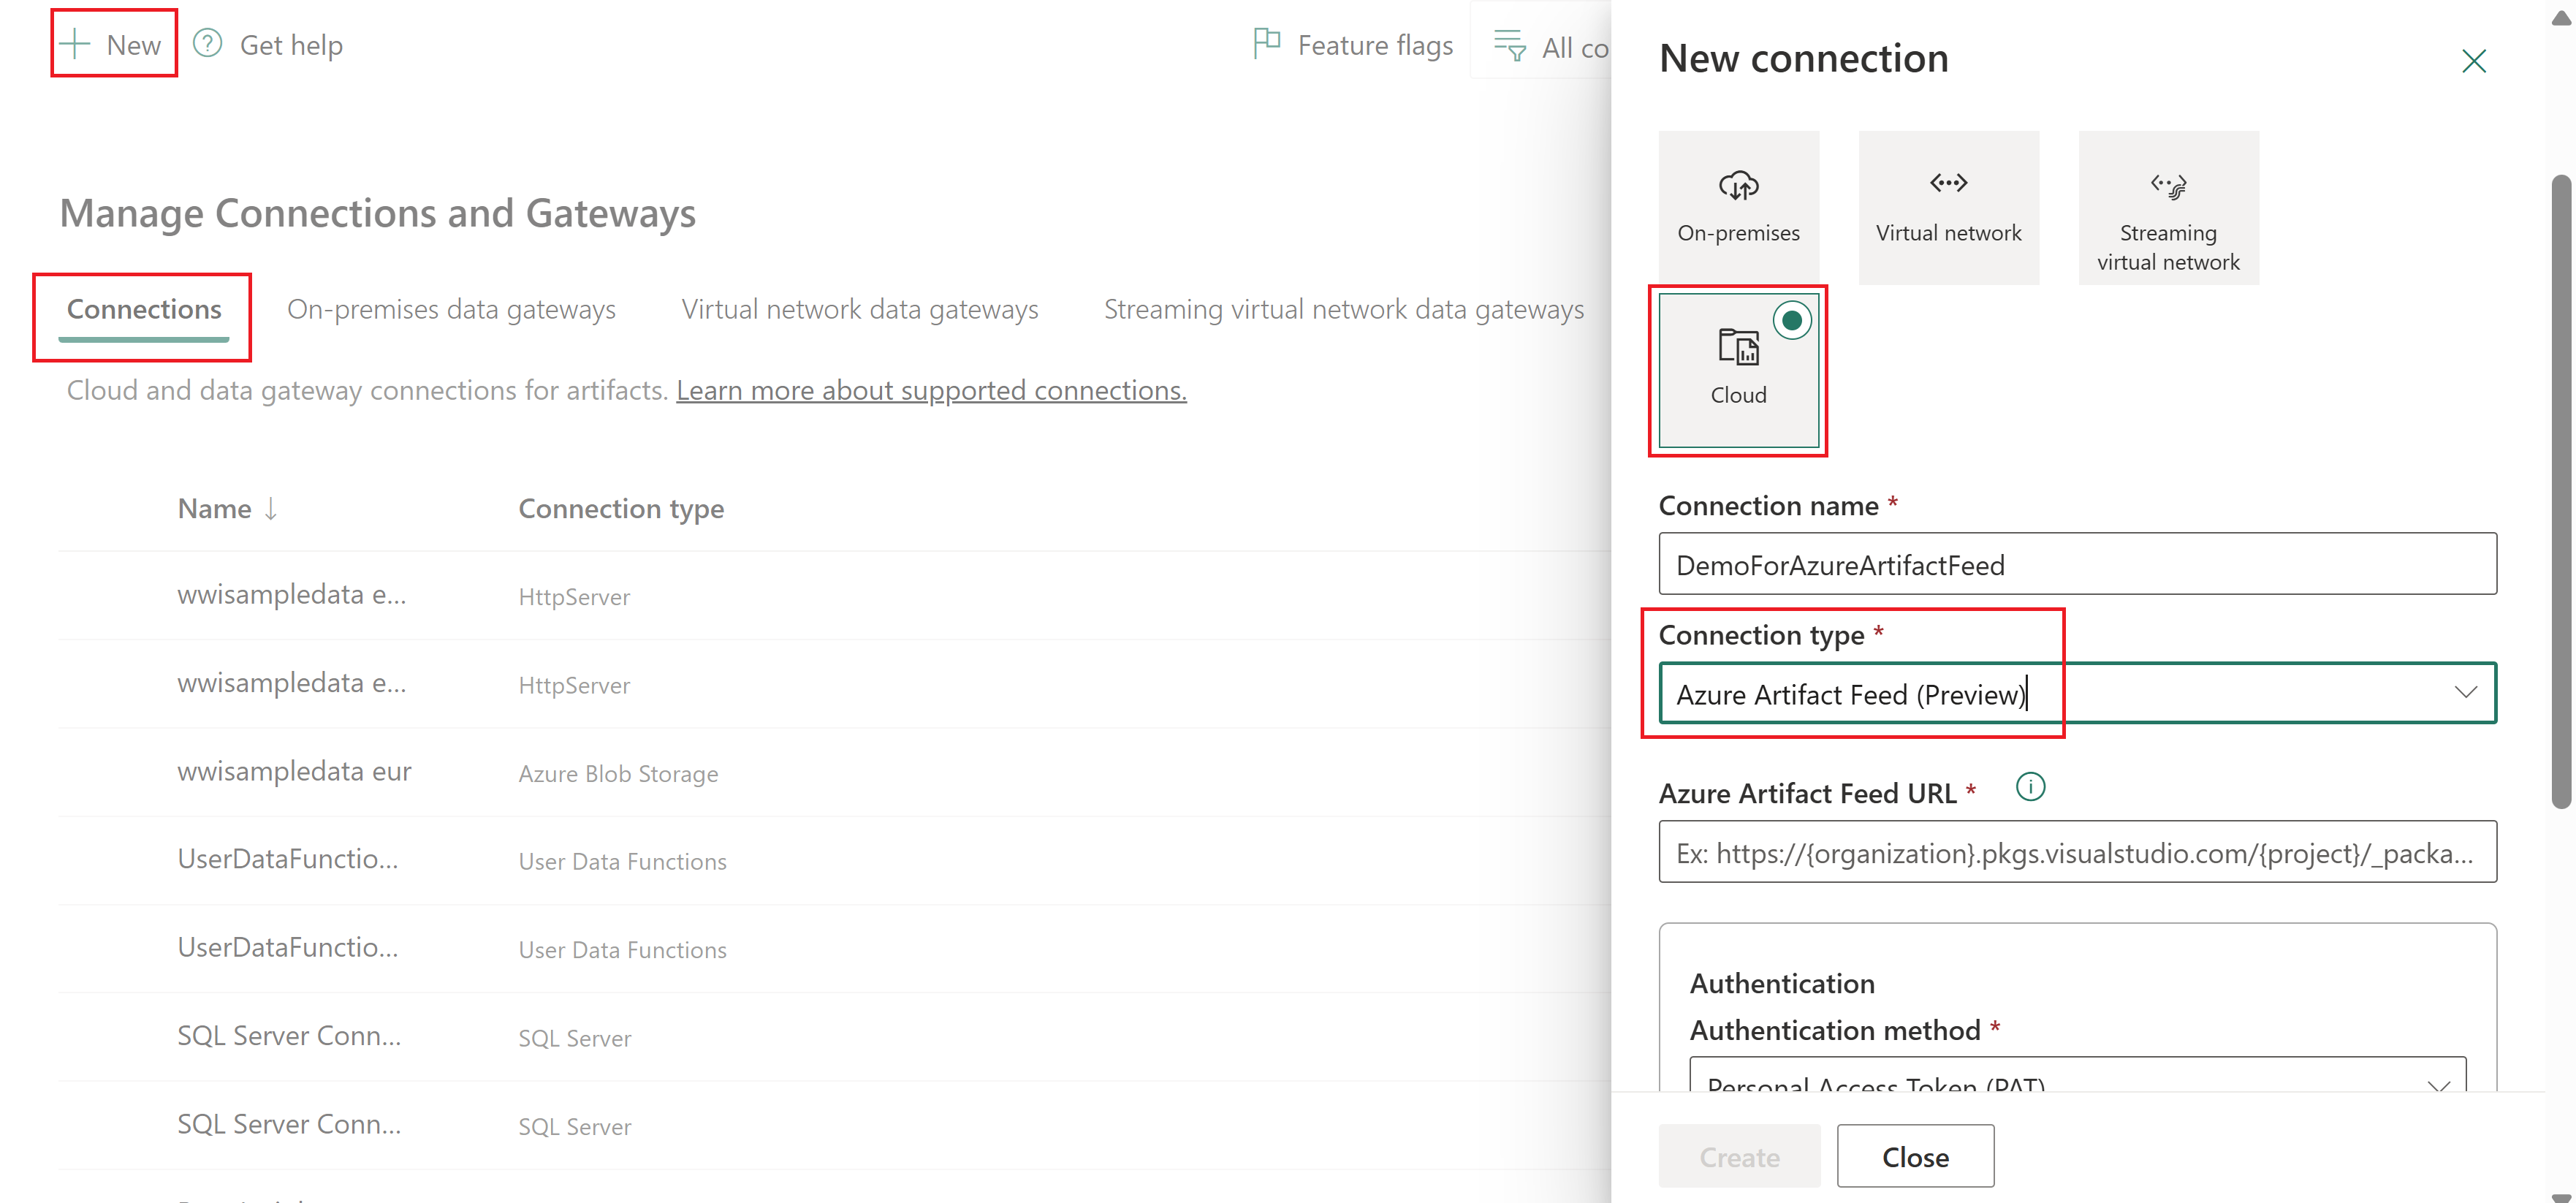
Zadejte adresu URL informačního kanálu v některém z těchto formulářů:
https://pkgs.dev.azure.com/{organization}/{project}/_packaging/{feed}/pypi/simple/
https://{organization}.pkgs.visualstudio.com/{project}/_packaging/{feed}/pypi/simple/
Udělit přístup ke kanálu prostřednictvím tokenu osobního přístupu (PAT) nebo prostřednictvím identity pracovního prostoru
- V případě režimu tokenu PAT vygenerujte token PAT (v ADO → Uživatelské nastavení → Tokeny osobního přístupu) s rozsahem Balení: Čtení. Přidejte uživatele PAT-owner do kanálu s rolí Čtenář kanálu v části Kanál → Nastavení → Oprávnění.
- V případě režimu identity pracovního prostoru správce pracovního prostoru povolí identitu pracovního prostoru v nastavení pracovního prostoru → identitě pracovního prostoru → + identita pracovního prostoru. V feedu ADO vyhledejte Nastavení feedu → Oprávnění → Přidat uživatele nebo skupiny, přidejte identitu pracovního prostoru (pojmenovanou stejně jako pracovní prostor) s rolí alespoň Čtenář feedu.
Vyberte Povolit artefakty typu Code-First, jako jsou poznámkové bloky, k přístupu k tomuto připojení (Preview).
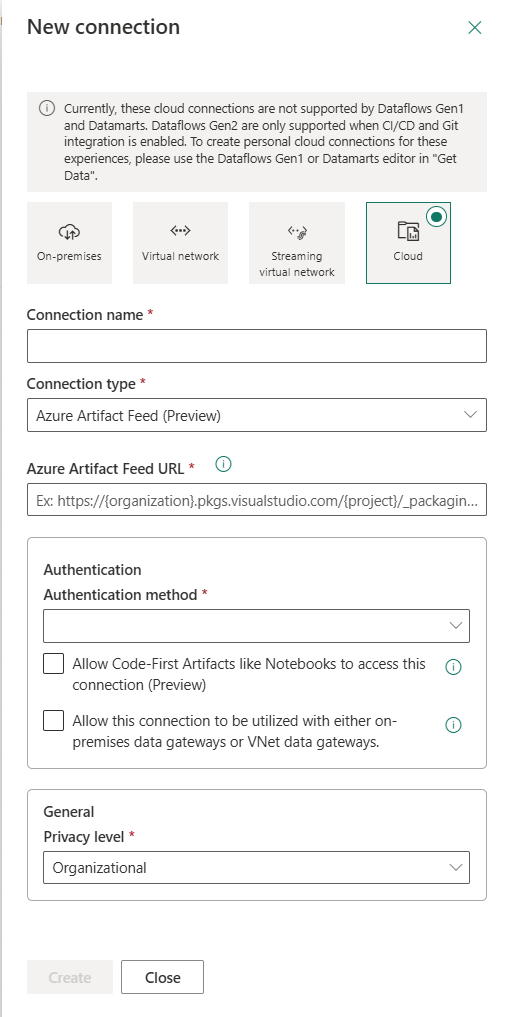
Vyberte Vytvořit a uložte připojení. Měl by se zobrazit v seznamu připojení.
Poznamenejte si ID připojení po vytvoření. Potřebujete ho v dalším kroku.
Příprava a nahrání souboru YML
Vytvořte soubor YML, který obsahuje balíčky, které chcete nainstalovat, a používá ID připojení místo adresy URL informačního kanálu a přihlašovacích údajů. Fabric používá ID připojení k ověřování a načítání balíčků z informačního kanálu v době publikování.
Standardní konfigurace pip odkazuje přímo na adresu URL informačního kanálu a přihlašovací údaje:
dependencies:
  - pip:
    - fuzzywuzzy==0.18.0
    - wordcloud==1.9.4
    - --index-url <URL_TO_THE_AZURE_ARTIFACT_FEED_WITH_AUTH>
U Fabric nahraďte adresu URL zaznamenaným ID připojení:
dependencies:
  - pip:
    - fuzzywuzzy==0.18.0
    - wordcloud==1.9.4
    - --index-url <YOUR_CONNECTION_ID>
Nahrajte soubor YML přímo do prostředí nebo přepněte do zobrazení editoru YML a vložte obsah. Když prostředí publikujete, Fabric přečte balíčky z vašeho informačního kanálu a zachová je. Pokud aktualizujete balíčky v úložišti artefaktů Azure, znovu publikujte prostředí, aby se načetly nejnovější verze.
Poznámka:
- V zobrazení Seznam můžete přidávat, odebírat nebo upravovat knihovny z existujících připojení informačních kanálů. Pokud chcete přidat, odebrat nebo upravit samotné připojení informačního kanálu, přepněte do zobrazení editoru YML a přímo aktualizujte soubor YML.
- V souboru YML můžete zadat více informačních kanálů . Fabric je vyhledá v uvedeném pořadí, dokud se balíček nenajde. Veřejná úložiště, jako je PyPI a Conda, se prohledávají automaticky, i když nejsou zahrnutá do souboru YML.
- Pokud balíček v souboru YML nejde najít v žádném z uvedených informačních kanálů, publikování selže. Před publikováním pečlivě zkontrolujte název a verzi balíčku.
Správa externích knihoven
Po přidání externích knihoven je můžete spravovat v části Externí úložiště .
- Filter – K filtrování seznamu externích knihoven použijte název balíčku jako klíčové slovo.
- Aktualizace – Vyberte knihovnu, která aktualizuje její název, verzi nebo typ zdroje v zobrazení Seznam. V zobrazení editoru YML můžete také aktualizovat ID připojení k kanálu Azure Artifact Feed.
- Delete – Najeďte myší na řádek knihovny, abyste viděli možnost Odstranit , nebo vyberte více knihoven a pak vyberte Odstranit. Knihovny můžete také odebrat pomocí zobrazení editoru YML.
- Zobrazit závislosti – Na knihovnu veřejného úložiště najeďte kurzorem a vyberte Zobrazit závislosti k načtení stromu závislostí. Informace o závislostech nejsou k dispozici pro soukromé knihovny nebo knihovny z informačního kanálu artefaktů Azure.
-
Exportovat do .yml – Exportujte úplný seznam externí knihovny do
.ymlsouboru a stáhněte si ho do místního adresáře.
Vlastní knihovny
Vlastní knihovny odkazují na kód vytvořený vámi nebo vaší organizací. Fabric podporuje soubory vlastních knihoven ve formátech .whl, .py, .jar a .tar.gz. Stejně jako u externích knihoven při nahrávání vlastních balíčků zvolíte režim publikování (úplný nebo rychlý). Podrobnosti najdete v tématu Výběr režimu publikování pro knihovny.
Poznámka:
Fabric podporuje pouze soubory .tar.gz pro jazyk R. Pro Python jazyk použijte formát souboru .whl a .py.
Pomocí tlačítek Nahrát a Stáhnout na stránce Vlastní knihovny můžete přidat knihovny z místního adresáře nebo je stáhnout místně.
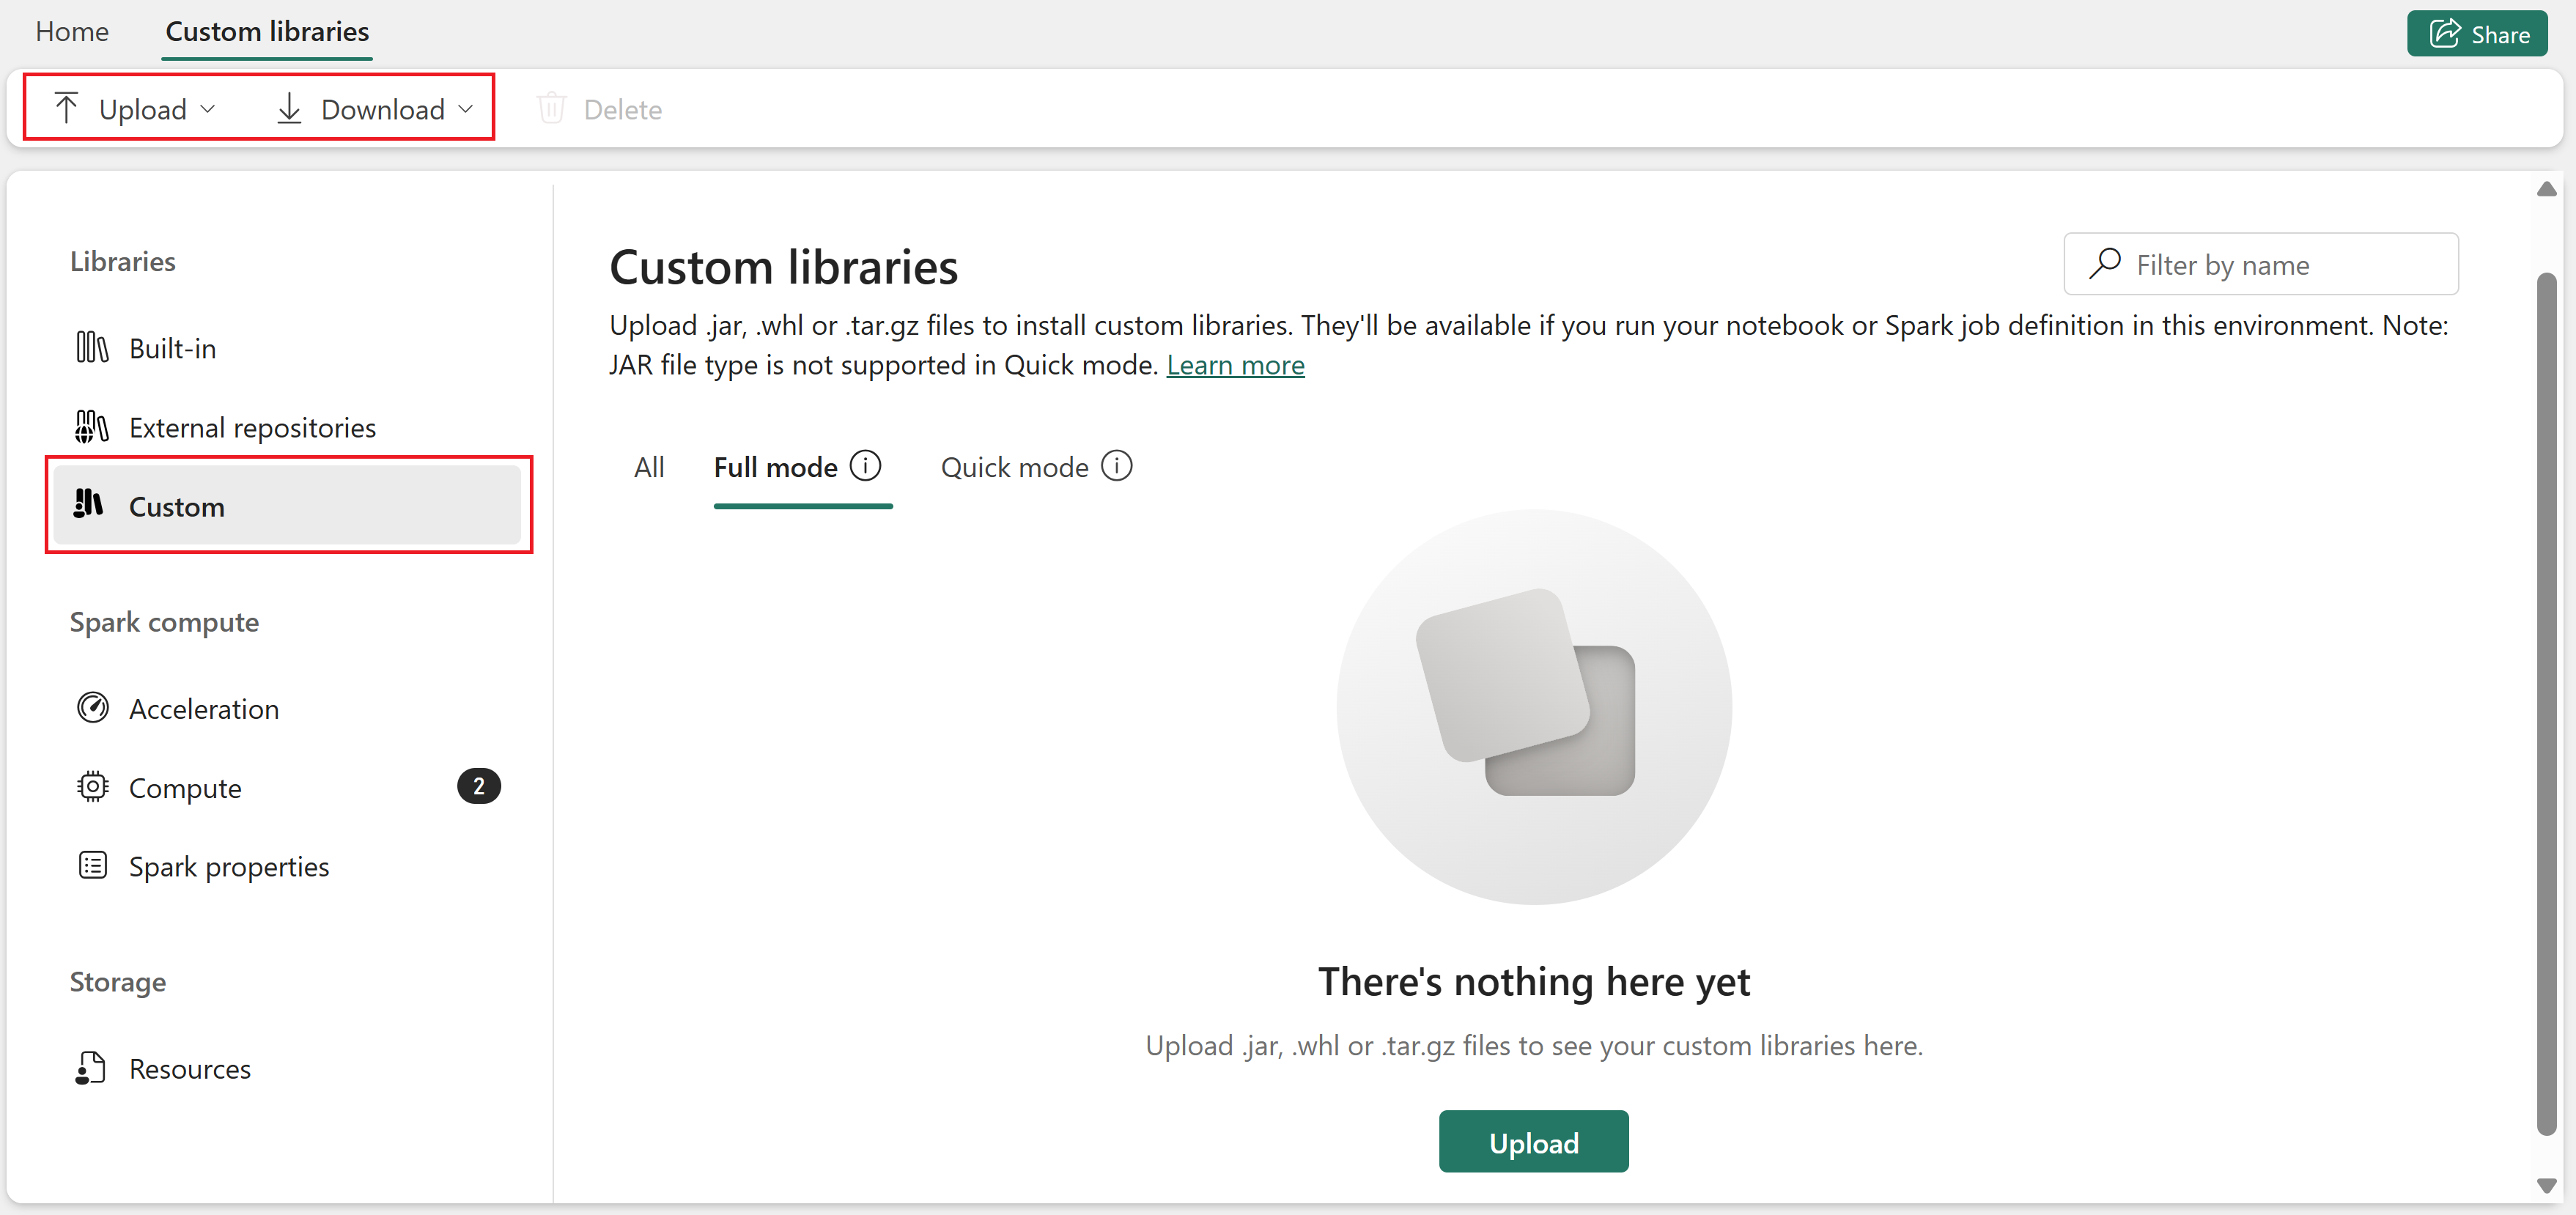
Pokud chcete knihovnu odstranit, najeďte myší na její řádek a vyberte ikonu koše nebo vyberte více knihoven a pak vyberte Odstranit.
Výběr režimu publikování pro knihovny
Když přidáte externí nebo vlastní knihovny, zvolíte režim publikování. Úplný režim je k dispozici pro všechny zdroje knihoven a typy úloh. Rychlý režim je k dispozici pro veřejná úložiště a většinu vlastních formátů knihovny, ale pouze při spouštění poznámkových bloků.
Následující tabulka ukazuje, který režim publikování podporuje každý zdroj knihovny.
| Zdroj knihovny | Plný režim | Rychlý režim |
|---|---|---|
| Veřejné úložiště (PyPI/Conda) | Ano | Ano |
| Privátní úložiště (pip/conda) | Ano | Ne |
| informační kanál artefaktů Azure | Ano | Ne |
Vlastní .whl, .py.tar.gz |
Ano | Ano |
Vlastní .jar |
Ano | Ne |
Volba správného režimu pro vaše potřeby
Pomocí složitosti závislostí a typu úlohy určete, který režim vyhovuje.
- Úplný režim řeší závislosti, ověřuje kompatibilitu a během publikování vytvoří stabilní snímek knihovny. Snímek se nasazuje při zahájení nové relace. Nejvhodnější pro větší sady závislostí (například více než 10 balíčků), produkční úlohy a pipeline. Publikování obvykle trvá 3 až 6 minut; ke spuštění relace se přidá 1 až 3 minuty na nasazení závislostí podle jejich velikosti. Pokud chcete při přibližně 5sekundovém spuštění relace zachovat stabilní snímek, použijte režim Full společně s vlastním živým fondem.
- Rychlý režim přeskočí zpracování závislostí během publikování a balíčky nainstaluje při spuštění sessiony poznámkového bloku. Vhodné pro méně náročné sady závislostí, rychlé iterace a experimentování v rané fázi. Publikování se dokončí přibližně za 5 sekund; instalace knihovny probíhá při spuštění relace.
Během vývoje můžete kombinovat režimy. Běžným vzorem je iterace v rychlém režimu a následná přesunutí ověřených závislostí do úplného režimu pro stabilní produkční snímek. Stávající snímek v úplném režimu můžete zachovat beze změny a vrstvit nové testovací balíčky v rychlém režimu – snímek v úplném režimu se nasadí jako první a pak se balíčky rychlého režimu nainstalují nad.
Omezení a chování v režimu
Při práci s režimy publikování mějte na paměti tato omezení.
- Rychlý režim funguje jenom s poznámkovými bloky, ne s definicemi úloh Sparku.
- Pokud chcete přesunout vlastní knihovnu mezi režimy, stáhněte si soubor, odeberte ho z aktuálního režimu a pak ji nahrajte do cílového režimu. Přímé přenosy mezi režimy se nepodporují.
- Protokoly instalace se v poznámkovém bloku nezobrazují. Ke sledování průběhu a řešení potíží použijte monitorování (úroveň 2 ).
- Pokud oba režimy obsahují balíčky, použije se snímek celého režimu jako první. Balíčky rychlého módu se instalují jako první a přepíší jakékoli balíčky v plném módu se stejným názvem.
- Pokud existují duplicitní balíčky v různých režimech, verze rychlého režimu přepisují úplné verze režimu pouze pro aktuální relaci poznámkového bloku. Spuštění nové relace nejprve znovu použije snímek režimu Full mode a poté se na něj nainstalují balíčky režimu Quick mode.
- Balíčky rychlého režimu se nainstalují, když se spustí první buňka kódu pro daný jazyk. Například Python balíčky se nainstalují, když se spustí první Python buňka, a balíčky R se nainstalují při prvním spuštění buňky R.
Související obsah
- Vytvoření, konfigurace a použití prostředí v Fabric
- Spravovat knihovny Apache Spark ve Fabric