Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
Platí pro: ✅ Warehouse v Microsoft Fabric
Tento článek vysvětluje výhody vývoje a nasazování Fabric Data Warehouse pomocí vestavěné integrace Gitu v platformě Fabric.
Important
Tato funkce je ve verzi Preview.
Použitím integrace Git ve Fabric mohou týmy aplikovat moderní postupy správy zdrojových kódů při vývoji ve skladech. Vývojáři mohou izolovat změny v větvích, sledovat vývoj schématu pomocí commitů, spolupracovat prostřednictvím pull requestů a synchronizovat aktualizace mezi Git repozitáři a Fabric workspaces.
Mezi obvyklé scénáře patří:
- Bezpečné provádění změn schématu ve větvích a pracovních prostorech
- Verze objektů skladu v Gitu
- Spolupráce napříč více pobočkami a pracovními prostory
- Podpora validovaných změn mezi větvemi
- Udržování položek pracovního prostoru (datového skladu a dalších) v souladu s Gitem jako zdrojem pravdy
Pro udržení konzistence, sledovatelnosti a spolehlivosti napříč životními cykly vývoje skladu je nutné tyto pracovní postupy pochopit.
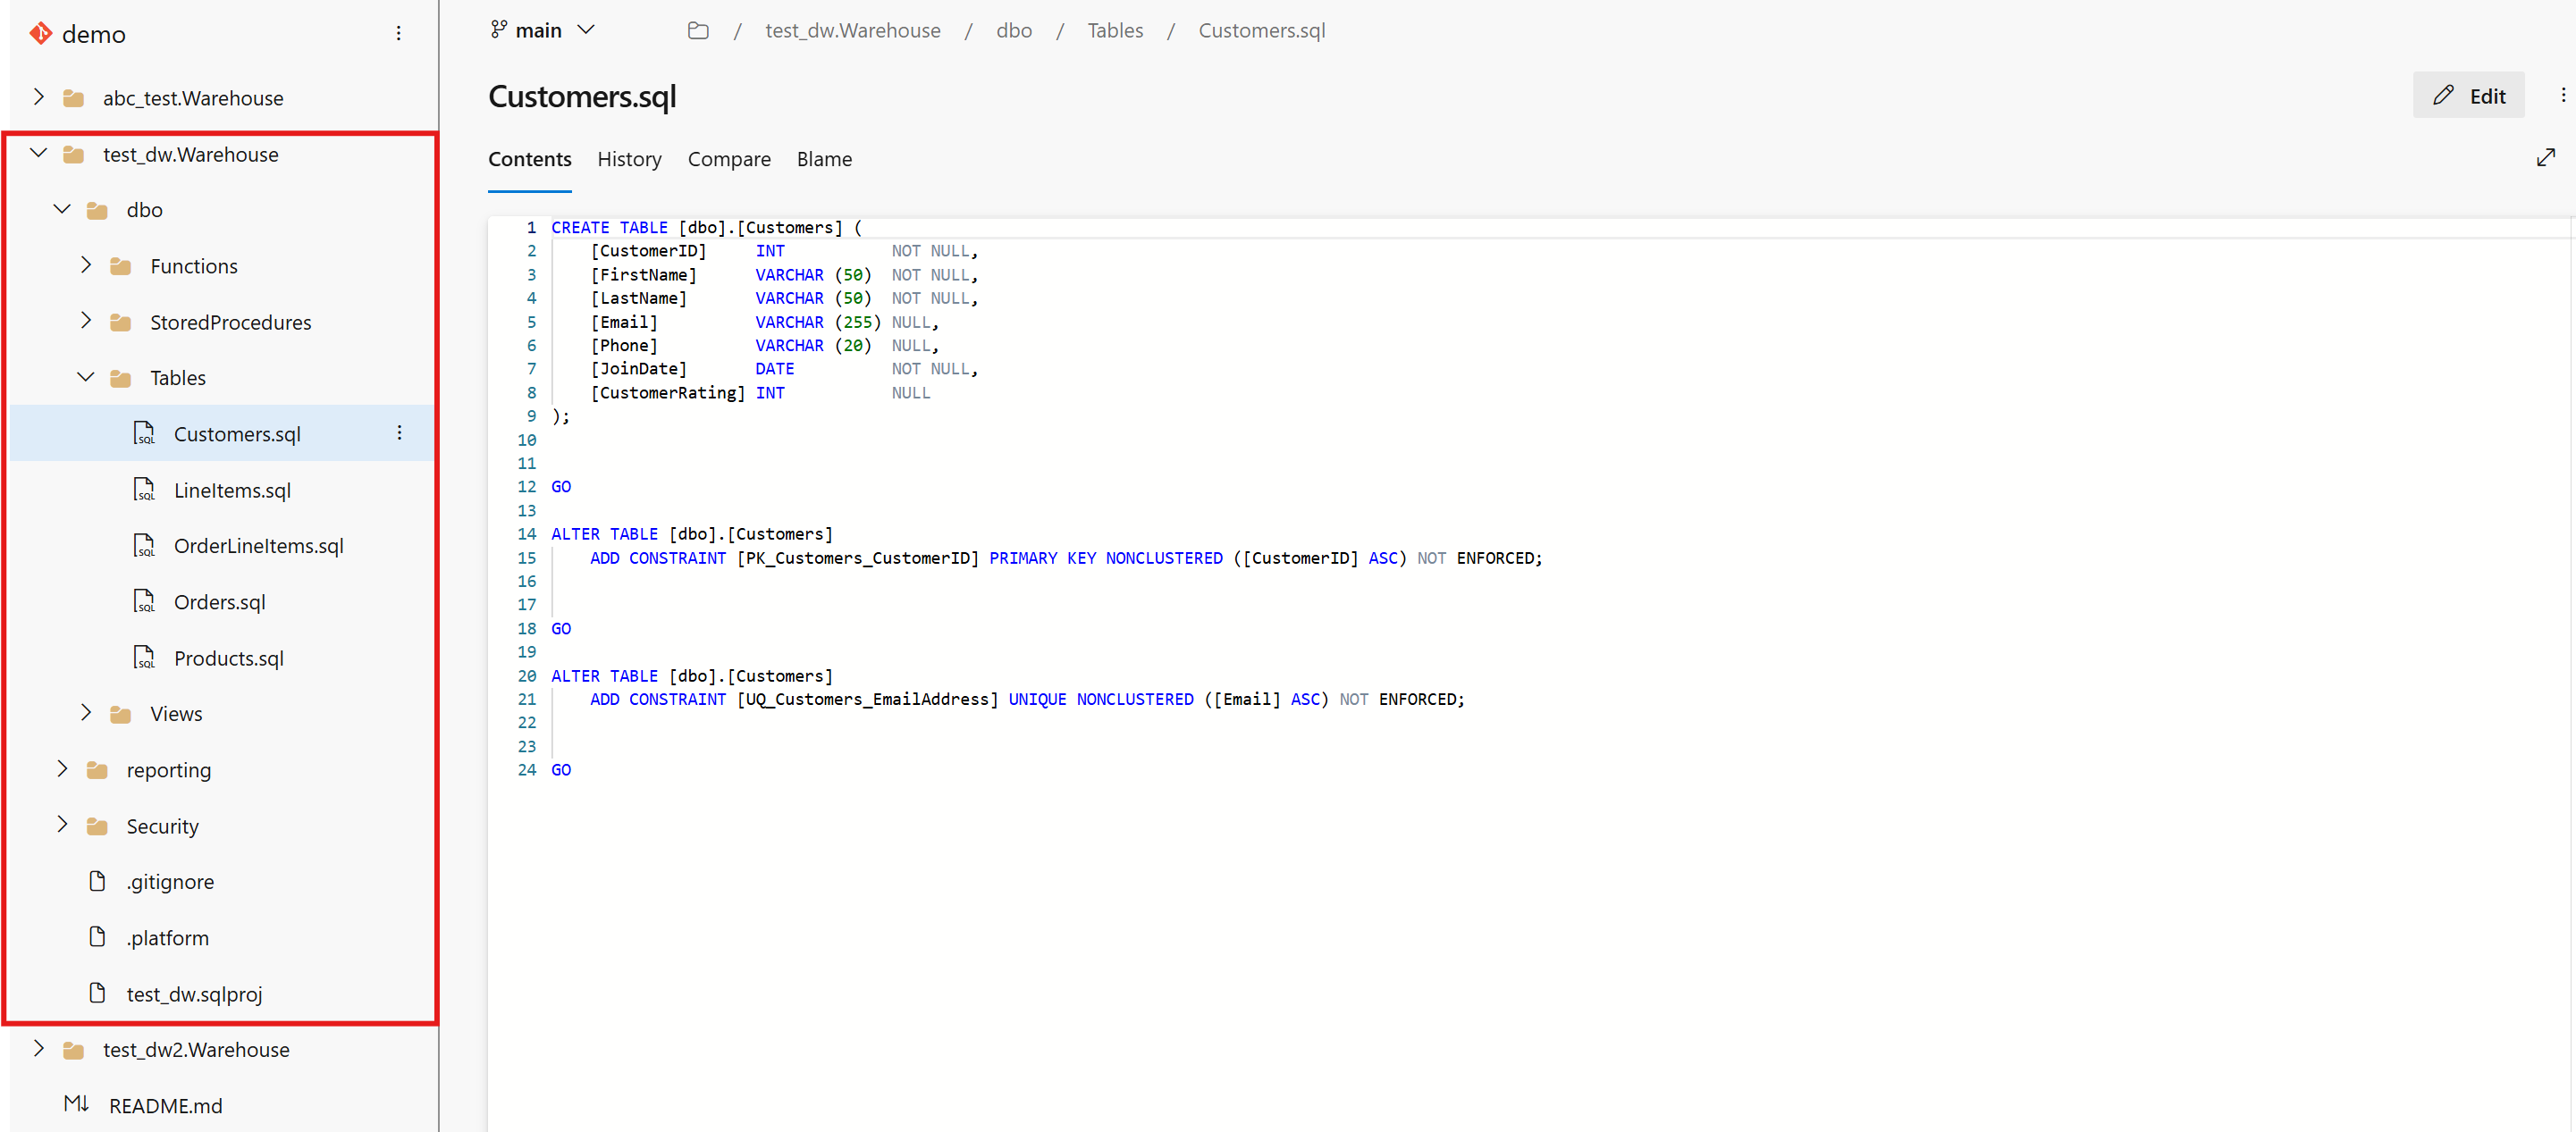
Když připojíte pracovní prostor Fabric Data Warehouse ke Gitu, potvrdíte definice datového skladu jako databázový projekt. Tento projekt se stává autoritativním vyjádřením skladového schématu ve zdrojovém řízení a slouží jako základ pro pokračující vývojové aktivity. V průzkumníku správy zdrojového kódu se schéma zobrazuje jako jednotlivé .sql soubory.
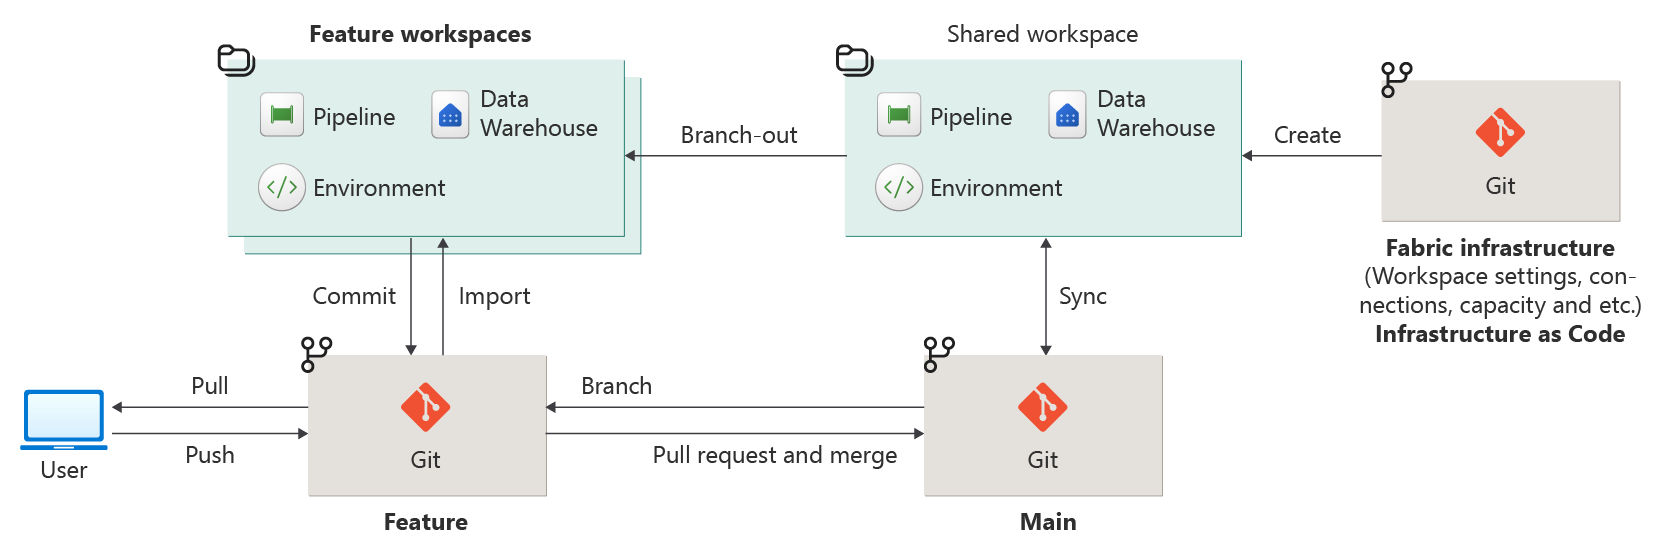
Použitím Fabric Git Integration a Fabric Data Warehouse můžete:
- Vyvíjejte Fabric Data Warehouse pomocí integrace s Gitem.
- Nasazujte Fabric Data Warehouse pomocí nasazovacích pipeline.
- Nasazujte a nasazujte průběžně pomocí portálu Fabric, Gitu, vlastního IDE nebo lokálního vývojového prostředí, Fabric deployment pipeline nebo externích systémů kontinuální integrace/kontinuálního nasazení (CI/CD), včetně pipeline v Azure DevOps Services nebo GitHub.
Porovnání
Během tohoto synchronizačního procesu Fabric používá inkrementální nasazování schématu založeného na DacFx k aplikaci změn. Tento přístup aplikuje pouze relevantní rozdíly ve schématu na sklad, místo aby aktualizoval celou definici skladu.
Inkrementální extrakce pomáhá omezit zbytečné změny v systému správy zdrojového kódu, zachovat přehlednější rozdíly ve schématu napříč větvemi a podporuje efektivní pracovní postupy při vytváření větví a jejich slučování. Protože proces extrakce zohledňuje schéma, umožňuje také spolehlivé porovnání a ověřování shody mezi stavem pracovního prostoru a definicemi sledovanými v Gitu.
Standardizace způsobu extrakce a ukládání skladových schémat zlepšuje konzistenci napříč vývojovými prostředími. Definice schémat zůstávají stabilní napříč větvemi, rozdíly přesněji odrážejí záměrné vývojové změny a správa zdrojových kódů se stává spolehlivým základem pro nasazení, spolupráci a řízení životního cyklu.
Soubor XMLA.json sám je během integračních pracovních postupů Git vyloučen. Fabric tento soubor vylučuje z commitů a aktualizací, takže výchozí sémantická model metadata nejsou nechtěně uložena v Gitu. Při synchronizaci pracovního prostoru z Gitu je ignorován, XMLA.json což pomáhá předcházet konfliktům, nechtěným přepsáním a šumu při přepínání větví nebo aktualizacích z Gitu.
Omezení správy zdrojového kódu
SQL bezpečnostní funkce, jako jsou oprávnění, vyžadují skriptový přístup pro export a migraci. Zvažte použití skriptu po nasazení v projektu databáze SQL. V projektu můžete nastavit skript po nasazení pomocí rozšíření SQL Database Projects, které je dostupné v Visual Studio Code.
Závislosti napříč položkami mezi sklady a SQL analytickými endpointy nejsou v současnosti ve vývojových pracovních postupech podporovány. V důsledku toho scénáře, které závisí na koordinovaných změnách těchto položek, nemusí spolehlivě fungovat.
Skripty před nasazením nebo po nasazení a další konfigurace publikování přidané přímo do databázového projektu přes Git nejsou uchovávány jako součást vývojových workflow. Tyto konfigurace možná budete muset spravovat samostatně mimo pracovní prostor Fabric.
Selektivní commity na úrovni skladu momentálně nejsou podporovány. Změny se provádějí na úrovni skladových položek, nikoli na jemnějších, detailních úrovních objektů.
Podpora správy verzí pro SQL analytické endpointy momentálně není dostupná. Toto omezení může omezit správu životního cyklu od začátku do konce, pokud řešení pokrývají jak sklady, tak SQL analytické koncové body.
Omezení integrace Gitu
- Když se dvě nebo více skladových položek na sebe odkazují, tvoří cyklickou závislost. Systém detekuje tuto kruhovou referenci během synchronizačních operací typu branch-out nebo Git-to-workspace, což způsobuje jejich selhání. Vyhněte se cyklickým závislostem mezi položkami.
- V současné době nevytvořte tok dat Gen2 s výstupním cílem do skladu. V úložišti se zobrazí nová položka s názvem
DataflowsStagingWarehousea zablokuje potvrzení a aktualizaci z Gitu. - Závislosti mezi položkami, pořadí položek a mezery synchronizace mezi koncovým bodem sql Analytics a skladem ovlivňují "větvení do nového nebo existujícího pracovního prostoru" a "přepnutí na jinou větev" během vývoje a průběžné integrace.
- Pokud objekt odkazuje na jiný objekt ve stejném skladu pomocí třífázového pojmenovávání (),
database.schema.objectmůže být potvrzení nebo aktualizace z Gitu neúspěšná. Pro více informací a řešení viz Odkazy na objekty skladu pomocí třídílného názvu. - Pokud změníte sloupec, ve kterém je definováno
IDENTITY, potvrzení změn nebo aktualizace v Git může selhat, dokud pro tabulku nepovolíteIDENTITY_INSERT. - Pokud repozitář obsahuje soubor
.sqlproj, který fixuje starší verzi sady SDKMicrosoft.Build.Sql, může potvrzení změn nebo aktualizace z Gitu selhat, protože starší sada SDK nerozpoznává novější syntaxi datového skladu, jako jsou sloupceIDENTITYaCLUSTER BY. Pro více informací a řešení viz Out-of-date .sqlproj v Git repozitáři. - Pokud objekt odkazuje na dvě nebo více tabulek v jiném warehouse, aniž by byl každý sloupec kvalifikován aliasem, může potvrzení změn nebo aktualizace z Gitu selhat. Další informace a náhradní řešení naleznete v tématu Nekvalifikované sloupce v objektech, které odkazují na dvě nebo více tabulek v jiném datovém skladu.
- Pokud vaše skripty odkazují na dva nebo více různých objektů ve stejném schématu jiného skladu a název schématu píšou s nekonzistentním velkým písmenem, může commitování nebo aktualizace z Gitu selhat. Pro více informací a řešení viz Nekonzistentní velká písmena názvů schémat.
- Nejasné chyby ve sloupcích, jejichž kandidátní seznam obsahuje oddělovač,
::se mohou objevit při commitování nebo aktualizaci z Gitu, i když není žádná skutečná nejednoznačnost. Pro více informací a obcházení viz Nejednoznačné chyby sloupců s duplicitními kandidátskými objekty.
Nepodporované scénáře
Následující pracovní postupy CI/CD nejsou oficiálně podporovány, pokud mají sklady v různých pracovních prostorech různé kolace. I když tyto operace můžou být úspěšné bez chyb, můžou vést k chybám metadat.
Ve všech těchto scénářích, pokud dojde k neshodě kolace, použijte skript Python scripts/dw-collation-error-update-tmsl/pbi_interactive.py v úložišti GitHub Fabric toolbox k aktualizaci kolace datové sady (TMSL), aby odpovídala kolaci skladu.
| Scenario | Description | Riziko |
|---|---|---|
| Nasazovací kanály | Propagace obsahu skladu prostřednictvím fází potrubí (například Dev → Test → Prod), kde byl cílový sklad vytvořen s odlišným řazením než zdroj, není podporováno. | Nasazení může proběhnout úspěšně, ale kolace datové sady se neaktualizuje tak, aby odpovídala kolaci cílového skladu. |
| Větvení do nového nebo existujícího pracovního prostoru | Použití integrace Gitu k rozvětvení z existujícího pracovního prostoru do nového nebo existujícího pracovního prostoru, kde má sklad jinou kolaci, se nepodporuje. | Obsah skladu se synchronizuje, ale metadata uspořádání dat nejsou sjednocována. |
| Přepínání větví v pracovním prostoru | Přepnutí na větev přidruženou ke skladu jiné kolace v pracovním prostoru připojeném ke Git není podporováno. | Synchronizovaný obsah může přenášet kolacační předpoklady, které neodpovídají aktuálnímu datovému skladu. |
| Sloučení změn mezi pracovními prostory prostřednictvím větví | Sloučení větví Gitu mezi pracovními prostory, kde mají databázové sklady různé jazykové řazení, se nepodporuje. | Sloučení může být úspěšné na úrovni Gitu, ale výsledné řazení datové sady neodráží řazení cílového skladu. |