Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
platí pro:✅ Warehouse v Microsoft Fabric
Tento článek popisuje metody migrace datových skladů v SQL Server do Microsoft Fabric Data Warehouse.
Tip
Pro více informací o strategii a plánování viz Migration planning: SQL Server to Fabric Data Warehouse.
Použijte Fabric Pomocník s migrací for Data Warehouse pro automatizovanou migraci z SQL Server. Zbytek tohoto článku popisuje další kroky manuální migrace.
Následující tabulka shrnuje metody migrace datového schématu (DDL), databázového kódu (DML) a dat. Každá možnost je popsána později v tomto článku.
| Option | Metoda | Jak funguje | Dovednosti nebo preference | Scenario |
|---|---|---|---|---|
| 1 | Data Factory | Převod schématu Extrakce dat Příjem dat |
kanál Data Factory | Zjednodušené schéma a migrace dat. Doporučeno pro dimenzionální tabulky. |
| 2 | Data Factory s dělením na oddíly | Převod schématu Extrakce dat Příjem dat |
Kanál Data Factory | Paralelizovaná migrace pro velké faktové tabulky. |
| 3 | Migrace typu Schema-first | Převod schématu | Kanál Data Factory | Nejprve migrujte schéma a poté extrahujte a ingestujte data odděleně pro lepší kontrolu nad propustností. |
| 4 | SQL migrační skripty | Převod schématu Extrakce dat Posouzení kódu |
T-SQL | Používejte IDE a skripty pro detailní kontrolu nad migračními úkoly. |
| 5 | SQL databázové projekty | Převod schématu Posouzení kódu |
SQL projekt | Používejte databázový projekt pro správu zdrojového kódu, hodnocení a nasazení. |
| 6 | dbt | Převod schématu Převod kódu databáze |
dbt | Znovu použijte existující DBT projekt změnou konfigurace adaptéru a cíle. |
Volba pracovního zatížení pro počáteční migraci
Když se rozhodujete, kde začít projekt SQL Server Fabric Data Warehouse migrace, vyberte oblast pracovní zátěže, kde můžete:
- Prokažte životaschopnost přechodu na Fabric Data Warehouse rychlým využitím výhod nového prostředí. Začněte pomalými a jednoduchými a připravte se na několik malých migrací.
- Dejte technickému týmu čas získat relevantní zkušenosti s procesy a nástroji, které používají k migraci jiných pracovních zátěží.
- Vytvořte šablonu pro další migrace specifickou pro vaše SQL Server prostředí, nástroje a procesy.
Tip
Vytvořte inventář objektů, které je třeba migrovat, a dokumentujte migrační proces od začátku do konce, aby jej bylo možné opakovat pro jiné databáze nebo pracovní zátěže.
Objem dat při počáteční migraci by měl být dostatečně velký, aby demonstroval schopnosti a přínosy Fabric Data Warehouse, ale zároveň dostatečně malý, aby rychle prokázal hodnotu. Velikost v rozsahu 1–10 terabajtů je typická.
Migrujte pomocí Fabric Data Factory
Fabric Data Factory poskytuje nízkokódové rozhraní, které dokáže převádět tabulky DDL a migrovat data ze SQL Server.
Služba Fabric Data Factory může provádět následující úlohy:
- Převést schéma (DDL) na Fabric Data Warehouse syntaxi.
- Vytvořte objekty schématu v Fabric Data Warehouse.
- Migrujte data na Fabric Data Warehouse.
Možnost 1. Migrace schémat a dat pomocí Copy assistant
Tato metoda využívá Data Factory Copy asistenta k připojení ke zdrojové SQL Server databázi, převodu tabulky DDL na Fabric syntaxi a kopírování dat do Fabric Data Warehouse. Můžete vybrat jednu nebo více zdrojových tabulek. Generovaný pipeline používá aktivitu ForEach k paralelnímu kopírování vybraných tabulek.
Když konfigurujete kopírovací operaci:
- Pro zdrojové připojení použijte konektor SQL Server.
- Omezte paralelní kopie na úroveň, kterou zdrojová databáze a síť udrží.
- Monitorujte zdrojový CPU, I/O, využití transakčních logů a latenci produkční zátěže během extrakce.
Doporučené použití
Použijte Copy assistant pro jednoduché rozhraní, které převádí DDL a ingestuje vybrané tabulky v jedné operaci. Tato metoda je vhodná pro dimenzionální tabulky a menší pracovní zátěže.
U velkých tabulek použijte partitioning ke zvýšení paralelismu čtení a zápisu.
Možnost 2. Migrace dat s partitioningem
Pro velké faktové tabulky použijte aktivita Copy pro každou tabulku a nastavte rozdělení zdroje. Používejte fyzické oddíly, pokud jsou k dispozici, nebo konfigurujte rozdělení dynamického rozsahu zadáním vhodného číselného nebo datového sloupce a jeho minimálních a maximálních hodnot.
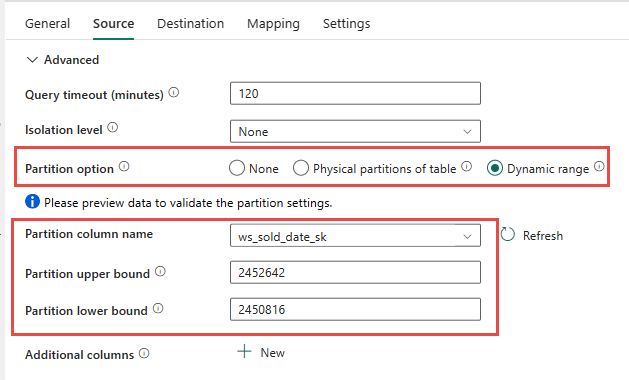
Když používáte partitioning:
- Vyberte sloupec pro rozdělení, který rovnoměrně rozdělí řádky.
- Vyhněte se vytváření více souběžných zdrojových dotazů, než jaké SQL Server dokáže zpracovat, aniž by to ovlivnilo produkční pracovní zátěž.
- Otestujte rozsah dělení a nastavení paralelního kopírování na reprezentativní zátěži.
- Postupně zvyšujte paralelizismus při monitorování zdroje a cíle.
Doporučené použití
Použijte dělení oddílů v Data Factory pro velké faktové tabulky, pokud paralelní extrakce zvyšuje propustnost. Velikost počtu dávek a rozsah oddílů nastavte podle zdrojových databázových zdrojů a kapacity sítě.
Možnost 3. Migrace typu Schema-first
U větších databází oddělte migraci schématu od migrace dat:
- Převádějte a vytvářejte tabulková schémata v Fabric Data Warehouse.
- Extrahujte zdrojová data do Azure Data Lake Storage (ADLS) Gen2.
- Použijte Data Factory nebo příkaz COPY INTO pro vstup fázovaných dat do Fabric Data Warehouse.
Oddělení těchto fází vám umožní nezávisle ladit extrakci a příjem.
Migrace schématu s Data Factory
Můžete použít Fabric pipeline k migraci schémat tabulek z SQL Server do Fabric Data Warehouse bez kopírování řádků.
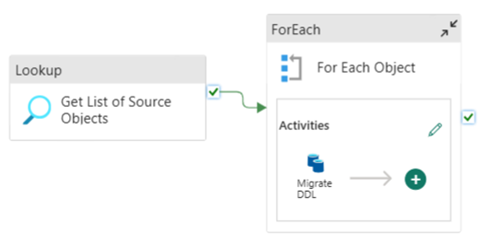
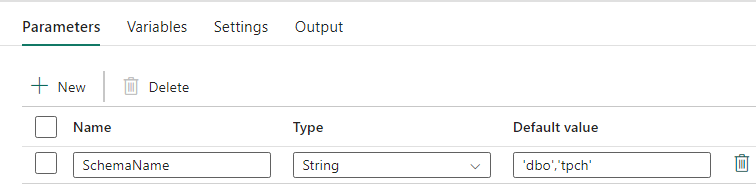
Konfigurace parametrů pipeline
Vytvořte parametr, SchemaName který určuje, která schémata migrovat. Použijte dbo jako výchozí nebo zadejte seznam oddělený čárkami, například 'dbo','sales'.
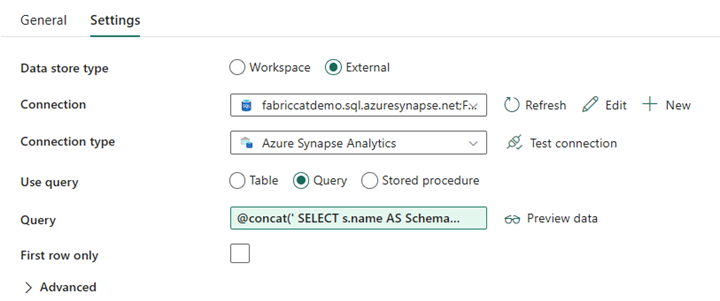
Nastavte vyhledávací aktivitu
Vytvořte vyhledávací aktivitu a nastavte její spojení se zdrojovou databází SQL Server. Na kartě Nastavení :
- Nastavte typ úložiště dat na Externí.
- Vyberte zdrojové připojení SQL Server.
- Nastavte Použít dotaz na Dotaz.
- Přidejte dynamický dotaz, který vrací zdrojové schéma a názvy tabulek.
Použijte následující výraz k vytvoření dotazu:
@concat('
SELECT s.name AS SchemaName,
t.name AS TableName
FROM sys.tables AS t
INNER JOIN sys.schemas AS s
ON t.type = ''U''
AND s.schema_id = t.schema_id
AND s.name in (',coalesce(pipeline().parameters.SchemaName, 'dbo'),')
')
Konfigurujte aktivitu ForEach
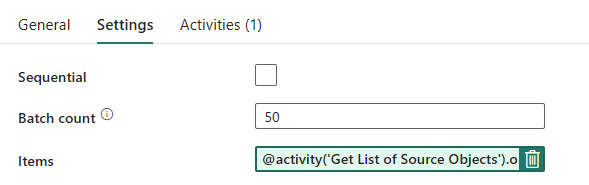
Na kartě Nastavení aktivity ForEach:
- Vypněte sekvenční režim, aby iterace běžely současně.
- Nastavte počet dávek na hodnotu, kterou zdrojová databáze dokáže udržet. Začněte s konzervativní hodnotou a otestujte ji.
- Nastavte položky na
@activity('Get List of Source Objects').output.value.
Nakonfigurujte aktivitu kopírování
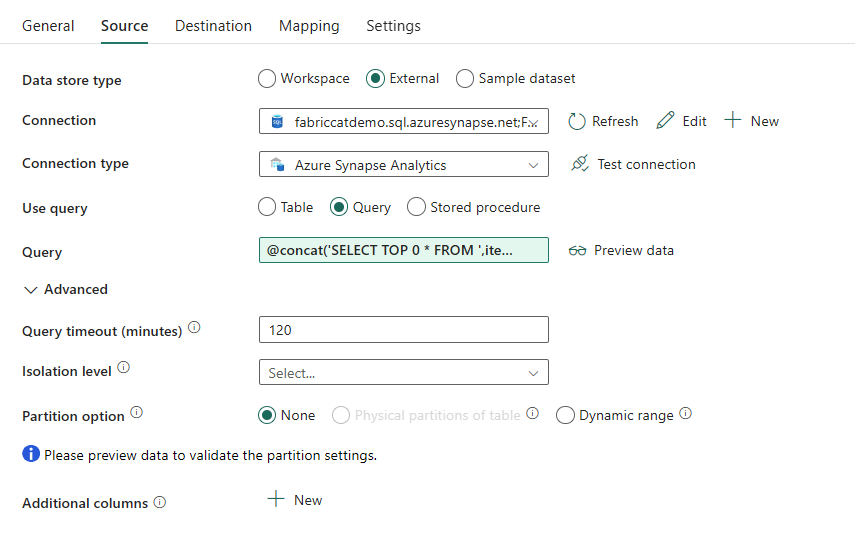
Uvnitř aktivity ForEach přidejte aktivitu aktivita Copy. Na kartě Zdroj :
- Nastavte typ úložiště dat na Externí.
- Vyberte zdrojové připojení SQL Server.
- Nastavte Použít dotaz na Query.
-
Nastavte Query tak,
@concat('SELECT TOP 0 * FROM ',item().SchemaName,'.',item().TableName)aby byla migrována pouze metadata tabulky.
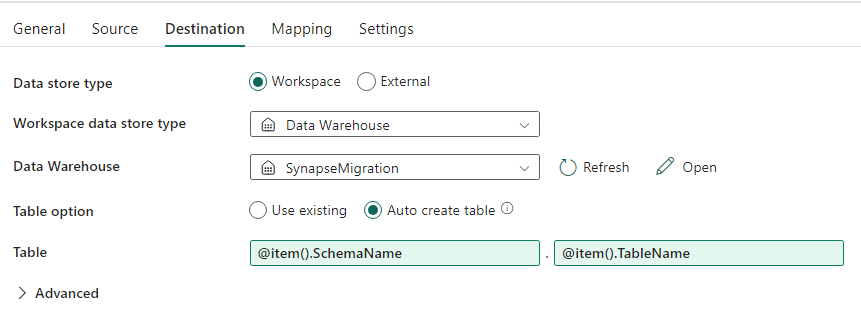
Na kartě Cíl :
- Nastavte typ úložiště dat na Pracovní prostor.
- Nastavte typ datového úložiště Workspace na Data Warehouse a vyberte cílový sklad.
- Nastavte schéma cíle na
@item().SchemaName. - Nastavte cílovou tabulku na
@item().TableName.
Po spuštění pipeline ověřte, že Fabric Data Warehouse obsahuje každou vybranou tabulku s očekávaným schématem.
Migrace pomocí SQL skriptů
Používejte migrační skripty T-SQL a PowerShell, když chcete detailní kontrolu nad konverzí schémat, extrakcí dat a hodnocením kódu.
Migrační skripty můžou:
- Převést schéma (DDL) na Fabric Data Warehouse syntaxi.
- Vytvořte objekty schématu v Fabric Data Warehouse.
- Extrahujte data ze SQL Server do ADLS Gen2.
- Označte nepodporovanou syntaxi T-SQL v uložených procedurách, funkcích a pohledech.
Tým Microsoft Fabric CAT poskytuje ukázky migračního kódu v repozitáři fabric-migration.
Doporučené použití
Používejte skripty, když znáte T-SQL, preferujete integrované vývojové prostředí a potřebujete řídit jednotlivé migrační úkoly. Použijte COPY INTO nebo Data Factory k načtení extrahovaných dat do Fabric Data Warehouse.
Migrace s využitím projektů databáze SQL
Fabric Data Warehouse je podporováno v rozšíření SQL Database Projects pro Visual Studio Code.
Projekt SQL databáze poskytuje možnosti řízení zdrojového kódu, testování databází, ověřování schémat a nasazování. Dokáže:
- Převést schéma (DDL) na Fabric Data Warehouse syntaxi.
- Vytvořte objekty schématu v Fabric Data Warehouse.
- Zhodnoťte nepodporovanou T-SQL syntaxi v uložených procedurách, funkcích a pohledech.
Pro migraci dat použijte Data Factory pro přímou kopíraci ze SQL Server, nebo extrahujte data do ADLS Gen2 a importujte je do COPY INTO Data Factory.
Pro návod na používání SQL databázových projektů s migračními skripty viz repozitář fabric-migration.
Pro více informací viz Začněte s rozšířením SQL Database Projects a Build a database project z příkazového řádku.
Migrace pomocí dbt
Pokud tvůj SQL Server data warehouse používá dbt, můžeš použít DBT adaptér pro Fabric Data Warehouse k převodu schématu a databázového kódu změnou cílového profilu a adaptéru.
DBT framework generuje DDL a DML skripty z modelových souborů. Data musíte migrovat samostatně pomocí Data Factory nebo jiné možnosti migrace dat uvedených v tomto článku.
Pro začátek si přečtěte návod: Nastavte dbt pro Fabric Data Warehouse.
Vstup dat do Fabric Data Warehouse
Pro fázovaná data použijte COPY INTO nebo Fabric Data Factory pro ingest souborů z ADLS Gen2 do Fabric Data Warehouse. Zvažte následující doporučení:
- Extrahujte velké tabulky paralelně, pokud má zdrojová databáze a síť dostatečnou kapacitu.
- Preferujte soubory Parquet ke snížení využití úložiště a sítě a zlepšení efektivity odběru.
- Načítej více cílových tabulek současně, když kapacita Fabric zvládne tuto zátěž.
- Monitorujte jak extrakci zdroje, tak kapacitu Fabric, abyste našli optimální míru paralelismu.