Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
Rozdíly v konfiguracích hardwaru, softwaru a clusteru a také různé požadavky aplikací na dobu provozu a výkon vyžadují konkrétní konfiguraci pro hodnoty časového limitu zapůjčení, clusteru a kontroly stavu. Některé aplikace a úlohy vyžadují agresivnější monitorování, aby se omezil výpadek po těžkých selháních. Jiné vyžadují vyšší toleranci vůči přechodným problémům se sítí a prodlevám způsobeným vysokým využitím prostředků a smiřují se s pomalejším přepnutím při selhání.
K detekci selhání pracuje více služeb na každém uzlu. Služba clusteru může zjistit ztrátu kvora, knihovna DLL prostředků může zjistit problém zjištěný detekcí stavu AlwaysOn nebo ruční převzetí služeb při selhání může být zahájeno přímo v primární instanci. Služba clusteru, hostitel prostředků a instance SQL Serveru se vzájemně synchronizují přes RPC, sdílenou paměť a T-SQL. Ve většině scénářů tyto služby úspěšně komunikují, ale tato komunikace není dokonale spolehlivá ani mezi službami na stejném počítači. Kromě toho skupina dostupnosti (AG) musí být schopná odolat událostem v celém systému, jako jsou selhání sítě a disku, což může bránit komunikaci nebo přerušení funkčnosti. Vzhledem k mnoha možným případům selhání a ne zcela spolehlivé komunikaci mezi službami je skupina dostupnosti (AG) závislá na různých mechanismech detekce selhání a převzetí služeb při selhání, aby na sobě nezávisle zjišťovala selhání a reagovala na ně, takže stav clusteru je na všech uzlech vždy konzistentní.
Vylepšená diagnostika časového limitu kontroly stavu v SQL Serveru 2025
Omezení prostředků, jako je vysoké využití procesoru, latence disku nebo nedostatek paměti, můžou způsobit vypršení časového limitu zapůjčení skupiny dostupnosti Always On. Když je v logu failover clusteru hlášen timeout pronájmu, nejnovější data z monitoru výkonu CPU, paměti a latence čtení a zápisu disku jsou hlášena v logu failover clusteru spolu s timeoutem pronájmu.
Stejně tak mohou omezené systémové prostředky způsobit vypršení časového limitu kontroly stavu. Od SQL Server 2025 (17.x) jsou nyní stejné čítače monitorování výkonu hlášeny v logu failover clusteru při detekci timeoutu kontroly stavu, podobně jako diagnostika timeoutu při pronájmu.
Následuje ukázka výstupu logu vylepšeného failover clusteru pro timeout kontroly stavu:
[Verbose] 000035b8.00001a64::2024/04/18-23:56:35.536 ERR   [RES] SQL Server Availability Group: [hadrag] Failure detected, diagnostics heartbeat is lost
[Verbose] 000035b8.00001a64::2024/04/18-23:56:35.536 WARN  [RES] SQL Server Availability Group: [hadrag] AG health check failed, logging perf counter data collected so far
[Verbose] 000035b8.00001a64::2024/04/18-23:56:35.536 WARN  [RES] SQL Server Availability Group: [hadrag] Date/Time, Processor time(%), Available memory(bytes), Avg disk read(secs), Avg disk write(secs)
[Verbose] 000035b8.00001a64::2024/04/18-23:56:35.536 WARN  [RES] SQL Server Availability Group: [hadrag] 4/18/2024 23:55:25.0, 21.857418, 3248349184.000000, 0.000000, 0.000253
[Verbose] 000035b8.00001a64::2024/04/18-23:56:35.536 WARN  [RES] SQL Server Availability Group: [hadrag] 4/18/2024 23:55:35.0, 11.442071, 3255394304.000000, 0.000907, 0.000382
[Verbose] 000035b8.00001a64::2024/04/18-23:56:35.536 WARN  [RES] SQL Server Availability Group: [hadrag] 4/18/2024 23:55:45.0, 9.979768, 3253981184.000000, 0.000415, 0.000549
[Verbose] 000035b8.00001a64::2024/04/18-23:56:35.536 WARN  [RES] SQL Server Availability Group: [hadrag] 4/18/2024 23:55:55.0, 9.762850, 3251232768.000000, 0.001989, 0.000638
[Verbose] 000035b8.00001a64::2024/04/18-23:56:35.536 WARN  [RES] SQL Server Availability Group: [hadrag] 4/18/2024 23:56:5.0, 9.827234, 3250462720.000000, 0.002250, 0.001418
Detekce uzlu clusteru a prostředků
Každý uzel v clusteru spouští jednu službu clusteru, která provozuje cluster s podporou převzetí služeb při selhání a monitoruje všechny prostředky clusteru. Hostitel prostředků funguje jako samostatný proces a je rozhraním mezi clusterovou službou a prostředky clusteru. Hostitel prostředků provádí operace s prostředky clusteru při volání službou clusteru. Aplikace pracující s clustery, jako je SQL Server, poskytují vlastní rozhraní monitorování prostředků prostřednictvím knihoven DLL prostředků. Knihovna prostředků DLL implementuje operace online a offline a monitorování stavu u vlastních prostředků. Hostitel prostředku je podřízený proces clusterové služby a je ukončen pokaždé, když je clusterová služba ukončena.
Pro SQL Server knihovna DLL prostředku AG vyhodnocuje stav AG na základě mechanismu lease AG a detekce stavu Always On. Knihovna DLL prostředků AG zpřístupňuje stav prostředku prostřednictvím operace IsAlive. Monitor prostředků se dotazuje na IsAlive v intervalu clusterového heartbeat, který je nastaven hodnotami platnými pro celý cluster CrossSubnetDelay a SameSubnetDelay. Na primárním uzlu clusterová služba zahájí převzetí služeb při selhání pokaždé, když volání knihovny DLL prostředku IsAlive vrátí, že skupina dostupnosti není v dobrém stavu.
Služba clusteru odesílá ostatním uzlům v clusteru signály heartbeat a potvrzuje přijetí signálů heartbeat, které od nich obdrží. Když uzel na základě série nepotvrzených heartbeatů zjistí selhání komunikace, rozešle zprávu, která způsobí, že všechny dosažitelné uzly sjednotí svůj pohled na stav uzlů clusteru. Tato událost, označovaná jako událost regroup, udržuje konzistenci stavu clusteru napříč uzly. Po události opětovného seskupení, pokud dojde ke ztrátě kvora, jsou všechny prostředky clusteru včetně skupin AG v tomto oddílu převedeny do režimu offline. Všechny uzly v tomto oddílu jsou převedeny do stavu řešení. Pokud existuje část clusteru, která má kvorum, AG je přiřazena jednomu uzlu v této části a stane se primární replikou, zatímco všechny ostatní uzly se stanou sekundárními replikami.
Detekce stavu AlwaysOn
Knihovna DLL prostředků AlwaysOn monitoruje stav interních komponent SYSTÉMU SQL Server.
sp_server_diagnostics hlásí stav těchto komponent SQL Serveru v intervalu řízeném HealthCheckTimeout.
sp_server_diagnostics hlásí stav pěti komponent na úrovni instance: systém, prostředek, zpracování dotazů, subsystém io a události. Také uvádí stav jednotlivých skupin dostupnosti. Při každé aktualizaci knihovna DLL prostředků aktualizuje stav funkčnosti prostředku skupiny dostupnosti na základě úrovně selhání skupiny dostupnosti. Když jsou data vrácena funkcí sp_server_diagnostics, každá komponenta se zobrazí buď jako v pořádku, ve stavu upozornění, chyby nebo v neznámém stavu spolu s daty XML, která popisují stav komponenty. Při zjišťování stavu knihovna prostředků DLL provede akci pouze tehdy, pokud je komponenta v chybovém stavu.
Pokud detekce stavu během několika intervalů nenahlásí aktualizaci knihovně DLL prostředku, skupina dostupnosti bude vyhodnocena jako nefunkční a při voláních IsAlive bude hlásit selhání.
Mechanismus zapůjčení
Na rozdíl od jiných mechanismů převzetí služeb při selhání hraje instance SQL Serveru aktivní roli v mechanismu zapůjčení. Mechanismus zapůjčení se používá jako Looks-Alive ověřování mezi hostitelem prostředků clusteru a procesem SQL Serveru. Tento mechanismus se používá k zajištění, že obě strany (služba clusteru a služba SQL Serveru) jsou často v kontaktu, kontrolují stav sebe navzájem a nakonec brání situaci rozděleného mozku. Při přenesení skupiny dostupnosti do režimu online jako primární repliky instance SQL Serveru vytvoří vyhrazené vlákno pracovního procesu zapůjčení skupiny dostupnosti. Pracovní proces zapůjčení sdílí malou oblast paměti s hostitelem prostředků, který obsahuje události obnovení zapůjčení a zastavení zapůjčení. Pracovník zapůjčení a hostitel prostředků pracují cyklickým způsobem, signalizují příslušnou událost prodloužení zapůjčení a pak spí, čekající na to, aby druhá strana signalizovala vlastní událost prodlužování zapůjčení nebo zastavila událost. Hostitel prostředků i vlákno leasingu SQL Serveru udržují hodnotu doby životnosti, která se aktualizuje pokaždé, když se vlákno probudí poté, co je signalizováno druhým vláknem. Pokud je během čekání na signál dosaženo doby životnosti (TTL), lease vyprší a replika pak pro danou konkrétní skupinu dostupnosti přejde do stavu řešení. Pokud je signalizována událost ukončení lease, replika přejde do role řešení.
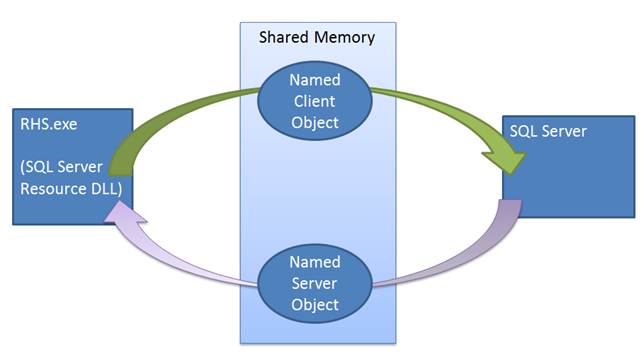
Mechanismus leasingu vynucuje synchronizaci mezi SQL Serverem a clusterem převzetí služeb při selhání systému Windows Server. Po vydání příkazu k převzetí služeb při selhání provede služba clusteru volání Offline na knihovnu DLL prostředku aktuální primární repliky. Knihovna prostředků DLL se nejprve pokusí přepnout skupinu dostupnosti (AG) do režimu offline pomocí uložené procedury. Pokud tato uložená procedura selže nebo vyprší časový limit, zobrazí se chyba zpět do služby clusteru, která pak vydá příkaz ukončení. Operace ukončení se znovu pokusí spustit stejnou uloženou proceduru, ale cluster tentokrát nečeká, až DLL prostředku oznámí úspěch nebo selhání, předtím než uvede skupinu dostupnosti do online stavu na nové replice. Pokud toto druhé volání procedury selže, musí se hostitel prostředků spolehnout na mechanismus pronájmu, aby převedl instanci do režimu offline. Když je knihovna DLL prostředku vyvolána k převedení AG do režimu offline, signalizuje událost ukončení lease, čímž probudí pracovní vlákno lease v SQL Serveru, aby převedlo AG do režimu offline. I když tato událost zastavení není signalizována, platnost pronájmu vyprší a replika přejde do stavu řešení.
Zapůjčení je primárně synchronizační mechanismus mezi primární instancí a clusterem, ale může také vytvořit podmínky selhání, kdy jinak není potřeba převzít služby při selhání. Například vysoké zatížení CPU, stavy nedostatku paměti (málo virtuální paměti, stránkování procesů), situace, kdy proces SQL Serveru při generování výpisu paměti nereaguje, kdy systém nereaguje nebo kdy cluster (WSFC) přejde do režimu offline (například kvůli ztrátě kvora), mohou zabránit obnovení leasingu z instance SQL a způsobit restart nebo převzetí služeb při selhání.
Pokyny pro hodnoty časového limitu clusteru
Pečlivě zvažte kompromisy a seznamte se s důsledky použití méně agresivního monitorování clusteru SQL Serveru. Zvýšení hodnot časového limitu clusteru zvyšuje odolnost vůči přechodným problémům se sítí, ale zpomaluje reakce na těžké selhání. Zvýšení časových limitů kvůli nedostatku prostředků nebo vysoké latenci způsobené geografickou vzdáleností také prodlouží dobu zotavení po závažných selháních nebo selháních, ze kterých se nelze zotavit. I když je to přijatelné pro mnoho aplikací, není to ideální ve všech případech.
Výchozí nastavení jsou optimalizovaná pro rychlé reakce na příznaky těžkých selhání a omezení výpadků, ale tato nastavení můžou být pro určité úlohy a konfigurace příliš agresivní. Nedoporučuje se snižovat některou z hodnot LeaseTimeout, CrossSubnetDelay, CrossSubnetThreshold, SameSubnetDelay, SameSubnetThreshold nebo HealthCheckTimeout pod jejich výchozí hodnoty. Správná nastavení pro každé nasazení se liší a zjišťování pravděpodobně trvá delší dobu. Při provádění změn některé z těchto hodnot je proveďte postupně a s ohledem na vztahy a závislosti mezi těmito hodnotami.
Vztah mezi vypršením časového limitu clusteru a vypršením časového limitu zapůjčení
Primární funkcí mechanismu zapůjčení je převést prostředek SQL Serveru do offline režimu, pokud služba clusteru nemůže komunikovat s instancí při převzetí služeb při selhání do jiného uzlu. Když cluster převede prostředek clusteru AG do offline stavu, služba clusteru odešle službě rhs.exe volání RPC, aby prostředek převedla do offline stavu. Knihovna DLL prostředku používá uložené procedury k tomu, aby SQL Serveru sdělila, že má přepnout AG do offline režimu, ale tato uložená procedura může selhat nebo může dojít k vypršení časového limitu. Hostitel prostředku také během volání pro přepnutí do offline režimu zastaví vlastní vlákno pro obnovování lease. V nejhorším případě SQL Server způsobí, že pronájem vyprší za ½ * LeaseTimeout a instance přejde do stavu resolving. Převzetí služeb při selhání může být iniciováno několika různými stranami, ale je naprosto zásadní, aby pohled na stav clusteru byl konzistentní napříč clusterem i ve všech instancích SQL Serveru. Představte si například scénář, kdy primární instance ztratí připojení ke zbytku clusteru. Každý uzel v clusteru detekuje selhání přibližně ve stejnou dobu kvůli hodnotám časových limitů clusteru, ale pouze primární uzel může komunikovat s primární instancí SQL Serveru a přinutit ji vzdát se primární role.
Z pohledu primárního uzlu služba clusteru ztratila kvorum a služba se začne ukončovat. Služba clusteru vydá volání RPC hostiteli prostředků za účelem ukončení procesu. Tento příkaz terminate slouží k převedení skupiny dostupnosti (AG) do offline režimu v instanci SQL Serveru. Toto offline volání se provádí prostřednictvím jazyka T-SQL, ale nelze zaručit, že připojení mezi SQL a DLL knihovnou prostředků bude úspěšně navázáno.
Z pohledu zbytku clusteru aktuálně neexistuje žádná primární replika, takže cluster hlasuje a vytvoří jeden nový primární pro zbývající uzly v clusteru. Pokud uložená procedura volaná knihovnou prostředků DLL selže nebo dojde k vypršení časového limitu, cluster může být náchylný ke scénáři split-brain.
Časový limit pronájmu zabraňuje scénářům typu split-brain při komunikačních chybách. I když veškerá komunikace selže, proces knihovny prostředků DLL se ukončí a nebude moci aktualizovat pronájem. Jakmile vyprší platnost lease, AG automaticky přejde do offline režimu. Instance SQL Serveru musí mít na paměti, že už není hostitelem primární repliky, než cluster vytvoří novou repliku. Vzhledem k tomu, že zbytek clusteru, který je zodpovědný za volbu nové primární repliky, nemá žádný způsob koordinace s aktuální primární replikou, hodnoty časového limitu zajistí, že se nová primární replika nenaváže předtím, než se aktuální primární server přenese do offline režimu.
Když dojde k převzetí služeb clusteru při selhání, instance serveru SQL Server, která hostí předchozí primární repliku, musí přejít do stavu resolving, než nová primární replika přejde do online stavu. Vlákno lease v SQL Serveru má v libovolném okamžiku zbývající dobu životnosti 1/2 * LeaseTimeout, protože při každém obnovení lease se nová doba životnosti aktualizuje na hodnotu LeaseInterval, tedy 1/2 * LeaseTimeout. Pokud služba clusteru nebo hostitel prostředků zastaví nebo ukončí bez signalizace události zastavení zapůjčení, cluster bude po milisekundách deklarovat neaktivní SameSubnetThreshold\ SameSubnetDelay primární uzel. Během této doby musí lease vypršet, aby bylo zaručeno, že primární je offline. Protože maximální doba životnosti pro časový limit pronájmu je ½ * LeaseTimeout, ½ * LeaseTimeout musí být menší než SameSubnetThreshold * SameSubnetDelay.
SameSubnetThreshold \<= CrossSubnetThreshold a SameSubnetDelay \<= CrossSubnetDelay měl by být pravdivý pro všechny clustery SQL Serveru.
Operace vypršení časového limitu kontroly stavu
Časový limit kontroly stavu lze nastavit flexibilněji, protože na něm přímo nezávisí žádný jiný mechanismus přepnutí při selhání. Výchozí hodnota 30 sekund nastavuje interval sp_server_diagnostics na 10 sekund, přičemž minimální hodnota časového limitu je 15 sekund a interval je 5 sekund. Obecně platí, že sp_server_diagnostics interval aktualizace je vždy 1/3 * HealthCheckTimeout. Pokud knihovna DLL prostředků během daného intervalu neobdrží novou sadu dat o stavu, bude i nadále používat data o stavu z předchozího intervalu k určení aktuálního stavu AG a instance. Zvýšení hodnoty časového limitu kontroly stavu činí primární uzel tolerantnějším vůči zatížení CPU, které může bránit tomu, aby sp_server_diagnostics v jednotlivých intervalech poskytoval nová data, současně se však po delší dobu spoléhá na kontroly stavu založené na zastaralých datech. Bez ohledu na hodnotu časového limitu platí, že jakmile jsou přijata data indikující, že replika není v pořádku, další volání IsAlive vrátí informaci, že instance není v pořádku, a clusterová služba zahájí převzetí služeb při selhání.
Úroveň podmínek selhání AG mění podmínky selhání kontroly stavu. Při jakékoli úrovni selhání platí, že pokud je prvek AG komponentou sp_server_diagnostics nahlášen jako nefunkční, kontrola stavu selže. Každá úroveň dědí všechny podmínky selhání z úrovní pod ní.
| Úroveň | Podmínka, pod kterou je instance považována za mrtvou |
|---|---|
| 1: OnServerDown | Kontrola stavu neprovede žádnou akci, pokud selže jakýkoli prostředek kromě AG. Pokud data skupiny dostupnosti nejsou přijata během 5 intervalů nebo 5/3 * HealthCheckTimeout |
| 2: OnServerNereaguje | Pokud nejsou z sp_server_diagnostics během časového limitu HealthCheckTimeout přijata žádná data |
| 3: OnCriticalServerError | (Výchozí) Pokud systémová komponenta hlásí chybu |
| 4: OnModerateServerError | Pokud komponenta prostředků hlásí chybu |
| 5: PřiJakýchkoliKvalifikovanýchPodmínkáchSelhání | Pokud komponenta zpracování dotazů hlásí chybu |
Aktualizace hodnot časového limitu clusteru a AlwaysOn
Hodnoty clusteru
V konfiguraci WSFC jsou čtyři hodnoty, které zodpovídají za určení hodnot časového limitu clusteru:
- ZpožděníStejnéPodsítě
- Prahová hodnota pro stejnou podsíť
- Zpoždění mezi podsítěmi
- HranicePropojeníMezisubnety
Hodnoty zpoždění určují dobu čekání mezi signály heartbeat z clusterové služby a prahové hodnoty nastavují počet signálů heartbeat, u nichž může chybět potvrzení od cílového uzlu nebo prostředku, než cluster objekt prohlásí za nefunkční. Pokud mezi uzly ve stejné podsíti nedojde k úspěšnému signálu heartbeat po dobu delší než SameSubnetDelay \* SameSubnetThreshold milisekund, uzel je považován za nefunkční. Totéž platí pro komunikaci mezi podsítěmi pomocí hodnot mezi podsítěmi.
Pokud chcete zobrazit seznam všech aktuálních hodnot clusteru, otevřete na libovolném uzlu v cílovém clusteru terminál PowerShellu se zvýšenými oprávněními. Spusťte následující příkaz:
Get-Cluster | fl *
Pokud chcete aktualizovat některou z těchto hodnot, spusťte v terminálu PowerShellu se zvýšenými oprávněními následující příkaz:
(Get-Cluster).<ValueName> = <NewValue>
Pokud zvyšujete součin zpoždění a prahové hodnoty, aby byl časový limit clusteru tolerantnější, je účinnější nejprve zvýšit hodnotu zpoždění, než zvýšíte prahovou hodnotu. Zvýšením zpoždění se prodlouží interval mezi jednotlivými prezenčními signály. Delší doba mezi heartbeaty dává přechodným problémům se sítí více času, aby se samy vyřešily, a snižuje přetížení sítě ve srovnání s odesíláním většího počtu heartbeatů ve stejném časovém úseku.
Časový limit zapůjčení
Mechanismus pronájmu je řízen jedinou hodnotou specifickou pro každou skupinu dostupnosti (AG) v clusteru WSFC. Časový limit zapůjčení může vést k následujícím chybám:
Error 35201:
A connection timeout has occurred while attempting to establish a connection to availability replica 'replicaname'
Error 35206:
A connection timeout has occurred on a previously established connection to availability replica 'replicaname'
Pokud chcete upravit hodnotu časového limitu zapůjčení, použijte Správce clusteru s podporou převzetí služeb při selhání a postupujte takto:
Na kartě Role vyhledejte cílovou roli AG. Vyberte cílovou roli AG.
Klikněte pravým tlačítkem myši na prostředek AG ve spodní části okna a vyberte Vlastnosti.
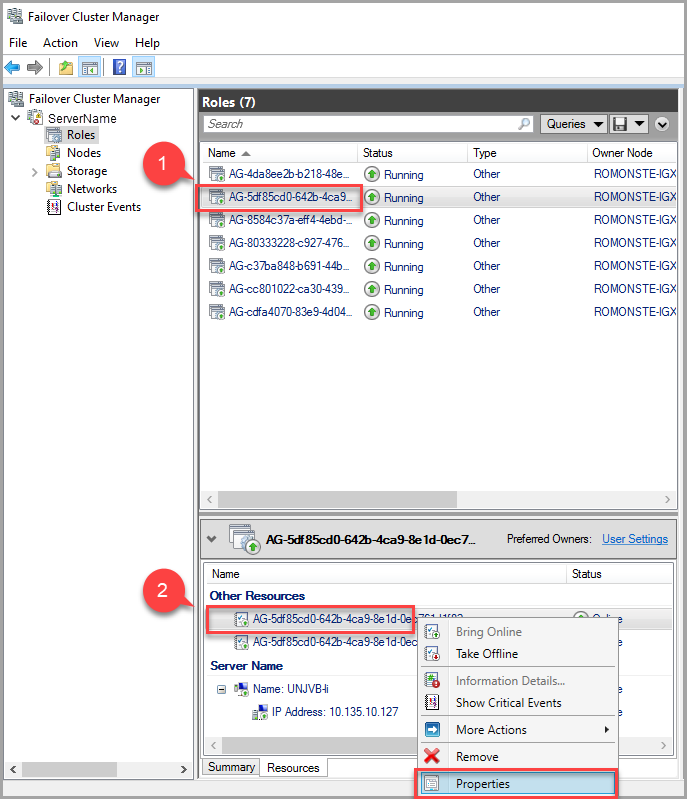
V automaticky otevíraném okně přejděte na kartu Vlastnosti, chcete-li zobrazit seznam hodnot specifických pro tuto AG. Vyberte hodnotu LeaseTimeout a změňte ji.
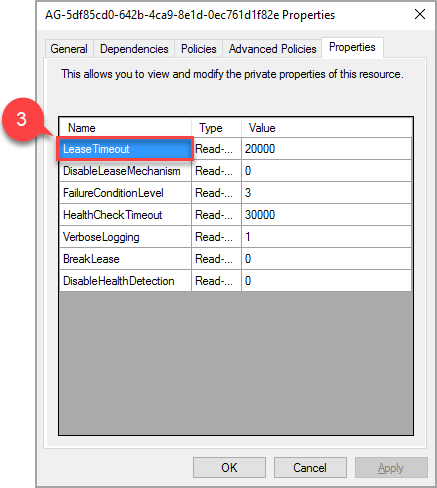
V závislosti na konfiguraci skupiny dostupnosti mohou být k dispozici další prostředky pro naslouchače, sdílené disky, sdílené složky atd.; tyto prostředky nevyžadují žádnou další konfiguraci.
Poznámka:
Nová hodnota vlastnosti LeaseTimeout se projeví poté, co se prostředek přenese do offline režimu a znovu se přenese do režimu online.
Hodnoty kontroly stavu
Dvě hodnoty řídí kontrolu stavu AlwaysOn: FailureConditionLevel a HealthCheckTimeout. FailureConditionLevel označuje úroveň tolerance vůči konkrétním podmínkám selhání hlášeným komponentou sp_server_diagnostics a HealthCheckTimeout určuje dobu, po kterou může knihovna DLL prostředků fungovat, aniž by obdržela aktualizaci od sp_server_diagnostics. Interval sp_server_diagnostics aktualizace je vždy HealthCheckTimeout / 3.
Pro nastavení úrovně podmínky převzetí služeb při selhání použijte volbu FAILURE_CONDITION_LEVEL = <n> v příkazu CREATE nebo ALTERAVAILABILITY GROUP, kde <n> je celé číslo v rozmezí od 1 do 5. Následující příkaz nastaví úroveň podmínky selhání na 1 pro AG1:
ALTER AVAILABILITY GROUP AG1 SET (FAILURE_CONDITION_LEVEL = 1);
Chcete-li nakonfigurovat časový limit kontroly stavu, použijte volbu HEALTH_CHECK_TIMEOUT příkazů CREATE nebo ALTERAVAILABILITY GROUP. Následující příkaz nastaví časový limit kontroly stavu na 60 000 milisekund pro ag1:
ALTER AVAILABILITY GROUP AG1 SET (HEALTH_CHECK_TIMEOUT =60000);
Shrnutí pokynů k časovým limitům
Snížení všech hodnot časového limitu pod jejich výchozí hodnoty se nedoporučuje.
Interval pronájmu (½ * LeaseTimeout) musí být kratší než SameSubnetThreshold * SameSubnetDelay.
SameSubnetThreshold <= CrossSubnetThreshold
SameSubnetDelay <= CrossSubnetDelay
| Nastavení časového limitu | Účel | Mezi | Použití | JeŽivý a Vypadá Živě | Příčiny | Výsledek |
|---|---|---|---|---|---|---|
| Časový limit zapůjčení Výchozí hodnota: 20000 |
Zabránit rozdělení mozku | Primární do clusteru (HADR) |
Objekty událostí Systému Windows | Používá se v obou | Operační systém nereaguje, nedostatek virtuální paměti, stránkování pracovní sady, generování výpisu paměti, procesor vytížený na maximum, WSFC mimo provoz (ztráta kvora) | Prostředek AG offline-online, převzetí služeb při selhání |
| Časový limit relace Výchozí hodnota: 10000 |
Informovat o problému s komunikací mezi primárním a sekundárním | Sekundární na primární (HADR) |
Sockety TCP (zprávy odeslané přes endpoint DBM) | Nepoužívá se ani v jednom z nich | Síťová komunikace, Problémy na sekundárním uzlu – nedostupný, OS nereaguje, konflikt o prostředky |
Sekundární – ODPOJENO |
| Časový limit kontroly stavu Výchozí hodnota: 30000 |
Určení časového limitu při pokusu o zjištění stavu primární repliky | Cluster na primární uzel (FCI & HADR) |
T-SQL sp_server_diagnostics | Používá se v obou | Nastaly podmínky selhání, operační systém nereaguje, nedostatek virtuální paměti, omezení pracovní sady, generování výpisu paměti, WSFC (ztráta kvora), problémy s plánovačem (zablokované plánovače) | Prostředek skupiny dostupnosti offline–online nebo převzetí služeb při selhání, restartování nebo převzetí služeb při selhání FCI |