Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
platí pro: SQL Server 2016 (13.x) a novější verze
Toto je tutoriál číslo 8 ze série RevoScaleR o tom, jak používat funkce RevoScaleR se SQL Server.
V tomto tutoriálu použijete logistický regresní model, který jste vytvořili v předchozím tutoriálu, k ohodnocení další datové sady, která používá stejné nezávislé proměnné jako vstupy.
- Skóre nových dat
- Vytvořte histogram skóre
Poznámka:
Pro některé z těchto kroků potřebujete administrátorská práva DDL.
Generování a ukládání skóre
Aktualizujte datový zdroj sqlScoreDS (vytvořený v tutoriálu dva) tak, aby používal sloupcové informace vytvořené v předchozím tutoriálu.
sqlScoreDS <- RxSqlServerData(
    connectionString = sqlConnString,
    table = sqlScoreTable,
    colInfo = ccColInfo,
    rowsPerRead = sqlRowsPerRead)
Abyste se ujistili, že výsledky neztratíte, vytvořte nový objekt datového zdroje. Poté použijte nový objekt zdroje dat k naplnění nové tabulky v databázi RevoDeepDive.
sqlServerOutDS <- RxSqlServerData(table = "ccScoreOutput",
    connectionString = sqlConnString,
    rowsPerRead = sqlRowsPerRead )
V tuto chvíli tabulka ještě nebyla vytvořena. Toto tvrzení pouze definuje kontejner pro data.
Zkontrolujte aktuální výpočetní kontext pomocí rxGetComputeContext() a pokud je potřeba, nastavte výpočetní kontext na server.
rxSetComputeContext(sqlCompute)Pro jistotu zkontrolujte existenci výstupní tabulky. Pokud už existuje tabulka se stejným názvym, při pokusu o zápis nové tabulky dostanete chybu.
K tomu zavolejte funkce rxSqlServerTableExists a rxSqlServerDropTable, přičemž jako vstup předáte název tabulky.
if (rxSqlServerTableExists("ccScoreOutput")) rxSqlServerDropTable("ccScoreOutput")- rxSqlServerTableExists dotáže ovladač ODBC a vrátí hodnotu PRAVDA, pokud tabulka existuje, v opačném případě hodnotu NEPRAVDA.
- rxSqlServerDropTable spustí DDL a vrátí TRUE, pokud je tabulka úspěšně odstraněna, jinak FALSI.
Spuskutěte rxPredict pro vytvoření skóre a uložite je do nové tabulky definované v datovém zdroji sqlScoreDS.
rxPredict(modelObject = logitObj,
    data = sqlScoreDS,
    outData = sqlServerOutDS,
    predVarNames = "ccFraudLogitScore",
      type = "link",
    writeModelVars = TRUE,
    overwrite = TRUE)
Funkce rxPredict je další funkcí, která podporuje běh v vzdálených výpočetních kontextech. Funkci rxPredict můžete použít k vytvoření skóre z modelů založených na rxLinMod, rxLogit nebo rxGlm.
Parametr writeModelVars je zde nastaven na TRUE . To znamená, že proměnné použité pro odhad budou zahrnuty v nové tabulce.
Parametr predVarNames určuje proměnnou, do které budou výsledky uloženy. Zde předáte novou proměnnou,
ccFraudLogitScore.Parametr typupro rxPredict určuje, jak chcete vypočítat predikce. Specifikujte odpověď na klíčové slovo, abyste generovali skóre na základě škály proměnné odpovědi. Nebo použijte klíčové slovo odkaz k generování skóre na základě základní funkce odkazu, v takovém případě jsou predikce vytvářeny pomocí logistické škály.
Po nějaké době můžete v Management Studiu obnovit seznam tabulek a vidět novou tabulku a její data.
Pro přidání dalších proměnných do výstupních predikcí použijte argument extraVarsToWrite . Například v následujícím kódu je proměnná custID přidána z tabulky skórovacích dat do výstupní tabulky predikcí.
rxPredict(modelObject = logitObj,
        data = sqlScoreDS,
        outData = sqlServerOutDS,
        predVarNames = "ccFraudLogitScore",
          type = "link",
        writeModelVars = TRUE,
        extraVarsToWrite = "custID",
        overwrite = TRUE)
Zobrazit skóre v histogramu
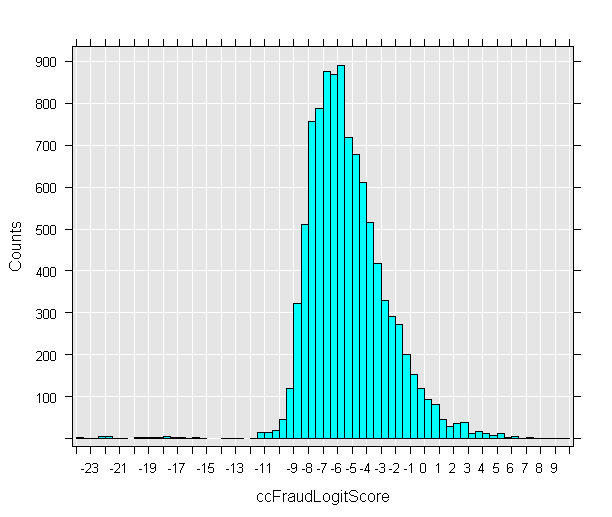
Po vytvoření nové tabulky vypočítejte a zobrazte histogram 10 000 předpovězených skóre. Výpočet je rychlejší, pokud zadáte nízké a vysoké hodnoty, takže je získávejte z databáze a přidejte je do svých pracovních dat.
Vytvořte nový datový zdroj, sqlMinMax, který dotazuje databázi a získává nízké a vysoké hodnoty.
sqlMinMax <- RxSqlServerData(
    sqlQuery = paste("SELECT MIN(ccFraudLogitScore) AS minVal,",
    "MAX(ccFraudLogitScore) AS maxVal FROM ccScoreOutput"),
    connectionString = sqlConnString)
Z tohoto příkladu vidíte, jak snadné je použít zdrojové objekty RxSqlServerData k definování libovolných datových sad na základě SQL dotazů, funkcí nebo uložených procedur a pak je použít ve svém R kódu. Proměnná neukládá skutečné hodnoty, pouze definici zdroje dat; dotaz se vykoná tak, aby generoval hodnoty, pouze když jej použijete v funkci jako rxImport.
Zavolejte funkci rxImport , která umístí hodnoty do datového rámce, který lze sdílet napříč výpočetními kontexty.
minMaxVals <- rxImport(sqlMinMax)
minMaxVals <- as.vector(unlist(minMaxVals))
Results
> minMaxVals

[1] -23.970256   9.786345
Nyní, když jsou k dispozici maximální a minimální hodnoty, použijte tyto hodnoty k vytvoření dalšího zdroje dat pro generovaná skóre.
sqlOutScoreDS <- RxSqlServerData(sqlQuery = "SELECT ccFraudLogitScore FROM ccScoreOutput",
    connectionString = sqlConnString,
    rowsPerRead = sqlRowsPerRead,
        colInfo = list(ccFraudLogitScore = list(
            low = floor(minMaxVals[1]),
                    high = ceiling(minMaxVals[2]) ) ) )
Použijte objekt zdrojů dat sqlOutScoreDS pro získání skóre a vypočítejte a zobrazte histogram. Přidejte kód pro nastavení výpočetního kontextu, pokud je to potřeba.
# rxSetComputeContext(sqlCompute)
rxHistogram(~ccFraudLogitScore, data = sqlOutScoreDS)
Results