Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
Platí na: SQL Server 2016 (13.x) a novější verze Azure SQL DatabaseAzure SQL Managed InstanceSQL database in Microsoft Fabric
Systemově verzovaná časová tabulka uchovává všechny předchozí verze každého řádku ve své historické tabulce. Tabulka historie může zvětšit velikost vaší databáze více než běžné tabulky za následujících podmínek:
- Historická data uchováváte po dlouhou dobu.
- Používáte vzor úprav dat s častými aktualizacemi nebo odstraňováním dat.
Velká, neustále rostoucí tabulka historie by mohla být problémem, a to jak kvůli nákladům na skladování, tak kvůli dani z výkonu, kterou ukládá časovým dotazům. Vytvoření politiky uchovávání dat pro historickou tabulku je důležitou součástí plánování a řízení životního cyklu každé časové tabulky.
Naplánujte politiku uchovávání dat
Pro řízení uchovávání dat v časové tabulce nejprve určte požadovanou dobu uchovávání pro každou časovou tabulku. Vaše politika uchovávání by ve většině případů měla být součástí obchodní logiky aplikace, která časové tabulky používá. Například aplikace v auditu dat a scénářích cestování časem mají pevné požadavky na to, jak dlouho musí být historická data dostupná pro online dotazování.
Poté, co určíte dobu uchovávání dat, vypracujte plán správy historických dat. Rozhodněte se, jak a kam ukládáte historická data a jak odstranit historická data, která jsou starší než vaše požadavky na uchovávání informací.
Každý přístup v tomto článku funguje na sloupci odpovídající konci období v aktuální tabulce, což je sloupec ValidTo v následujících příkladech. Hodnota konce období pro každý řádek určuje okamžik, kdy se verze řádku změní na uzavřená, tj. když se zobrazí v tabulce historie. Například stav ValidTo < DATEADD (DAY, -30, SYSUTCDATETIME()) odpovídá historickým údajům starým více než 30 dní.
Vyberte jeden z následujících způsobů, jak s těmito řádky naložit:
| Approach | Jak to funguje | Kdy ji použít |
|---|---|---|
| Politika uchovávání časové historie | Nastavíte dobu uchovávání pro každou tabulku a úkol na pozadí automaticky smaže zastaralé řádky. | Nejjednodušší možností je, když můžete vymazat starou historii úplně. |
| Dělení tabulek | Posuvné okno přesune nejstarší oddíl z historické tabulky, takže ho můžete archivovat nebo odstranit. | Když chcete archivovat historická data před jejich odstraněním nebo využít vyřazování oddílů pro temporální dotazy. |
| Vlastní skript pro čištění | Plánovaný skript deaktivuje systémové verzování, maže zastaralé řádky v malých částech a poté znovu povoluje systémové verzování. | Když pro vaši tabulku nejsou k dispozici zásady uchovávání a dělení na oddíly není možné. |
Příklady rozdělení a vlastního vyčištění v tomto článku používají ukázky z článku Create a system-versioned temporal table.
Používejte politiku uchovávání časové historie
Platí na: SQL Server 2017 (14.x) a novější verze, Azure SQL Database, Azure SQL Managed Instance a SQL databázi v Microsoft Fabric.
Uchovávání časové historie můžete nastavit na úrovni jednotlivých tabulek, což vám umožní vytvářet flexibilní politiky stárnutí. Pro umožnění časové retentace nastavte HISTORY_RETENTION_PERIOD při vytváření tabulky nebo při změně schématu.
Po definování politiky zadržení spustí Database Engine plánovanou úlohu na pozadí, která najde a transparentně odstraní historické řádky, jejichž hodnota na konci období je starší než doba zadržování.
Konfigurace zásad uchovávání informací
Před konfigurací zásad uchovávání informací pro dočasnou tabulku zkontrolujte, jestli je povolené dočasné historické uchovávání na úrovni databáze:
SELECT is_temporal_history_retention_enabled,
       name
FROM sys.databases;
Databázový příznak is_temporal_history_retention_enabled je výchozí na , ONale můžete ho změnit pomocí příkazu ALTER DATABASE . Databázový stroj ji také automaticky nastaví po operaci OFF obnovení k určitému bodu v čase (PITR), jak je popsáno v části informace o obnovení k určitému bodu v čase. Pokud chcete pro vaši databázi aktivovat vyčištění uchovávání časové historie, spusťte následující příkaz. Nahraďte <myDB> databází, kterou chcete upravit:
ALTER DATABASE [<myDB>]
    SET TEMPORAL_HISTORY_RETENTION ON;
Important
Retenci pro časové tabulky můžete nastavit i když is_temporal_history_retention_enabled je , OFFale Database Engine v takovém případě nespouští automatické čištění pro starší řádky.
Politiku zadržování můžete nastavit při vytváření tabulky zadáním hodnoty parametru HISTORY_RETENTION_PERIOD :
CREATE TABLE dbo.WebsiteUserInfo
(
    UserID INT NOT NULL PRIMARY KEY CLUSTERED,
    UserName NVARCHAR (100) NOT NULL,
    PagesVisited INT NOT NULL,
    ValidFrom DATETIME2 (0) GENERATED ALWAYS AS ROW START,
    ValidTo DATETIME2 (0) GENERATED ALWAYS AS ROW END,
    PERIOD FOR SYSTEM_TIME (ValidFrom, ValidTo)
)
WITH (
    SYSTEM_VERSIONING = ON (
        HISTORY_TABLE = dbo.WebsiteUserInfoHistory,
        HISTORY_RETENTION_PERIOD = 6 MONTHS
    )
);
Po zavedení této zásady řádky v dbo.WebsiteUserInfoHistory splňují podmínky pro vyčištění, když splňují následující podmínku:
ValidTo < DATEADD (MONTH, -6, SYSUTCDATETIME())
Periodu zadržení můžete specifikovat v DAYS, WEEKS, MONTHS, nebo YEARS. Pokud vynecháte HISTORY_RETENTION_PERIOD, doba uchování je ve výchozím nastavení INFINITE. Klíčové slovo INFINITE můžete také použít explicitně.
V některých případech můžete chtít nastavit uchovávání po vytvoření tabulky nebo změnit dříve nastavenou hodnotu. V takovém případě použijte příkaz ALTER TABLE:
ALTER TABLE dbo.WebsiteUserInfo
    SET (SYSTEM_VERSIONING = ON (HISTORY_RETENTION_PERIOD = 9 MONTHS));
Important
Nastavení SYSTEM_VERSIONING na OFF nezachovává hodnotu doby udržení. Nastavení SYSTEM_VERSIONING na ON bez explicitního HISTORY_RETENTION_PERIOD vede k zachování INFINITE.
Pokud chcete zkontrolovat aktuální stav zásad uchovávání informací, použijte následující ukázku. Tento dotaz spojí příznak dočasného uchovávání informací na úrovni databáze s obdobími uchovávání pro jednotlivé tabulky:
SELECT DB.is_temporal_history_retention_enabled,
       SCHEMA_NAME(T1.schema_id) AS TemporalTableSchema,
       T1.name AS TemporalTableName,
       SCHEMA_NAME(T2.schema_id) AS HistoryTableSchema,
       T2.name AS HistoryTableName,
       T1.history_retention_period,
       T1.history_retention_period_unit_desc
FROM sys.tables AS T1
    OUTER APPLY (
        SELECT is_temporal_history_retention_enabled
        FROM sys.databases
        WHERE name = DB_NAME()
) AS DB
    LEFT OUTER JOIN sys.tables AS T2
        ON T1.history_table_id = T2.object_id
WHERE T1.temporal_type = 2;
Odstranění starých řádků databázovým strojem
Proces čištění závisí na rozložení indexu tabulky historie. Politiku konečného uchovávání lze nastavit pouze na tabulkách historie s clusterovaným úložištěm řádků (B-strom) nebo indexem shlukovaného úložiště sloupců. Úloha na pozadí provádí čištění starých dat pro všechny časové tabulky s konečnou periodou uchovávání.
Note
Dokumentace používá termín B-tree obecně v odkazu na indexy. V indexech rowstore databázový stroj implementuje strom B+. To neplatí pro indexy columnstore ani indexy v tabulkách optimalizovaných pro paměť. Další informace najdete v SQL Serveru a architektuře indexu Azure SQL a průvodci návrhem.
index B-tree pro řádkové úložiště
Clusterovaný rowstore index musí mít jako první sloupec sloupec odpovídající konci periody SYSTEM_TIME. Pokud takový index neexistuje, nelze nastavit konečnou dobu zadržování:
Msg 13765, Level 16, State 1
Setting finite retention period failed on system-versioned temporal table
'dbo.WebsiteUserInfo' because the history table 'dbo.WebsiteUserInfoHistory'
does not contain required clustered index. Consider creating a clustered
columnstore or B-tree index starting with the column that matches end of
SYSTEM_TIME period, on the history table.
Výchozí tabulka historie již obsahuje kompatibilní shlukovaný index. Pokud se pokusíte tento index přenést do tabulky historie s konečnou periodou zadržení, operace selže s následující chybou:
Msg 13766, Level 16, State 1
Cannot drop the clustered index 'WebsiteUserInfoHistory.IX_WebsiteUserInfoHistory'
because it is being used for automatic cleanup of aged data. Consider setting HISTORY_RETENTION_PERIOD to INFINITE on the corresponding system-versioned
temporal table if you need to drop this index.
Logika čištění pro clusterovaný index rowstore maže zastaralé řádky v menších částech (až do 10 000), čímž minimalizuje tlak na databázový log a I/O subsystém. Ačkoli logika čištění používá požadovaný index typu B-tree, nemůže zaručit pořadí mazání u řádků starších než doba uchovávání. V aplikacích nespoléhejte na pořadí úklidu.
Clusterovaný sloupcový index
Úkol čištění pro clusterovaný columnstore odstraní najednou celé skupiny řádků . Každá skupina řádků obvykle obsahuje jeden milion řádků. Tato metoda je efektivnější, zvláště když vaše pracovní zátěž generuje historická data vysokou rychlostí.
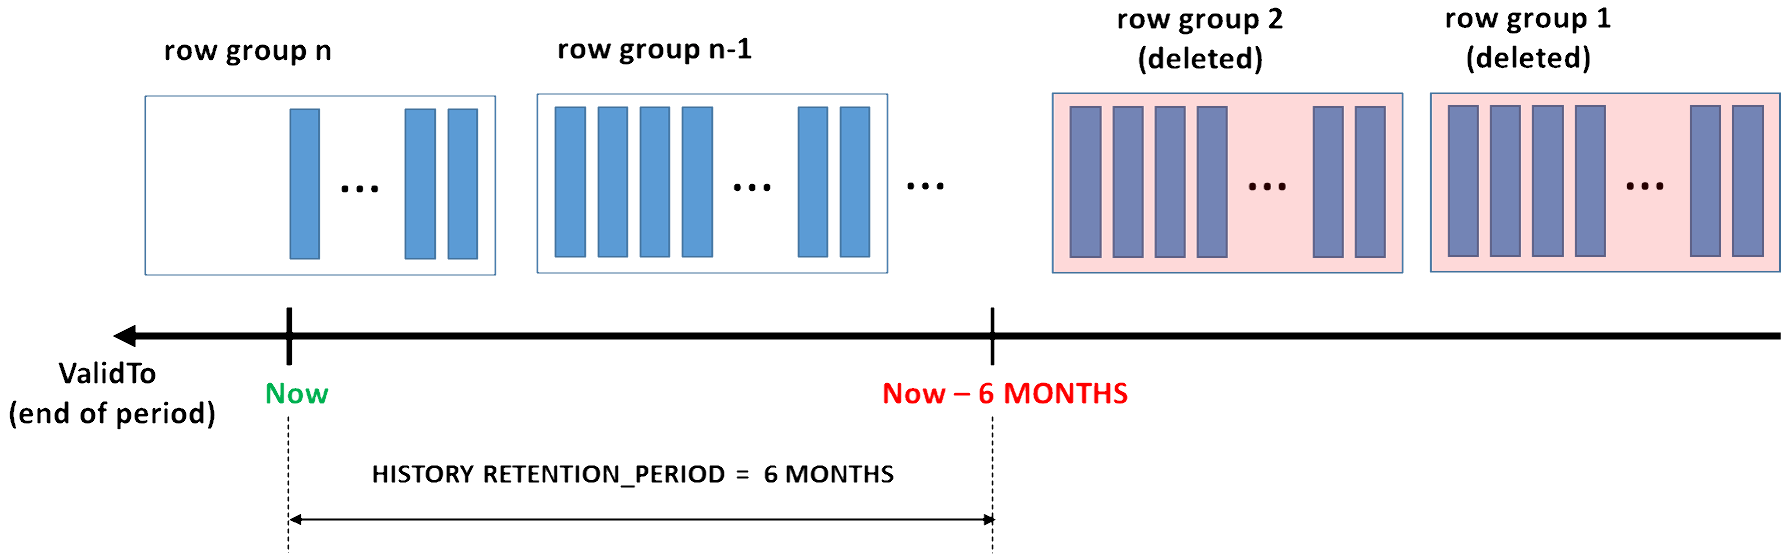
Komprese dat a čištění při uchovávání dat činí z clusterovaného sloupcového indexu vhodnou volbu pro scénáře, kdy pracovní zátěž rychle generuje velké množství historických dat. Tento vzorec je typický pro intenzivní transakční zpracování, která využívají časové tabulky pro sledování změn a audit, analýzu trendů nebo sběr dat z Internetu věcí (IoT).
Čištění indexu clustered columnstore funguje optimálně, když historické řádky dorazí vzestupně (seřazeny podle sloupce na konci období). Tato podmínka platí vždy, když se do tabulky historie objevuje pouze mechanismus SYSTEM_VERSIONING . Pokud řádky v tabulce historie nejsou seřazeny podle sloupce end-of-period (což se může stát při migraci existujících historických dat), znovu vytvořte clusterovaný sloupcový index nad správně seřazeným řádkovým indexem typu B-tree, abyste dosáhli optimálního výkonu.
Vyhněte se přestavbě indexu clustered columnstore na historické tabulce s konečnou periodou uchovávání, protože přestavba by mohla změnit pořadí skupin řádků, které operace systémového verzování přirozeně ukládá. Pokud potřebujete znovu vytvořit index clustered columnstore v tabulce historie, vytvořte jej znovu nad kompatibilním indexem B-stromu, abyste zachovali pořadí skupin řádků potřebné pro pravidelné čištění dat. Stejný přístup zvolíte, pokud vytvoříte časovou tabulku s existující tabulkou historie, která má shlukovaný index columnstore bez zaručeného pořadí dat:
/* Create B-tree ordered by the end-of-period column */
CREATE CLUSTERED INDEX IX_WebsiteUserInfoHistory
    ON WebsiteUserInfoHistory(ValidTo) WITH (DROP_EXISTING = ON);
GO

/* Re-create the clustered columnstore index */
CREATE CLUSTERED COLUMNSTORE INDEX IX_WebsiteUserInfoHistory
    ON WebsiteUserInfoHistory WITH (DROP_EXISTING = ON);
Když pro tabulku historie s clustered columnstore indexem nastavíte omezenou dobu uchovávání, nemůžete v této tabulce vytvořit další neclusterované indexy B-tree:
CREATE NONCLUSTERED INDEX IX_WebHistNCI
    ON WebsiteUserInfoHistory(UserName);
Předchozí tvrzení selhává s následující chybou:
Msg 13772, Level 16, State 1
Cannot create non-clustered index on a temporal history table 'WebsiteUserInfoHistory' since it has finite retention period and clustered columnstore index defined.
Dotazování tabulek pomocí zásad uchovávání informací
Všechny dotazy v časové tabulce automaticky filtrují historické řádky, které odpovídají politice konečného uchovávání, aby se předešlo nepředvídatelným a nekonzistentním výsledkům. Úkol úklidu maže zastaralé řádky kdykoli a v libovolném pořadí.
Následující screenshot ukazuje plán dotazu pro základní dotaz. Tento příklad předpokládá jednoMONTHdenní dobu uchovávání u tabulky WebsiteUserInfo:
SELECT *
FROM dbo.WebsiteUserInfo FOR SYSTEM_TIME ALL;
Plán dotazu zahrnuje dodatečný filtr na sloupci na konci období (ValidTo) v operátoru Clustered Index Scan (zvýrazněném na následujícím obrázku) v tabulce historie.

Pokud dotazujete přímo do tabulky historie, můžete vidět řádky starší než je zadaná doba zadržení, ale bez záruky opakovatelných výsledků dotazů. Následující screenshot ukazuje plán dotazu pro dotaz v tabulce historie bez dalších filtrů:

Nespoléhejte se na obchodní logiku, která přečte tabulku historie po uplynutí doby udržení, protože můžete dosáhnout nekonzistentních nebo nečekaných výsledků. Používejte časové dotazy s klauzulí FOR SYSTEM_TIME k analýze dat v časových tabulkách.
Aspekty obnovení k určitému bodu v čase
Když obnovíte databázi do konkrétního časového bodu, nová databáze má na úrovni databáze vypnutou časovou retenci (is_temporal_history_retention_enabled nastaveno na OFF). Toto chování vám umožní zkontrolovat historické řádky starší než nastavená doba uchovávání dříve, než je odstraní úloha čištění. Pro obnovení automatického čištění obnovené databáze nastavte TEMPORAL_HISTORY_RETENTION zpět na ON.
Note
Databáze vytvořená v prémiové úrovni Azure SQL Database uchovává zálohy až 35 dní, takže ji můžete obnovit do určitého okamžiku kdekoli v tomto okně. U časové tabulky s jednoměsíční dobou uchovávání vám to umožní prohlížet historické řádky staré až 65 dní pomocí přímého dotazování na tabulku historie v obnovené databázi.
Použijte rozdělení tabulek
dělené tabulky a indexy můžou vytvářet rozsáhlé tabulky lépe spravovatelné a škálovatelné. Použitím přístupu rozdělení tabulek můžete implementovat vlastní čištění dat nebo offline archivaci podle časových podmínek. Dělení tabulek také poskytuje výhody výkonu při dotazování dočasných tabulek v podmnožině historie dat pomocí odstranění oddílu.
Použijte rozdělení tabulek k implementaci posuvného okna pro přesun nejstarší části historických dat z tabulky historie a zachování velikosti zachované části konstantní podle stáří. Posuvné okno uchovává data v tabulce historie odpovídající požadované době uchovávání. Tabulka historie podporuje přesouvání dat jinam, zatímco SYSTEM_VERSIONING je ON, což znamená, že můžete vyčistit část historických dat bez zavedení okna údržby nebo blokování běžných úloh.
Note
Pro provedení přepínání oddílů musí být váš shlukovaný index v tabulce historie zarovnán se schématem rozdělení (musí obsahovat ValidTo). Výchozí tabulka historie obsahuje shlukovaný index, který zahrnuje ValidTo sloupce a ValidFrom a což je optimální pro dělení částí, vkládání nových historických dat a typické časové dotazování. Další informace naleznete v tématu časové tabulky.
Posuvné okno vyžaduje dvě sady úkolů:
- Úloha konfigurace rozdělení
- Opakované úlohy údržby oddílů
Pro tuto ilustraci předpokládejme, že chcete uchovávat historická data po dobu šesti měsíců a že chcete uchovávat každý měsíc dat v samostatné části. Také předpokládejte, že jste aktivovali systémové verzování v září 2023.
Úloha konfigurace dělení vytvoří počáteční konfiguraci dělení pro tabulku historie. V tomto příkladu vytvoříte stejný počet oddílů, kolik má velikost posuvného okna, v měsících, plus jeden prázdný oddíl navíc. Tato konfigurace zajišťuje, že systém může správně ukládat nová data, když poprvé spustíte opakovanou úlohu údržby oddílů. Také to zaručuje, že nikdy nerozdělíte oddíly obsahující data, což zabraňuje nákladným přesunům dat. Definujme funkci rozdělení pomocí RANGE LEFT namísto RANGE RIGHT. Pro více informací viz Aspekty výkonu při dělení tabulek později v tomto článku.
Následující obrázek ukazuje počáteční konfiguraci rozdělení pro uchování šesti měsíců dat.
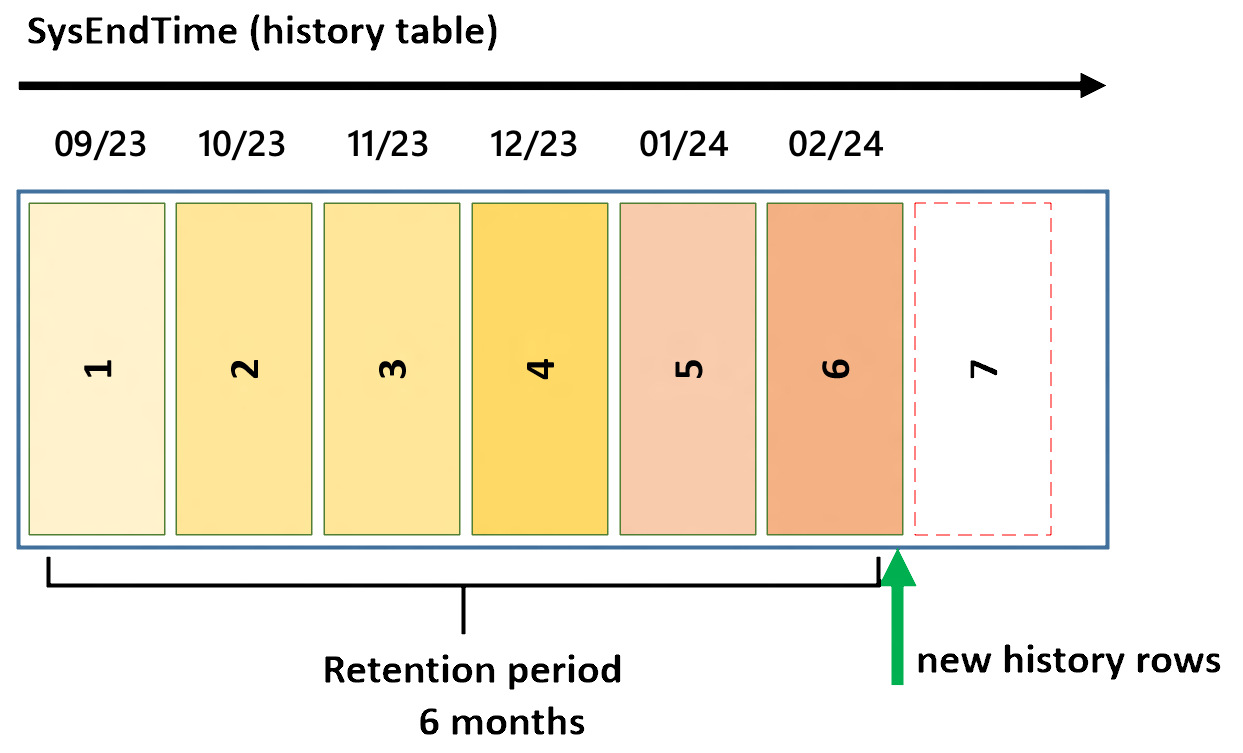
První a poslední oddíl jsou na dolní, respektive horní hranici otevřené, aby se zajistilo, že každý nový řádek má cílový oddíl bez ohledu na hodnotu ve sloupci použitém pro dělení do oddílů. Postupem času se nové řádky v tabulce historie ocitají ve vyšších particích. Když je šestý oddíl zaplněn, dosáhnete požadované doby uchovávání. V tomto bodě začněte poprvé s opakující se úlohou údržby oddílů. Naplánujte to na pravidelné spouštění, v tomto příkladu jednou za měsíc.
Následující obrázek znázorňuje opakující se úkoly údržby oddílů.
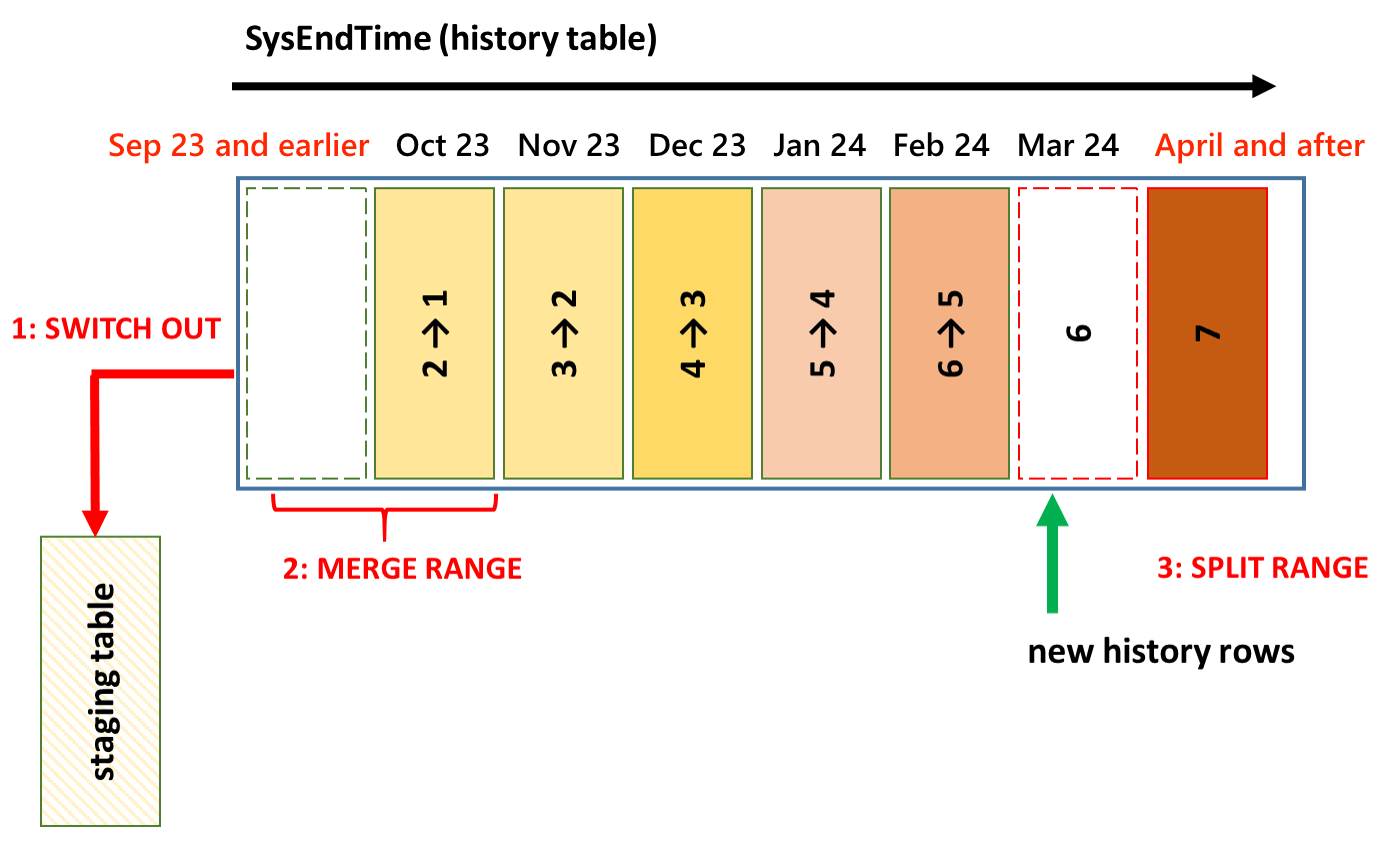
Každý běh opakující se údržbové úlohy provádí následující kroky:
SWITCH OUT: Vytvořte staging tabulku a poté přepněte oddíl mezi historickou tabulkou a staging tabulkou pomocí příkazu ALTER TABLE s argumentemSWITCH PARTITION.ALTER TABLE [<history table>] SWITCH PARTITION 1 TO [<staging table>];Po přepnutí oddílu můžete data z přípravné tabulky případně archivovat a poté přípravnou tabulku buď odstranit, nebo vyprázdnit, abyste ji připravili na další cyklus údržby.
MERGE RANGE: Sloučte prázdnou partíci1s partition2pomocí příkazu ALTER PARTITION FUNCTION sMERGE RANGE. Když tuto funkci použijete k odstranění nejnižší hranice, fakticky sloučíte prázdný oddíl1s původním oddílem2a vytvoříte tak nový oddíl1. Ostatní oddíly také v důsledku toho mění svá pořadová čísla.SPLIT RANGE: Vytvořte novou prázdnou partition7pomocí příkazu ALTER PARTITION FUNCTION sSPLIT RANGE. Když tuto funkci použijete k přidání nové horní hranice, efektivně vytvoříte samostatnou partici pro nadcházející měsíc.
Použijte Transact-SQL pro vytvoření partitionů na historické tabulce
Použijte následující skript Transact-SQL k vytvoření funkce oddílu, schématu oddílu a k opětovnému vytvoření clusterovaného indexu tak, aby byl v souladu se schématem oddílu. V tomto příkladu vytvoříte šestiměsíční posuvné okno s měsíčními oddíly od září 2023.
BEGIN TRANSACTION;

/*Create partition function*/
CREATE PARTITION FUNCTION [fn_Partition_DepartmentHistory_By_ValidTo](DATETIME2 (7))
    AS RANGE LEFT FOR VALUES (
        N'2023-09-30T23:59:59.999',
        N'2023-10-31T23:59:59.999',
        N'2023-11-30T23:59:59.999',
        N'2023-12-31T23:59:59.999',
        N'2024-01-31T23:59:59.999',
        N'2024-02-29T23:59:59.999'
    );

/*Create partition scheme*/
CREATE PARTITION SCHEME [sch_Partition_DepartmentHistory_By_ValidTo]
    AS PARTITION [fn_Partition_DepartmentHistory_By_ValidTo]
    TO (
        [PRIMARY],
        [PRIMARY],
        [PRIMARY],
        [PRIMARY],
        [PRIMARY],
        [PRIMARY],
        [PRIMARY]
    );

/*Re-create index to be partition-aligned with the partitioning schema*/
CREATE CLUSTERED INDEX [ix_DepartmentHistory] ON [dbo].[DepartmentHistory] (
    ValidTo ASC,
    ValidFrom ASC
)
WITH (
    PAD_INDEX = OFF,
    STATISTICS_NORECOMPUTE = OFF,
    SORT_IN_TEMPDB = OFF,
    DROP_EXISTING = ON,
    ONLINE = OFF,
    ALLOW_ROW_LOCKS = ON,
    ALLOW_PAGE_LOCKS = ON,
    DATA_COMPRESSION = PAGE
)
ON [sch_Partition_DepartmentHistory_By_ValidTo] (ValidTo);

COMMIT TRANSACTION;
Použití Transact-SQL k údržbě particí ve scénáři posuvného okna
Pro údržbu oddílů ve scénáři posuvného okna použijte následující skript Transact-SQL. V tomto příkladu vyměníte oddíl pro září 2023 použitím MERGE RANGE, a pak přidáte nový oddíl pro březen 2024 pomocí SPLIT RANGE.
BEGIN TRANSACTION;

/* (1) Create staging table */
CREATE TABLE [dbo].[staging_DepartmentHistory_September_2023]
(
    DeptID INT NOT NULL,
    DeptName VARCHAR (50) COLLATE SQL_Latin1_General_CP1_CI_AS NOT NULL,
    ManagerID INT NULL,
    ParentDeptID INT NULL,
    ValidFrom DATETIME2 (7) NOT NULL,
    ValidTo DATETIME2 (7) NOT NULL
) ON [PRIMARY]
WITH (DATA_COMPRESSION = PAGE);

/* (2) Create index on the same filegroups as the partition to switch out */
CREATE CLUSTERED INDEX [ix_staging_DepartmentHistory_September_2023]
ON [dbo].[staging_DepartmentHistory_September_2023](
    ValidTo ASC,
    ValidFrom ASC
)
WITH (
    PAD_INDEX = OFF,
    SORT_IN_TEMPDB = OFF,
    DROP_EXISTING = OFF,
    ONLINE = OFF,
    ALLOW_ROW_LOCKS = ON,
    ALLOW_PAGE_LOCKS = ON
)
ON [PRIMARY];

/* (3) Create constraints matching the partition to switch out */
ALTER TABLE [dbo].[staging_DepartmentHistory_September_2023] WITH CHECK
    ADD CONSTRAINT [chk_staging_DepartmentHistory_September_2023_partition_1]
            CHECK (ValidTo <= N'2023-09-30T23:59:59.999');

ALTER TABLE [dbo].[staging_DepartmentHistory_September_2023]
    CHECK CONSTRAINT [chk_staging_DepartmentHistory_September_2023_partition_1];

/* (4) Switch partition to staging table */
ALTER TABLE [dbo].[DepartmentHistory]
    SWITCH PARTITION 1 TO [dbo].[staging_DepartmentHistory_September_2023]
    WITH (
        WAIT_AT_LOW_PRIORITY (
            MAX_DURATION = 0 MINUTES, ABORT_AFTER_WAIT = NONE
        )
    );

/* (5) [Commented out] Optionally archive the data and drop staging table
      INSERT INTO [ArchiveDB].[dbo].[DepartmentHistory]
      SELECT * FROM [dbo].[staging_DepartmentHistory_September_2023];
      DROP TABLE [dbo].[staging_DepartmentHIstory_September_2023];
*/

/* (6) merge range to move lower boundary one month ahead */
ALTER PARTITION FUNCTION [fn_Partition_DepartmentHistory_By_ValidTo]()
    MERGE RANGE (N'2023-09-30T23:59:59.999');

/* (7) Create new empty partition for "April and after"
by creating new boundary point and specifying NEXT USED file group*/
ALTER PARTITION SCHEME [sch_Partition_DepartmentHistory_By_ValidTo]
    NEXT USED [PRIMARY];

ALTER PARTITION FUNCTION [fn_Partition_DepartmentHistory_By_ValidTo]()
    SPLIT RANGE (N'2024-03-31T23:59:59.999');

COMMIT TRANSACTION;
Optimálním řešením je však pravidelně každý měsíc bez úprav spouštět obecný Transact-SQL skript. Můžete zobecnit předchozí skript tak, aby působil na zadané parametry (spodní hranice, která se musí sloučit, a nová hranice vytvořená rozdělením partition). Aby se předešlo vytváření staging tabulky každý měsíc, vytvořte ji předem a znovu ji použijte změnou kontrolního omezení tak, aby odpovídalo oddílu, který vyměňujete. Pro více informací viz jak plně automatizovat scénář s posuvným oknem.
Aspekty výkonu při particování tabulek
Provádějte operace MERGE RANGE a SPLIT RANGE způsobem, který zabrání přesunu dat, protože přesun dat může způsobit značnou režii. Další informace naleznete v tématu Úprava funkce oddílu.
Když vytvoříte funkci oddílu jako RANGE LEFT, zadané hodnoty představují horní hranice oddílů. Při použití RANGE RIGHTpřiřazené hodnoty představují dolní hranice rozdělení. Pokud použijete operaci MERGE RANGE k odebrání hranice z definice funkce oddílu, základní implementace také odebere oddíl, který obsahuje hranici. Pokud tento oddíl není prázdný, MERGE RANGE přesune data na výsledný oddíl.
Následující diagram popisuje možnosti RANGE LEFT a RANGE RIGHT:
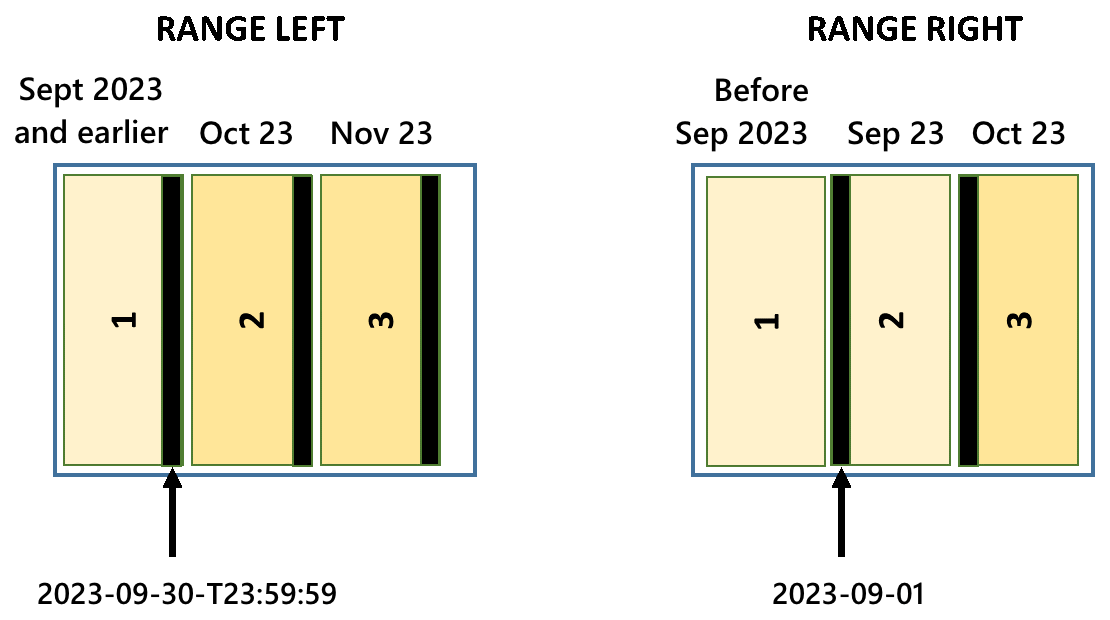
Ve scénáři posuvného okna vždy odeberete nejnižší hranici oddílu.
RANGE LEFTpřípad: Nejnižší hranice oddílu náleží oddílu1, který je prázdný (po odpojení oddílu přepnutím), takžeMERGE RANGEnezpůsobuje žádný přesun dat.RANGE RIGHTpřípad: Nejnižší hranice oddílu patří oddílu2, který není prázdný, protože výměna vyprázdní pouze oddíl1. V tomto případě způsobujeMERGE RANGEpohyb dat, což znamená přesun dat z jedné části2na druhou1. Aby se tomuto pohybu dat předešlo,RANGE RIGHTje v případě posuvného okna potřeba mít partition1, který je vždy prázdný. Tento požadavek znamená, že pokud použijeteRANGE RIGHT, měli byste vytvořit a udržovat jednu extra partition ve srovnání s případemRANGE LEFT.
Závěr: Správa oddílů je snazší, když v posuvném oddílu použijete RANGE LEFT, a nedochází tak k přesunu dat. Definování hranic oddílů pomocí RANGE RIGHT je ale o něco jednodušší, protože nemusíte řešit problémy s kontrolou data a času.
Použijte vlastní skript pro čištění
Když pro vaši tabulku není dostupná politika uchovávání a rozdělení tabulek není možné, můžete data z tabulky historie smazat pomocí vlastního skriptu pro čištění. Tento proces je možný pouze tehdy, když SYSTEM_VERSIONING = OFF. Aby se předešlo nekonzistenci dat, provádějte čištění buď během údržbového okna (kdy nejsou aktivní pracovní zátěže, které mění data), nebo v rámci transakce (efektivně blokující jiné pracovní zátěže). Tato operace vyžaduje oprávnění CONTROL pro aktuální tabulky a tabulky historie.
Logika čištění je stejná pro každou časovou tabulku, takže ji můžete automatizovat pomocí obecného uloženého postupu. Použijte SQL Server Agent nebo jiný nástroj k plánování tohoto postupu každý den, přičemž iterujte každou časovou tabulku, u které chcete omezit historii dat.
Následující diagram ukazuje, jak uspořádat logiku čištění pro jednu tabulku, abyste snížili dopad na běžící pracovní zátěže.
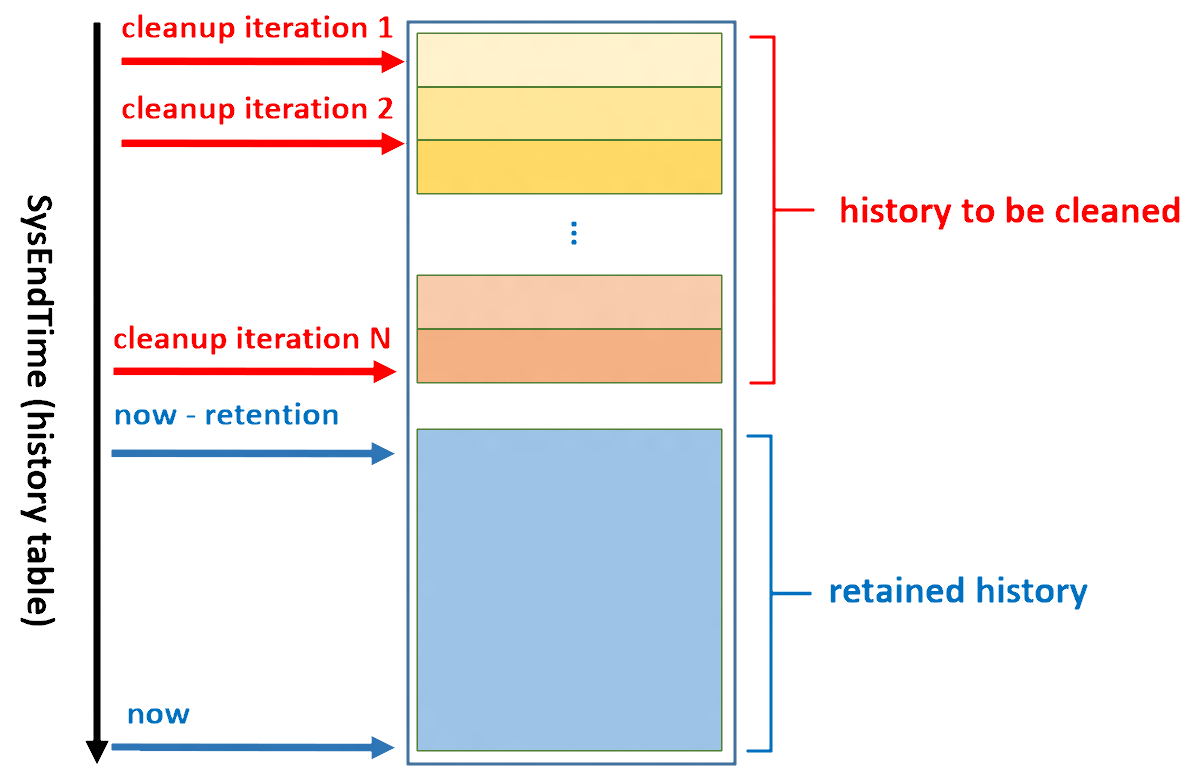
Zde jsou některé základní pokyny pro implementaci tohoto procesu:
Smažte historická data v každé časové tabulce v několika iteracech malých částí. Začněte od nejstarších řad a přejděte k nejnovějším. Vyhněte se mazání všech řádků v jedné transakci, jak ukazuje předchozí diagram. Ačkoliv neexistuje jedna velikost bloku ve všech scénářích, smazání více než 10 000 řádků v jedné transakci může znamenat výrazný trest.
Implementujte každou iteraci jako vyvolání obecné uložené procedury, která odstraní část dat z tabulky historie.
Spočítejte, kolik řádků potřebujete odstranit pro jednotlivé dočasné tabulky při každém vyvolání procesu. Na základě výsledku a počtu iterací, které chcete, určete dynamické body rozdělení pro každé volání procedury.
Naplánujte zpoždění mezi iteracemi pro jednu tabulku, abyste snížili dopad na aplikace, které přistupují k časové tabulce.
Následující uložená procedura maže data pro jednu časovou tabulku. Objeví tabulku historie a sloupec konce periody z katalogových zobrazení a poté spustí tři příkazy uvnitř transakce: SET SYSTEM_VERSIONING = OFF, DELETE FROM <history_table>, a SET SYSTEM_VERSIONING = ON. Tento kód pečlivě prostudujte a upravte ho před aplikací ve svém prostředí.
V SQL Serveru 2016 (13.x) musí první dva kroky běžet v samostatných příkazech EXECUTE nebo SQL Server vygeneruje chybu podobnou následujícímu příkladu:
Msg 13560, Level 16, State 1, Line XXX
Cannot delete rows from a temporal history table '<database_name>.<history_table_schema_name>.<history_table_name>'.
DROP PROCEDURE IF EXISTS usp_CleanupHistoryData;
GO

CREATE PROCEDURE usp_CleanupHistoryData (
    @temporalTableSchema SYSNAME,
    @temporalTableName SYSNAME,
    @cleanupOlderThanDate DATETIME2
)
AS
DECLARE @disableVersioningScript AS NVARCHAR (MAX) = '';
DECLARE @deleteHistoryDataScript AS NVARCHAR (MAX) = '';
DECLARE @enableVersioningScript AS NVARCHAR (MAX) = '';
DECLARE @historyTableName AS SYSNAME;
DECLARE @historyTableSchema AS SYSNAME;
DECLARE @periodColumnName AS SYSNAME;

/* Generate script to discover history table name and
end of period column for given temporal table name */
EXECUTE sp_executesql N'
    SELECT @hst_tbl_nm = t2.name,
           @hst_sch_nm = s2.name,
           @period_col_nm = c.name
    FROM sys.tables AS t1
         INNER JOIN sys.tables AS t2
             ON t1.history_table_id = t2.object_id
         INNER JOIN sys.schemas AS s1
             ON t1.schema_id = s1.schema_id
         INNER JOIN sys.schemas AS s2
             ON t2.schema_id = s2.schema_id
         INNER JOIN sys.periods AS p
             ON p.object_id = t1.object_id
         INNER JOIN sys.columns AS c
             ON p.end_column_id = c.column_id
            AND c.object_id = t1.object_id
    WHERE t1.name = @tblName
          AND s1.name = @schName',
    N'@tblName sysname,
    @schName sysname,
    @hst_tbl_nm sysname OUTPUT,
    @hst_sch_nm sysname OUTPUT,
    @period_col_nm sysname OUTPUT',
@tblName = @temporalTableName,
@schName = @temporalTableSchema,
@hst_tbl_nm = @historyTableName OUTPUT,
@hst_sch_nm = @historyTableSchema OUTPUT,
@period_col_nm = @periodColumnName OUTPUT;

IF @historyTableName IS NULL
   OR @historyTableSchema IS NULL
   OR @periodColumnName IS NULL
    THROW 50010, 'History table cannot be found. Either specified table is not system-versioned temporal or you have provided incorrect argument values.', 1;

SET @disableVersioningScript = @disableVersioningScript +
    'ALTER TABLE [' + @temporalTableSchema + '].[' + @temporalTableName + ']
    SET (SYSTEM_VERSIONING = OFF)';

SET @deleteHistoryDataScript = @deleteHistoryDataScript +
    ' DELETE FROM [' + @historyTableSchema + '].[' + @historyTableName + ']
    WHERE [' + @periodColumnName + '] < ' + '''' +
    CONVERT (VARCHAR (128), @cleanupOlderThanDate, 126) + '''';

SET @enableVersioningScript = @enableVersioningScript +
    ' ALTER TABLE [' + @temporalTableSchema + '].[' + @temporalTableName + ']
    SET (SYSTEM_VERSIONING = ON (HISTORY_TABLE = [' + @historyTableSchema + '].[' +
    @historyTableName + '], DATA_CONSISTENCY_CHECK = OFF )); ';

BEGIN TRANSACTION;
    EXECUTE (@disableVersioningScript);
    EXECUTE (@deleteHistoryDataScript);
    EXECUTE (@enableVersioningScript);
COMMIT TRANSACTION;
Související obsah
- temporální tabulky
- Začínáme se systémově verzovanými temporálními tabulkami
- Kontroly konzistence systému časových tabulek
- Oddíl s dočasnými tabulkami
- aspekty a omezení časových tabulek
- zabezpečení časových tabulek
- Systémově verzované časové tabulky s tabulkami optimalizovanými pro paměť
- Zobrazení a funkce metadat temporálních tabulek