Návrh hvězdicového schématu pro sémantické modely
Zvolili jste, jak data proudí do sémantického modelu. Nyní navrhujte hvězdicové schéma, které ho uspořádá pro jasné a výkonné dotazy. Hvězdicové schéma spojuje tabulky faktů s tabulkami dimenzí prostřednictvím relací, které vytvářejí filtrační cesty, na nichž závisí sestavy a spotřeba AI. Pokud jste obeznámeni s vytvářením hvězdicového schématu v Power BI Desktopu, tato lekce se zaměřuje na rozhodování o návrhu vztahů, která jsou důležitá při nárůstu složitosti a škálování modelů.
Hvězdicové schéma v sémantickém modelu
Ve hvězdicovém schématu tabulky faktů ukládají měřitelné obchodní události (například prodejní transakce, řádky objednávek a návštěvy webu) a tabulky dimenzí poskytují popisný kontext (například podrobnosti o produktu, informace o zákaznících a atributy data). Tabulky dimenzí filtrují tabulky faktů prostřednictvím relací, což umožňuje uživatelům rozdělit metriky podle libovolného popisného atributu.
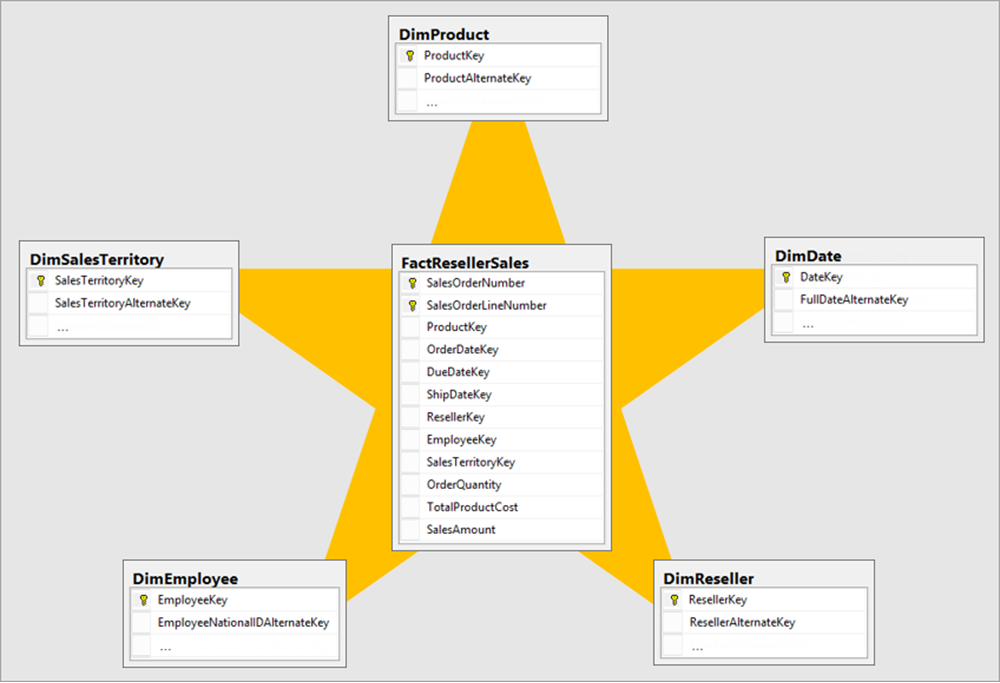
V sémantickém modelu Fabric tento vzor poskytuje čisté šíření filtrování pro sestavy i pro využití AI. Když Copilot nebo datový agent vygeneruje dotaz v přirozeném jazyce, dobře uspořádané hvězdicové schéma poskytuje umělé inteligenci jasné cesty ke správným datům. Nejednoznačné nebo kruhové vztahy matou jak uživatele sestav, tak nástroje umělé inteligence.
Vliv režimu úložiště na vztahy
Relace v sémantickém modelu se chovají odlišně v závislosti na režimu úložiště. Pochopení těchto rozdílů je nezbytné pro návrh hvězdicového schématu, které dobře funguje v různých scénářích.
Vztahy Direct Lake
V režimu Direct Lake modul čte relace přímo z metadat tabulky Delta. Relace fungují nejlépe, když:
- Sloupce klíče dimenze mají nízkou kardinalitu vzhledem k řádkům tabulky faktů.
- Referenční integrita se udržuje ve zdrojových datech. Když je dodržena referenční integrita, systém místo levých vnějších spojení používá vnitřní spojení, takto se zvyšuje výkon dotazů.
- Sloupce používané v relacích se indexují v podkladových tabulkách Delta.
Poznámka:
Pokud dotaz zahrnuje relaci, která způsobí, že model překročí limity paměti nebo použije nepodporované operace, Direct Lake se vrátí zpět do DirectQuery a chování relace se změní tak, aby odpovídalo sémantice DirectQuery.
Relace mezi zdroji
Fabric sémantické modely mohou propojit tabulky z různých úložišť dat. Tabulka faktů z jezera může mít relaci s tabulkou dimenzí ze skladu nebo s tabulkou přístupnou prostřednictvím koncového bodu analýzy SQL. Tato připojení mezi zdroji používají funkce složeného modelu.
Pokud tabulky pocházejí z různých zdrojů, režim úložiště pro každou tabulku určuje, jak relace funguje v době dotazu. Modul vyřeší jednotlivé strany nezávisle a spojí výsledky.
Typy vztahů
Vztahy jeden k mnoha
1:N je nejběžnější typ relace ve hvězdicovém schématu. Jedna jedinečná hodnota v tabulce dimenzí souvisí s mnoha řádky v tabulce faktů. Například jeden řádek produktu v dimenzi Produkt odpovídá tisícům řádků objednávek v tabulce faktů Prodej.
Nakonfigurujte relace jedna k mnoha se směrem filtru, který proudí z dimenze, (strana "jedna") do tabulky faktů (strana "mnoha"). Toto je vzor standardního filtru hvězdicového schématu.
Relace M:N
Relace M:N se vyžadují, pokud žádná tabulka nemá jedinečné hodnoty pro sloupec relace. K vyřešení těchto relací použijte spojovací tabulku. Propojená tabulka se nachází mezi dvěma tabulkami a obsahuje jedinečné kombinace klíčů z obou tabulek.
Pokud například zákazník může mít více účtů a účet může patřit více zákazníkům, vztah se řeší propojovací tabulkou Zákazník-Účet. Přechodová tabulka má relace 1:N s tabulkami Customer (Zákazník) a Account (Účet).
Směr filtru
Ve většině implementací hvězdicového schématu použijte jednosměrové filtrování z dimenze na fakta. To poskytuje předvídatelné šíření filtru a zabraňuje nejednoznačnosti ve výsledcích dotazu.
Obousměrné filtrování je někdy nezbytné pro relace M:N nebo v případě, že tabulky dimenzí musí být filtrovány podle hodnot v tabulce faktů. Obousměrné filtry používejte střídmě, protože mohou snížit výkon dotazů a vytvářet neočekávané chování filtrů v sestavách.
Referenční integrita
Nastavení předpokládat referenční integritu říká modulu, aby při dotazování mezi relacemi používal spíše vnitřní spojení než levé vnější spojení. V režimech Direct Lake a DirectQuery toto nastavení může výrazně zvýšit výkon, protože snižuje počet řádků procesů modulu.
Toto nastavení povolte, pokud máte jistotu, že každá hodnota cizího klíče v tabulce faktů má v tabulce dimenzí odpovídající hodnotu. Pokud dojde k porušení referenční integrity, řádky s chybějícími klíči z výsledků dotazu bezobslužně zmizí.
Neaktivní relace a USERELATIONSHIP
Mezi dvěma tabulkami najednou může existovat pouze jedna aktivní relace. Pokud potřebujete více cest relací (například datum objednávky a datum expedice, které souvisí se stejnou dimenzí dat), aktivujte jednu relaci a ostatní neaktivujte.
USERELATIONSHIP Pomocí funkce v jazyce DAX aktivujte neaktivní relaci ve výpočtu:
Shipped Amount =
CALCULATE(
    SUM(Sales[Amount]),
    USERELATIONSHIP(Sales[ShipDate], 'Date'[Date])
)
Tento model udržuje model čistý a současně podporuje více analytických perspektiv na stejných datech.
Zpracování schématu sněhové vločky v sémantických modelech
Zdrojová data často přicházejí do normalizovaného schématu sněhové vločky, kde jsou tabulky dimenzí rozdělené do více souvisejících tabulek. Dimenze Produktu může být například rozdělena do tabulek Product (Produkt), Subcategory (Podkategorie) a Category (Kategorie), které jsou propojené prostřednictvím cizích klíčů.
V sémantickém modelu máte dvě možnosti: zploštění sněhové vločky na hvězdicové schéma nebo zachování normalizované struktury.
Zploštit do hvězdicového schématu
Zplošťování znamená kombinování normalizovaných tabulek dimenzí do jedné tabulky denormalizovaných dimenzí. Tabulka Product (Produkt) by obsahovala přímo sloupce Subcategory a Category (Kategorie), čímž by se eliminovaly nadbytečné tabulky a relace.
Vyrovnat kdy:
- Kombinovaná tabulka dimenzí je stále malá vzhledem k tabulce faktů (což je téměř vždy případ dimenzí).
- Chcete jednodušší filtrační cesty z dimenze na fakty. Každý filtr prochází jednou relací místo řetězu.
- Spotřeba umělé inteligence (AI) je prioritou. Méně tabulek a jednodušších relací poskytuje Copilot a datovým agentům jasnější cesty ke správným datům.
Zplošťujte tabulky dimenzí během přípravy dat v Lakehouse nebo datových tocích, ještě před tím, než data dosáhnou sémantického modelu. Pomocí sloučení Power Query, spojení SQL nebo transformací v poznámkových blocích zkombinujte normalizované tabulky do jedné dimenze.
Zachování struktury sněhové vločky
V některých případech dává zachování normalizované struktury smysl:
- Hierarchie dimenzí má více úrovní a zploštění by vytvořilo desítky redundantních sloupců.
- Několik faktových tabulek sdílí subdimenzionální tabulky (například sdílenou tabulku kategorie používanou fakty prodej i inventář) a denormalizace by vytvořila nevyvážené kopie.
- Zabezpečení na úrovni řádků je potřeba použít na konkrétní úrovni v hierarchii.
Když zachováte strukturu sněhové vločky, nakonfigurujte relace pečlivě. Každá relace v řetězci musí používat filtrování v jednom směru, od nejvzdálenější tabulky k tabulce faktů, aby se filtry správně propagovaly. Filtr na kategorii musí postupovat přes podkategorie, poté skrze produkt a do tabulky faktů.
Poznámka:
Ve většině sémantických scénářů modelu je lepší volbou zploštětování dimenzí do hvězdicového schématu. Méně tabulek znamená méně relací, jednodušší jazyk DAX, rychlejší dotazy a lepší spotřebu AI. Zachovejte strukturu sněhové vločky pouze tehdy, když je silný důvod, proč ji zachovat.
Kdy použít složené modely pro scénáře napříč zdroji
Složené modely použijte, když hvězdicové schéma pokrývá více Fabric úložišť dat nebo zahrnuje externí zdroje. Mezi běžné scénáře patří:
- Tabulky faktů v jezeře s tabulkami dimenzí udržovanými ve skladu
- Streamovaná data z eventhouse v reálném čase v kombinaci s historickými daty v jezeře
- Referenční data z externího zdroje (Import) v kombinaci s tabulkami faktů nativními pro Fabric (Direct Lake).
V těchto scénářích nakonfigurujte režim úložiště pro každou tabulku nezávisle a ověřte, že relace mezi zdroji fungují přijatelně u očekávaných objemů dat.