Extrahování informací z dokumentů
Tip
Další podrobnosti najdete na kartě Text a obrázky .
Dnešní obchodní procesy závisí hodně na datech obsažených v dokumentech, jako jsou formuláře, účtenky a faktury. Ruční zpracování může představovat zpoždění a chyby, což dělá automatizaci extrakce dat důležitější než kdy dřív.
Jak funguje Azure Content Understanding
Azure Content Understanding se řídí modelem řízeným pracovním postupem extrakce, ve kterém se nestrukturovaný obsah ingestuje, analyzuje a vrací jako strukturovaná data.
Ingestování obsahu: Obsah odešlete do Služby Azure Content Understanding.
Analýza založená na umělé inteligenci: Služba používá kombinaci: Optické rozpoznávání znaků (OCR), rozpoznávání řeči, porozumění přirozenému jazyku a multimodální modely AI k analýze obsahu.
Strukturovaný výstup: Služba vrací strukturované výsledky (například ve formátu JSON), které odpovídají vašemu modelu – usnadňují ukládání, vyhledávání nebo integraci dat do podřízených systémů.
Poznámka:
JSON (JavaScript Object Notation) je textový formát dat používaný k ukládání a výměně strukturovaných dat mezi systémy. Pro lidi je snadné číst a psát a pro stroje je snadné analyzovat a generovat.
Pochopit schémata
OCR (optické rozpoznávání znaků) umožňuje počítači číst text z obrázků, jako jsou naskenované dokumenty, fotky účtenek nebo obrázky tištěných stránek, a převést tento text na upravitelný a prohledávatelný digitální text. Základní technologie OCR pomáhá rozpoznat tištěný text, zaměřuje se na extrakci textu a nerozumí významu, kontextu nebo vztahů mezi slovy.
Možnosti analýzy dokumentů služby Azure Content Understanding překračují rámec jednoduché extrakce textu založeného na technologii OCR, aby zahrnovaly extrakci polí a jejich hodnot založenou na schématu . Přístup řízený schématem rozlišuje Službu Azure Content Understanding od základních služeb OCR nebo přepisu.
Schéma popisuje , jaké informace chcete extrahovat a jak by měly být strukturované. Při definování schématu zadáte pole, která se mají extrahovat. Schéma obsahuje seznam konkrétních polí nebo entit, na které vám záleží.
Předpokládejme například, že definujete schéma, které zahrnuje běžná pole, která se obvykle nacházejí na faktuře, například:
- Název dodavatele
- Číslo faktury
- Datum faktury
- Jméno zákazníka
- Vlastní adresa
- Položky – položky seřazené, z nichž každá zahrnuje:
- Popis položky
- Jedn. cena
- Objednané množství
- Součet řádkové položky
- Mezisoučty faktur
- Daň
- Expediční poplatek
- Celkový počet faktur
Předpokládejme, že teď potřebujete tyto informace extrahovat z následující faktury:
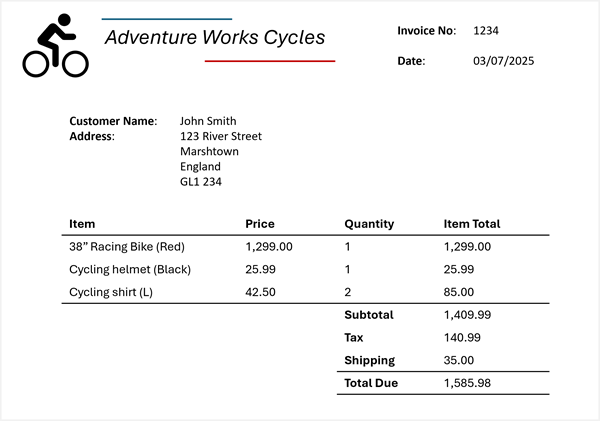
Azure Content Understanding může použít schéma faktury na vaši fakturu a identifikovat odpovídající pole, a to i v případě, že jsou označená různými názvy (nebo nejsou označena vůbec). Výsledná analýza vytvoří výsledek podobný tomuto:
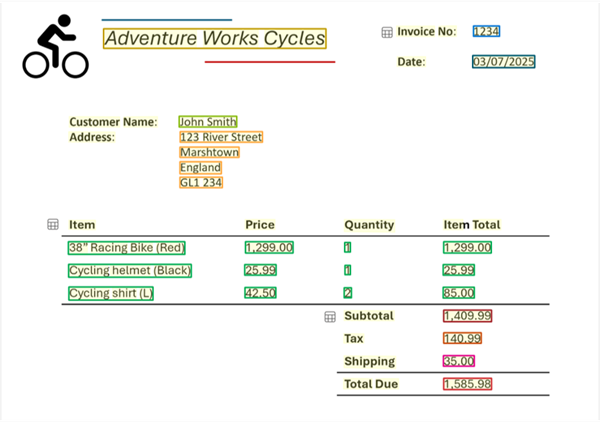
Schéma také definuje strukturu polí. Schémata podporují strukturovaná a vnořená pole, nejen plochý text. Například:
-
Itemsje sbírka. - Každá položka má
description,unit pricequantity, aline total
Identifikace strukturovaných polí umožňuje službě Azure Content Understanding porozumět vztahům mezi hodnotami, něco samotného OCR nemůže udělat.
V příkladu faktury můžete pro každé zjištěné pole extrahovat vnořené hodnoty:
- Název dodavatele: Adventure Works Cycles
- Číslo faktury: 1234
- Datum faktury: 03/07/2025
- Jméno zákazníka: John Smith
- Vlastní adresa: 123 River Street, Marshtown, Anglie, GL1 234
-
Položky:
- Položka 1:
- Popis položky: 38" Závodní kolo (červená)
- Jednotková cena: 1299,00
- Objednané množství: 1
- Celkem řádkové položky: 1299,00
- Položka 2:
- Popis položky: Cyklistická helma (Černá)
- Jednotková cena: 25,99
- Objednané množství: 1
- Součet řádkové položky: 25,99
- Položka 3:
- Popis položky: Cyklistická košile (L)
- Jednotková cena: 42,50
- Objednané množství: 2
- Součet položek: 85,00
- Položka 1:
- Mezisoučet faktury: 1409,99
- Daň: 140.99
- Přepravní poplatek: 35.00
- Faktura celkem: 1585.98
Azure Content Understanding extrahuje očekávaný význam, nejen popisky. Schémata se používají sémanticky, což znamená:
- Pole je možné extrahovat i v případě, že se popisky liší.
- Pole je možné extrahovat i v případě, že popisky chybí.
Například číslo faktury č., faktura #nebo neoznačené číslo se můžou namapovat, pokud InvoiceNumber analyzátor zjistí, že představují stejný koncept.
Principy analyzátorů
Analyzátor je jednotka v Azure Content Understanding, která přijímá vstupy, používá analýzu AI a vytváří strukturované výsledky. Analyzátory konzistentně aplikují stejnou logiku extrakce na veškerý příchozí obsah. Jakmile je nakonfigurovaný, analyzátor zajistí, aby se schéma opakovaně používalo pro každý požadavek analýzy. Analyzátory také vytvářejí předvídatelné výsledky JSON. Strukturované výsledky usnadňují zpracování podřízených dat (úložiště, vyhledávání, automatizaci).
Azure Content Understanding nabízí předem připravené analyzátory pro běžné scénáře a podporuje vlastní analyzátory přizpůsobené vašim potřebám. Na vysoké úrovni:
- Zvolíte nebo vytvoříte analyzátor.
- Analyzátor obsahuje schéma definující pole a strukturu.
- Odešlete obsah k analýze.
- Služba použije schéma.
- Obdržíte strukturované výsledky JSON odpovídající schématu.
Použití služby Azure Content Understanding na portálu Foundry
Poznámka:
Portál Foundry má klasické uživatelské rozhraní a nové uživatelské rozhraní.
Po vytvoření prostředku Microsoft Foundry můžete použít nové rozhraní portálu Foundry k vyzkoušení služby Azure Content Understanding. Portál Foundry poskytuje příklady obsahu a umožňuje nahrát vlastní materiál k analýze.
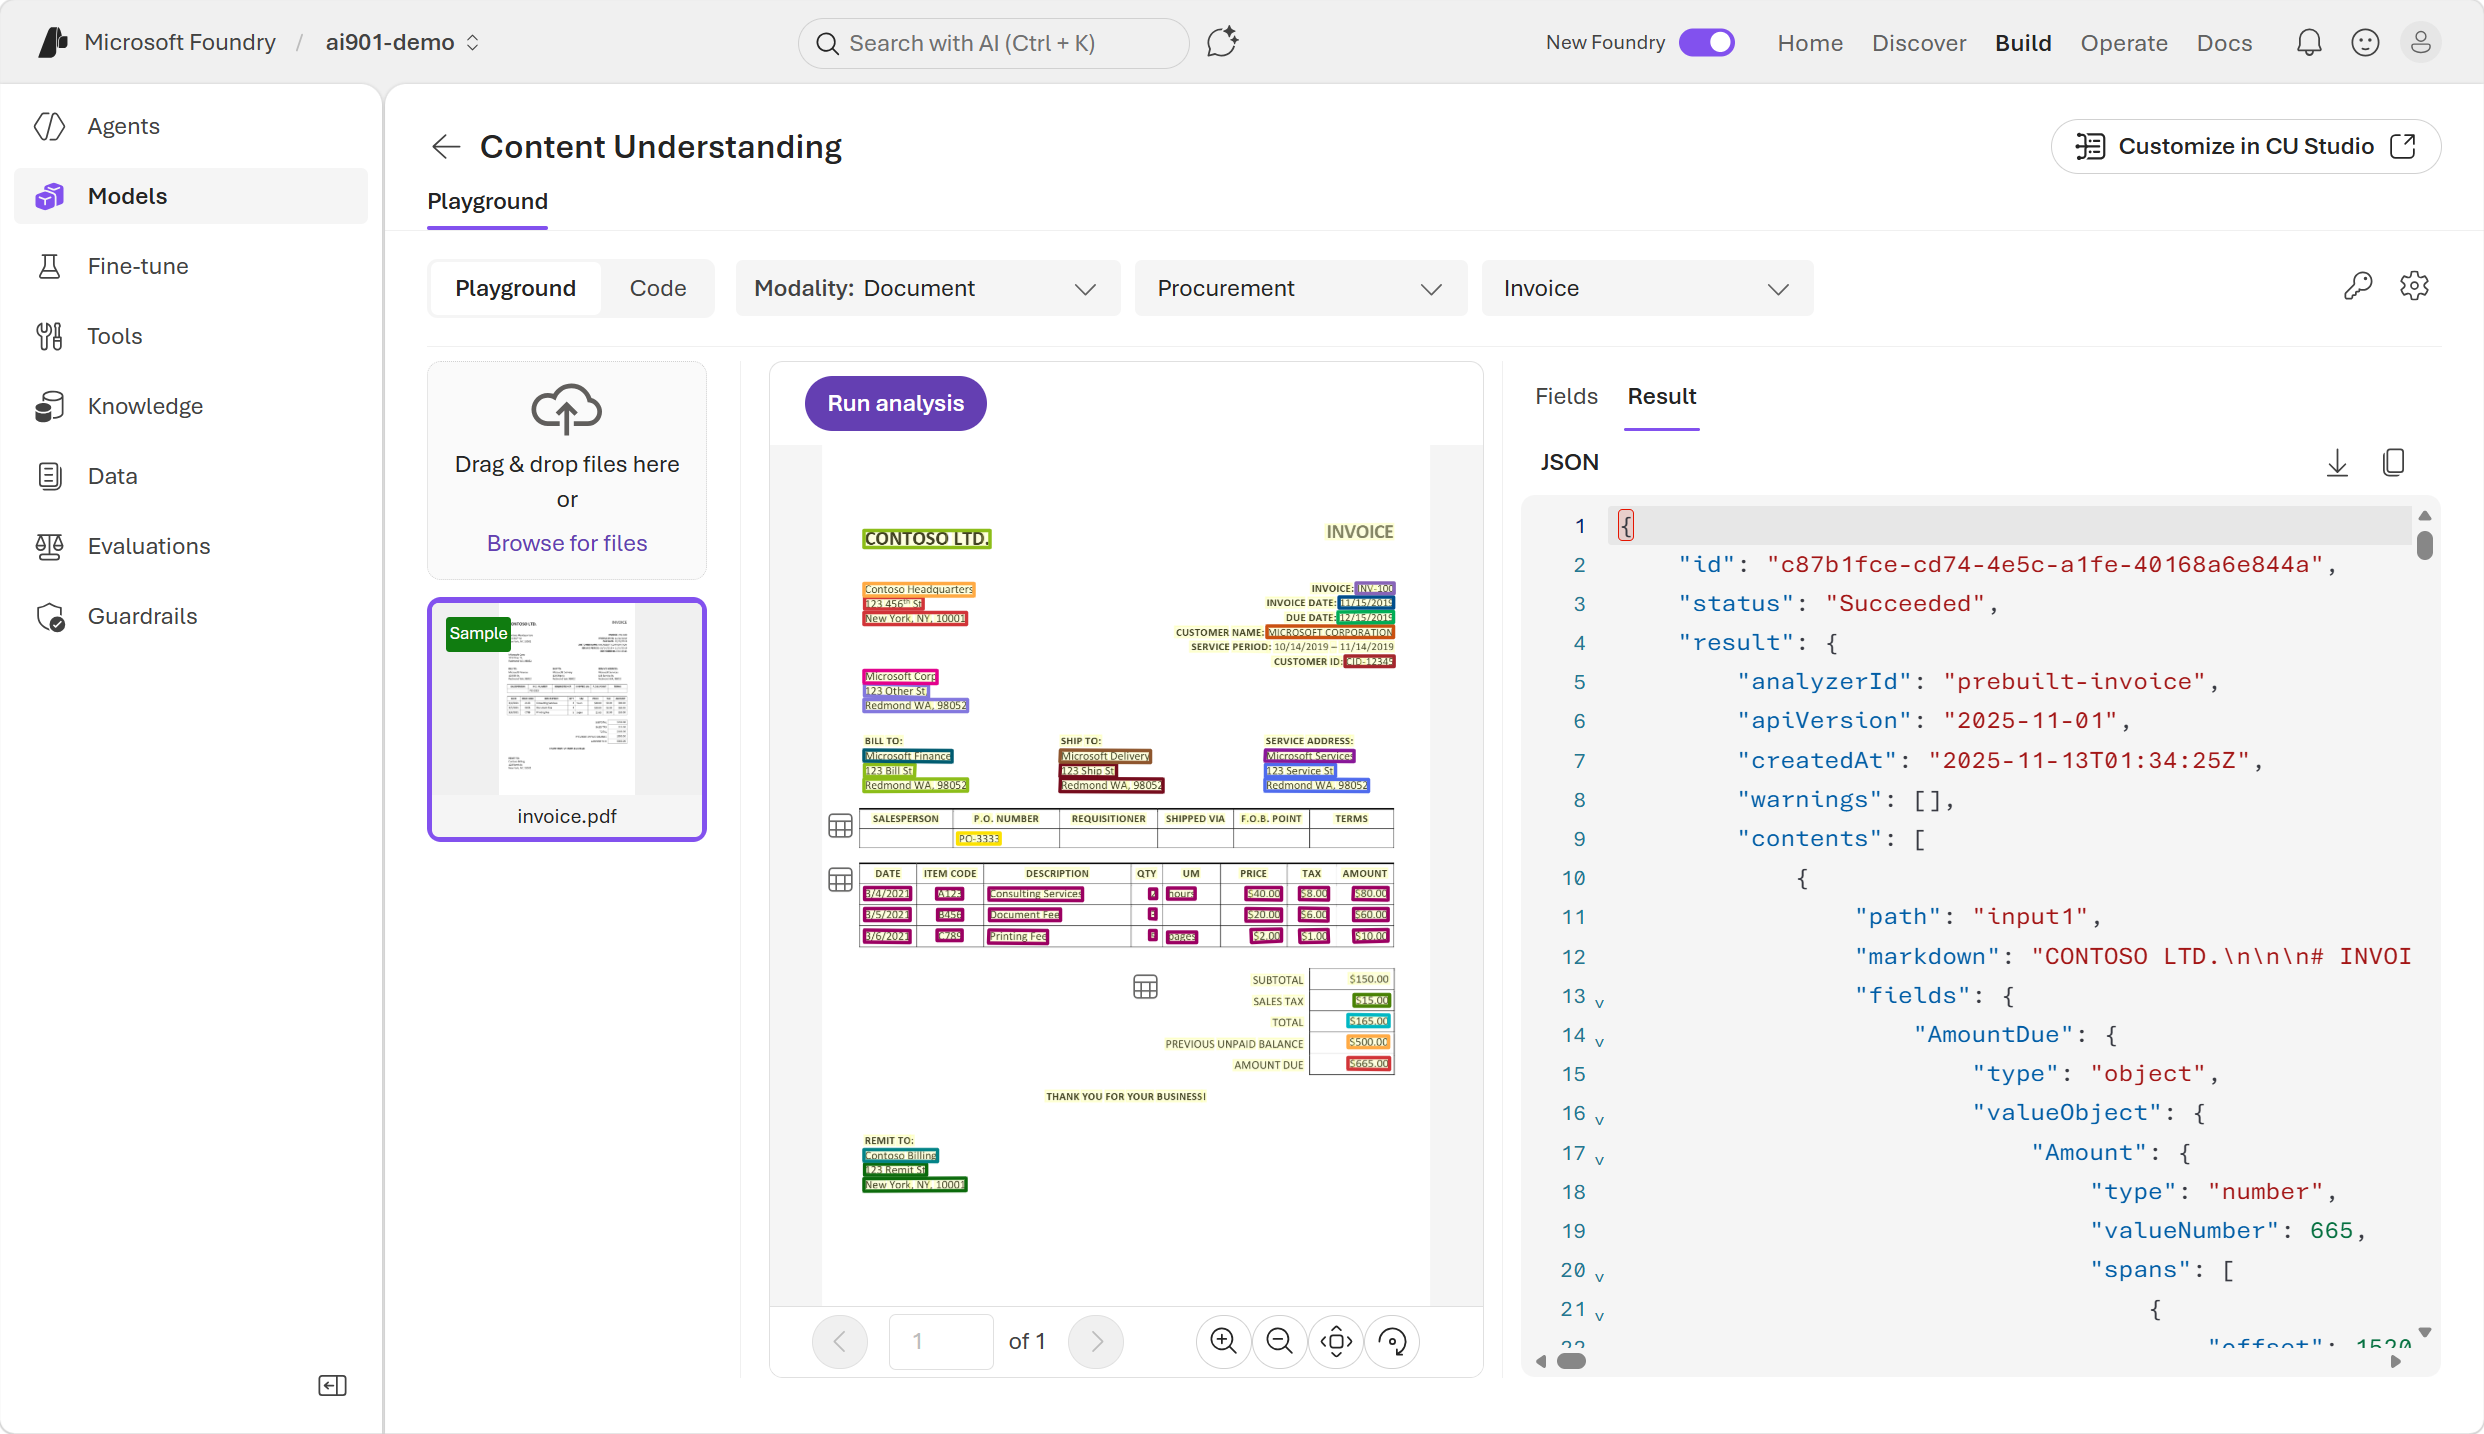
Pomocí vizuálního rozhraní můžete vybrat zdrojový dokument a extrahovat výchozí pole informací. Když například vyzkoušíte Službu Azure Content Understanding na obrázku dokumentu, vrátí služba informace o textu dokumentu a rozložení textu.
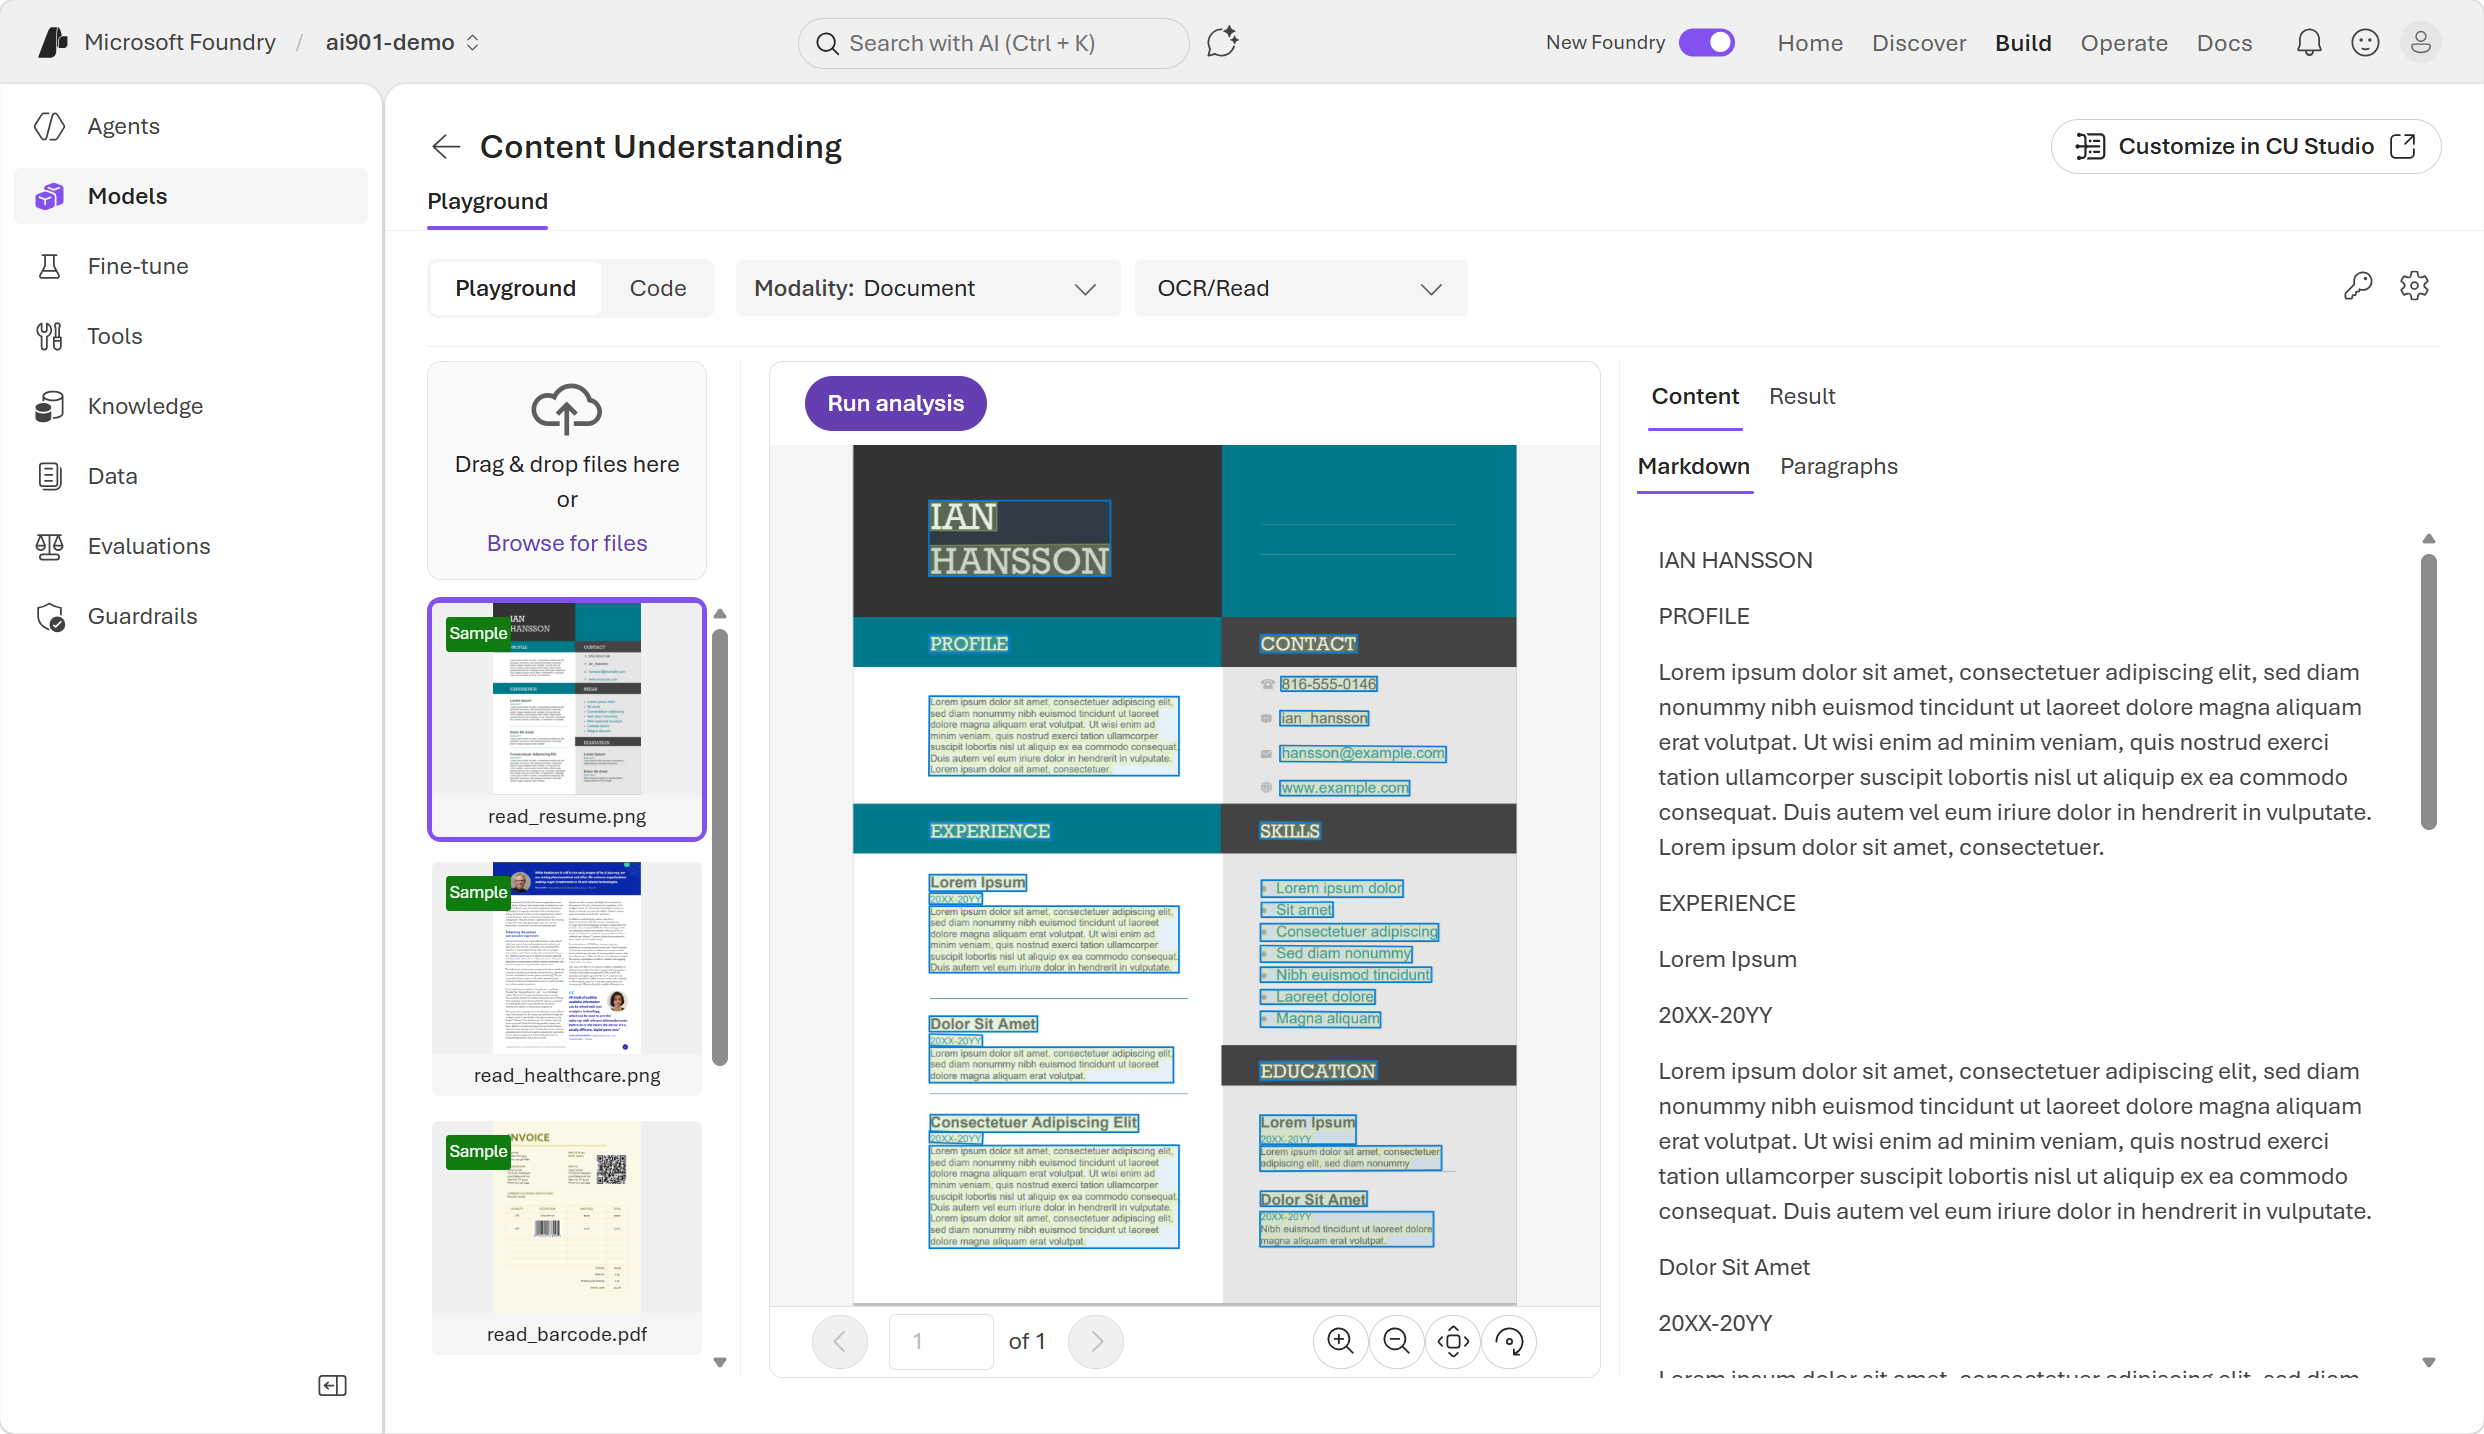
Analyzátory služby Azure Content Understanding identifikují textové hodnoty v dokumentech a mapují je na konkrétní pole. Například na faktuře vrátí služba pole (například adresu dodavatele) a data v polích (například 123 456th Street).
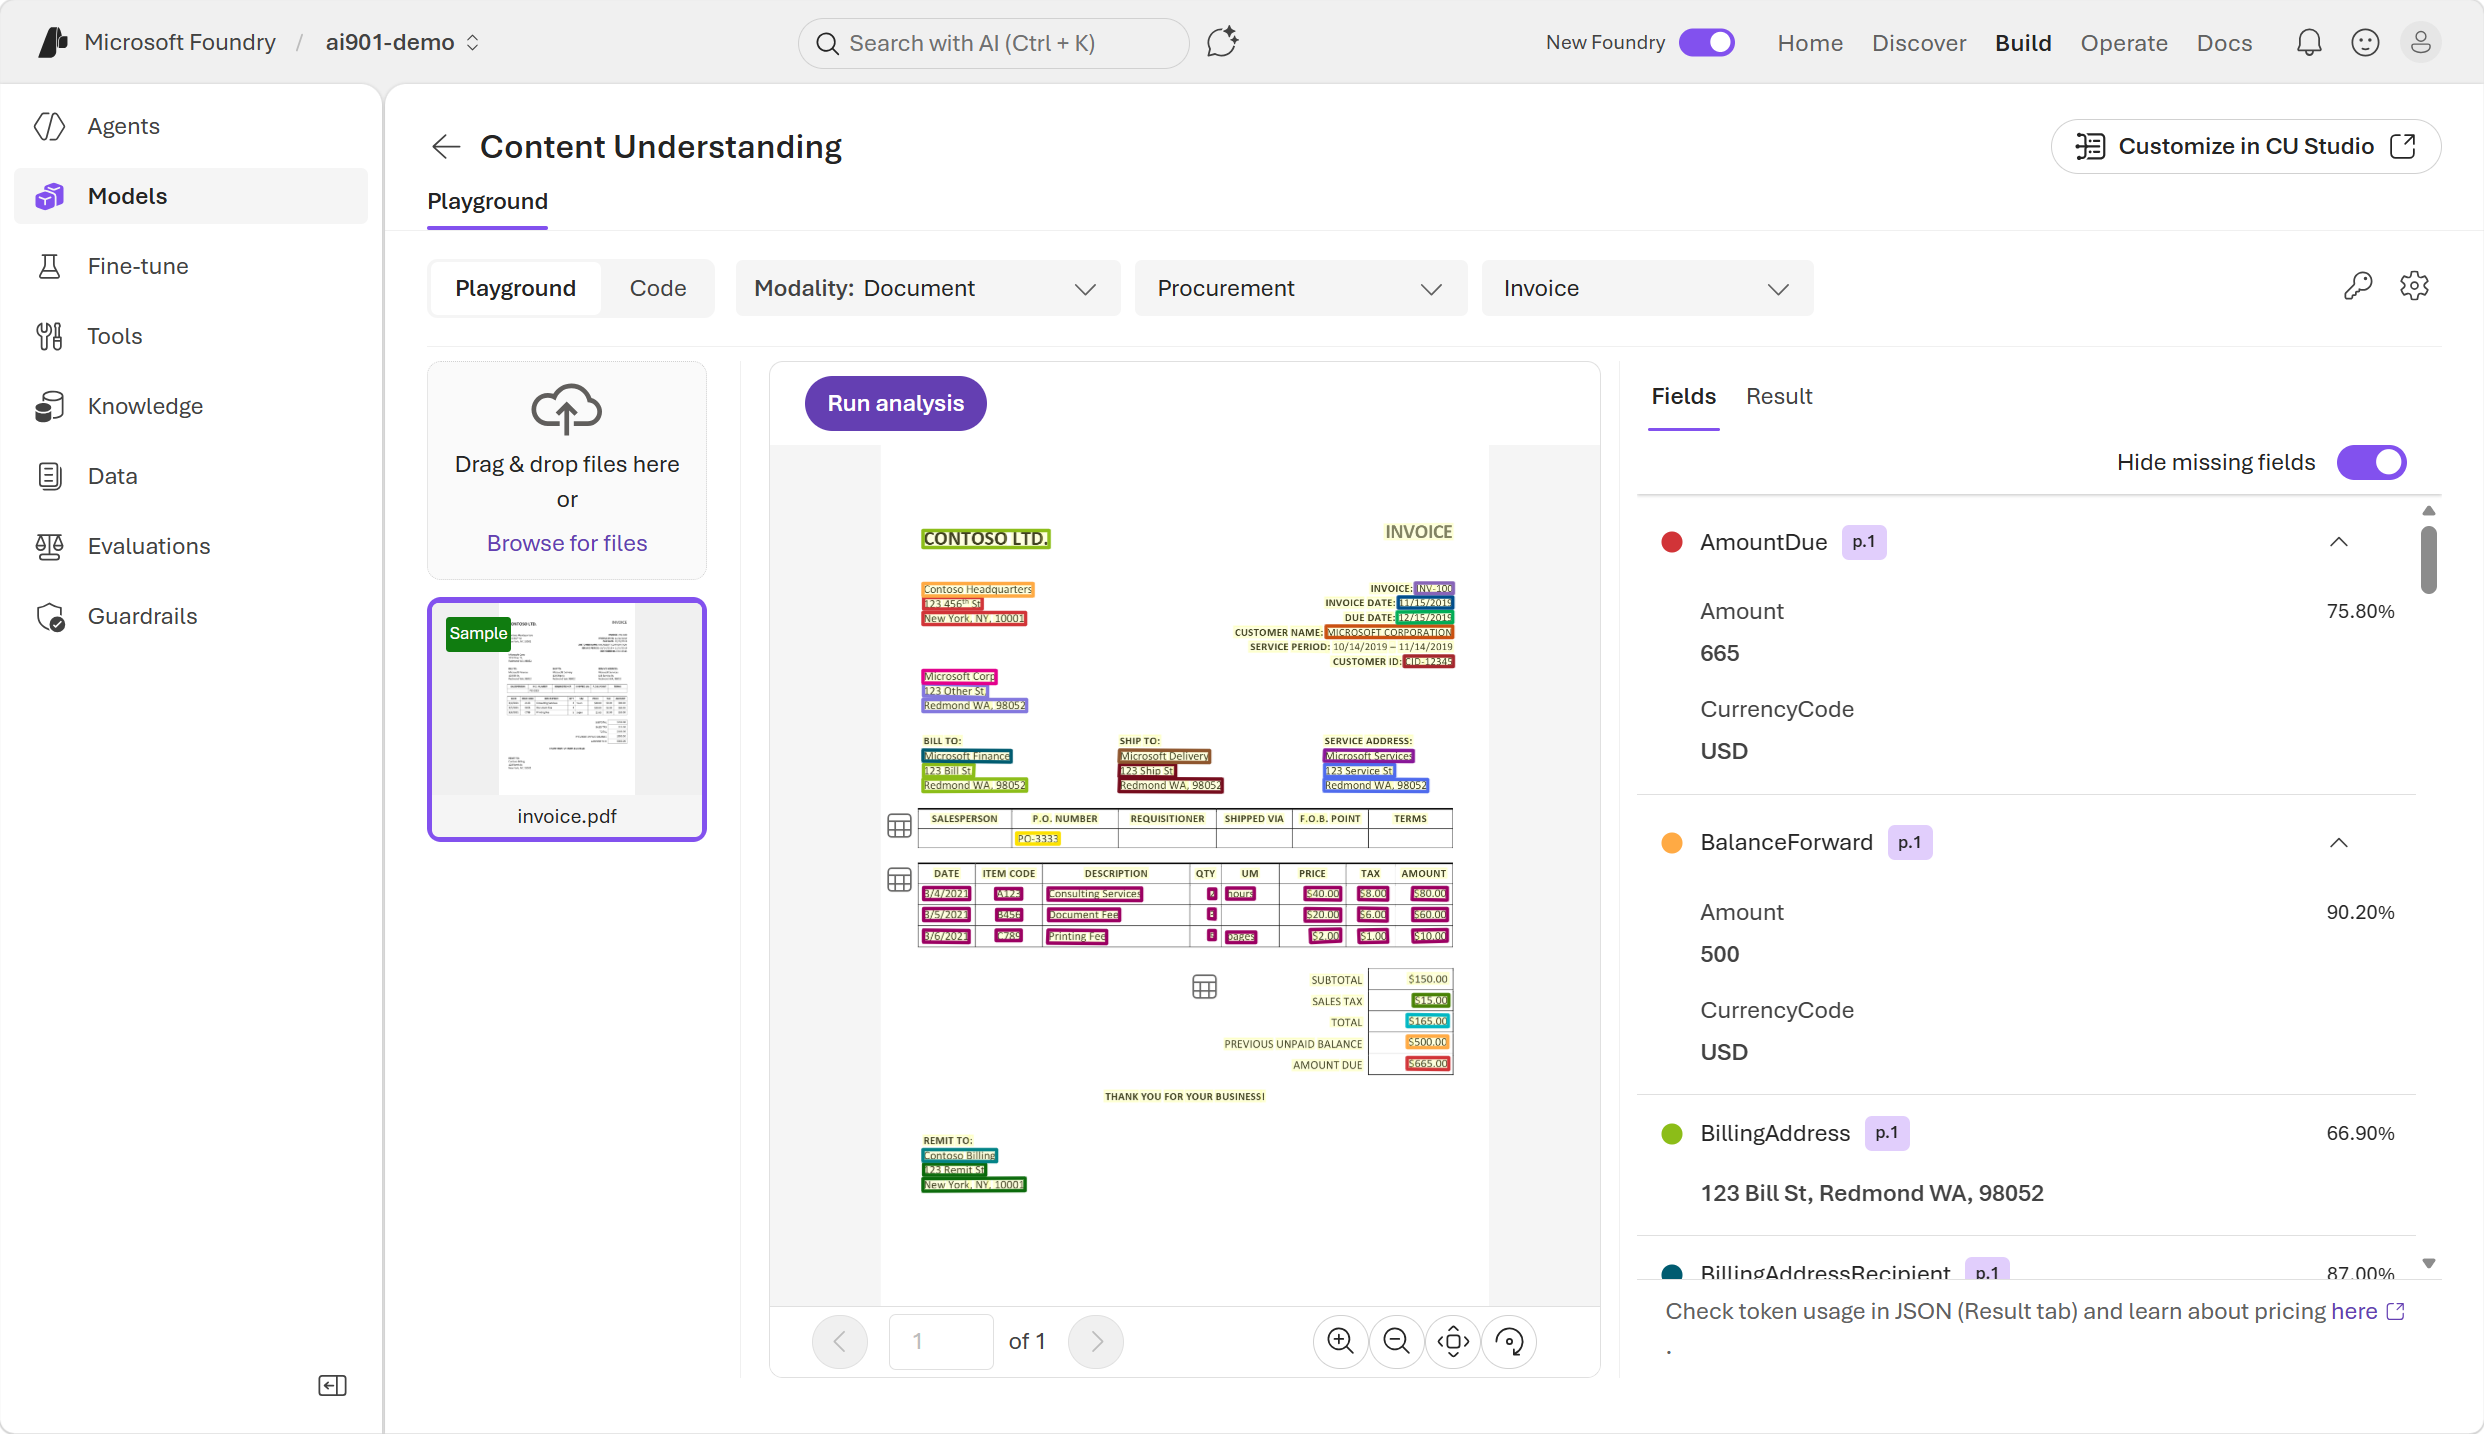
Na portálu Foundry můžete také zobrazit výsledky zpracování ve formátu JSON.
Vytvoření klientské aplikace pomocí Azure Content Understanding
Pomocí rozhraní API služby Content Understanding můžete vytvořit odlehčenou klientskou aplikaci, která prostřednictvím kódu programu extrahuje data.
Poznámka:
Klientská aplikace je softwarový program, který běží na zařízení uživatele a požaduje služby nebo data z jiného systému, obvykle server, přes síť. Klient je součástí aplikace, se kterou uživatelé pracují, zatímco server pracuje na pozadí. Aplikace mohou požadovat data nebo akce ze služby a přijímat strukturovanou odpověď pomocí rozhraní API.
Když používáte rozhraní API služby Content Understanding, můžete zvolit předem připravený analyzátor nebo vytvořit vlastní analyzátor. Mezi předem připravené analyzátory patří: prebuilt-invoice, prebuilt-imageSearch, prebuilt-audioSearcha prebuilt-videoSearch. Když do analyzátoru odešlete obsah pro analýzu, analýza je asynchronní, což znamená, že výsledek získáte později, až bude připravený. Vzhledem k tomu, že analýza je asynchronní, musíte se dotazovat na adresu URL Operation-Location (nebo analyzerResults), dokud úloha nebude úspěšná.
Použití sady Azure Content Understanding Python SDK
Pojďme se podívat na proces použití sady Python SDK k analýze faktury z adresy URL.
- Nainstalujte Python SDK pro Azure Content Understanding.
python -m pip install azure-ai-contentunderstanding
Identifikujte koncový bod prostředku Foundry a klíč rozhraní API nebo ID Microsoft Entra. Váš koncový bod obvykle vypadá takto:
https://<your-resource-name>.services.ai.azure.com/Vytvořte a spusťte kód klientské aplikace. Jedná se
analzyer_ido ID předem připraveného analyzátoru. Tady najdete seznam předem připravených hodnot ID analyzátoru.
import os
from azure.ai.contentunderstanding import ContentUnderstandingClient
from azure.core.credentials import AzureKeyCredential

endpoint = os.environ["FOUNDRY_ENDPOINT"]
key = os.environ["FOUNDRY_KEY"]

client = ContentUnderstandingClient(endpoint=endpoint, credential=AzureKeyCredential(key))

# 1) start analysis with analyzer id + inputs
analyzer_id = "prebuilt-invoice"
inputs = [
    {"url": "https://github.com/Azure-Samples/azure-ai-content-understanding-python/raw/refs/heads/main/data/invoice.pdf"}
]

# 2) wait for the Long Running Operation (LRO) to complete
poller = client.begin_analyze(analyzer_id=analyzer_id, inputs=inputs)  # starts LRO
result = poller.result()  # waits for completion (polling handled by SDK)

# 3) read structured fields + markdown
# The result typically includes extracted "fields" and "markdown" per input content item.
for content in result.contents:
    print(content.markdown)
    print(content.fields)
Výsledný výstup je JSON, který zobrazuje extrahovaný markdown, pole, data v polích a skóre spolehlivosti. Například:
{
	"status": "Succeeded",
	"result": {
		"analyzerId": "prebuilt-invoice",
		"apiVersion": "2025-05-01-preview",
		"contents": [
			{
				"markdown": "# INVOICE\n\nCONTOSO LTD.\n\nContoso Headquarters\n123 456th St\nNew York, NY, 10001\n\nINVOICE: INV-100\n\nINVOICE DATE: 11/15/2019\n\nDUE DATE: 12/15/2019\n\nCUSTOMER NAME: MICROSOFT CORPORATION\n",
				"fields": {
					"CustomerName": {
						"type": "string",
						"valueString": "MICROSOFT CORPORATION",
						"confidence": 0.95,
					},
					"InvoiceDate": {
						"type": "date",
						"valueDate": "2019-11-15",
						"confidence": 0.994,
					}
                }
            }
        ]
    }
}
Dále se dozvíte, jak pomocí analyzátorů Azure Content Understanding extrahovat strukturovaná data ze zvuku a videa.