Multimodální modely pro analýzu obrázků
Tip
Další podrobnosti najdete na kartě Text a obrázky .
Nové modely AI jsou stále vícemodální. Jinými slovy podporují více druhů vstupních dat, včetně obrázků a textu. Multimodální modely jsou modely AI, které můžou pochopit a pracovat s více typy dat najednou, například s textem, obrázky, zvukem nebo videem. Multimodální model může například popsat obrázek v přirozeném jazyce nebo odpovědět na otázku týkající se fotky.
Multimodální modely se běžně používají jako součást:
- Aplikace AI, kde porozumění obrázkům vylepšuje pracovní postupy uživatelů
- Agenti umělé inteligence, kde vizuální vstup pomáhá agentům lépe rozhodovat
Mezi příklady patří:
- Agent, který kontroluje nahrané dokumenty a snímky obrazovky
- Aplikace podpory, která analyzuje fotky odeslané zákazníky
- Výukový nástroj, který vysvětluje diagramy nebo grafy v prostém jazyce
Vzhledem k tomu, že multimodální modely přijímají text i obrázky, snižují potřebu samostatných kanálů zpracování obrazu a usnadňují vytváření komplexních inteligentních prostředí.
Schopnost modelů kombinovat vizuální porozumění s odpověďmi přirozeného jazyka se označuje jako modely GPT s podporou zraku nebo GPT se zrakem. Modely s podporou vizuálního vnímání jsou navrženy pro flexibilní a univerzální vizuální uvažování. Můžou analyzovat vizuální vstup a reagovat v přirozeném jazyce, což usnadňuje vytváření inteligentních aplikací, aniž by potřebovali hluboké znalosti počítačového zpracování obrazu.
Multimodální modely v Microsoft Foundry
Microsoft Foundry obsahuje mnoho modelů, které přijímají vstup založený na imagích a umožňují vytvářet inteligentní řešení založená na vizi. Multimodální modely v Microsoft Foundry umožňují aplikacím a agentům pochopit, analyzovat a zdůvodnit obrázky a vizuální obsah.
Například modely GPT s podporou zraku v Foundry můžou:
- Popis obsahu obrázku v přirozeném jazyce
- Odpovědi na otázky týkající se objektů, textu nebo scén na obrázku
- Extrakce významu z grafů, snímků obrazovky, dokumentů nebo fotek
- Kombinování porozumění obrázkům s textovými pokyny v jediném příkazovém řádku
Katalog modelů Foundry obsahuje mnoho multimodálních modelů, mezi které patří:
GPT-4.1 / GPT-4.1-mini / GPT-4.1-nano: Tyto multimodální modely GPT pro obecné účely můžou zpracovávat text a obrázky společně. Běžně se používají pro popis obrázku a vizuální odpovědi na otázky, analýzu dokumentů a snímků obrazovky a interpretaci grafů a diagramů.
Řada GPT-5 (například GPT-5.1, GPT-5.2): Řada GPT-5 dostupná v Foundry obsahuje pokročilé multimodální modely navržené pro podnikové a agentské scénáře. Tyto modely podporují multimodální vstupy (včetně textu a obrázků), strukturované výstupy, použití nástrojů a velkokontekstové uvažování napříč modalitami. Modely řady GPT-5 se obvykle používají v agentech umělé inteligence na produkční úrovni a v komplexních multimodálních aplikacích.
Foundry také hostuje multimodální modely poskytované partnerem ve svém katalogu modelů, včetně modelů od poskytovatelů, jako je Anthropic a další, které podporují porozumění textu a obrázku.
Analýza obrázků v dětském hřišti Foundry
Poznámka:
Portál Foundry má klasické uživatelské rozhraní a nové uživatelské rozhraní.
Na novém portálu Microsoft Foundry můžete chatovat s nasazeným modelem pomocí testovacího prostředí. Můžete vybrat model s podporou zraku, nahrát obrázky a otestovat výzvy interaktivně, abyste pochopili, jak model interpretuje vizuální informace.
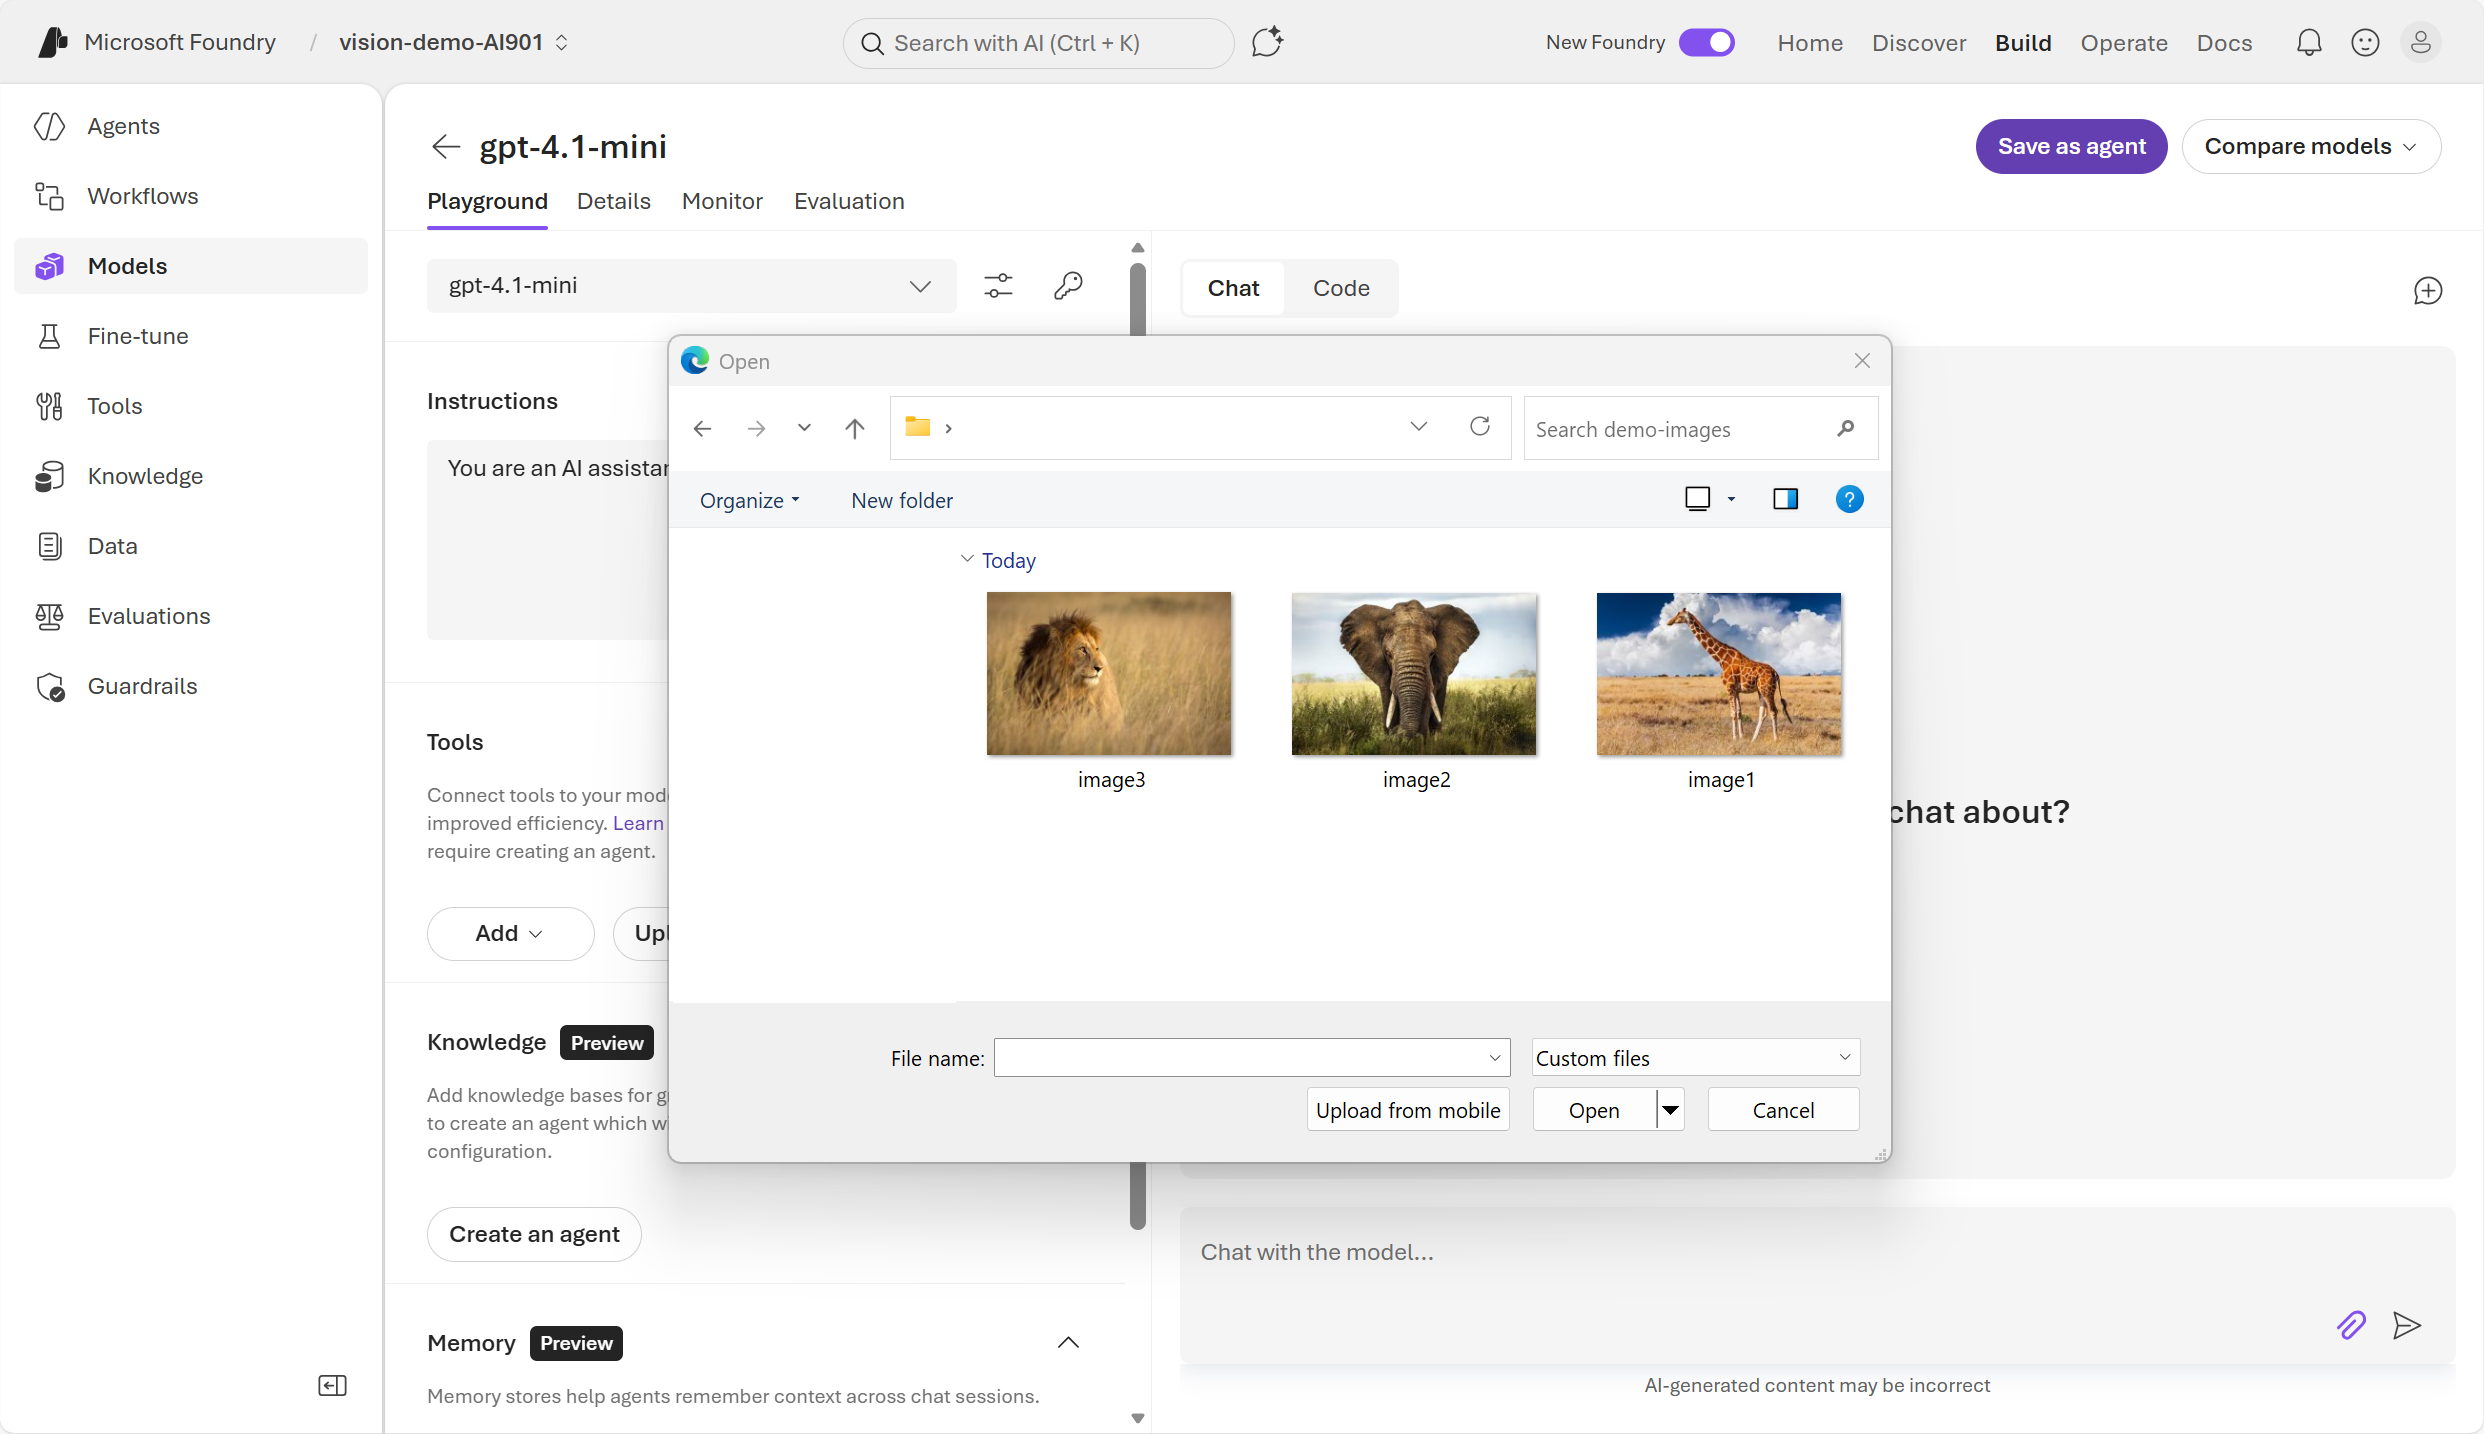
Můžete například připojit soubor obrázku a získat multimodální model (například gpt-4.1 mini) k analýze a popisu.
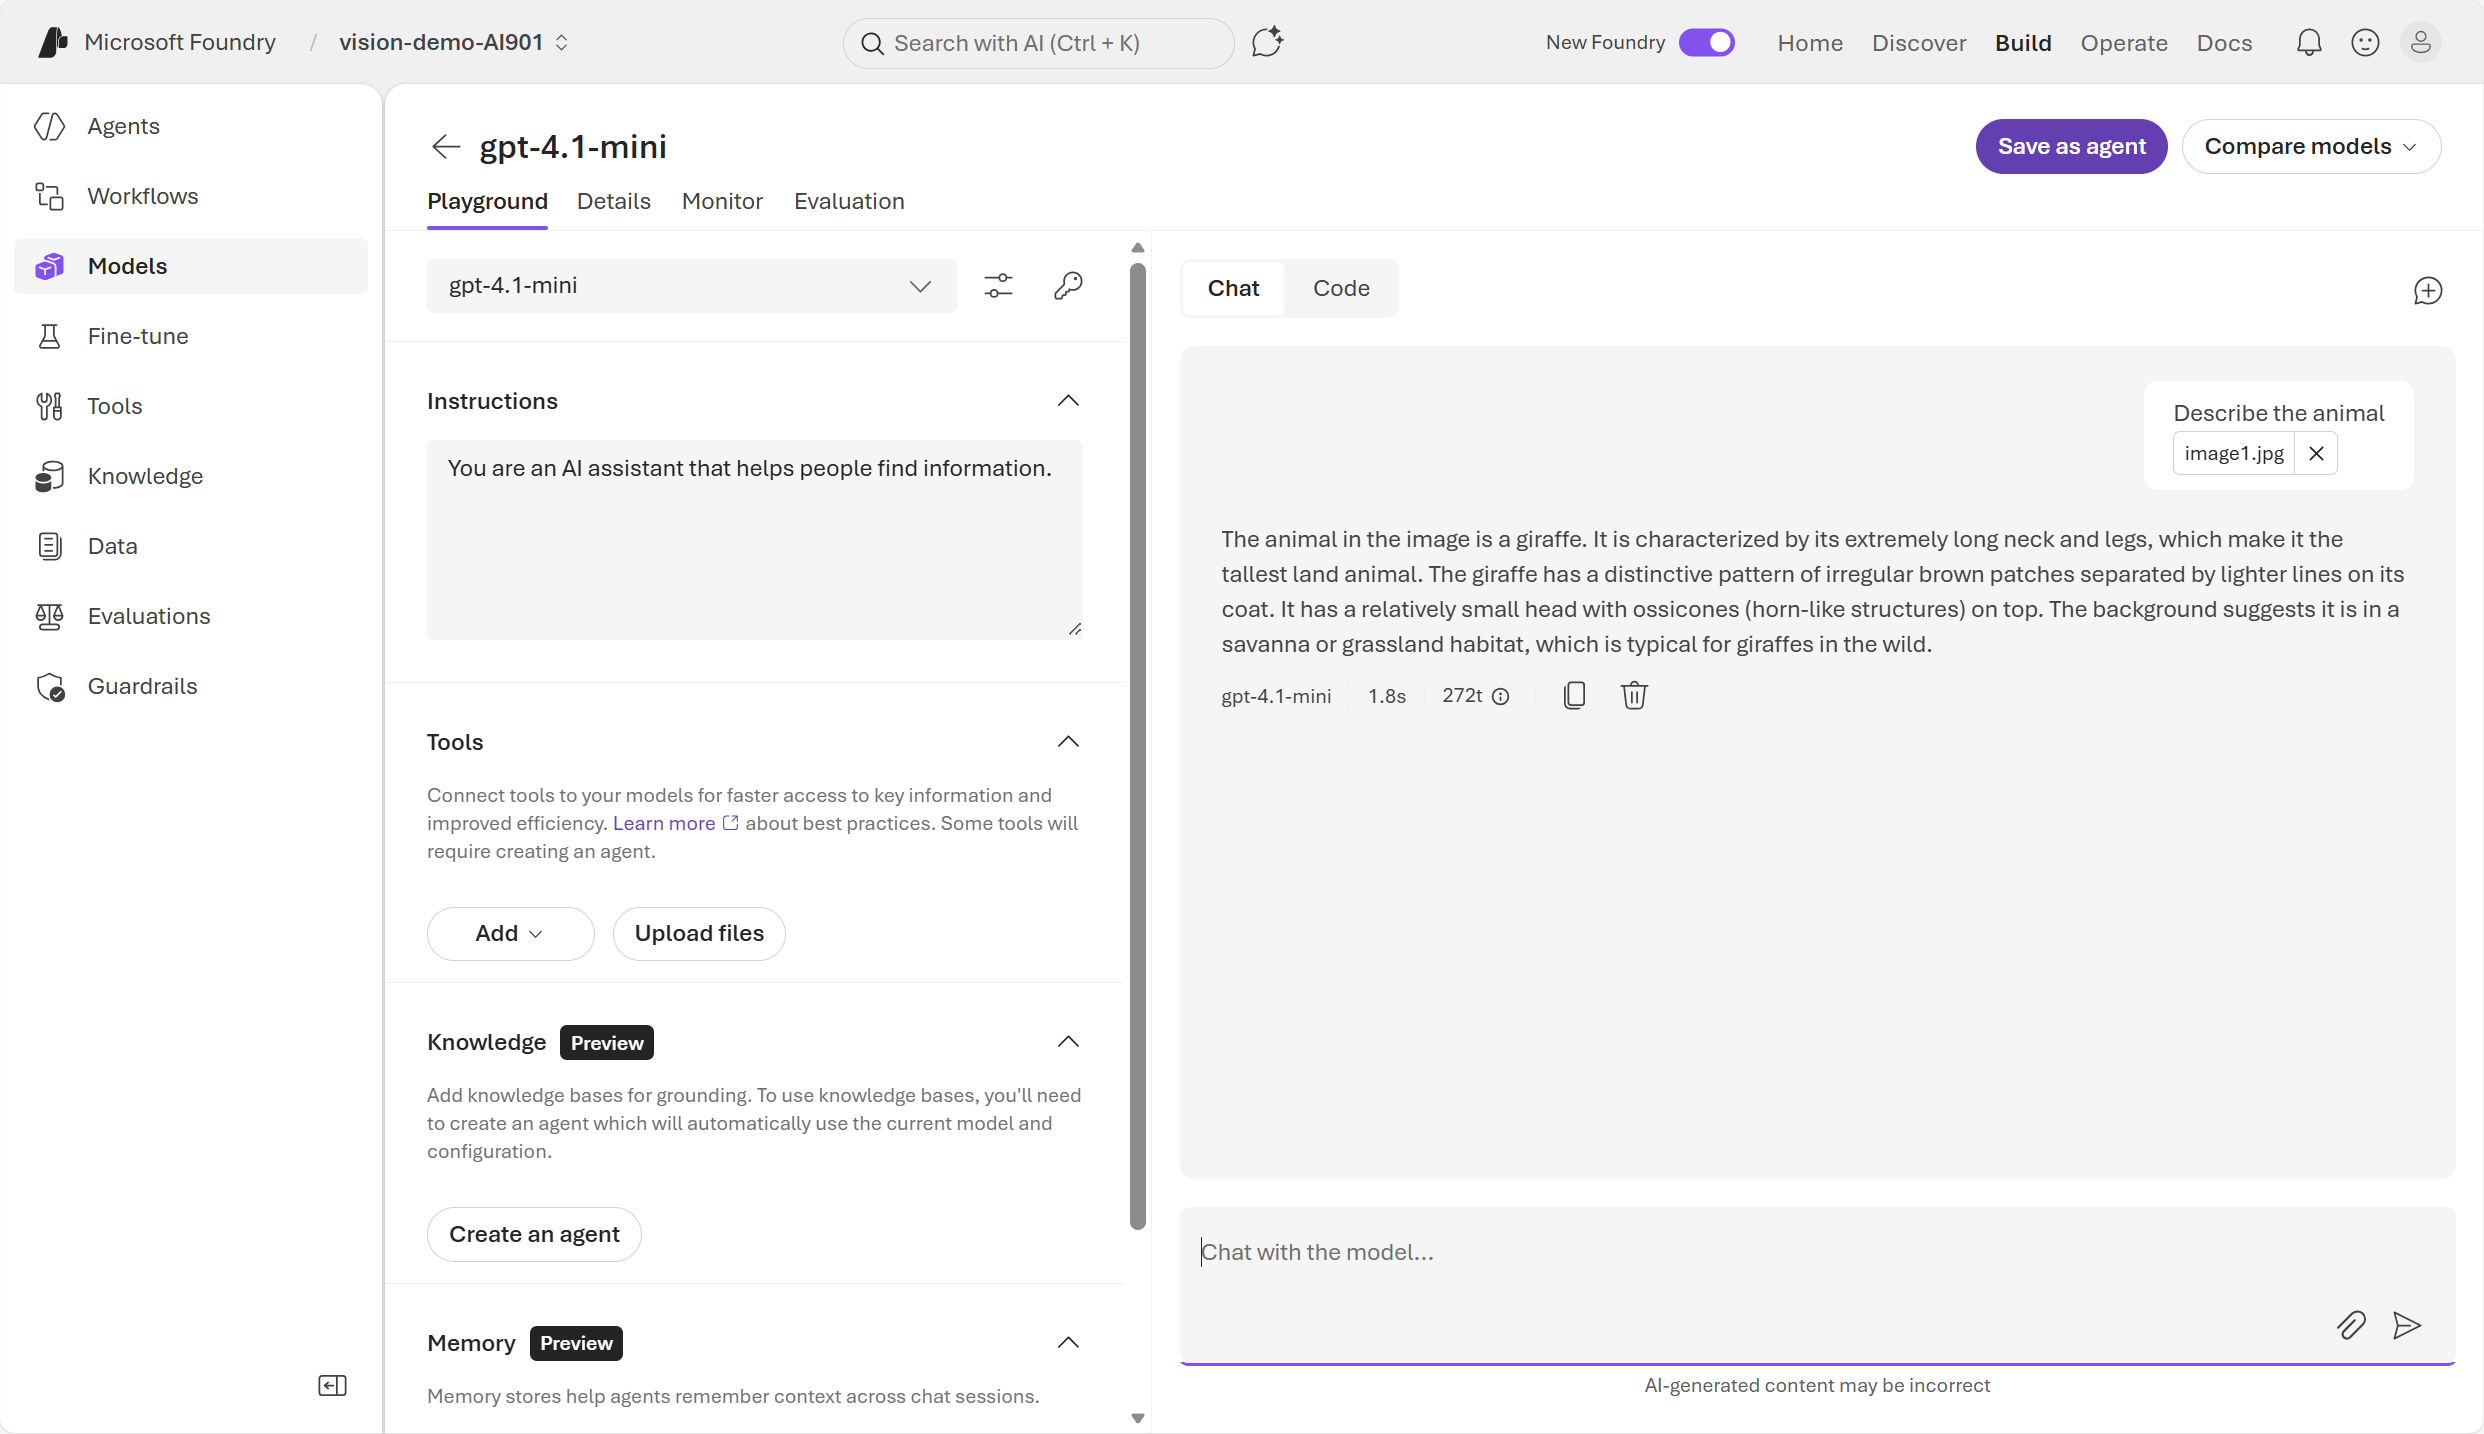
Po ověření se k stejným funkcím dá přistupovat programově pomocí rozhraní API, což umožňuje odeslání obrázků spolu s textovými výzvami v kódu aplikace.
Použití rozhraní API Azure OpenAI pro analýzu obrázků
Abyste mohli vyvíjet aplikaci, musíte přejít z prostředí Foundry na kód. V editoru kódu můžete napsat kód aplikace pomocí rozhraní OPENAI Responses API v Foundry. Rozhraní API pro odpovědi OpenAI je navržené pro aplikace agentů a podporuje nativní multimodální vstupy (včetně imagí).
Na vysoké úrovni:
- Jeden požadavek může obsahovat společně textové zadání a vstup obrázku.
- Obrázky je možné zadat jako adresy URL nebo jako data obrázků s kódováním Base64.
- Model zpracovává oba vstupy současně za účelem vygenerování odpovědi.
Koncepčně vypadá struktura výzvy takto:
- Textová instrukce (například Jaké objekty jsou viditelné na tomto obrázku?)
- Jeden nebo více vstupů obrázků připojených ke stejnému požadavku
Tento přístup umožňuje vývojářům vytvářet aplikace, ve kterých uživatelé nahrávají obrázky a ptají se na ně v reálném čase.
Použití sady Azure OpenAI Python SDK
Pomocí prostředku Microsoft Foundry s rozhraním OpenAI API můžete provádět analýzu obrázků, včetně odesílání obrázků do výzev a získávání odpovědí na text, pomocí rozhraní API pro odpovědi s nasazením modelu s podporou zpracování obrazu.
Sadu Python SDK je možné nainstalovat v terminálu editoru Visual Studio Code pomocí:
pip install openai
V editoru kódu můžeme vytvořit jeden soubor Pythonu, který obsahuje kód aplikace. Důležité je, že potřebujete klíč prostředku Foundry, koncový bod a název nasazeného modelu.
Poznámka:
Když nasadíte model v Foundry, má základní nebo původní název a původní název nasazení , který mu dáte. Foundry hostuje nasazený model (například modely GPT třídy s vizuálními schopnostmi) a poskytuje vám koncový bod.
V příkladu kódu vytvoříte klienta, nasměrujete ho na svůj koncový bod a jako předáte MODEL_NAME (název, který jste modelu dali).
import os
from openai import OpenAI

# Environment variables you set locally or in your app service:
FOUNDRY_KEY = "... your key ..."
ENDPOINT = "https://YOUR-RESOURCE-NAME.openai.azure.com/openai/v1/"
MODEL_NAME = "your-model-deployment-name"  # e.g., "gpt-4.1-mini" deployed as "my-vision-deploy"

client = OpenAI(
    api_key=os.getenv("FOUNDRY_KEY"),
    base_url=os.getenv("ENDPOINT"),
)

image_url = ""

response = client.responses.create(
    model=os.getenv("MODEL_NAME"),  # your deployment name
    input=[
        {
            "role": "user",
            "content": [
                {"type": "input_text", "text": "What is in this image? Provide 3 bullet points."},
                {"type": "input_image", "image_url": image_url}
            ],
        }
    ],
)

print(response.output_text)
Příklad klientské aplikace
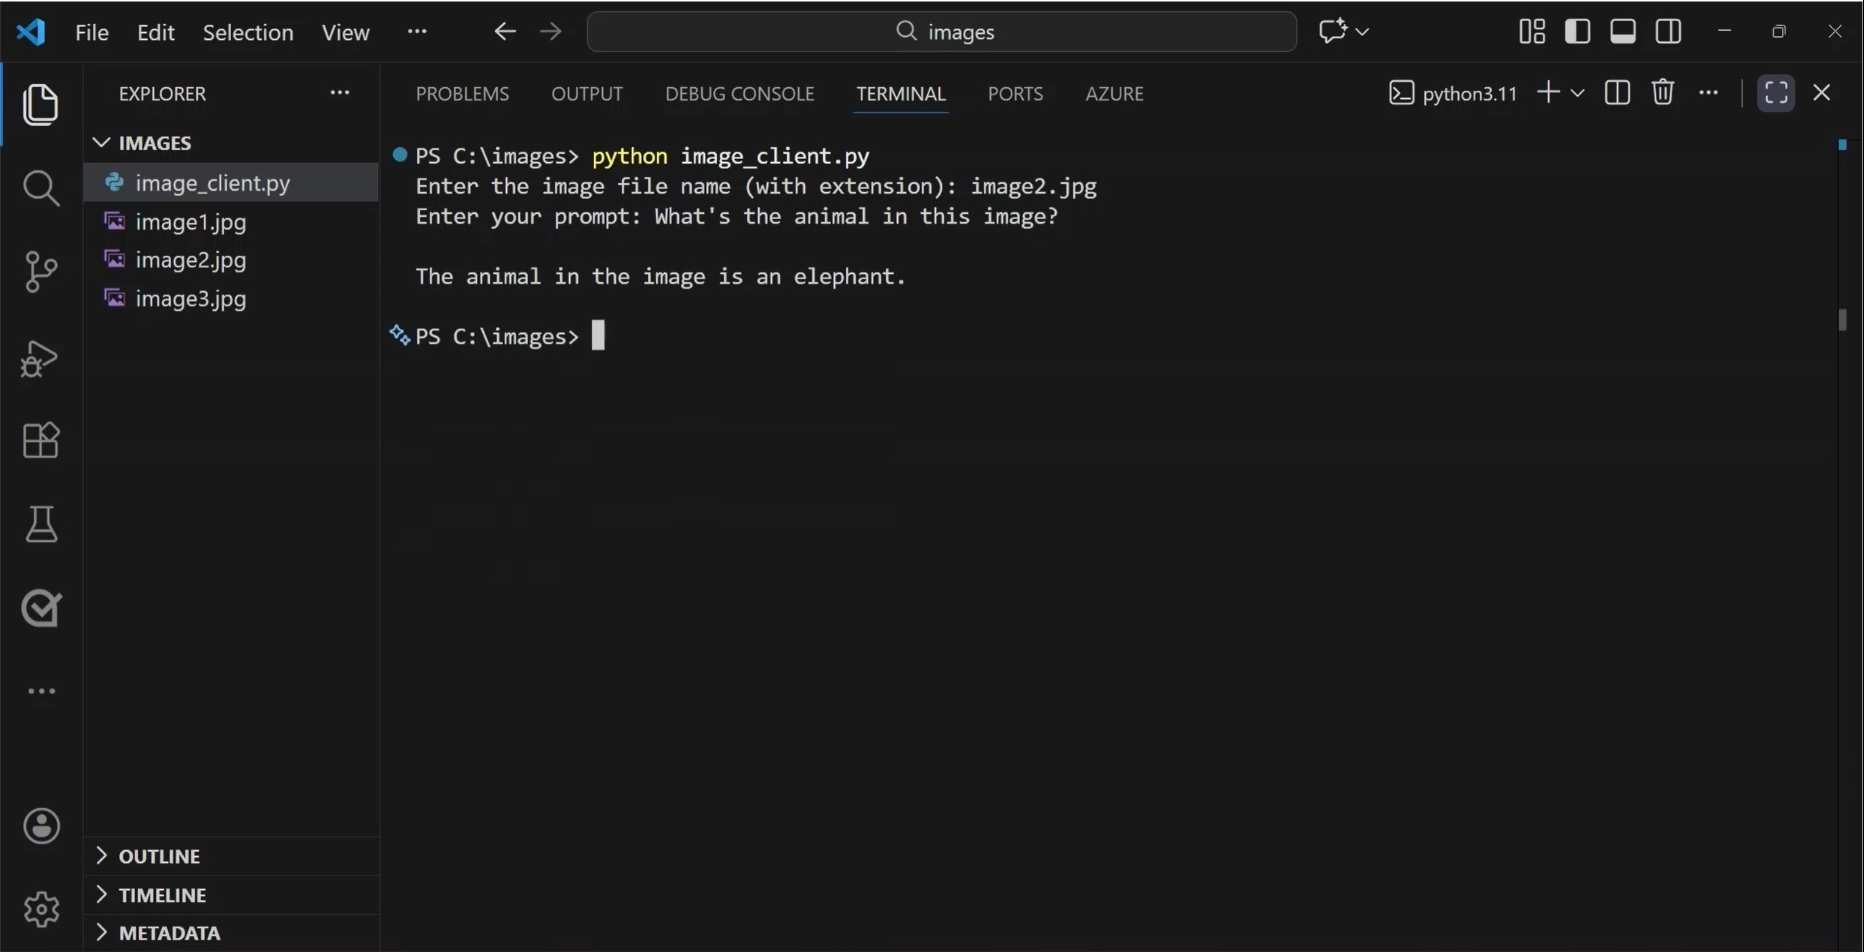
Můžete vytvořit vlastní aplikaci, která používá model s podporou zpracování obrazu k analýze obrázku pomocí sady OpenAI Python SDK. Předpokládejme například, že chcete vytvořit aplikaci, která dokáže identifikovat zvířata fotografovaná v Safari. Fotky můžete nahrát a vytvořit soubor Pythonu v editoru kódu.
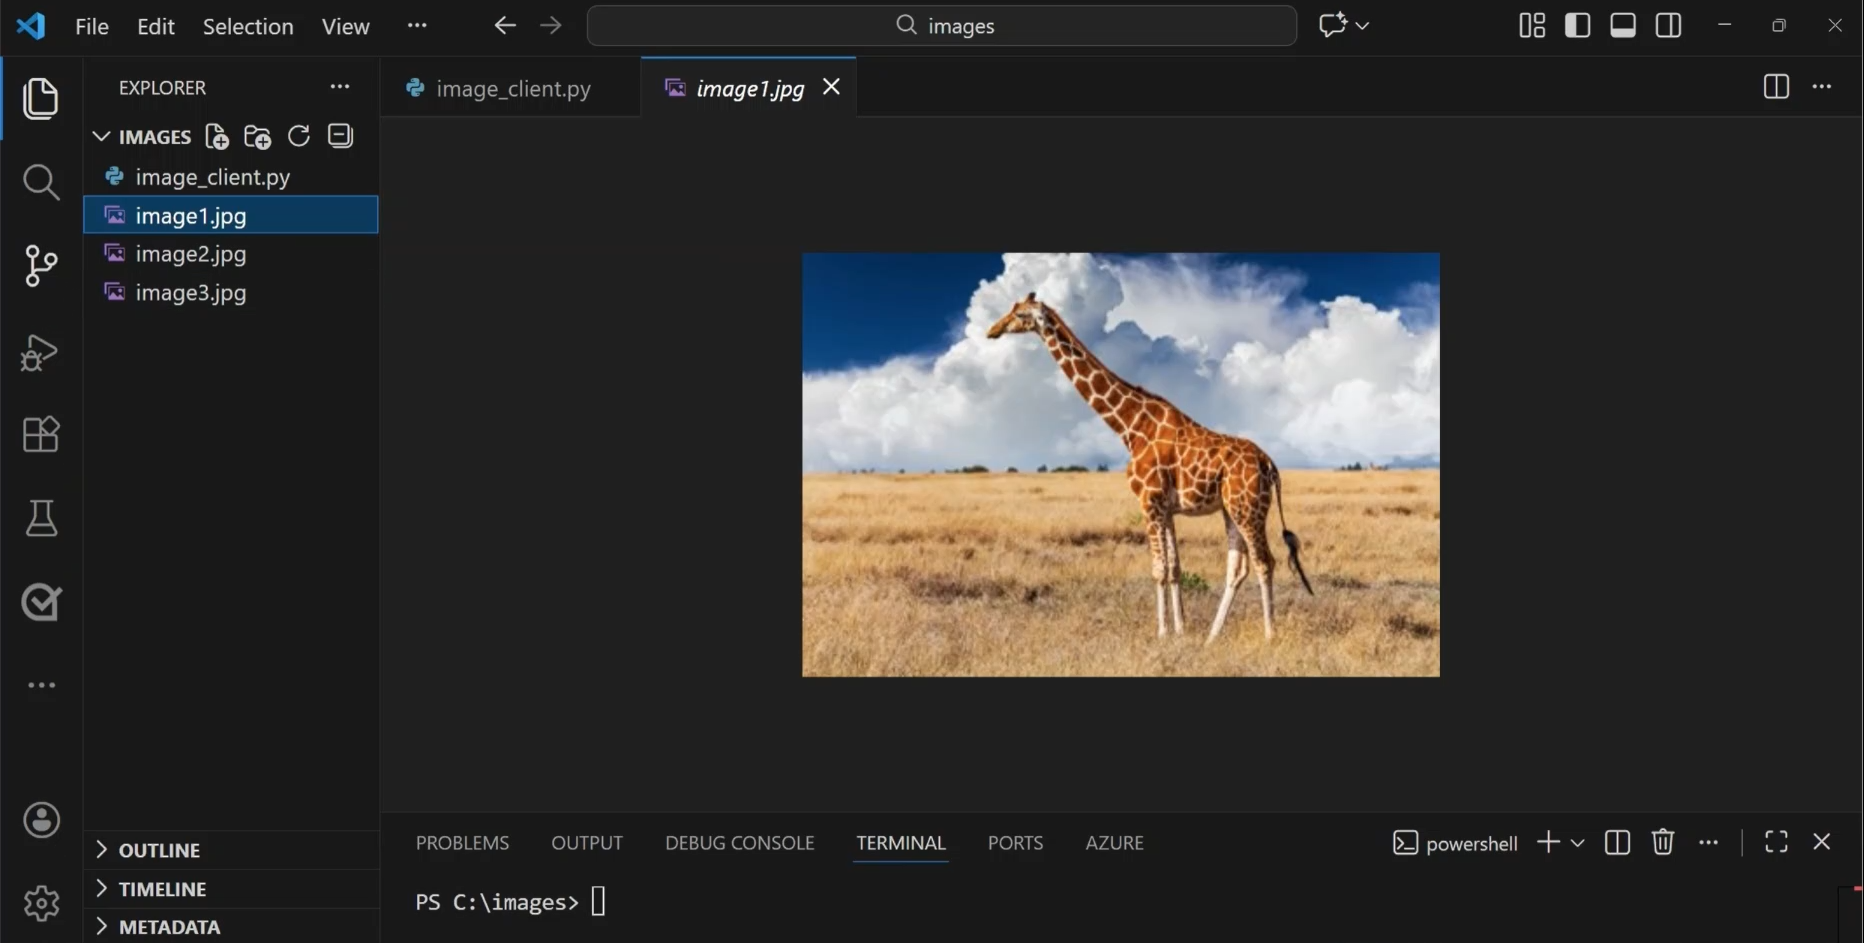
Pak můžete napsat kód aplikace, který používá rozhraní OpenAI API pro připojení ke koncovému bodu modelu v Foundry.
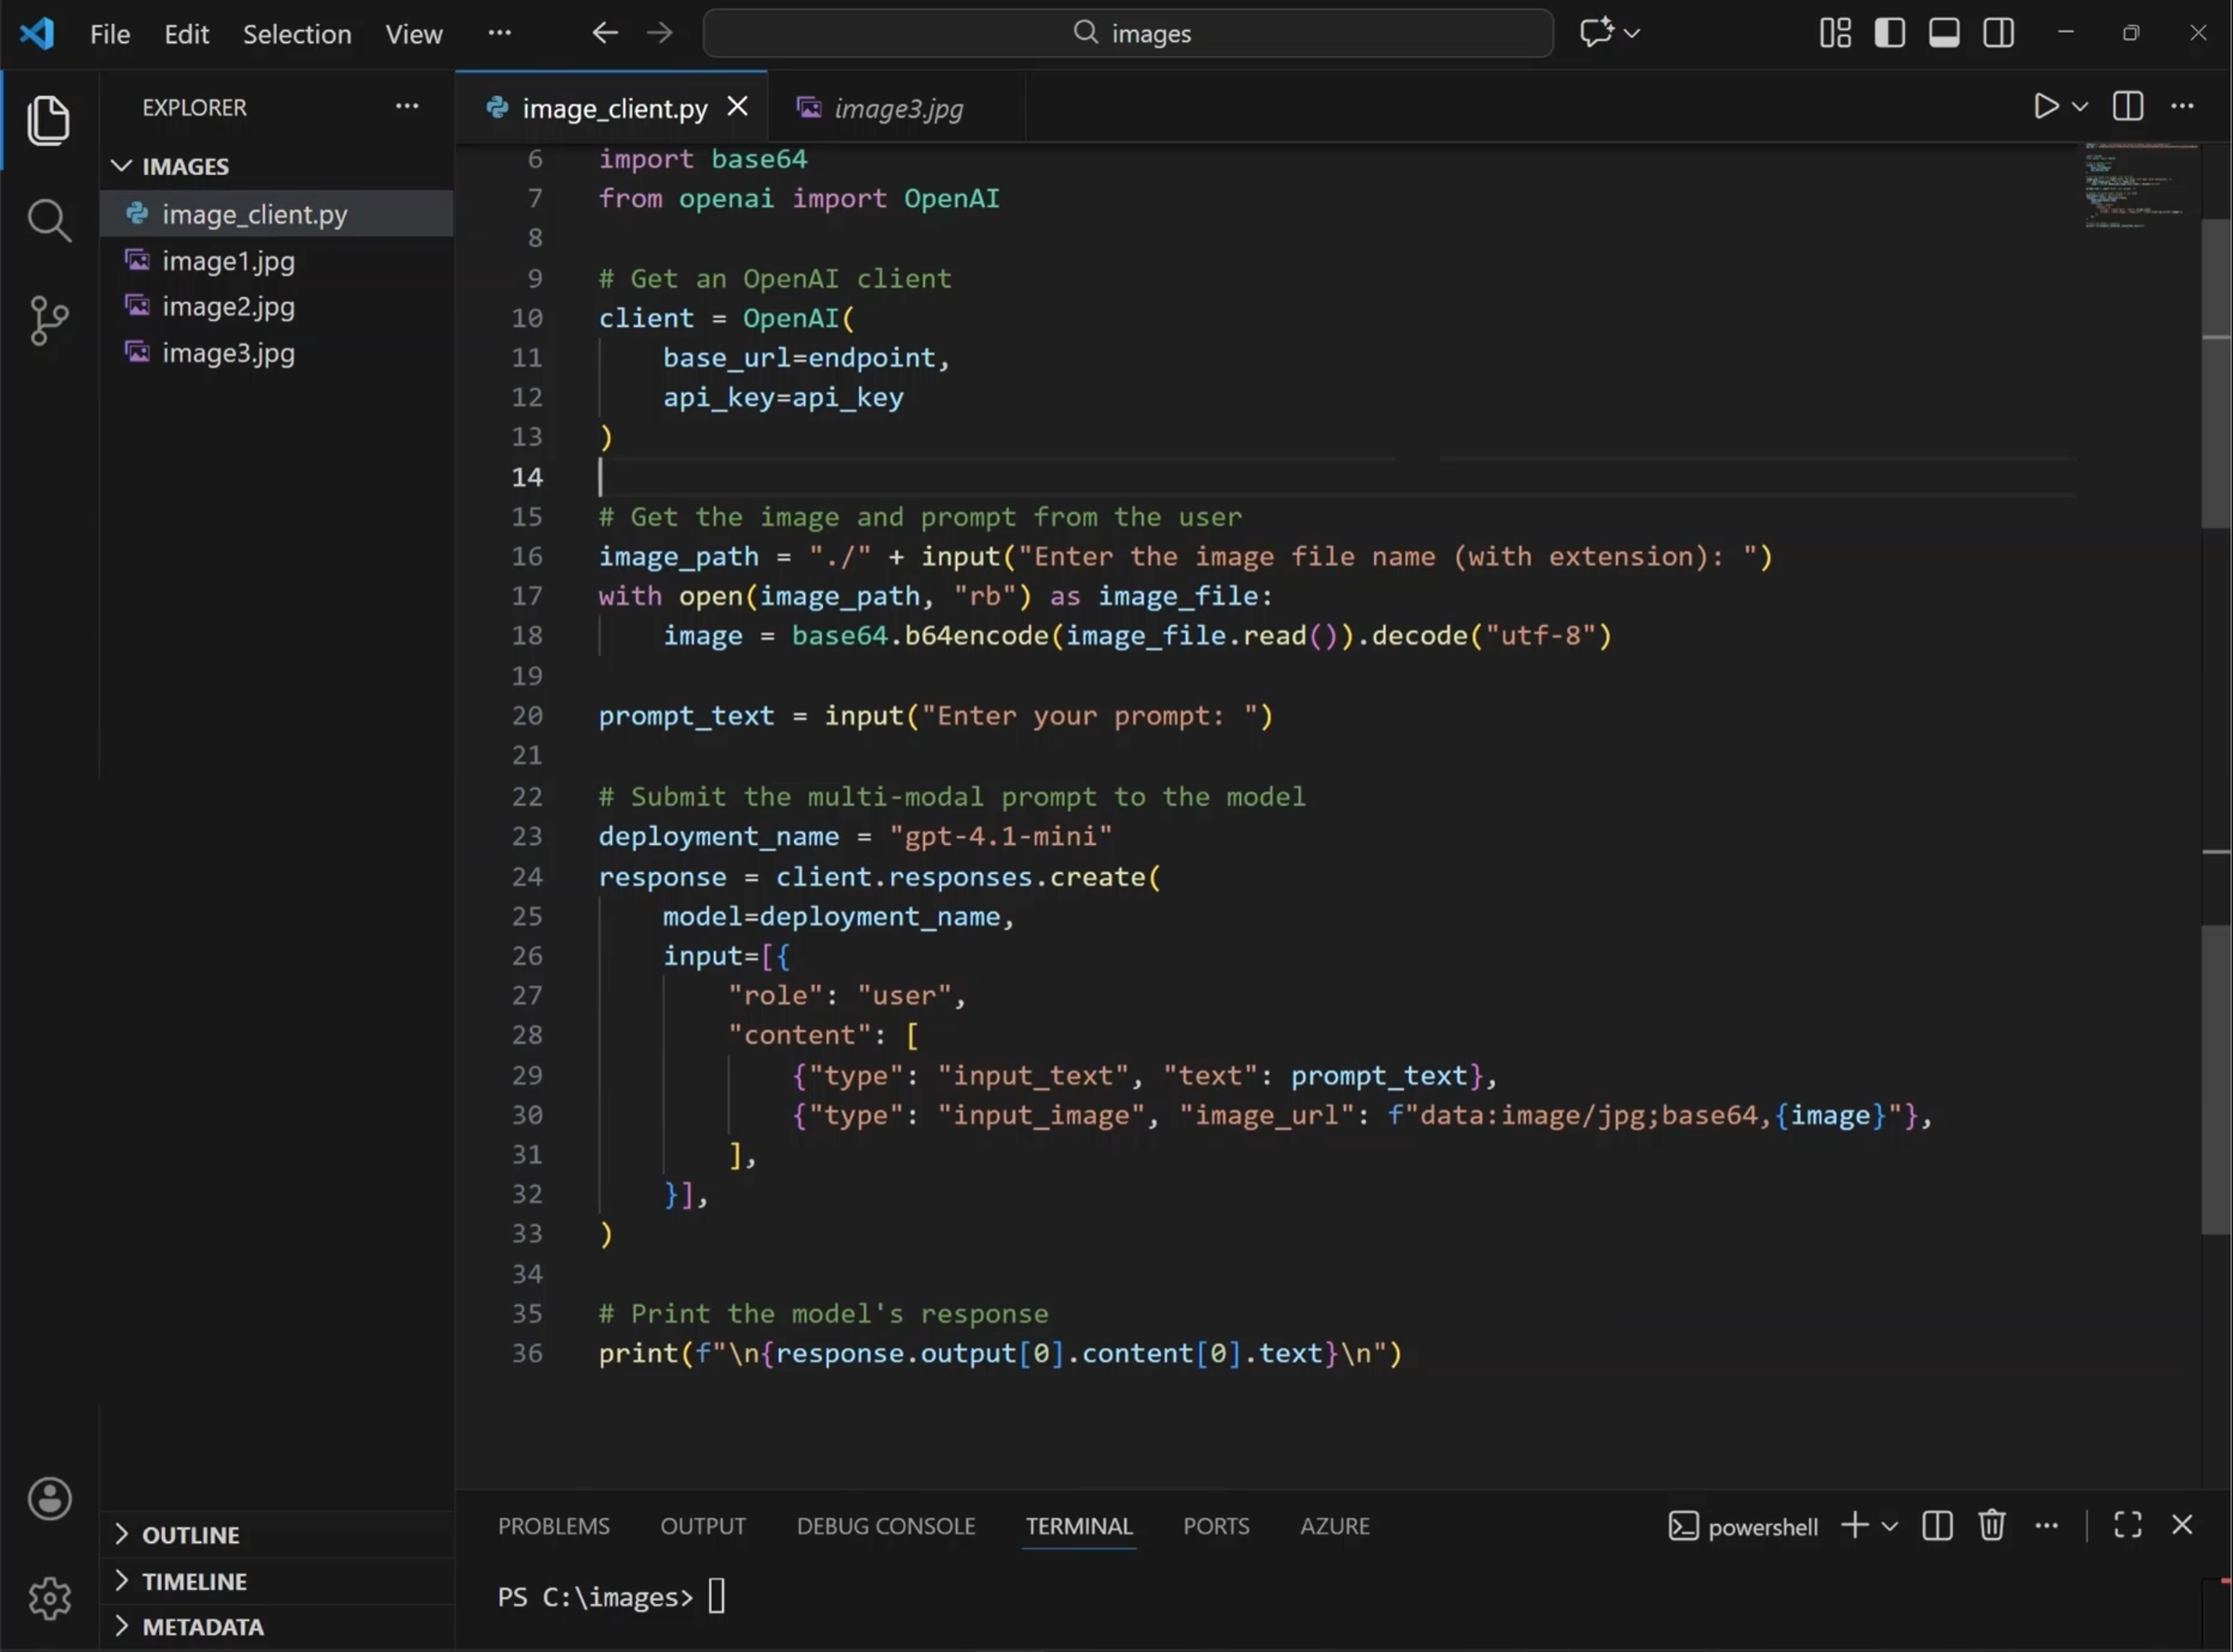
Kód aplikace potřebuje načíst data obrázku a získat výzvu přirozeného jazyka od uživatele. Pokud chcete odeslat vstup do modelu, musíte vytvořit vícedílnou zprávu, která obsahuje obrázek i textová data. Model může reagovat odpovídajícím výstupem na základě textu i obrázku na příkazovém řádku.
Dále se dozvíte, jak používat modely Foundry a sadu Azure OpenAI SDK pro generování imagí.