Co je klasifikace?
Binární klasifikace je klasifikace se dvěma kategoriemi. Můžeme například označovat pacienty jako ne-diabetik nebo diabetik.
Predikce třídy se provádí určením pravděpodobnosti pro každou možnou třídu jako hodnoty mezi 0 (nemožné) a 1 (určité). Celková pravděpodobnost pro všechny třídy je vždy 1, protože pacient je rozhodně buď diabetik nebo non-diabetic. Takže pokud je predikovaná pravděpodobnost, že pacient je diabetik, 0,3, pak existuje odpovídající pravděpodobnost 0,7, že pacient je nediabetik.
Prahová hodnota, často 0,5, se používá k určení predikované třídy. Pokud pozitivní třída (v tomto případě diabetik) má předpovězenou pravděpodobnost větší než prahová hodnota, pak se predikuje klasifikace diabetika.
Trénování a vyhodnocení klasifikačního modelu
Klasifikace je příkladem techniky strojového učení pod dohledem, což znamená, že spoléhá na data, která obsahují známé hodnoty funkcí a známé hodnoty popisků. V tomto příkladu jsou hodnoty funkcí diagnostickými měřeními pro pacienty a hodnoty štítků jsou klasifikace jako nediabetik nebo diabetik. Klasifikační algoritmus slouží k přizpůsobení podmnožiny dat do funkce, která dokáže vypočítat pravděpodobnost každého popisku třídy z hodnot funkcí. Zbývající data se používají k vyhodnocení modelu porovnáním předpovědí generovaných z funkcí se známými popisky tříd.
Jednoduchý příklad
Pojďme se podívat na příklad, který vám pomůže vysvětlit klíčové principy. Předpokládejme, že máme následující údaje o pacientech, které se skládají z jednoho příznaku (hladiny glukózy v krvi), a označení třídy: 0 pro nediabetika, 1 pro diabetika.
| Glukóza v krvi | Diabetik |
|---|---|
| 82 | 0 |
| 92 | 0 |
| 112 | 1 |
| 102 | 0 |
| 115 | 1 |
| 107 | 1 |
| 87 | 0 |
| 120 | 1 |
| 83 | 0 |
| 119 | 1 |
| 104 | 1 |
| 105 | 0 |
| 86 | 0 |
| 109 | 1 |
K trénování klasifikačního modelu použijeme prvních osm pozorování a začneme vykreslením funkce glukózy v krvi (x) a predikovaného diabetického popisku (y).
Graf glukózy v krvi vykreslený ve vztahu k diabetesu (0 nebo 1) bez spojnice trendu.
Potřebujeme funkci, která vypočítá hodnotu pravděpodobnosti pro y na základě x (jinými slovy, potřebujeme funkci f(x) = y). Z grafu vidíte, že pacienti s nízkou hladinou glukózy v krvi jsou všichni ne diabetici, zatímco pacienti s vyšší hladinou glukózy v krvi jsou diabetici. Zdá se, že čím vyšší je hladina glukózy v krvi, tím pravděpodobnější je, že pacient je diabetik, přičemž inflexní bod je někde mezi 100 a 110. Potřebujeme přizpůsobit funkci, která vypočítá hodnotu mezi 0 a 1 pro y na tyto hodnoty.
Jednou z těchto funkcí je logistická funkce, která tvoří křivku s tvarem S (sigmoidal).
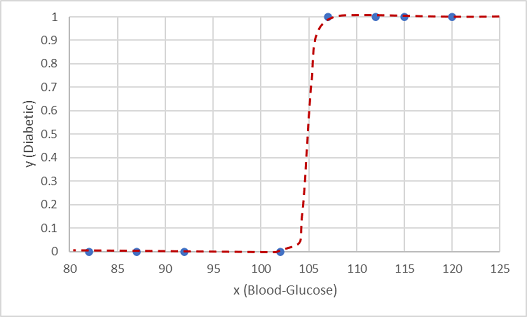
Teď můžeme funkci použít k výpočtu hodnoty pravděpodobnosti, že y je pozitivní, což znamená, že pacient je diabetik, z libovolné hodnoty x nalezením bodu na spojnici funkce pro x. Jako mezní bod pro predikci popisku třídy můžeme nastavit prahovou hodnotu 0,5.
Pojďme to otestovat pomocí dvou datových hodnot, které jsme si odložili stranou.
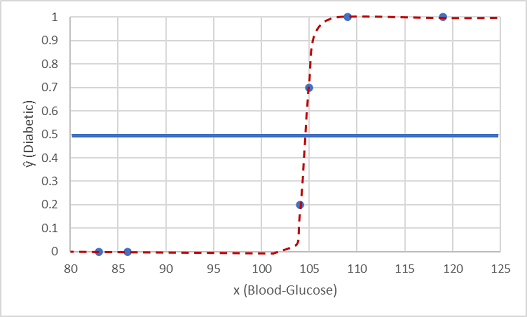
Body vykreslené pod prahovou čárou mají předpokládanou třídu 0 (nediabetik) a body nad čárou jsou předpokládány jako 1 (diabetik).
Nyní můžeme porovnat predikce štítků (ŷ nebo "y-hat"), na základě logistické funkce, která je obsažena v modelu, s popisky skutečné třídy (y).
| x | y | ŷ |
|---|---|---|
| 83 | 0 | 0 |
| 119 | 1 | 1 |
| 104 | 1 | 0 |
| 105 | 0 | 1 |
| 86 | 0 | 0 |
| 109 | 1 | 1 |