Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
Poznámka:
Pro větší funkčnost lze PyTorch použít také s DirectML ve Windows.
V předchozí fázi tohoto kurzu jsme získali datovou sadu, pomocí které vytrénujeme klasifikátor obrázků pomocí PyTorchu. Teď je čas tato data použít.
Pokud chcete vytrénovat klasifikátor obrázků pomocí PyTorch, musíte provést následující kroky:
- Načtěte data. Pokud jste provedli předchozí krok tohoto kurzu, už jste to zvládli.
- Definujte neurální síť konvoluce.
- Definujte funkci ztráty.
- Natrénujte model na trénovacích datech.
- Otestujte síť na testovacích datech.
Definujte neurální síť konvoluce.
K vytvoření neurální sítě pomocí PyTorchu použijete torch.nn balíček. Tento balíček obsahuje moduly, rozšiřitelné třídy a všechny požadované komponenty pro vytváření neurálních sítí.
Tady vytvoříte základní konvoluční neurální síť (CNN), která klasifikuje obrázky z datové sady CIFAR10.
Síť CNN je třída neurálních sítí definovaná jako vícevrstivá neurální sítě navržená k detekci složitých funkcí v datech. Nejčastěji se používají v aplikacích pro počítačové zpracování obrazu.
Naše síť bude strukturovaná s následujícími 14 vrstvami:
Conv -> BatchNorm -> ReLU -> Conv -> BatchNorm -> ReLU -> MaxPool -> Conv -> BatchNorm -> ReLU -> Conv -> BatchNorm -> ReLU -> Linear.
Konvoluční vrstva
Konvoluční vrstva je hlavní vrstva sítě CNN, která nám pomáhá detekovat funkce na obrázcích. Každá vrstva má počet kanálů pro detekci konkrétních funkcí na obrázcích a několik jader pro definování velikosti zjištěné funkce. Z tohoto důvodu by konvoluční vrstva s 64 kanály a velikost jádra 3 x 3 zjistila 64 různých funkcí, z nichž každá má velikost 3 x 3. Když definujete konvoluční vrstvu, zadáte počet v kanálech, počet mimo kanály a velikost jádra. Počet odsadových kanálů ve vrstvě slouží jako počet kanálů do další vrstvy.
Například: Konvoluční vrstva se vstupními kanály=3, výstupními kanály=10 a velikostí jádra=6 obdrží RGB obraz (3 kanály) jako vstup a aplikuje 10 naznačovačů vlastností na obrázky s velikostí jádra 6x6. Menší velikosti jader sníží výpočetní dobu a sdílení hmotnosti.
Další vrstvy
Do naší sítě se zapojují následující další vrstvy:
- Vrstva
ReLUje aktivační funkce definující všechny příchozí funkce, které mají být 0 nebo vyšší. Když použijete tuto vrstvu, změní se jakékoli číslo menší než 0 na nulu, zatímco ostatní se zachovávají stejně. - vrstva
BatchNorm2dna vstupech používá normalizaci tak, aby měla nulovou střední hodnotu a odchylku jednotek a zvýšila přesnost sítě. - Vrstva
MaxPoolnám pomůže zajistit, aby umístění objektu na obrázku nemělo vliv na schopnost neurální sítě zjišťovat jeho specifické funkce. - Vrstva
Linearje konečná vrstva v naší síti, která vypočítá skóre jednotlivých tříd. V datové sadě CIFAR10 je deset tříd označení. Popisek s nejvyšším skóre bude ten, který model předpoví. V lineární vrstvě musíte zadat počet vstupních funkcí a počet výstupních funkcí, které by měly odpovídat počtu tříd.
Jak funguje neurální síť?
Síť CNN je síť pro předávání informačních kanálů. Během trénování síť zpracuje vstup přes všechny vrstvy, vypočítá ztrátu, aby pochopila, jak daleko se předpovězený popisek obrázku liší od správného, a propašuje gradienty zpět do sítě za účelem aktualizace váhy vrstev. Iterací nad obrovskou datovou sadou vstupů se síť "naučí" nastavit své váhy, aby dosáhla nejlepších výsledků.
Funkce vpřed vypočítá hodnotu funkce ztráty a zpětná funkce vypočítá přechody zjistitelných parametrů. Když vytváříte naši neurální síť pomocí PyTorchu, stačí definovat funkci forward. Zpětná funkce bude automaticky definována.
- Zkopírujte do
PyTorchTraining.pysouboru v sadě Visual Studio následující kód, který definuje CCN.
import torch
import torch.nn as nn
import torchvision
import torch.nn.functional as F

# Define a convolution neural network
class Network(nn.Module):
    def __init__(self):
        super(Network, self).__init__()

        self.conv1 = nn.Conv2d(in_channels=3, out_channels=12, kernel_size=5, stride=1, padding=1)
        self.bn1 = nn.BatchNorm2d(12)
        self.conv2 = nn.Conv2d(in_channels=12, out_channels=12, kernel_size=5, stride=1, padding=1)
        self.bn2 = nn.BatchNorm2d(12)
        self.pool = nn.MaxPool2d(2,2)
        self.conv4 = nn.Conv2d(in_channels=12, out_channels=24, kernel_size=5, stride=1, padding=1)
        self.bn4 = nn.BatchNorm2d(24)
        self.conv5 = nn.Conv2d(in_channels=24, out_channels=24, kernel_size=5, stride=1, padding=1)
        self.bn5 = nn.BatchNorm2d(24)
        self.fc1 = nn.Linear(24*10*10, 10)

    def forward(self, input):
        output = F.relu(self.bn1(self.conv1(input)))
        output = F.relu(self.bn2(self.conv2(output)))
        output = self.pool(output)
        output = F.relu(self.bn4(self.conv4(output)))
        output = F.relu(self.bn5(self.conv5(output)))
        output = output.view(-1, 24*10*10)
        output = self.fc1(output)

        return output

# Instantiate a neural network model
model = Network()
Poznámka:
Zajímá vás další informace o neurální síti pomocí PyTorchu? Projděte si dokumentaci k PyTorchu.
Definování funkce ztráty
Funkce ztráty vypočítá hodnotu, která odhaduje, jak daleko je výstup od cíle. Hlavním cílem je snížit hodnotu funkce ztráty změnou hodnot vektoru hmotnosti prostřednictvím zpětného šíření v neurálních sítích.
Hodnota ztráty se liší od přesnosti modelu. Funkce ztráty nám dává představu o tom, jak dobře se model chová po každé iteraci optimalizace trénovací sady. Přesnost modelu se vypočítá na testovacích datech a zobrazí procento správné předpovědi.
V PyTorch obsahuje balíček neurální sítě různé funkce ztráty, které tvoří stavební bloky hlubokých neurálních sítí. V tomto kurzu použijete klasifikační ztrátovou funkci s klasifikační křížovou entropií a optimalizátor Adam. Rychlost učení (lr) určuje řízení toho, jak moc upravujete váhy naší sítě s ohledem na gradient ztráty. Nastavíte ji jako 0,001. Tím nižším je, tím pomalejší bude trénování.
- Zkopírujte do
PyTorchTraining.pysouboru v sadě Visual Studio následující kód, který definuje funkci ztráty a optimalizátor.
from torch.optim import Adam

# Define the loss function with Classification Cross-Entropy loss and an optimizer with Adam optimizer
loss_fn = nn.CrossEntropyLoss()
optimizer = Adam(model.parameters(), lr=0.001, weight_decay=0.0001)
Natrénujte model na trénovacích datech.
Pokud chcete model vytrénovat, musíte procházet přes iterátor dat, předat vstupy do sítě a optimalizovat. PyTorch nemá vyhrazenou knihovnu pro použití GPU, ale můžete ručně definovat spouštěcí zařízení. Zařízení bude Nvidia GPU, pokud se ve vašem počítači nachází, nebo CPU, pokud ne.
- Do souboru přidejte následující kód
PyTorchTraining.py.
from torch.autograd import Variable

# Function to save the model
def saveModel():
    path = "./myFirstModel.pth"
    torch.save(model.state_dict(), path)

# Function to test the model with the test dataset and print the accuracy for the test images
def testAccuracy():

    model.eval()
    accuracy = 0.0
    total = 0.0
    device = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")

    with torch.no_grad():
        for data in test_loader:
            images, labels = data
            # run the model on the test set to predict labels
            outputs = model(images.to(device))
            # the label with the highest energy will be our prediction
            _, predicted = torch.max(outputs.data, 1)
            total += labels.size(0)
            accuracy += (predicted == labels.to(device)).sum().item()

    # compute the accuracy over all test images
    accuracy = (100 * accuracy / total)
    return(accuracy)


# Training function. We simply have to loop over our data iterator and feed the inputs to the network and optimize.
def train(num_epochs):

    best_accuracy = 0.0

    # Define your execution device
    device = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")
    print("The model will be running on", device, "device")
    # Convert model parameters and buffers to CPU or Cuda
    model.to(device)

    for epoch in range(num_epochs):  # loop over the dataset multiple times
        running_loss = 0.0
        running_acc = 0.0

        for i, (images, labels) in enumerate(train_loader, 0):

            # get the inputs
            images = Variable(images.to(device))
            labels = Variable(labels.to(device))

            # zero the parameter gradients
            optimizer.zero_grad()
            # predict classes using images from the training set
            outputs = model(images)
            # compute the loss based on model output and real labels
            loss = loss_fn(outputs, labels)
            # backpropagate the loss
            loss.backward()
            # adjust parameters based on the calculated gradients
            optimizer.step()

            # Let's print statistics for every 1,000 images
            running_loss += loss.item()     # extract the loss value
            if i % 1000 == 999:
                # print every 1000 (twice per epoch)
                print('[%d, %5d] loss: %.3f' %
                      (epoch + 1, i + 1, running_loss / 1000))
                # zero the loss
                running_loss = 0.0

        # Compute and print the average accuracy fo this epoch when tested over all 10000 test images
        accuracy = testAccuracy()
        print('For epoch', epoch+1,'the test accuracy over the whole test set is %d %%' % (accuracy))

        # we want to save the model if the accuracy is the best
        if accuracy > best_accuracy:
            saveModel()
            best_accuracy = accuracy
Otestujte model na testovacích datech.
Model teď můžete otestovat pomocí dávky obrázků z naší testovací sady.
- Do souboru
PyTorchTraining.pypřidejte následující kód.
import matplotlib.pyplot as plt
import numpy as np

# Function to show the images
def imageshow(img):
    img = img / 2 + 0.5     # unnormalize
    npimg = img.numpy()
    plt.imshow(np.transpose(npimg, (1, 2, 0)))
    plt.show()


# Function to test the model with a batch of images and show the labels predictions
def testBatch():
    # get batch of images from the test DataLoader
    images, labels = next(iter(test_loader))

    # show all images as one image grid
    imageshow(torchvision.utils.make_grid(images))

    # Show the real labels on the screen
    print('Real labels: ', ' '.join('%5s' % classes[labels[j]]
                               for j in range(batch_size)))

    # Let's see what if the model identifiers the  labels of those example
    outputs = model(images)

    # We got the probability for every 10 labels. The highest (max) probability should be correct label
    _, predicted = torch.max(outputs, 1)

    # Let's show the predicted labels on the screen to compare with the real ones
    print('Predicted: ', ' '.join('%5s' % classes[predicted[j]]
                              for j in range(batch_size)))
Nakonec přidáme hlavní kód. Tím zahájíte trénování modelu, uložíte ho a zobrazíte výsledky na obrazovce. Na trénovací sadě spustíme jenom dvě iterace [train(2)] , takže proces trénování nebude trvat příliš dlouho.
- Do souboru
PyTorchTraining.pypřidejte následující kód.
if __name__ == "__main__":

    # Let's build our model
    train(5)
    print('Finished Training')

    # Test which classes performed well
    testAccuracy()

    # Let's load the model we just created and test the accuracy per label
    model = Network()
    path = "myFirstModel.pth"
    model.load_state_dict(torch.load(path))

    # Test with batch of images
    testBatch()
Pojďme test spustit! Ujistěte se, že rozevírací nabídky na horním panelu nástrojů jsou nastavené na Ladit. Změňte platformu řešení na x64 a spusťte projekt na místním počítači, pokud je vaše zařízení 64bitové, nebo x86, pokud je 32bitová.
Když zvolíte počet epoch (počet dokončených průchodů trénovací datovou sadou) na dvě ([train(2)]), výsledkem bude dvojnásobný průchod celou testovací datovou sadou obsahující 10 000 obrázků. Dokončení trénování procesoru Intel 8. generace bude trvat přibližně 20 minut a model by měl dosáhnout více nebo méně než 65% úspěšnosti při klasifikaci deseti popisků.
- Pokud chcete projekt spustit, klikněte na tlačítko Spustit ladění na panelu nástrojů nebo stiskněte klávesu F5.
Otevře se okno konzoly a zobrazí se proces trénování.
Jak jste definovali, hodnota ztráty se vytiskne každých 1 000 dávek obrázků nebo pětkrát pro každou iteraci v trénovací sadě. Očekáváte, že se hodnota ztráty sníží v každém cyklu.
Po každé iteraci uvidíte také přesnost modelu. Přesnost modelu se liší od hodnoty ztráty. Funkce ztráty nám dává představu o tom, jak dobře se model chová po každé iteraci optimalizace trénovací sady. Přesnost modelu se vypočítá na testovacích datech a zobrazí procento správné předpovědi. V našem případě nám řekne, kolik obrázků z testovací sady 10 000 obrázků, byl náš model schopen správně klasifikovat po každé trénovací iteraci.
Po dokončení trénování byste měli očekávat, že uvidíte výstup podobný následujícímu. Vaše čísla nebudou úplně stejná – trianing závisí na mnoha faktorech a ne vždy vrátí identifikální výsledky, ale měly by vypadat podobně.
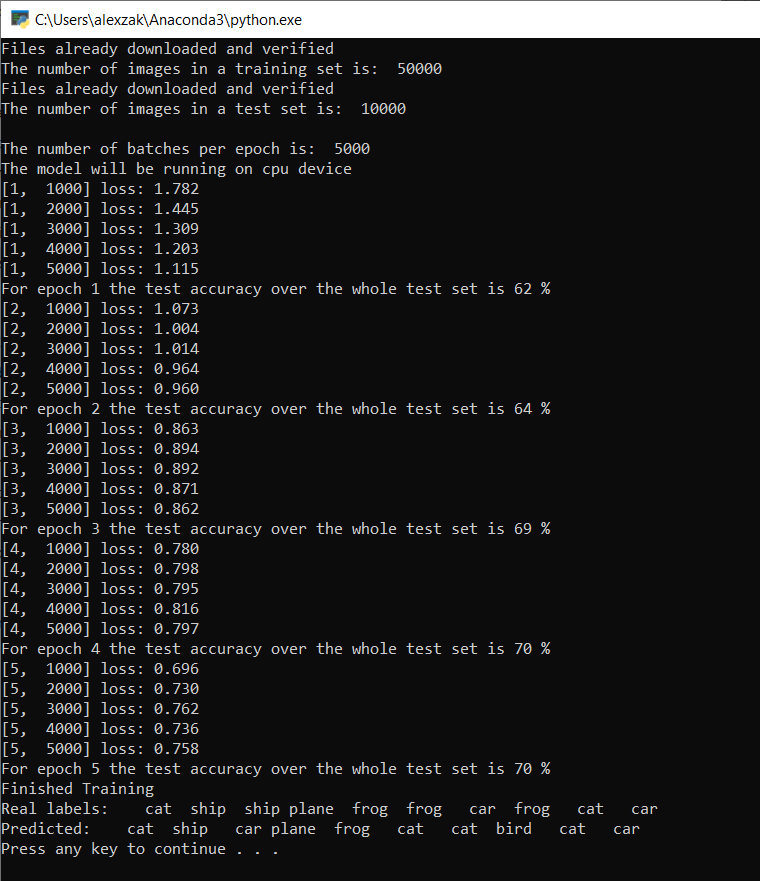
Po absolvování pouhých 5 epoch je úspěšnost modelu 70%. Jedná se o dobrý výsledek pro základní model natrénovaný po krátkou dobu!
Model při testování s dávkou obrázků správně identifikoval 7 z 10 obrázků. Není to vůbec špatné a konzistentní s úspěšností modelu.
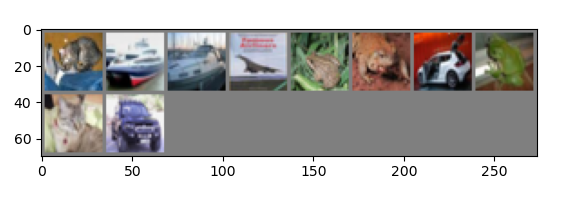
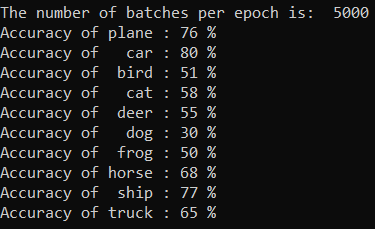
Můžete zkontrolovat, které třídy náš model dokáže nejlépe předpovědět. Jednoduše přidejte a spusťte následující kód:
-
Volitelné – přidejte do
testClassesssouboru následujícíPyTorchTraining.pyfunkci, přidejte volání této funkce -testClassess()uvnitř hlavní funkce -__name__ == "__main__".
# Function to test what classes performed well
def testClassess():
    class_correct = list(0. for i in range(number_of_labels))
    class_total = list(0. for i in range(number_of_labels))
    with torch.no_grad():
        for data in test_loader:
            images, labels = data
            outputs = model(images)
            _, predicted = torch.max(outputs, 1)
            c = (predicted == labels).squeeze()
            for i in range(batch_size):
                label = labels[i]
                class_correct[label] += c[i].item()
                class_total[label] += 1

    for i in range(number_of_labels):
        print('Accuracy of %5s : %2d %%' % (
            classes[i], 100 * class_correct[i] / class_total[i]))
Výstup je následující:
Další kroky
Teď, když máme klasifikační model, je dalším krokem převod modelu do formátu ONNX.