Bemærk
Adgang til denne side kræver godkendelse. Du kan prøve at logge på eller ændre mapper.
Adgang til denne side kræver godkendelse. Du kan prøve at ændre mapper.
Eventstream i Microsoft Fabric er en fuldt administreret event intaketion og streaming-tjeneste, der muliggør realtidsdatabehandling og analyse. Du kan integrere eventstream med Fabric-notebooks ved hjælp af Spark Structured Streaming til at behandle og analysere streamingdata i realtid.
Denne integration gør det muligt for dig at udforske eventstreams og andre realtidskilder via Real-Time-hubben, direkte fra dine Fabric notesbøger. Du kan også oprette nye eventstreams og begynde at indsamle data fra næsten 30 (og voksende) streamingkilder, herunder CDC-aktiverede databaser, beskedmæglere, streamingtjenester og offentlige feeds. Den nye programmeringsmodel gør det nemt at forbinde til eventstream, læse streamingdata og udføre realtidsanalyser ved hjælp af velkendte Spark API'er uden nogen forbindelsesstrenge eller legitimationsoplysninger, hvilket gør det mere sikkert at bygge realtidsapplikationer
Forudsætninger
Før du begynder, skal du sikre dig, at du har følgende forudsætninger på plads:
- Et Fabric-arbejdsområde med eventstream aktiveret.
- Et notesbogsmiljø sat op i Fabric.
- Grundlæggende viden om Spark Structured Streaming og PySpark eller Scala.
Trin til at forespørge Eventstream fra en notesbog
Opdag og tilføj eventstream til Notebook:
Åbn din Microsoft Fabric-notesbog.
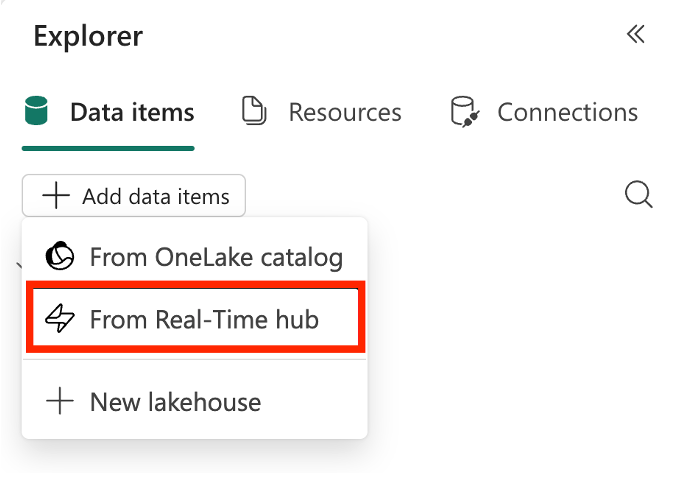
Vælg ' Tilføj dataelementer ' under fanen Dataelementer , og vælg derefter Fra Real-Time hub i rullemenuen.
I dialogen Real-Time hub skal du finde den ønskede eventstream, du vil forespørge i, med forskellige søge- og filtermuligheder.
Tilføj eventstreamen til dit notesbogsmiljø.
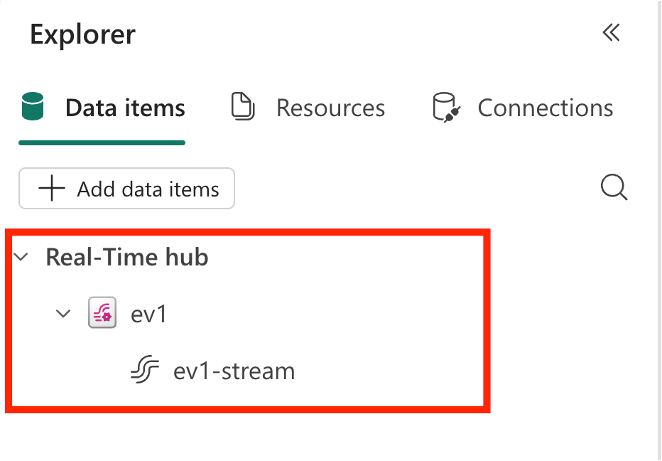
Efter eventstream-elementet er tilføjet, vil det dukke op under Real-Time-hub-noden i din notebook object explorer med itemnavnet, og efter udvidelse af noden vil du se standard- eller afledte streamen inden for eventstream-elementet.
Læs streamingdata fra eventstream:
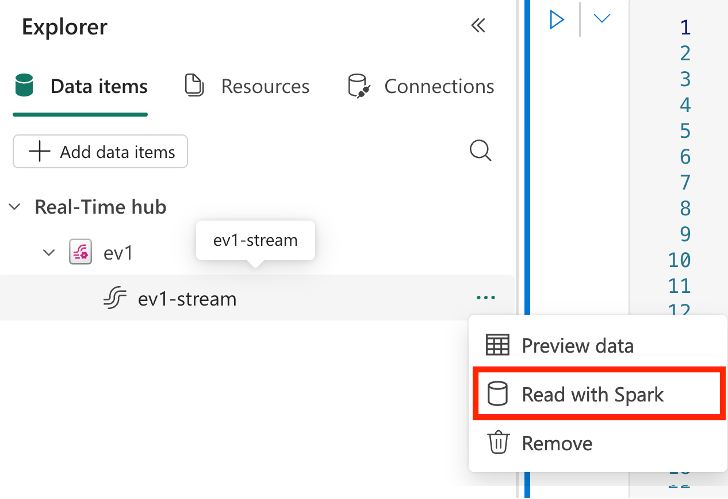
Fra kontekstmenuen for eventstream-elementet i objektexploreren vælger du Read with Spark for at oprette en forudkonfigureret kodecelle, der skal læses fra den valgte eventstream.
I den nyoprettede kodecelle kan du bruge følgende PySpark-kodeuddrag til at læse streamingdata fra eventstreamen:
from pyspark.sql import SparkSession
from pyspark.sql.functions import col
from pyspark.sql.types import StringType
from pyspark.sql.dataframe import DataFrame

eventstream_options = {
    "eventstream.itemid": __in_eventstream_item_id,
    "eventstream.datasourceid": __in_eventstream_datasource_id
}

# Read from Kafka using the config map
df_raw = spark.readStream.format("kafka").options(**eventstream_options).load()

decoded_df = df_raw.select(
    col("key").cast(StringType()).alias("key"),
    col("value").cast(StringType()).alias("value"),
    col("partition"),
    col("offset")
)

def showDf(x:DataFrame, y:int):
    x.show()

# Print messages to the console
query = decoded_df.writeStream.foreachBatch(showDf).outputMode("append").start()
query.awaitTermination()
Værdien af og-mulighederne
eventstream.itemideventstream.datasourceidudfyldes automatisk i parameterkodecellen over denne kodecelle.Notat
For hvert valg på Read with Spark genereres en ny kodecelle med de nødvendige parametre automatisk udfyldt, og en ny Notebook-destination oprettes for Eventstream-elementet, hvor den
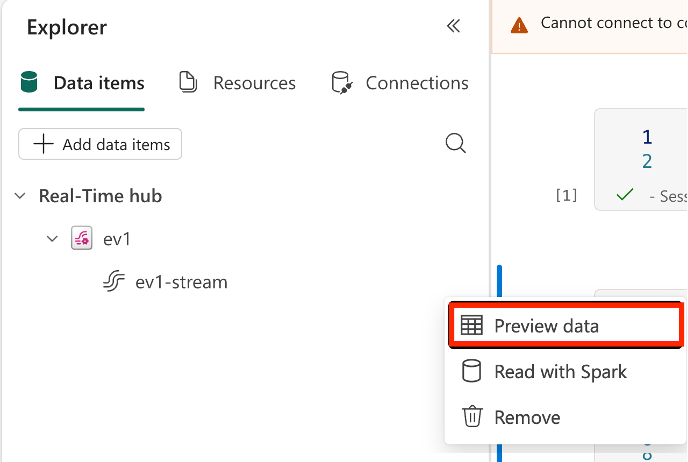
eventstream.datasourceider unik for hver Notebook-destination. For ét notesbogselement anbefaler vi, at du sætter det én gang som destination for ét Eventstream-element for at undgå at oprette flere destinationer.Før du kører et job, kan du også forhåndsvise streamingdataene ved at klikke på knappen Forhåndsvis data i kontekstmenuen for Eventstream-elementet. Et sidepanel åbner og viser et øjebliksbillede af de strømmende data ved siden af notesbogen.
Tilføj notebook som destination: Du kan også tilføje notebooken som destination for Eventstream, så Eventstreamen begynder at indlæse data i Eventstream inde i notesbogen. For mere information, se Tilføj en Spark Notebook-destination til en eventstream.
Konklusion
Integration af eventstream i Fabric med notebooks ved hjælp af Spark Structured Streaming gør det muligt for dig at behandle og analysere realtidsdata problemfrit. Ved at følge trinene beskrevet i denne artikel kan du nemt forbinde til Eventstream, læse streamingdata og udføre realtidsanalyser ved hjælp af velkendte Spark API'er. Denne integration åbner nye muligheder for at bygge realtidsapplikationer og opnå indsigt fra streaming af data inden for Fabric-økosystemet.
Relateret indhold
For at lære mere om at arbejde med eventstreams og notesbøger i Fabric, kan du tjekke følgende ressourcer