Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Generieren Sie vorab aufgefüllte Ansichten über Daten in einem oder mehreren Datenspeichern, wenn die Daten nicht ideal für erforderliche Abfragevorgänge formatiert sind. Dieser Ansatz kann eine effiziente Abfrage- und Datenextraktion unterstützen und die Anwendungsleistung verbessern.
Kontext und Problem
Beim Speichern von Daten priorisieren Entwickler und Datenadministratoren häufig, wie die Daten gespeichert werden, anstatt wie sie gelesen werden. Das ausgewählte Speicherformat entspricht in der Regel dem Format der Daten, den Anforderungen für die Verwaltung von Datengröße und Datenintegrität und der Art des verwendeten Speichers. Wenn Sie beispielsweise einen NoSQL Dokumentspeicher verwenden, stellen Sie die Daten häufig als Eine Reihe von Aggregaten dar, die alle Informationen für diese Entität enthalten.
Dieser Ansatz kann sich jedoch negativ auf Abfragen auswirken. Wenn für eine Abfrage nur eine Teilmenge der Daten einiger Entitäten benötigt wird, z.B. eine Zusammenfassung der Bestellungen von mehreren Kunden ohne sämtliche Bestelldetails, müssen alle Daten für die relevanten Entitäten extrahiert werden, um die erforderlichen Informationen abzurufen.
Das Hinzufügen von Indizes oder das Anpassen von Abfragen beim Lesen behebt diese Ineffizienz nicht immer. Viele Speichersysteme lassen sich nicht für beliebige Lesezugriffsmuster neu indizieren, ohne die Schreibleistung zu beeinträchtigen. Die entitätsübergreifende Aggregation bleibt zur Abfragezeit teuer. Einige Stores haben absichtlich nur eingeschränkte Abfragemöglichkeiten. Aufgrund dieser Einschränkungen reicht die Optimierung des Lesepfads innerhalb des Quellspeichers häufig nicht aus.
Solution
Zur Unterstützung einer effizienten Abfrage besteht eine gängige Lösung darin, im Voraus eine Ansicht zu generieren, die die Daten in einem Format materialisiert, das für das erforderliche Resultset geeignet ist. Mit dem Muster für materialisierte Sichten wird das Generieren vorausgefüllter Sichten von Daten in Umgebungen beschrieben, in denen die Quelldaten nicht in einem geeigneten Format für Abfragen vorliegen, in denen das Generieren einer Abfrage schwierig ist oder in denen die Abfrageleistung aufgrund der Art der Daten oder des Datenspeichers schlecht ist.
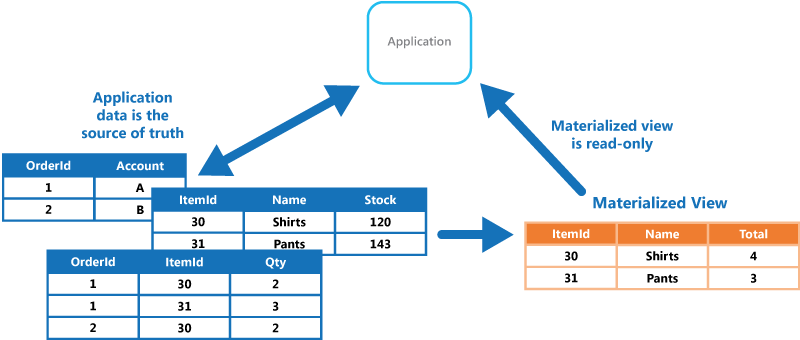
Bei diesem Muster handelt es sich bei einer materialisierten Ansicht um ein Lesemodell oder eine Projektion, das Daten enthält, die aus einem oder mehreren Quellspeichern abgeleitet sind. Eine dedizierte Anwendungskomponente oder Datenpipeline kann die Projektion verwalten, einschließlich über Speichergrenzen hinweg. Abfrage-Clients behandeln die Projektion als schreibgeschützt. Dieses Architekturkonzept ist breiter als ein datenbankeigenes materialisiertes Ansichtsobjekt, das ein Datenbankmodul definiert, speichert und aktualisiert gemäß seinen eigenen Featureeinschränkungen.
Diese materialisierten Ansichten, die nur Daten enthalten, die von einer Abfrage benötigt werden, ermöglichen Anwendungen das schnelle Abrufen der benötigten Informationen. Zusätzlich zum Verknüpfen von Tabellen oder Kombinieren von Datenentitäten können materialisierte Sichten die aktuellen Werte von berechneten Spalten oder Datenelementen, die Ergebnisse der Kombination von Werten oder der Ausführung von Transformationen mit den Datenelementen und Werte, die als Teil der Abfrage angegeben werden, enthalten. Eine materialisierte Ansicht kann sogar für eine einzelne Abfrage optimiert werden.
Ein wichtiger Punkt ist, dass eine materialisierte Ansicht und die darin enthaltenen Daten vollständig verfügbar sind, da sie vollständig aus den Quelldatenspeichern neu erstellt werden können. Abfragenutzer aktualisieren die Ansicht nicht direkt. Stattdessen verwaltet ein dediziertes Komponenten-, Datenpipeline- oder Datenbankmodul sie, sodass es sich um einen speziellen Cache handeln kann.
Wenn sich die Quelldaten für die Ansicht ändern, muss die Ansicht aktualisiert werden, um die neuen Informationen einzuschließen. Sie können diese Aktualisierung automatisch planen oder wenn das System eine Änderung der ursprünglichen Daten erkennt. In einigen Fällen müssen Sie die Ansicht möglicherweise manuell neu erstellen. Die folgende Abbildung zeigt ein Beispiel für die Verwendung des Materialisierten Ansichtsmusters.
Probleme und Überlegungen
Berücksichtigen Sie die folgenden Punkte, wenn Sie sich für die Implementierung dieses Musters entscheiden:
Aktualisierungsstrategie anzeigen. Idealerweise wird die Ansicht als Reaktion auf ein Ereignis, das auf eine Änderung der Quelldaten hinweist, neu generiert, obwohl dieser Ansatz zu erheblichem Zusatzaufwand führen kann, wenn sich die Quelldaten schnell ändern. Erwägen Sie alternativ, eine geplante Aufgabe, einen externen Trigger oder eine manuelle Aktion zu verwenden, um die Ansicht neu zu generieren.
Aktualisierungsverhalten. Ermitteln Sie, ob die Implementierung eine vollständige Neuerstellung durchführt oder inkrementelle Änderungen anwendet. Sie müssen auch entscheiden, ob die Aktualisierungsvorgänge Lesevorgänge blockieren.
Diese Entscheidungen bestimmen, ob Abfragen potenziell veraltete materialisierte Daten zurückgeben, materialisierte Daten mit nicht verarbeiteten Quelländerungen kombinieren, um aktuelle Ergebnisse zurückzugeben oder die letzte vollständige Version bis zum Abschluss der Aktualisierung weiter zu bedienen.
Zuverlässigkeit des Refresh-Signals. Wenn das Aktivierungssignal, das die Regenerierung der Ansicht auslöst, verloren geht oder verzögert wird – zum Beispiel durch ein verpasstes Änderungsfeed-Ereignis oder eine fehlgeschlagene geplante Aufgabe –, liefert die Ansicht unbemerkt veraltete Ergebnisse. Überwachen Sie die Aktualität der Daten, und lösen Sie eine Warnung aus, wenn das Alter der Ansicht das zulässige Verfallsfenster überschreitet.
Aktualisieren Sie die Rechenkosten. Durch das Generieren einer Ansicht werden Computeressourcen proportional zum Volumen der Quelldaten und die Komplexität der Transformationen verbraucht. Bei einer ereignisgesteuerten Aktualisierung bei schnell sich ändernden Quelldaten oder für vollständige Neuerstellung großer analytischer Ansichten kann die Berechnungskosten der Aktualisierung ein erheblicher Kostentreiber sein. Passen Sie Aktualisierungshäufigkeit und Umfang angemessen an, um die Aktualität der Daten mit den Rechenkosten in Einklang zu bringen.
Abhängigkeit von Event Sourcing. In einigen Systemen, z. B. wenn Sie das Event Sourcing-Muster verwenden, um nur die Ereignisse zu speichern, die die Daten geändert haben, sind materialisierte Ansichten in der Regel erforderlich. Das Vorausfüllen von Sichten, indem alle Ereignisse überprüft werden, um den aktuellen Status zu bestimmen, ist möglicherweise die einzige Möglichkeit zum Abrufen von Informationen aus dem Ereignisspeicher. Wenn Sie event Sourcing nicht verwenden, überlegen Sie, ob eine materialisierte Ansicht hilfreich ist. Materialisierte Ansichten sind in der Regel speziell auf eine oder eine kleine Anzahl von Abfragen zugeschnitten. Wenn viele Abfragen verwendet werden, können materialisierte Sichten zu nicht akzeptablen Kapazitätsanforderungen und Kosten für den Speicher führen.
Datenkonsistenz. Berücksichtigen Sie die Auswirkungen auf die Datenkonsistenz beim Generieren der Ansicht und beim Aktualisieren der Ansicht, wenn dieser Vorgang in einem Zeitplan erfolgt. Wenn sich die Quelldaten gleichzeitig mit der Ansicht ändern, ist die Kopie der Daten in der Ansicht nicht vollständig mit den ursprünglichen Daten konsistent. Das Fenster für maximale Verzögerungen ist eine direkte Folge des Aktualisierungsintervalls oder der Ereignisverarbeitungsverzögerung. Definieren Sie daher die akzeptable Veraltetkeit, bevor Sie zwischen ereignisgesteuerter, geplanter oder manueller Aktualisierung wählen.
Speicherort anzeigen. Die Sicht muss sich nicht im gleichen Speicher oder in der gleichen Partition wie die ursprünglichen Daten befinden. Sie können Teilmengen aus einigen verschiedenen Partitionen kombinieren.
Im Verlustfall neu erstellen. Eine Ansicht kann neu erstellt werden, falls sie verloren gegangen ist. Wenn die Ansicht vorübergehend ist und nur verwendet wird, um die Abfrageleistung zu verbessern, indem sie den aktuellen Status der Daten widerspiegelt oder um die Skalierbarkeit zu verbessern, können Sie sie in einem Cache oder an einem weniger zuverlässigen Speicherort speichern.
Wenn der Aktualisierungsprozess selbst jedoch mittendrin fehlschlägt – z. B. wenn eine geplante Regenerierungsaufgabe abstürzt –, legen Sie fest, ob die Workload die vorherige vollständige Ansicht, eine teilweise aktualisierte Ansicht oder überhaupt keine Ansicht bereitstellen soll, bis die Regeneration erfolgreich abgeschlossen ist.
Der sicherste Ansatz ist in der Regel eine Atompublikation oder Versionsersetzung, bei der Ihre Workload weiterhin die letzte vollständige Ansicht bedient und verwendet, während Sie die neue Ansicht erstellen und überprüfen. Wechseln Sie nach Abschluss der Überprüfung in die neue Ansicht.
Berechnete Spalten. Maximieren Sie beim Definieren einer materialisierten Ansicht deren Nutzen, indem Sie Datenelemente oder Spalten hinzufügen, die auf der Berechnung oder Transformation vorhandener Datenelemente, auf in der Abfrage übergebenen Werten oder gegebenenfalls auf Kombinationen dieser Werte basieren.
Indexierung anzeigen. Wenn der Speichermechanismus dies unterstützt, sollten Sie die materialisierte Ansicht indizieren, um die Leistung zu steigern. Viele relationale Datenbanken unterstützen die Indizierung für Ansichten. Die Indexwartung für die Sicht verursacht jedoch bei jedem Aktualisierungszyklus Mehraufwand im Schreibpfad, daher sollten die Gewinne bei der Leseleistung gegen die zusätzliche Aktualisierungszeit und die Rechenkosten abgewogen werden.
Zugriffssteuerung für Ansichten. Wenn eine materialisierte Ansicht verwendet wird, um einzuschränken, welche Datenuntermengen für bestimmte Verbraucher sichtbar sind, z. B. aus Sicherheits- oder Datenschutzgründen, muss der Ansichtsspeicher dieselben oder strengere Zugriffskontrollen wie die Quelldaten erzwingen. Die Aktualisierungspipeline muss unbeabsichtigte Spalten oder Zeilen ausschließen, da eine Ansicht, die versehentlich Daten über den vorgesehenen Bereich hinaus enthält, geschützte Daten verfügbar machen kann.
Datenlebenszyklus für Ansichten. Wenden Sie die Aufbewahrungs- und Löschanforderungen der Quelldaten auf jede materialisierte Ansicht an. Verteilen Sie Löschungen und Schwärzungen an der Quelle innerhalb der vorgeschriebenen Frist, und beziehen Sie jede Ansicht in die Compliance-Überwachung ein. Weitere Informationen finden Sie unter Data Governance und Sicherheitsgrundwerte mit Microsoft Purview.
Lebenszyklusverwaltung anzeigen. Behandeln Sie Ansichtsdefinitionen als bereitstellungsfähige Artefakte, die über Quellcodeverwaltungs- und CI/CD-Pipelines verwaltet werden, insbesondere, wenn Ansichten deklarativ definiert werden. Ohne Lebenszyklusverwaltung können Ansichtsdefinitionen zwischen Umgebungen driften, was zu inkonsistenten Abfrageverhalten bei entwicklung, Staging und Produktion führt.
Wann dieses Muster verwenden
Verwenden Sie dieses Muster in folgenden Fällen:
- Sie müssen Ansichten über Daten erstellen, die nur schwer abzufragen sind oder wenn Abfragen sehr komplex sein müssen, um Daten zu extrahieren, die auf normalisierte, halbstrukturierte oder unstrukturierte Weise gespeichert sind.
- Sie möchten neu aufbaubare oder transiente zwischengespeicherte Projektionen erstellen, die die Abfrageleistung verbessern oder Daten so strukturieren, dass sie zum Erstellen von Datenübertragungsobjekten für eine Benutzeroberfläche, einen Bericht oder eine Anzeige verwendet werden können.
- Sie müssen gelegentlich verbundene oder getrennte Szenarien unterstützen, in denen die Verbindung zum Datenspeicher nicht immer verfügbar ist. Sie können die Ansicht in diesem Fall lokal zwischenspeichern.
- Sie möchten Abfragen vereinfachen und Daten für Experimente auf eine Weise verfügbar machen, die kein Wissen über das Quelldatenformat erfordert. Beispielsweise durch Verknüpfen von verschiedenen Tabellen in einer oder mehreren Datenbanken oder in einer oder mehreren Domänen in NoSQL-Speichern und anschließendes Formatieren der Daten entsprechend der tatsächlichen Verwendung.
- Sie möchten Zugriff auf bestimmte Teilmengen der Quelldaten gewähren, die aus Sicherheits- oder Datenschutzgründen nicht allgemein zugänglich sein sollten, offen für Änderungen oder vollständig für Benutzer verfügbar sein sollten.
- Sie möchten verschiedene Datenspeicher überbrücken, um ihre individuellen Funktionen nutzen zu können. Sie können z. B. einen Cloudspeicher verwenden, der für das Schreiben als Referenzdatenspeicher effizient ist, und eine relationale Datenbank, die eine gute Abfrage- und Leseleistung bietet, um die materialisierten Ansichten zu halten.
- Wenn Sie Microservices verwenden, halten Sie sie lose gekoppelt, einschließlich ihrer Datenspeicherung. Materialisierte Ansichten können Ihnen dabei helfen, Daten aus Ihren Diensten zu konsolidieren. Wenn materialisierte Ansichten in Ihrer Microservices-Architektur oder in einem bestimmten Szenario nicht geeignet sind, sollten Sie in Betracht ziehen, definierte Grenzen zu haben, die sich an domänengesteuertem Design (DDD) ausrichten und ihre Daten bei Bedarf aggregieren.
Dieses Muster ist möglicherweise nicht geeignet, wenn:
- Die Quelldaten sind einfach und können leicht abgefragt werden.
- Die Quelldaten ändern sich sehr schnell oder können ohne eine Ansicht zugegriffen werden. Vermeiden Sie in diesen Fällen den Verarbeitungsaufwand beim Erstellen von Ansichten.
- Konsistenz hat einen hohen Stellenwert. Die Sichten sind möglicherweise nicht immer vollständig mit den ursprünglichen Daten konsistent.
Arbeitslastgestaltung
Ein Architekt sollte evaluieren, wie das Materialized View-Pattern im Design seines Workloads verwendet werden kann, um die Ziele und Prinzipien zu erreichen, die in den Säulen des Azure Well-Architected Framework behandelt werden. Beispiel:
| Säule | So unterstützt dieses Muster die Säulenziele |
|---|---|
| Performance Efficiency hilft Ihrem Workload durch Optimierungen bei Skalierung, Daten und Code, die Anforderungen effizient zu erfüllen . | Die materialisierten Ansichten speichern die Ergebnisse komplexer Berechnungen oder Abfragen, ohne dass die Datenbank-Engine oder der Client bei jeder Anfrage eine neue Berechnung durchführen muss. Dieses Design reduziert den gesamten Ressourcenverbrauch. - PE:08 Datenleistung |
Wenn dieses Muster Kompromisse innerhalb einer Säule einführt, sollten Sie sie gegen die Ziele der anderen Säulen berücksichtigen.
Example
Erwägen Sie eine Vertriebsanwendung, die Order-, OrderItem- und Customer-Entitäten in Azure Table Storage speichert. Bestellungen werden nach Kunden-ID, Bestellartikeln nach Auftrags-ID und Kunden nach Region partitioniert. Diese Schlüssel unterstützen die Betriebszugriffsmuster der Anwendung, aber ein nach Produkt gruppierter Umsatzbericht muss Daten über Partitionen lesen und im Anwendungscode kombinieren.
Die folgende Abbildung zeigt eine materialisierte Ansicht, in der der Gesamtumsatz und die Anzahl der unterschiedlichen Einkaufskunden für jedes Produkt in der Kategorie Elektronik gespeichert wird. Die Quellzeilen und Zusammenfassungswerte sind illustrativ, kein vollständiges Eingabedatenset für die angezeigten Summen.
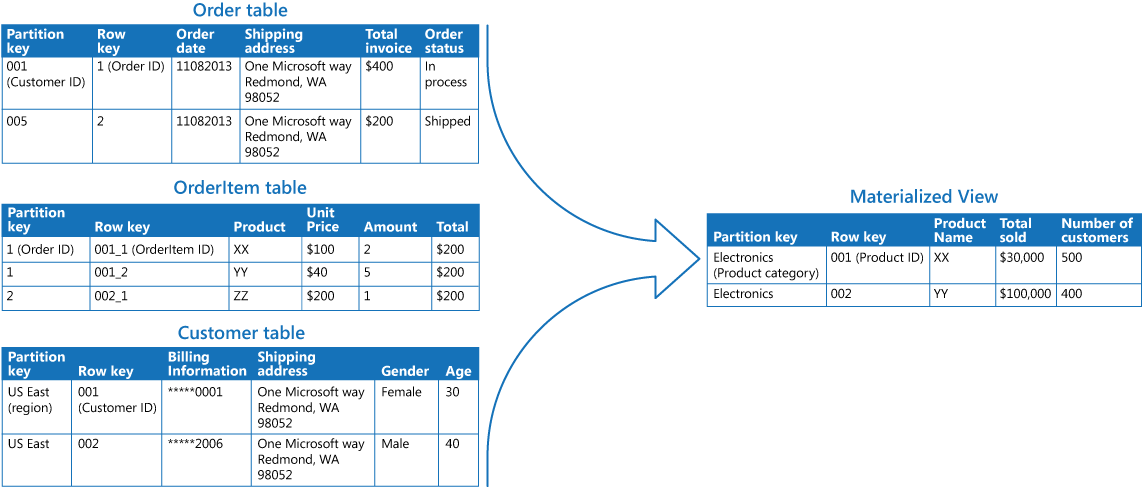
Ein Hintergrundprozess liest die erforderlichen Quellentitäten, ordnet Bestellelemente ihren Bestellungen und Kunden zu und aggregiert verkäufe nach Produkt. Er zählt jeden Kunden einmal pro Produkt, auch wenn dieser Kunde über mehrere Bestellungen oder Auftragspositionen verfügt. Der Prozess schreibt die Ergebnisse in eine separate Zusammenfassungstabelle mit Produktkategorie als PartitionKey und Produkt-ID als RowKey. Diese Zusammenfassungstabelle ist eine von der Anwendung verwaltete Projektion, keine datenbankseitige materialisierte Ansicht.
Ein Dashboard kann dann die Elektronikpartition abfragen, anstatt die partitionsübergreifenden Lese- und Aggregationsvorgänge für jede Anforderung zu wiederholen. Die Abfrage eines Produkts liefert beide Schlüssel. Die Auswirkungen dieser Schlüssel auf die Abfrageleistung finden Sie unter "Entwurf für abfragen".
Aktualisieren Sie die Zusammenfassung nach einem Zeitplan, der der zulässigen Aktualitätsdauer des Berichts entspricht. Erstellen und überprüfen Sie vor der Veröffentlichung eine neue Version, damit Leser die vorherige vollständige Version während einer Neuerstellung weiterhin verwenden. Die Aktualisierung verursacht weiterhin partitionsübergreifende Lese- und Aggregationskosten, aber wiederholte Berichtsabfragen verwenden das Ergebnis wieder. Quelländerungen werden erst angezeigt, wenn eine spätere Aktualisierung sie berücksichtigt.
Nächste Schritte
- Erstellen von indizierten Ansichten beschreibt, wie SQL-Datenbanken berechnete Ansichtsergebnisse beibehalten können, indem sie einen Index in einer Ansicht erstellen.
- Unter Entwurfsmuster für den Änderungsfeed in Azure Cosmos DB for NoSQL wird beschrieben, wie Nutzer des Änderungsfeeds materialisierte Sichten verwalten können.
- Die Übersicht über materialisierte Ansichten beschreibt materialisierte Ansichten in Azure Data Explorer.
- Azure Managed Redis kann vorab berechnete Abfrageergebnisse als leseoptimierte Schicht vor persistenten Datenspeichern zwischenspeichern.
- Azure Table Storage können vorkompilierte Ansichtsdaten speichern, die von Anwendungslogik oder einem Hintergrundprozess generiert werden.
Verwandte Ressourcen
Die folgenden Muster sind unter Umständen bei der Implementierung dieses Musters ebenfalls relevant:
- Muster zur Trennung von Befehls- und Anfrageverantwortung (CQRS - Command and Query Responsibility Segregation). Wird verwendet, um die Informationen in einer materialisierten Sicht zu aktualisieren, indem auf Ereignisse reagiert wird, die aufgrund von Änderungen der zugrunde liegenden Datenwerte auftreten.
- Muster für Ereignisherkunftsermittlung. Verwenden Sie dieses Muster zusammen mit dem CQRS-Muster, um die Informationen in einer materialisierten Ansicht zu pflegen. Wenn die Datenwerte einer materialisierten Ansicht auf Änderungen basieren, kann das System Ereignisse auslösen, die diese Änderungen beschreiben und in einem Ereignisspeicher speichern.
- Indextabellenmuster Die Daten in einer materialisierten Sicht sind in der Regel mit einem Primärschlüssel organisiert. Abfragen müssen aber möglicherweise Informationen aus dieser Sicht abrufen, indem sie Daten in anderen Feldern untersuchen. Verwenden Sie dieses Muster, um sekundäre Indizes über Datensätze für Datenspeicher zu erstellen, die keine nativen sekundären Indizes unterstützen.