Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Erstellen und verwalten Sie separate Nachschlagetabellen für Daten, die von Anwendungen häufig in Abfragen verwendet werden, wenn ein Datenspeicher keine geeigneten sekundären Indizes bereitstellt. Dieser Ansatz verbessert die Leseleistung, indem vollständige Datenüberprüfungen vermieden werden, wenn Abfragen keinen Primärschlüssel oder Partitionsschlüssel verwenden.
Kontext und Problem
Viele Datenspeicher organisieren die Daten für eine Sammlung von Entitäten mithilfe des Primärschlüssels. Mit diesem Schlüssel kann eine Anwendung Daten suchen und abrufen. Die folgende Abbildung zeigt ein Beispiel für einen Datenspeicher, der Kundeninformationen enthält, die nach dem Primärschlüssel ,Kunden-ID" organisiert sind.
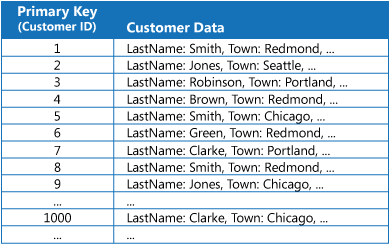
Die Abbildung zeigt eine zweispaltige Tabelle mit Kundendatensätzen. Die erste Spalte, Primärschlüssel (Kunden-ID), enthält Kunden-IDs von 1 bis 9, gefolgt von Auslassungspunkten, ID 1000 und weiteren Auslassungspunkten. Die zweite Spalte „Kundendaten” enthält Kundendaten, die aus einem Nachnamen und einem Ort bestehen, gefolgt von Auslassungspunkten. Zu den sichtbaren Beispielen gehören ID 1, die dem Nachnamen Smith und der Stadt Redmond zugeordnet ist, und ID 2, die dem Nachnamen Jones und der Stadt Seattle zugeordnet ist. Eine weitere Zeile zeigt Smith in Chicago und eine andere Zeigt Smith in Redmond. Eine weitere Zeile zeigt Jones in Chicago.
Obwohl der Primärschlüssel für Abfragen nützlich ist, die Daten basierend auf dem Wert dieses Schlüssels abrufen, kann eine Anwendung, die Daten basierend auf einem anderen Feld abrufen muss, den Primärschlüssel für diese Abfrage nicht verwenden. Im Beispiel mit den Kundendaten kann eine Anwendung keine Kunden mithilfe der als Primärschlüssel dienenden Kunden-ID abrufen, wenn Daten ausschließlich über den Wert eines anderen Attributs abfragt werden (z.B. der Stadt, in der der Kunde ansässig ist). Um eine Abfrage auszuführen, die nur auf die Stadt verweist, muss die Anwendung möglicherweise jeden Kundendatensatz abrufen und untersuchen, was ein langsamer Prozess sein kann.
Viele Managementsysteme für relationale Datenbanken unterstützen sekundäre Indizes. Ein sekundärer Index ist eine separate Datenstruktur, die nach einem oder mehreren nicht primären (sekundären) Schlüsselfeldern organisiert ist. Ein sekundärer Index gibt an, wo die Daten für jeden indizierten Wert gespeichert werden. Die Elemente in einem sekundären Index werden in der Regel nach dem Wert der Sekundärschlüssel sortiert, um eine schnelle Suche nach Daten zu ermöglichen. Das Datenbankverwaltungssystem verwaltet diese Indizes in der Regel automatisch.
Relationale Datenbanken ermöglichen es mehreren sekundären Indizes, verschiedene Abfragemuster zu unterstützen. In einer Tabelle "Kunden" in einer relationalen Datenbank, in der die Kunden-ID der Primärschlüssel ist, empfiehlt es sich beispielsweise, einen sekundären Index über das Feld "Ort" hinzuzufügen, wenn die Anwendung häufig Kunden nach der Stadt sucht, in der sie sich befinden.
Obwohl sekundäre Indizes in relationalen Systemen üblich sind, bieten nicht alle Datenspeicher ein gleichwertiges Feature. Bei einigen Datenspeichern fehlen sekundäre Indizes, während andere Indizes bereitstellen, die die Abfrage, Partitionierung oder Leistungsanforderungen einer Workload nicht erfüllen. In diesen Fällen müssen Anwendungen zwischen vollständigen Scans und manueller Indexverwaltung wählen.
Solution
Erstellen Sie eine Indextabelle, die die Daten nach einem angegebenen Schlüssel organisiert. Im folgenden Abschnitt werden drei allgemeine Strategien zum Strukturieren einer Indextabelle beschrieben. In den beiden nachfolgenden Abschnitten wird die Verwendung für Indextabellen in bestimmten Szenarien beschrieben.
Standardstrukturierungsstrategien
Die folgenden Strategien werden häufig verwendet, um eine Indextabelle zu strukturieren. Wählen Sie eine Strategie basierend auf der Anzahl der sekundären Indizes aus, die Ihr Szenario erfordert, und die Art der Abfragen, die Ihre Anwendung ausführt.
Vollständige Denormalisierung
Die vollständige Denormalisierung dupliziert die Daten in jeder Indextabelle, organisiert sie jedoch nach anderen Schlüsseln als dem Primärschlüssel. Die folgende Abbildung zeigt Indextabellen, die dieselben Kundeninformationen nach Ort und Nachname organisieren.
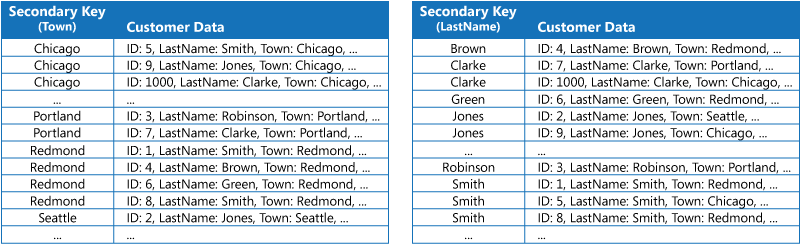
Diese Strategie eignet sich gut für leseintensive Workloads, bei denen sich Daten selten ändern. Da die Aktualisierungsrate zunimmt, erhöht die Aufrechterhaltung jeder Kopie den Verarbeitungsaufwand (siehe Konsistenzkomplexität). Für Datasets mit hohem Volumen kann das Speichern der Kopien auch einen erheblichen Speicherplatz erfordern.
Normalisierter Index
Eine normalisierte Indextabelle organisiert Daten nach anderen Schlüsseln als dem Primärschlüssel. Die normalisierte Indextabelle verweist auf die ursprünglichen Daten mithilfe des Primärschlüssels, anstatt diese Daten zu duplizieren, wie in der folgenden Abbildung dargestellt. Die Originaldaten werden als „Faktentabelle“ bezeichnet.
Tip
Hier bedeutet die Faktentabelle die autoritative Quelltabelle, auf die durch einen Index verwiesen wird. Es impliziert kein dimensionales Datenmodell.
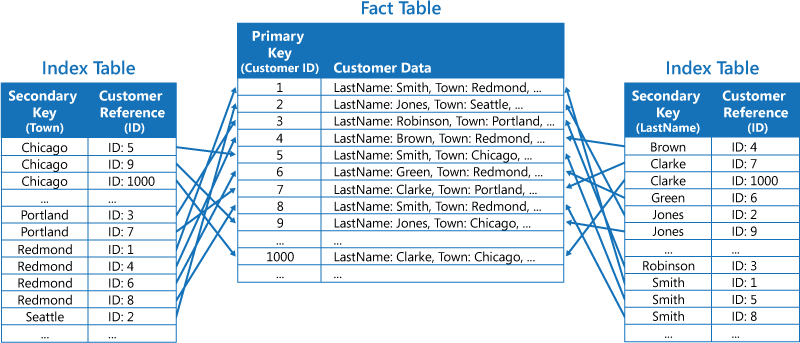
Diese Methode spart Speicherplatz und reduziert den Aufwand für die Verwaltung doppelter Daten. Der Nachteil besteht darin, dass eine Anwendung zwei Nachschlagevorgänge ausführen muss, um Daten mithilfe eines Sekundärschlüssels zu finden. Die Anwendung muss den Primärschlüssel für die Daten in der Indextabelle suchen und dann den Primärschlüssel verwenden, um die Daten in der Faktentabelle nachzuschlagen.
Teilweise Denormalisierung
Die Teilweise Denormalisierung erstellt Indextabellen, die häufig abgerufene Felder duplizieren und nach anderen Schlüsseln als dem Primärschlüssel organisiert werden. Auf die Faktentabelle wird verwiesen, um auf weniger häufig verwendete Felder zuzugreifen. Die folgende Abbildung zeigt, wie häufig verwendete Daten in jeder Indextabelle dupliziert werden.
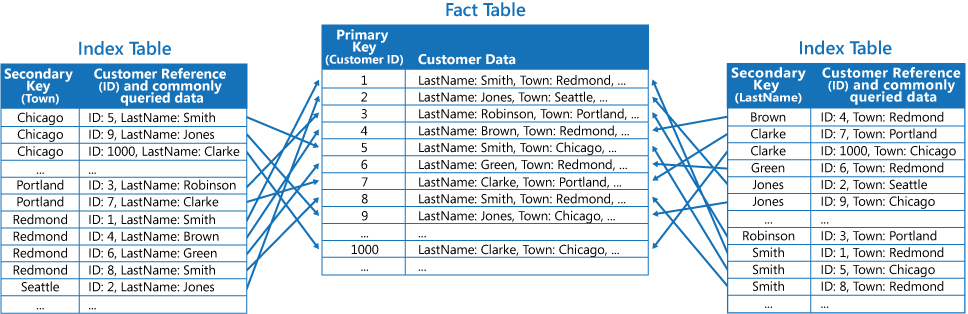
Diese Strategie gleicht die ersten beiden Ansätze aus. Sie können Daten für allgemeine Abfragen schnell abrufen, indem Sie einen einzelnen Nachschlagevorgang verwenden, während der Platz- und Wartungsaufwand nicht so wichtig ist wie das Duplizieren des gesamten Datasets.
Zusammengesetzte Schlüssel
Einige Anwendungen fragen häufig Daten ab, indem sie eine Kombination von Werten angeben, z. B. "Alle Kunden suchen, die in Redmond leben und einen Nachnamen von Smith haben." Erstellen Sie in diesem Fall Indexschlüssel aus mehreren Attributen, z. B. die Attribute "Town" und "LastName".
Verwenden Sie eine Codierung, mit der Komponentengrenzen beibehalten werden, sodass unterschiedliche Wertkombinationen nicht denselben Schlüssel erzeugen können. Wenn Abfragen von der Schlüsselreihenfolge abhängen, stellen Sie außerdem sicher, dass die Codierung die erforderliche Sortierreihenfolge unter den Schlüsselsortierungsregeln des Datenspeichers beibewahrt.
Die folgende Abbildung zeigt eine Indextabelle basierend auf zusammengesetzten Schlüsseln. Die Schlüssel werden nach Ort und dann nach Nachname für Datensätze sortiert, die denselben Wert für Town aufweisen.
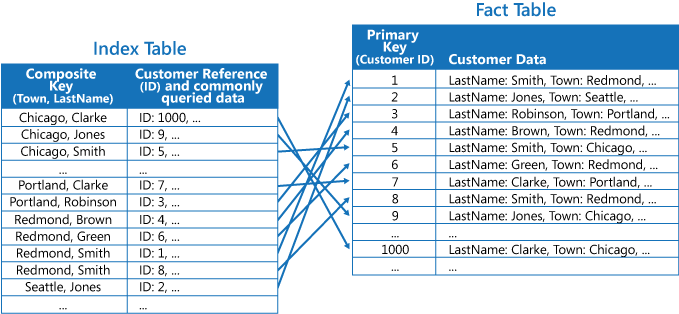
Das Diagramm enthält eine Indextabelle auf der linken Seite und eine Faktentabelle auf der rechten Seite. In der Faktentabelle werden Kundendaten nach dem Primärschlüssel "Kunden-ID" organisiert. Jede Zeile mit Kundendaten enthält den Nachnamen eines Kunden, einen Ort und Auslassungspunkte, die auf weitere Daten hinweisen. Die Indextabelle wird anhand eines zusammengesetzten Schlüssels organisiert, der "Town" und "LastName" kombiniert. Die zweite Spalte, „Kundenreferenz (ID)“ und häufig abgefragte Daten, enthält eine Kunden-ID sowie Auslassungspunkte. Pfeile reichen von Indextabellenzeilen bis zur Faktentabelle, wobei jeder Pfeil auf die Zeile "Kunden-ID" zeigt, auf die durch diesen Indexeintrag verwiesen wird. Die Kreuzpfeile veranschaulichen, dass durch den zusammengesetzten Schlüssel sortierte Einträge an unterschiedlichen Positionen in der Faktentabelle auf Kundenzeilen verweisen können.
Indextabellen für fragmentierte Daten
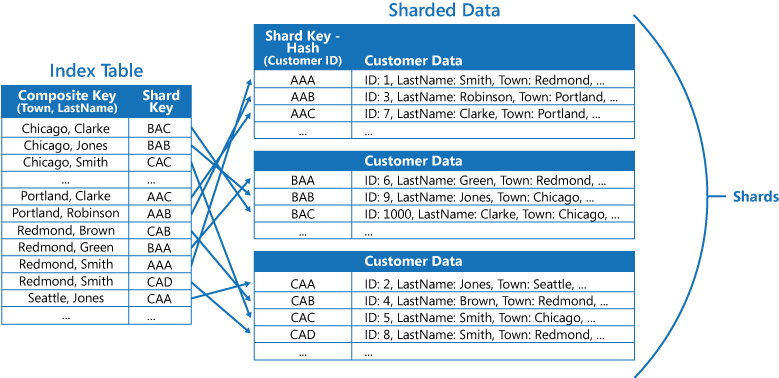
Indextabellen können Abfragevorgänge über abgeshardte Daten beschleunigen. Sie sind besonders nützlich, wenn der Shardschlüssel hashed wird. Die folgende Abbildung zeigt ein Beispiel, bei dem der Shardschlüssel ein Hash der Kunden-ID ist. Die Indextabelle organisiert Einträge nach Nicht-Hash-Werten, Town und LastName und speichert den entsprechenden Hashschlüssel mit jedem Eintrag.
Diese Anordnung unterstützt Bereichs- und geordnete Suchvorgänge für die nicht gehashten Werte und stellt zugleich die Routinginformationen bereit, die benötigt werden, um jeden Datensatz aus dem richtigen Shard abzurufen. Beispielsweise kann eine Abfrage wie "Alle Kunden suchen, die in Redmond leben" die übereinstimmenden Elemente in einem zusammenhängenden Block in der Indextabelle suchen. Die Anwendung folgt dann den Verweisen auf die Kundendaten mithilfe der in der Indextabelle gespeicherten Shard-Schlüssel.
Probleme und Überlegungen
Berücksichtigen Sie die folgenden Punkte, wenn Sie sich für die Implementierung dieses Musters entscheiden:
Wartungsaufwand. Die Aufrechterhaltung von sekundären Indizes kann erheblichen Aufwand verursachen. Analysieren und verstehen Sie die Abfragen, die Ihre Anwendung verwendet. Erstellen Sie Indextabellen nur, wenn Sie sie wahrscheinlich regelmäßig verwenden. Erstellen Sie keine spekulativen Indextabellen, um Abfragen zu unterstützen, die eine Anwendung nicht ausführt oder nur gelegentlich ausführt. Wenn die Anzahl der Abfragemuster wächst, steigt auch die Anzahl der Indextabellen, und jede davon erhöht den operativen Aufwand für Überwachung, Wartung und Fehlerbehebung. Wiegen Sie den Abfragevorteil jeder Indextabelle anhand der Betriebskosten der Aufrechterhaltung einer anderen abgeleiteten Datenstruktur ab. Überprüfen Sie in regelmäßigen Abständen vorhandene Indextabellen, um alle nicht mehr abgefragten Tabellen zu identifizieren und zu entfernen.
Speicher- und Durchsatzkosten. Das Duplizieren von Daten in einer Indextabelle erhöht die Speicherkosten im Verhältnis zur Anzahl der Indextabellen und der Größe kopierter Felder. Die Verwaltung mehrerer Kopien von Daten erhöht auch den Aufwand. Jeder Schreibvorgang in eine Indextabelle verbraucht Durchsatzkapazität, z. B. Transaktionen mit den Grenzwerten des Speicherkontos in Azure Table Storage oder Anforderungseinheiten in Azure Cosmos DB. Die Kosten reichen über den Speicher hinaus bis zum schreibseitigen Durchsatz.
Strafe bei doppelter Suche. Um eine Indextabelle als normalisierte Struktur zu implementieren, die auf die Originaldaten verweist, muss eine Anwendung für die Datensuche zwei Suchvorgänge durchführen. Der erste Vorgang durchsucht die Indextabelle, um den Primärschlüssel abzurufen, während der zweite Vorgang den Primärschlüssel zum Abrufen der Daten verwendet.
Konsistenzkomplexität. Wenn ein System eine Reihe von Indextabellen über große Datasets enthält, kann die Beibehaltung der Konsistenz zwischen Indextabellen und den ursprünglichen Daten schwierig sein. Wenn die Quelldaten und Indexeinträge nicht in derselben Transaktion aktualisiert werden können, legen Sie die Anwendung auf ein Eventual-Consistency-Modell aus. Speichern Sie jede Quelländerung dauerhaft, bevor Sie den Schreibvorgang quittieren. Verwenden Sie beispielsweise einen Datenbank-Änderungsfeed, nutzen Sie das Transactional Outbox pattern, um in derselben Transaktion wie die Quelländerung einen Outbox-Eintrag zu schreiben, oder stellen Sie einen Befehl in die Warteschlange, bevor Sie die Quelldaten ändern. Verwenden Sie im befehlsbasierten Ansatz einen Worker, um den Befehl zu verarbeiten und die Quelldaten und deren Indizes zu aktualisieren. Aktualisieren Sie die Quelldaten nicht, und veröffentlichen Sie dann unabhängig eine Indexaktualisierungsmeldung, da ein Fehler zwischen diesen Vorgängen den Index veraltet lassen kann.
Entwerfen Sie den asynchronen Consumer so, dass er idempotent ist, da Nachrichtenübermittlung und Wiederholungsversuche dazu führen können, dass dieselbe Aktualisierung mehr als einmal ausgeführt wird. Aktualisierungen für denselben Quelldatensatz können auch in falscher Reihenfolge eintreffen. Fügen Sie eine Quellversion oder Sequenznummer in jede Indexaktualisierung ein, und wenden Sie ein Update nur an, wenn sie neuer als die Version im Index ist. Bewahren Sie bei Löschvorgängen einen versionierten Tombstone oder eine entsprechende High-Water-Marke auf, damit eine verzögert eintreffende ältere Aktualisierung den gelöschten Indexeintrag nicht neu anlegen kann. Während des Intervalls zwischen dem Schreiben von Quelldaten und der asynchronen Indexaktualisierung können Abfragen für die Indextabelle veraltete Verweise auf Datensätze zurückgeben, die in den Quelldaten aktualisiert oder gelöscht wurden, und sie können kürzlich hinzugefügte Datensätze weglassen.
Partitionierung von Indextabellen. Indextabellen können selbst partitioniert oder abgeshardt werden, wodurch das Abfragerouting komplexer wird und die Partitionierungsstrategie zum Ausrichten an die Abfragemuster erforderlich ist, die der Index bedienen soll.
Wann dieses Muster verwenden
Verwenden Sie dieses Muster, wenn eine Anwendung häufig Daten mithilfe eines anderen Schlüssels als dem primären Schlüssel (oder Shardschlüssel) abrufen muss und der Datenspeicher sekundäre Indizes nicht nativ unterstützt oder seine systemeigenen Indizes die Abfrage, Partitionierung oder Leistungsanforderungen der Workload nicht erfüllen.
Dieses Muster ist möglicherweise nicht geeignet, wenn:
Daten sind flüchtig. Die Daten ändern sich so häufig, dass die Schreibrate die Rate überschreitet, mit der Indextabellen asynchron aktualisiert werden können. Das Veraltetkeitsfenster wächst, bis der Index dauerhaft veraltet ist, wodurch es ineffektiv wird und der Speicher- und Durchsatzaufwand für die Aufrechterhaltung der Indextabelle größer als alle Abfrageeinsparungen ist.
Sie haben nicht diskriminierende Schlüssel. Ein Feld, das als Sekundärschlüssel für eine Indextabelle ausgewählt ist, ist nicht diskriminierend und kann nur einen kleinen Satz von Werten aufweisen (z. B. ein boolesches Feld, das aufzeichnet, ob ein Element aktiv ist). Die Indextabelle verursacht vollständige Speicher- und Durchsatzkosten, bietet jedoch minimale Abfrageauswahl.
Datenwerte weisen eine schiefe Verteilung auf. Der Saldo der Datenwerte für ein Feld, das als Sekundärschlüssel für eine Indextabelle ausgewählt ist, ist sehr schief. Wenn z. B. 90 Prozent der Datensätze denselben Wert in einem Feld enthalten, kann das Erstellen und Verwalten einer Indextabelle zum Nachschlagen von Daten basierend auf diesem Feld mehr Aufwand verursachen als das sequenzielle Scannen der Daten. Wenn Abfragen jedoch häufig Zielwerte aufweisen, die in den verbleibenden 10 Prozent liegen, kann dieser Index weiterhin hilfreich sein.
Arbeitslastgestaltung
Ein Architekt sollte auswerten, wie das Indextabellenmuster in ihrem Arbeitsauslastungsentwurf verwendet wird, um die in den Azure Well-Architected Framework-Säulen behandelten Ziele und Prinzipien zu berücksichtigen. Die folgende Tabelle enthält Anleitungen dazu, wie dieses Muster die Ziele jeder Säule unterstützt.
| Säule | So unterstützt dieses Muster die Säulenziele |
|---|---|
| Zuverlässigkeit hilft Ihrer Workload, ihre Ziele für Ausfallsicherheit und Wiederherstellung zu erreichen, indem Redundanz aufgebaut und die Funktionalität bei Ausfällen aufrechterhalten wird. | Die asynchrone Indexwartung kann verhindern, dass temporäre Fehler bei der Indexaktualisierung Schreibvorgänge in die Quelldaten blockieren. Idempotente Verarbeitung, Dead-Letter-Behandlung, Überwachung und Abgleich helfen dabei, die Indexkonsistenz nach Fehlern wiederherzustellen. - RE:07 Selbsterhaltung - RE:10-Überwachung |
| Performance Efficiency hilft Ihrem Workload durch Optimierungen bei Skalierung, Daten und Code, die Anforderungen effizient zu erfüllen . | Indextabellen ermöglichen schnelle Nachschlagevorgänge für Nicht-Primärschlüsselfelder, ohne dass vollständige Datenüberprüfungen erforderlich sind. Bei shardierten Datenspeichern können Indextabellen Einträge nach nicht gehashten Werten organisieren, um Bereichsabfragen und geordnete Abfragen zu unterstützen, die der Shardschlüssel allein nicht effizient verarbeiten kann. - PE:05 Skalierung und Partitionierung - PE:08 Datenleistung |
Wie bei jeder Entwurfsentscheidung sollten Sie, wenn dieses Muster innerhalb einer Säule Kompromisse mit sich bringt, diese gegen die Ziele der anderen Säulen abwägen.
Example
Erwägen Sie eine Anwendung, die Informationen zu Filmen speichert. Angenommen, der Katalog ist groß und leseintensiv, jeder Film hat ein Hauptgenre, Abfragen zu Schauspielern sind häufig, Besetzungsdaten ändern sich selten, und eine kurze Verzögerung bei der Indexierung ist akzeptabel. Tabellenspeicher speichert jede Entität als strukturierter Satz benannter Eigenschaften. Jede Entität enthält ein PartitionKey, ein RowKey und einen Zeitstempel, und die Entitäten in derselben Tabelle können unterschiedliche Gruppen von Eigenschaften aufweisen.
Der Tabellenspeicher verwendet einen zusammengesetzten Primärschlüssel, der aus PartitionKey und RowKey besteht. Der PartitionKey Wert bestimmt die Partition, in der eine Entität gespeichert wird. Innerhalb einer Partition identifiziert der RowKey Wert eine Entität eindeutig. Der Tabellenspeicher ist für Abfragen optimiert, die beide Schlüssel angeben oder einen zusammenhängenden Bereich von Zeilenschlüsselwerten innerhalb einer Partition abrufen.
Tip
Der Tabellenspeicher unterstützt Transaktionsaktualisierungen für Entitäten in derselben Tabelle und Partition über Entitätsgruppentransaktionen. Eine Transaktion kann keine Faktentabelle und eine separate Indextabelle umfassen. Um eine Faktenentität und Indexentitäten atomar zu aktualisieren, speichern Sie sie in derselben Tabelle mit demselben PartitionKey. Entitätsgruppentransaktionen sind auf 100 Entitäten pro Batch mit maximaler Nutzlast von 4 MiB beschränkt.
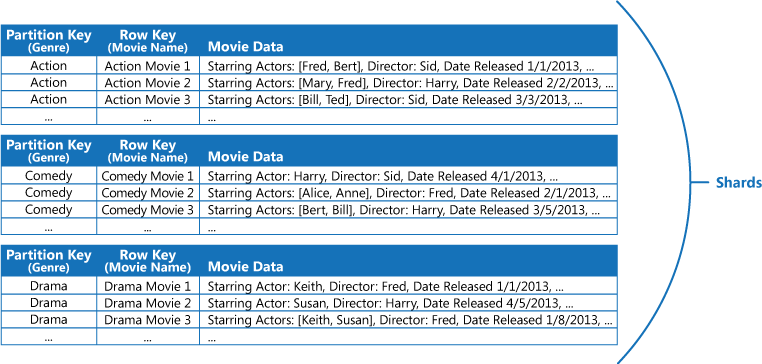
Erstellen Sie in diesem Beispiel eine Azure Tabelle mit Partitionen für jedes Genre, indem Sie einen codierten Genrebezeichner als Partitionsschlüssel und einen stabilen eindeutigen Filmbezeichner als Zeilenschlüssel verwenden. Speichern Sie die Genre- und Filmnamen als Eigenschaften. In der folgenden Abbildung werden lesbare Namen anstelle von Bezeichnern verwendet, um das Beispiel einfacher zu verfolgen.
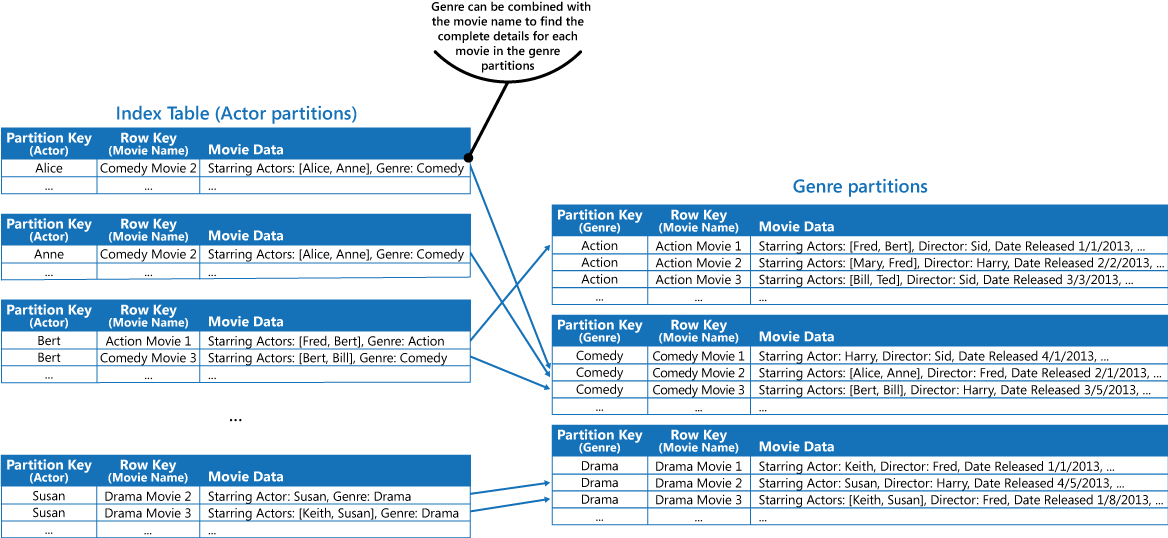
Diese Vorgehensweise ist nicht sehr effizient, wenn die Anwendung auch Filme nach Darstellern abfragen muss. Erstellen Sie in diesem Fall eine separate Azure Tabelle, die als Indextabelle fungiert. Verwenden Sie einen codierten, stabilen Akteurbezeichner als Partitionsschlüssel und den Filmbezeichner als Zeilenschlüssel. Speichern Sie Schauspieler- und Filmnamen als Eigenschaften. In der folgenden Abbildung werden lesbare Namen anstelle von Bezeichnern verwendet. Wenn in einem Film mehr als ein Schauspieler mitspielt, kommt derselbe Film in mehreren Partitionen vor.
Die folgende Abbildung zeigt die Akteurindextabelle.
Designbesprechung
Die Filmtabelle verwendet Genre als Partitionsschlüssel, was bedeutet, dass Abfragen, die nach Genre filtern, effizient als Partitionsscans über zusammenhängende Zeilenschlüsselbereiche ausgeführt werden. Tabellenspeicher unterstützt jedoch nur einen einzelnen gruppierten Index auf PartitionKey und RowKey. Sie hat keine sekundären Indizes. Eine Abfrage wie "Alle Filme mit einem bestimmten Akteur suchen" erfordert einen vollständigen Tabellenscan über jede Genrepartition, die im Großen und Ganzen teuer ist.
Die Akteurindextabelle behebt diese Einschränkung durch Umkehren des Zugriffsmusters. Jeder Akteurbezeichner wird zu einem Partitionsschlüssel, und jeder Filmbezeichner wird zu einem Zeilenschlüssel, sodass akteurbasierte Abfragen als effiziente Partitionssuche aufgelöst werden. Da jede Partition nur die Filme eines Akteurs enthält, gibt die Abfrage einen zusammenhängenden Bereich von Entitäten zurück, ohne nicht verknüpfte Daten zu scannen.
Da Film- und Akteureinträge separate Tabellen und Partitionsschlüssel verwenden, können diese Einträge keine Entitätsgruppentransaktion freigeben. Pflegen Sie den Akteurindex über einen dauerhaften asynchronen Mechanismus zur Änderungserfassung, und legen Sie die Anwendung so aus, dass sie kurzzeitig veraltete Abfrageergebnisse toleriert.
Die Indextabelle wendet teilweise Denormalisierung an: Jeder Eintrag dupliziert häufig verwendete Felder (z. B. die Namen anderer Akteure), sodass die am häufigsten verwendeten Abfragen allein aus der Indextabelle mit einem einzelnen Nachschlagevorgang beantwortet werden können. Für weniger häufig verwendete Felder enthält der Eintrag den Genrepartitionsschlüssel aus der ursprünglichen Filmtabelle, wodurch eine gezielte Punktabfrage auf die Genrepartition für den vollständigen Datensatz ermöglicht wird. Dieser Entwurf gleicht die Abfragegeschwindigkeit mit speicherkosten und Wartungsaufwand ab.
Nächste Schritte
Der Entwurfsleitfaden für Abfragen für Tabellenspeicher beschreibt sekundäre Indexmuster, die
PartitionKeyundRowKeyverwenden, einschließlich Ansätzen zum Speichern von Indexeinträgen in derselben Partition oder in separaten Partitionen.Strategien zur Datenpartitionierung erläutern, wie Partitions- und Zeilenschlüssel basierend auf Abfragemustern, Datenverteilung, Transaktionsanforderungen und Skalierbarkeitszielen ausgewählt werden.
Architekturstrategien zur Optimierung der Datenleistung bieten Anleitungen zur Auswertung von Abfragemustern, Indizes, Partitionen und Überwachungsanforderungen.
Konsistenzstufen in Azure Cosmos DB beschreiben die Konsistenzmodelle, die relevant sind, wenn Sie Indextabellen in Azure Cosmos DB verwalten.
Verwandte Ressourcen
Die folgenden Muster sind unter Umständen bei der Implementierung dieses Musters ebenfalls relevant:
Muster „Sharding“. Das Muster „Indextabelle“ wird häufig in Verbindung mit Daten, die durch Shards partitioniert werden, verwendet. Das Sharding-Muster beschreibt, wie ein Datenspeicher in eine Reihe von Shards unterteilt wird.
Muster „Materialisierte Sichten“. Anstatt Daten zu indizieren, um Abfragen zu unterstützen, die Daten zusammenfassen, kann es sinnvoller sein, eine materialisierte Ansicht der Daten zu erstellen. Dieses Muster beschreibt, wie Sie vorab aufgefüllte Ansichten über Daten generieren, um effiziente Sammelabfragen zu unterstützen.
Transactional-Outbox-Muster. Verwenden Sie das Transaktionsausgangsmuster, um Änderungen für die asynchrone Indexwartung zuverlässig zu veröffentlichen, wenn Quelldaten und Indexeinträge in einer Transaktion nicht aktualisiert werden können.