Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Überwachen Sie die Nutzung von Unity-Gateway-Diensten mit der system.ai_gateway.usage Systemtabelle. Es erfasst Anfragen an Modelldienste, Modellanbieterdienste und MCP-Dienste aus verschiedenen Quellen, darunter KI-Abfrage, Coding-Agenten, Databricks-Apps, KI-Playground und andere Anwendungen.
Nutzungseinträge umfassen Anfrage- und Servicedetails, Antwortstatus, Nutzung und Latenz von Modelltokens, MCP-Aufrufmetadaten sowie Metadaten der Coding-Agent-Sitzungen. Abfragen Sie die Tabelle für individuelle Analysen oder nutzen Sie das integrierte Nutzungs-Dashboard, um Nutzung, Ausgaben, Akzeptanz und Leistung zu überwachen.
Konto- und Arbeitsbereichsadministratoren können auch auf der AI-Seite im Governance Hub einen zusammengefassten Überblick über die KI-Nutzung einsehen.
Requirements
- Ein Azure Databricks Workspace in einer von Unity Gateway unterstützten Region.
- Unity-Katalog für Ihren Arbeitsbereich aktiviert. Weitere Informationen finden Sie unter Aktivieren eines Arbeitsbereichs für Unity Catalog.
- Sowohl die Konto- als auch die Metastore-Administratorrollen müssen standardmäßig die
system.ai_gateway.usageTabelle anzeigen oder abfragen. Administratoren können den Zugriff auf Systemtabellen verwalten , um Berechtigungen für Benutzer, Gruppen und Service-Principals zu steuern.
Nutzungstabelle abfragen
Unity Gateway protokolliert Nutzungsdaten in der system.ai_gateway.usage Systemtabelle. Sie können die Tabelle auf der Benutzeroberfläche anzeigen oder die Tabelle aus Databricks SQL oder einem Notizbuch abfragen.
Hinweis
Akten sind in der Regel innerhalb einer Stunde verfügbar. Die Datenlieferung für neue Arbeitsbereiche kann länger als dies dauern.
Um die Tabelle auf der Benutzeroberfläche anzuzeigen, klicken Sie auf der Modelldienstseite auf den Link "Verwendungsnachverfolgungstabelle", um die Tabelle im Katalog-Explorer zu öffnen.
So fragen Sie die Tabelle aus Databricks SQL oder einem Notizbuch ab:
SELECT * FROM system.ai_gateway.usage;
Tip
Genie Code kann das für dich übernehmen. Probieren Sie diese Beispielaufforderung aus:
Query the system.ai_gateway.usage table to analyze Unity Gateway usage showing request count and total tokens, grouped by endpoint name for the last 7 days.
Pricing
Die Nutzungsverfolgung ist eine abgerechnete Funktion des Unity-Gateways. Azure Databricks erhebt Gebühren für die Nutzung, die es in der Tabelle system.ai_gateway.usage erfasst. Siehe Unity Gateway Preise.
Integriertes Verwendungsdashboard
Das integrierte Unity Gateway Nutzungs-Dashboard bietet eine konsolidierte Übersicht über Nutzung, Ausgaben, Einführung und Leistung über Modelle, MCP-Dienste, Coding-Agenten und Fähigkeiten hinweg.
Erstellen Sie das Dashboard
Kontoadministratoren können das Dashboard von der Unity-Gateway-Seite aus erstellen:
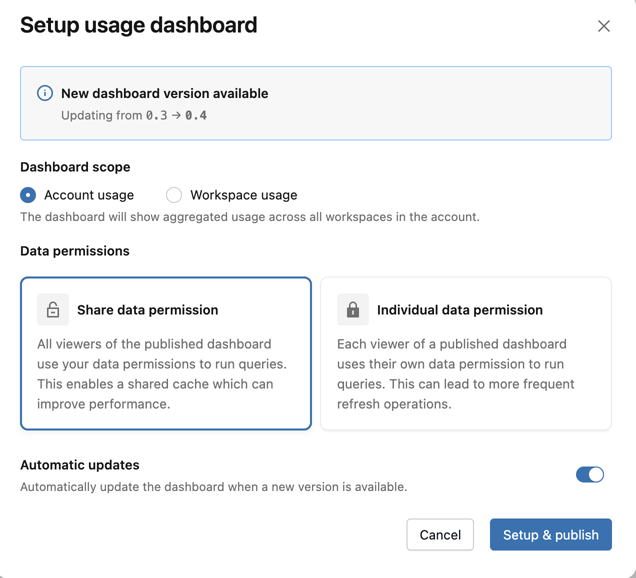
- Klicken Sie auf Govern > Create Usage Dashboard.
- Wählen Sie Kontonutzung zur Analyse der Nutzung über Arbeitsbereiche hinweg oder Arbeitsbereichsnutzung, um die Analyse auf den aktuellen Arbeitsbereich zu beschränken.
-
Datenberechtigungen konfigurieren:
- Datenfreigabeberechtigung: Betrachter führen Dashboard-Abfragen mit Ihren Datenberechtigungen durch.
- Individuelle Datenberechtigung: Jeder Betrachter führt Dashboard-Abfragen mit eigenen Datenberechtigungen aus.
- Wählen Sie, ob Sie automatische Updates und geplante Datenaktualisierungen aktivieren möchten.
- Klicken Sie auf Einrichtung& veröffentlichen.
Das Standard-SQL-Warehouse wird automatisch ausgewählt. Die Identität, die Dashboard-Abfragen ausführt, benötigt Zugriff auf die zugrundeliegenden Systemtabellen. Siehe Zugriff auf Systemtabellen gewähren und Dashboard-Datenberechtigungen.
Hinweis
In Arbeitsbereichen ohne das Dropdown-Menü Verwalten verwenden Sie die eigenständigen Schaltflächen Dashboard erstellen, Dashboard anzeigen und Aktualisieren auf der Unity-Gateway-Seite.
Entdecken Sie das Dashboard
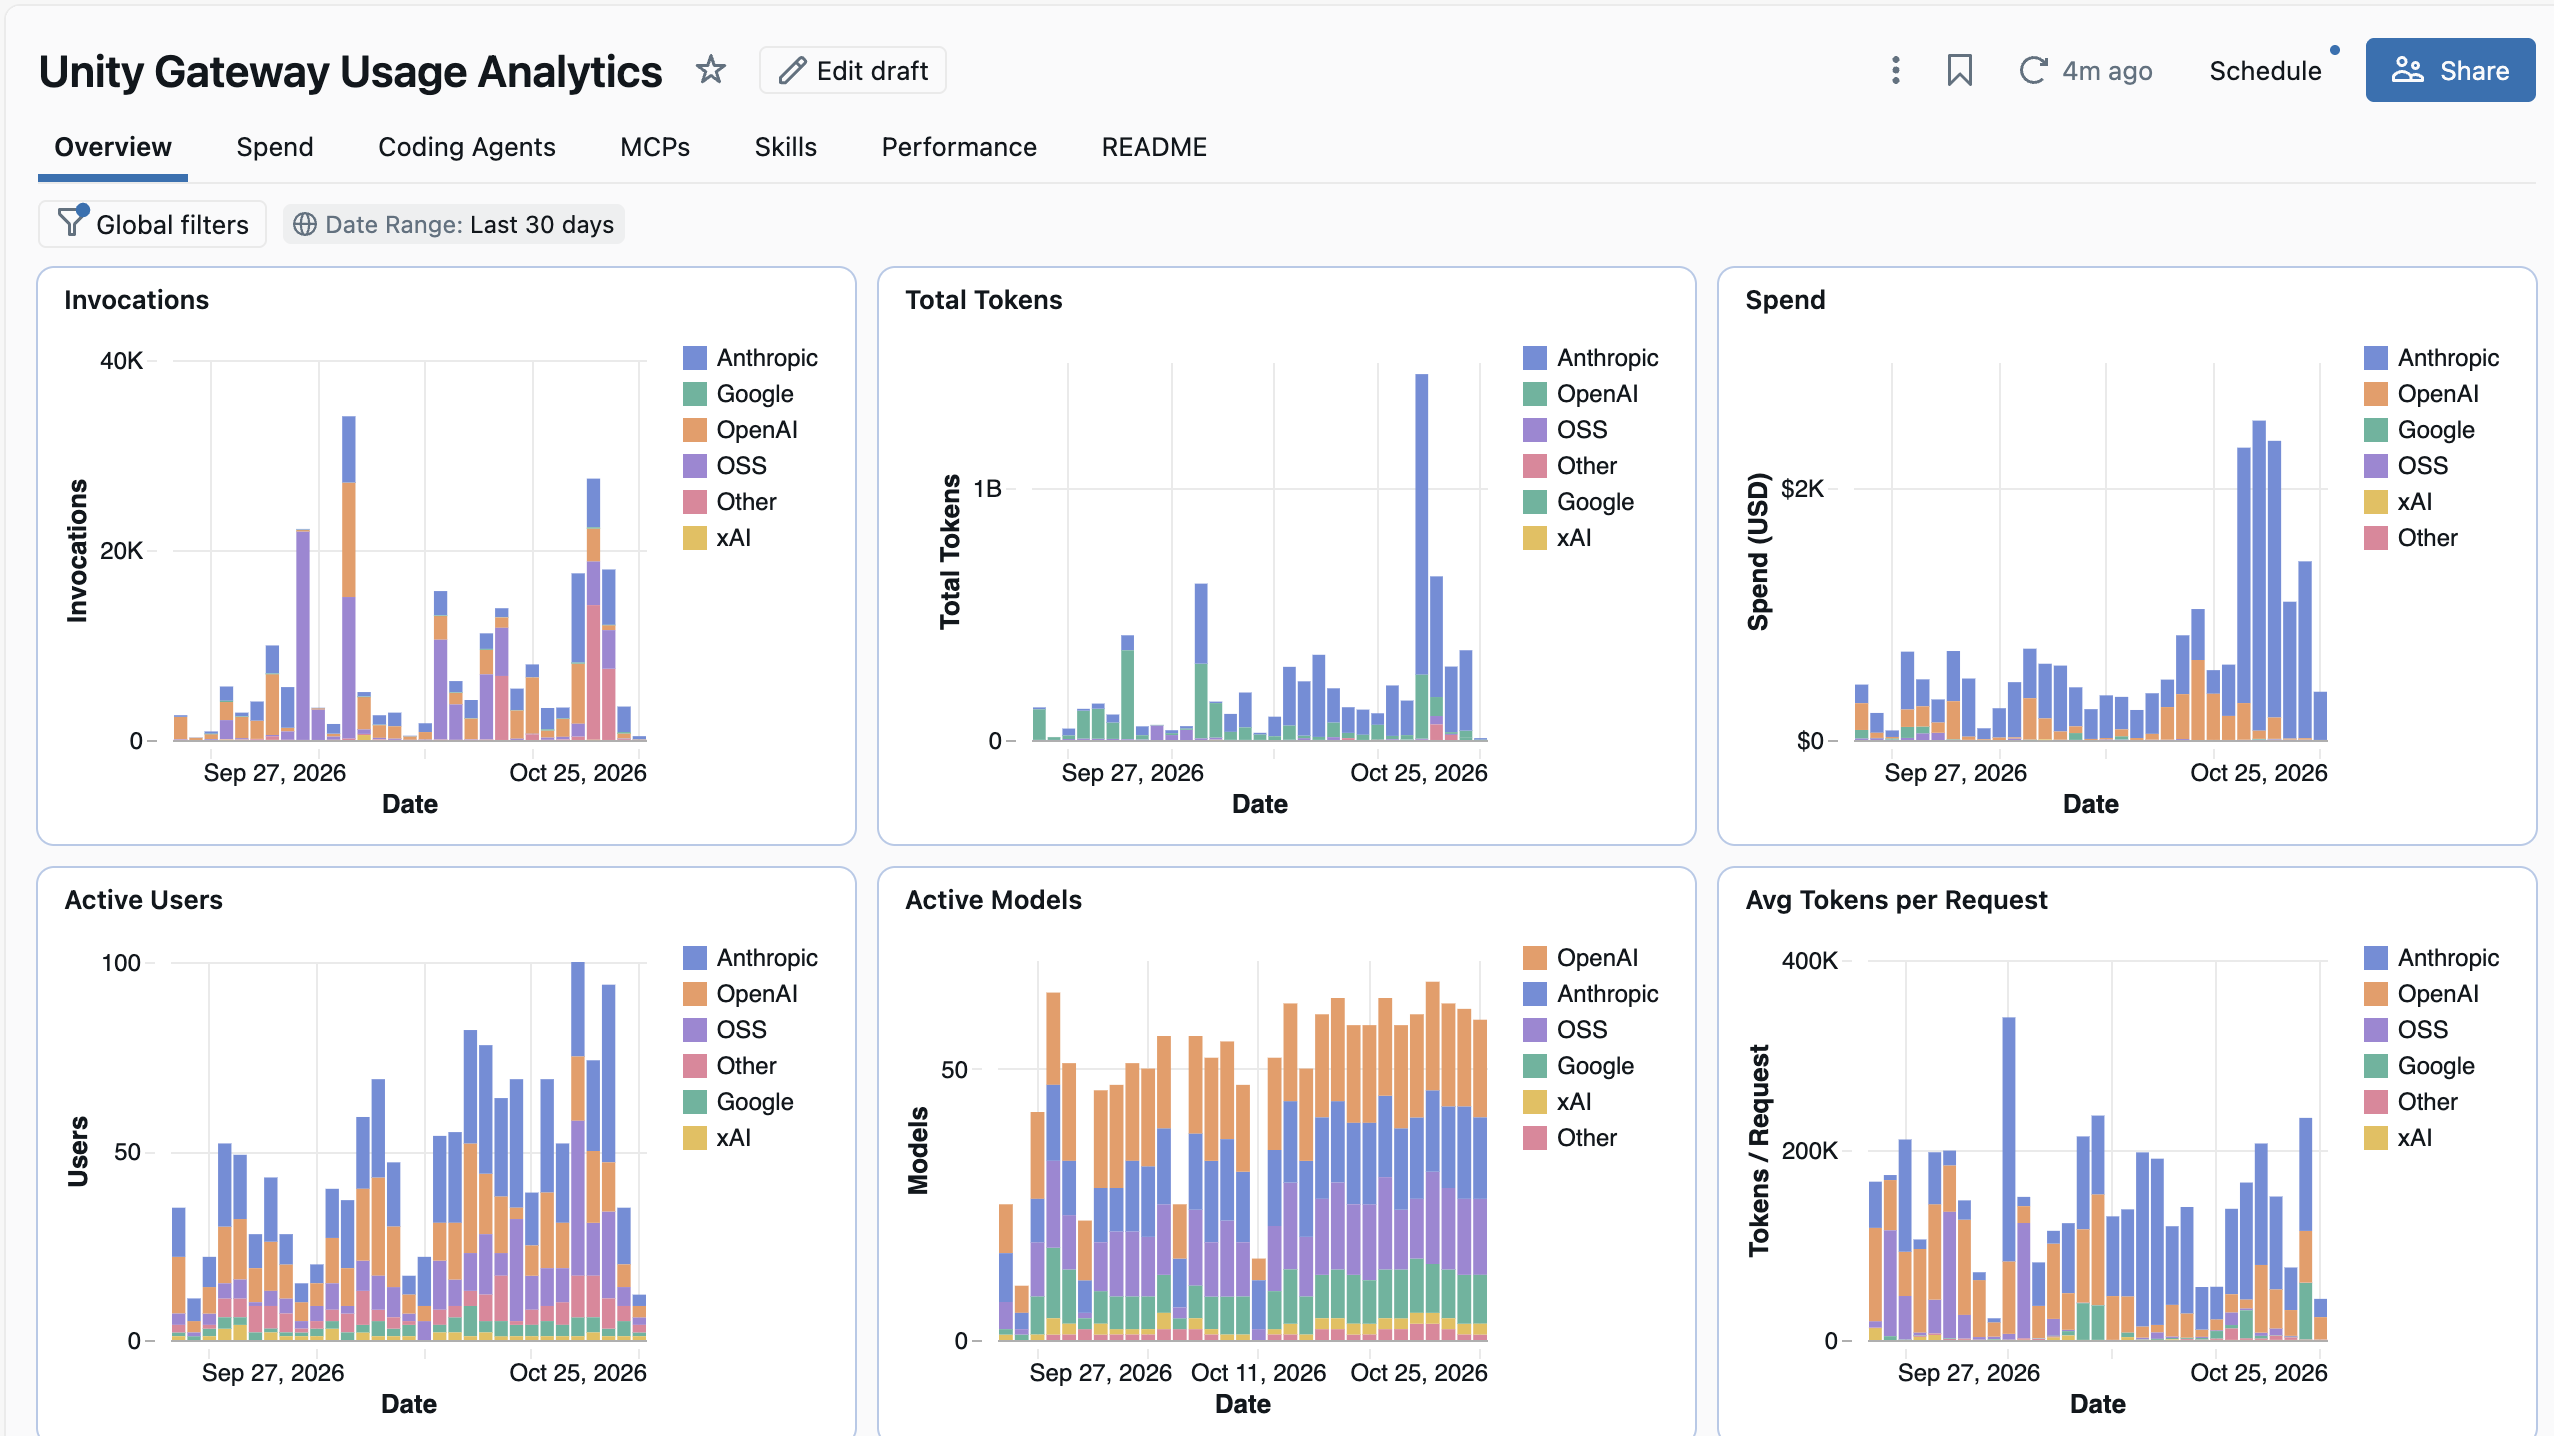
Klicken Sie auf Govern > Usage Dashboard, um das Dashboard in einem neuen Tab zu öffnen.
| Tab | Analyse |
|---|---|
| Overview | Überprüfen Sie die Nutzung, Tokens, aktive Nutzer und Coding-Agent-Sitzungen. Vergleichen Sie Modelle und Nutzer nach Ausgaben, Ausgabetrends und Ausgaben pro Token oder Anfrage. |
| Ausgeben | Analysieren Sie Ausgaben nach Modell und Nutzer, vergleichen Sie Tokenverbrauch und Caching sowie ordnen Sie Ausgaben über Service- und Request-Tags zu. |
| Coding-Agents | Vergleichen Sie Agenten-Adoption, Harness-Nutzung, Sitzungen, Token-Konsum und Subagenten. Untersuchen Sie einzelne Sitzungen, sortiert nach geschätzten Ausgaben. |
| Smart Routing | Verfolgen Sie geschätzte Einsparungen durch Smart Routing, Session- und Nutzereinführung, die Opt-out-Rate der Sitzungen und die Modellmischung für Smart-Routing- und Nicht-Smart-Routing-Anfragen. |
| MCPs | Verfolgen Sie Tool-Anrufe und aktive Nutzer, identifizieren Sie häufig genutzte Dienste und Tools und vergleichen Sie Nutzungsquellen. |
| Fähigkeiten | Verfolgen Sie Fertigkeits-Downloads und Ladevorgänge, vergleiche die Nutzung von Fertigkeiten und überprüfen Sie Aktivitäten nach Nutzern. |
| Leistung | Vergleichen Sie Modell- und MCP-Latenz, Streaming-Zeit bis zum ersten Byte, Ausgabe-Tokens pro Sekunde, Cache-Hit-Rate, Fehler und rate-limitierte Aufrufe. |
| README | Überprüfen Sie Dashboard-Funktionen, aktuelle Änderungen und Links zu den zugrunde liegenden Datenquellen. |
Wählen Sie einen Datumsbereich aus, um die Analyse zu fokussieren, oder wählen Sie einen Service Tag Key sowie einen oder mehrere Service Tag Value-Einträge, um die Nutzung und Ausgaben auf bestimmte Teams oder Projekte einzuschränken. Dashboards auf Kontoebene enthalten außerdem einen Filter Workspace-ID. Service-Tag-Filter gelten nicht für den Reiter Fähigkeiten.
Dashboard aktualisieren
Wenn eine neuere Dashboard-Version verfügbar ist, kann ein Kontoadministrator in der Dashboard-Versionszeile im Verwalten-Dropdown auf Aktualisieren klicken. Mit aktivierten automatischen Updates wird eine neuere Vorlage angewendet, wenn ein Kontoadministrator die Unity-Gateway-Seite besucht.
Ein Update ersetzt den Dashboard-Inhalt durch die neueste Vorlage und kann Anpassungen überschreiben. Speichere eine Kopie vor dem Aktualisieren, wenn du deine Änderungen erhalten möchtest.
Aktualisieren Sie die Dashboard-Daten
Die geplante Datenaktualisierung aktualisiert alle sechs Stunden die Abfrageergebnisse.
Verwalten Sie den Aktualisierungsplan im Dashboard. Siehe Erstellen eines Zeitplans.
Verwendungstabellenschema
Die system.ai_gateway.usage Tabelle weist das folgende Schema auf:
| Spaltenname | Typ | Beschreibung | Example |
|---|---|---|---|
account_id |
STRING | Die Konto-ID. | 11d77e21-5e05-4196-af72-423257f74974 |
workspace_id |
STRING | Die Arbeitsbereichs-ID. | 1653573648247579 |
request_id |
STRING | Ein eindeutiger Bezeichner für die Anforderung. | b4a47a30-0e18-4ae3-9a7f-29bcb07e0f00 |
invocation_id |
STRING | Ein eindeutiger Bezeichner für jeden einzelnen Ableitungsaufruf. Mehrere Aufrufe können dasselbe request_id teilen, z. B. Guardrail-Prüfungen oder Multi-Turn-Agent-Aufrufe. Verwenden Sie invocation_id, um sie zu unterscheiden. |
c0a8012e-9f3b-4d21-8a7e-1b2c3d4e5f60 |
schema_version |
INTEGER | Die Schemaversion des Verwendungsdatensatzes. | 1 |
service_type |
STRING | Die Art des Dienstes, der den Nutzungsdatensatz generiert hat. Die Werte sind MODEL_SERVICE, MCP_SERVICE, und MODEL_PROVIDER_SERVICE. |
MODEL_SERVICE |
service_id |
STRING | Die ID des Modelldienstes, MCP-Dienstes oder Modellanbieterdienstes. | 43addf89-d802-3ca2-bd54-fe4d2a60d58a |
service_name |
STRING | Der vollständig qualifizierte Name des Dienstes im Unity Catalog. | main.default.github_tools |
service_tags |
MAP | Ressourcen-Tags, die auf den Unity Catalog angewendet werden, sind bei der Erstellung oder Aktualisierung sicher. Sie gelten für alle Anfragen an den Dienst und sind nützlich, um die Nutzung nach Team, Kostenstelle oder Projekt zu kategorisieren. | {"team": "engineering"} |
endpoint_id |
STRING | Die eindeutige ID des Unity-Gateway-Modelldienstes. | 43addf89-d802-3ca2-bd54-fe4d2a60d58a |
endpoint_name |
STRING | Der Name des Unity Gateway Modelldienstes. | system.ai.gpt-5-2 |
endpoint_tags |
MAP | Tags, die beim Erstellen oder Aktualisieren auf dem Modelldienst konfiguriert sind. Sie gelten für alle Anforderungen an den Modelldienst und eignen sich für die Kategorisierung von Diensten nach Team, Kostenstelle oder Projekt. | {"team": "engineering"} |
endpoint_metadata |
STRUCT | Modelldienstmetadaten, einschließlich creator, creation_time, last_updated_time, destinations, inference_tableund fallbacks. |
{"creator": "user.name@email.com", "creation_time": "2026-01-06T12:00:00.000Z", ...} |
event_time |
TIMESTAMP | Der Zeitstempel, zu dem die Anforderung empfangen wurde. | 2026-01-20T19:48:08.000+00:00 |
latency_ms |
LONG | Die Gesamtlatenz in Millisekunden. | 300 |
time_to_first_byte_ms |
LONG | Die Zeit für das erste Byte in Millisekunden. | 300 |
destination_type |
STRING | Der Zieltyp (z. B. externes Modell oder Foundation-Modell). | PAY_PER_TOKEN_FOUNDATION_MODEL |
destination_name |
STRING | Der Name des Zielmodells oder Anbieters. | system.ai.gpt-5-2 |
destination_id |
STRING | Die eindeutige ID des Ziels. | 507e7456151b3cc89e05ff48161efb87 |
destination_model |
STRING | Das für die Anforderung verwendete spezifische Modell. | GPT-5.2 |
requester |
STRING | Die ID des Benutzers oder Dienstprinzipals, der die Anforderung gestellt hat. | user.name@email.com |
requester_type |
STRING | Der Typ des Anforderers (Benutzer, Dienstprinzipal oder Benutzergruppe). | USER |
ip_address |
STRING | Die IP-Adresse des Anforderers. | 1.2.3.4 |
url |
STRING | Die URL der Anforderung. | https://<workspace-url>/ai-gateway/mlflow/v1/chat/completions |
user_agent |
STRING | Der Benutzer-Agent des Anforderers. | OpenAI/Python 2.13.0 |
api_type |
STRING | Der Typ des API-Aufrufs (z. B. Chat, Fertigstellungen oder Einbettungen). | mlflow/v1/chat/completions |
request_tags |
MAP | Vom Benutzer bereitgestellte Tags, die mit einzelnen Anfragen über den HTTP-Header Databricks-Ai-Gateway-Request-Tags gesendet werden. Verwenden Sie Anforderungstags, um die Verwendung bestimmten Projekten, Teams, Umgebungen oder Endbenutzern zuzuordnen. Siehe Tag-Anfragen für Nutzungsverfolgung und Anfrage-Tagging. |
{"project": "chatbot", "team": "ml-platform"} |
invocation_metadata |
STRUCT | Informationen darüber, woher die Anfrage stammt, welche Dienststufe vom Modellanbieter gemeldet wird und ob die Anfrage ein Claude-Abonnement verwendet. | {"source": "EXTERNAL_CLIENT", "service_tier": "priority", "relayed": false} |
input_tokens |
LONG | Die Anzahl der Eingabetoken. | 100 |
output_tokens |
LONG | Die Anzahl der Ausgabetoken. | 100 |
total_tokens |
LONG | Die Gesamtzahl der Token (Eingabe + Ausgabe). | 200 |
token_details |
STRUCT | Detaillierte Aufschlüsselung der Token- und Werkzeugnutzung, einschließlich cache_read_input_tokens, cache_creation_5m_input_tokens, output_reasoning_tokens, cache_creation_1h_input_tokens, file_search_count, num_web_search_queries und cache_creation_input_tokens. |
{"cache_read_input_tokens": 100, ...} |
response_content_type |
STRING | Der Inhaltstyp der Antwort. | application/json |
status_code |
INT | Der HTTP-Statuscode der Antwort. | 200 |
routing_information |
STRUCT | Routeninformationen für Fallback-Versuche. Enthält ein attempts Array mit priority, action, destinationdestination_idstatus_codeerror_code, latency_msund start_timeend_time für jedes Modell, das während der Anforderung versucht wurde. |
{"attempts": [{"priority": "1", ...}]} |
mcp_metadata |
STRUCT | Details einer Anfrage an einen MCP-Service, einschließlich des aufgerufenen Tools, des Servertyps und der JSON-RPC Operation. Gefüllt für MCP_SERVICE Zeilen. |
{"tool_name": "echo", "server_type": "EXTERNAL", "json_rpc_method": "tools/call"} |
session_metadata |
STRUCT | Sitzungs- und Clientkontext, einschließlich Session- und Subagenten-IDs, Name und Version des Codieragenten, Client-Interface, Argumentationsaufwand und Smart-Routing-Rezept. Verwenden Sie diese Felder, um verwandte Anfragen zu gruppieren und die Nutzung nach Agent oder Sitzung zu analysieren. | {"coding_agent": "claude-code", "agent_version": "2.1.282", "reasoning_effort": "high", ...} |
auth_mode |
STRING | Der Databricks-Zugangstyp, der zur Authentifizierung der Anfrage verwendet wird: ein persönliches Zugriffstoken (PAT) oder ein OAuth-Token (OAUTH). |
OAUTH |
Verschachtelte Spaltenschemata
Die folgenden Tabellen beschreiben Felder innerhalb verschachtelter Spalten STRUCT . Die Feldverfügbarkeit hängt vom für die Anfrage verwendeten Dienst, Modell und Client ab.
Aufruf und Token-Metadaten
| Feldpfad | Typ | Beschreibung |
|---|---|---|
invocation_metadata.source |
STRING | Die Anwendung, der Dienst oder die API, die die Anfrage initiiert hat. Verwenden Sie dieses Feld, um die Nutzung seiner Quelle zuzuordnen. Zu den Werten gehören AI_PLAYGROUND, EXTERNAL_CLIENT, AI_QUERY, DATABRICKS_APPS, GUARDRAIL, ROUTER, MANAGED_AGENT, WEB_SEARCH und SAFEGUARD_CLASSIFIER. |
invocation_metadata.service_tier |
STRING | Die vom Modellanbieter in der Inferenzantwort gemeldete Service-Schicht, wie default oder priority. Nutzen Sie dieses Feld, um die Nutzung zwischen den Preisstufen der Anbieter zu vergleichen. |
invocation_metadata.relayed |
BOOLEAN | Ob die Anfrage über das Claude-Abonnement des Anrufers an Anthropic weitergeleitet wurde. |
token_details.cache_read_input_tokens |
LONG | Die Anzahl der Token, die aus dem Prompt-Cache gelesen werden. |
token_details.cache_creation_input_tokens |
LONG | Die Anzahl der Token, die in den Prompt-Cache geschrieben werden. |
token_details.output_reasoning_tokens |
LONG | Die Anzahl der Argumentationstoken im Output. |
token_details.cache_creation_5m_input_tokens |
LONG | Die Anzahl der in den Prompt-Cache geschriebenen Eingabetoken mit einer Lebensdauer von 5 Minuten. |
token_details.cache_creation_1h_input_tokens |
LONG | Die Anzahl der in den Prompt-Cache geschriebenen Eingabetoken mit einer Lebensdauer von 1 Stunde. |
token_details.file_search_count |
LONG | Die Anzahl der Dateisuch-Toolaufrufe, die im Rahmen der Anfrage durchgeführt werden. |
token_details.num_web_search_queries |
LONG | Die Anzahl der abrechenbaren Websuchanfragen, die im Rahmen der Anfrage ausgeführt wurden. |
MCP-Servicemetadaten
Diese Felder werden in mcp_metadata für MCP_SERVICE Zeilen ausgefüllt.
| Feldpfad | Typ | Beschreibung |
|---|---|---|
mcp_metadata.tool_name |
STRING | Der Name des von einer MCP-Anfrage tools/call aufgerufenen Werkzeugs. Nutzen Sie dieses Feld, um die Nutzung einzelner Tools auf einem Server zu analysieren. |
mcp_metadata.server_type |
STRING | Die Kategorie des MCP-Servers, der die Anfrage behandelt, wie EXTERNAL oder SYSTEM. |
mcp_metadata.json_rpc_method |
STRING | Die JSON-RPC Operation, die vom Client angefordert wird, wie tools/call zum Beispiel ein Werkzeug aufzurufen, tools/list Werkzeuge zu entdecken oder initialize eine Sitzung zu starten. |
Sitzungsmetadaten
Die Felder session_metadata helfen dabei, Anfragen innerhalb einer Sitzung zu korrelieren und unterscheiden Codierungsagenten, Client-Oberflächen und Anfrageeinstellungen. Jedes Feld wird ausgefüllt, wenn die entsprechenden Informationen vom Client oder der Anfrage verfügbar sind. Der Client meldet coding_agent, agent_version, und surface über seine Anfrageheader, und Unity Gateway überprüft diese nicht.
| Feldpfad | Typ | Beschreibung |
|---|---|---|
session_metadata.client_session_id |
STRING | Die vom Client bereitgestellte Session-ID. Nutze es, um Anfragen zu gruppieren, die während derselben Gesprächs- oder Coding-Agent-Sitzung gestellt werden. |
session_metadata.client_subagent_id |
STRING | Die vom Client bereitgestellte Subagent-ID. Nutzen Sie es mit client_session_id, um Anfragen von Subagenten innerhalb einer übergeordneten Sitzung zu unterscheiden. |
session_metadata.coding_agent |
STRING | Der normalisierte Name des Coding-Agenten, der die Anfrage gesendet hat, wie claude-code oder codex. Unity Gateway liest den Namen aus dem Databricks-Custom-Coding-Agent-Header, wenn dieser einen Wert enthält. Andernfalls leitet er den Namen aus dem User-Agent Header ab. |
session_metadata.agent_version |
STRING | Die vom Coding-Agent gemeldete Version wurde aus dem User-Agent-Header abgeleitet. Verwende es mit coding_agent, um die Nutzung über Agent-Releases hinweg zu vergleichen. Nicht befüllt, wenn der Databricks-Custom-Coding-Agent-Header coding_agent setzt. |
session_metadata.surface |
STRING | Die Client-Schnittstelle, von der der Coding-Agent die Anfrage gesendet hat, wie zum Beispiel eine Kommandozeilen-Schnittstelle, IDE oder Desktop-Anwendung. Mehrere Schnittstellen sind durch Zwischenräume getrennt. Schnittstellen, die im kommagetrennten Databricks-Custom-Client-Surfaces Anfrageheader aufgeführt sind, kommen zuerst, gefolgt von Schnittstellen, die aus den User-Agent und-Headern originator abgeleitet werden. Bei MCP_SERVICE Zeilen kommen die Schnittstellen nur aus dem Header User-Agent . |
session_metadata.reasoning_effort |
STRING | Der in der Anfrage angegebene Argumentationsaufwand, wie low, medium, oder high. Verfügbare Werte hängen vom Modell und der API ab. |
session_metadata.smart_router_name |
STRING | Der Name des vom Client ausgewählten Smart-Routing-Rezepts. Nutze es, um die Nutzung nach Routing-Rezept zu gruppieren. |
Tag-Anforderungen für die Verwendungsnachverfolgung
Anforderungstags sind benutzerdefinierte Schlüssel-Wert-Paare, die der Aufrufer an einzelne Anforderungen anfügt. Verwenden Sie Anforderungstags, um die Verwendung nach Projekt, Team, Umgebung, Endbenutzer oder einer anderen Dimension zu attributieren, die für Ihre Organisation relevant ist. Anforderungstags werden in der system.ai_gateway.usage Tabelle protokolliert und können verwendet werden, um Nutzungsdaten zu filtern, zu aggregieren und zu analysieren.
Um einzelne Anfragen zu kennzeichnen, fügen Sie den Databricks-Ai-Gateway-Request-Tags HTTP-Header mit einem JSON-Objekt hinzu, das Zeichenfolgenschlüssel Zeichenfolgenwerten zuordnet. Anfrage-Tags werden in der request_tags Spalte der Nutzungstabelle und in Inferenztabellen protokolliert.
Beispiele, die zeigen, wie man Anfrage-Tags mit der REST API, dem OpenAI SDK und dem Anthropic SDK einsetzt, siehe Anfrage-Tagging.
Beispielsweise können Sie die Nutzung nach Projekt mithilfe von Anforderungstags aggregieren:
SELECT
  request_tags['project'] AS project,
  COUNT(*) AS request_count,
  SUM(total_tokens) AS total_tokens
FROM system.ai_gateway.usage
WHERE request_tags['project'] IS NOT NULL
GROUP BY request_tags['project']
ORDER BY total_tokens DESC;
Einschränkungen
- Unity Gateway verfolgt die Tokennutzung nicht für nicht gestreamte Antworten ohne Einbettungen, die größer als 1 MiB sind.
-
Die aufgabenspezifische Nutzung von KI-Funktionen wie
ai_parse_documentundai_extractwird auf die Budgets des Unity Gateway angerechnet, aber nicht in der Tabellesystem.ai_gateway.usageerfasst. Um die abgerechnete Nutzung anzuzeigen, siehe Kosten anzeigen für AI-Funktions-Workloads.