Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Fabric Runtime bietet eine nahtlose Integration im Fabric-Ökosystem und bietet eine robuste Umgebung für Data Engineering und Data-Science-Projekte, die von Apache Spark betrieben werden.
Dieser Artikel stellt Fabric Runtime 2.0 vor, die aktuellste allgemein verfügbare (GA) und Standardlaufzeit in Microsoft Fabric. Runtime 2.0 ist die Standardauswahl für neue Arbeitsbereiche und Umgebungselemente. Es stellt Funktionen und Komponenten für skalierbare Analysen und fortgeschrittene Workloads bereit.
Fabric Runtime 2.0 enthält die folgenden Komponenten und Upgrades, die entwickelt wurden, um Ihre Datenverarbeitungsfunktionen zu verbessern:
- Apache Spark 4.1
- Betriebssystem: Azure Linux 3.0 (Mariner 3.0)
- Java: 21
- Skala: 2.13
- Python: 3.13
- Delta Lake: 4,2
- R: 4.5.2
Von Bedeutung
Fabric-Laufzeit-Release-Kanäle ermöglichen es Ihnen, kommende Laufzeitänderungen frühzeitig zu testen und die Workload-Kompatibilität zu überprüfen, bevor Updates zur Standardeinstellung werden. Dieser Ansatz hilft, unerwartete Produktionsunterbrechungen zu reduzieren und bietet mehr Kontrolle über Laufzeit-Upgrades. Erfahren Sie mehr über Veröffentlichungskanäle.
Tipp
Fabric Runtime 2.0 enthält Unterstützung für das native Ausführungsmodul, das die Leistung ohne mehr Kosten erheblich verbessern kann. Sie können das systemeigene Ausführungsmodul auf Umgebungsebene aktivieren, sodass alle Aufträge und Notizbücher automatisch die erweiterten Leistungsfunktionen erben.
Aktivieren von Runtime 2.0
Neue Arbeitsbereiche und Umgebungsobjekte verwenden standardmäßig Runtime 2.0. Wenn Ihr Arbeitsbereich oder Ihre Umgebung eine frühere Laufzeit verwendet, folgen Sie diesen Schritten, um nach Überprüfung der Workload-Kompatibilität Runtime 2.0 auszuwählen. Die Laufzeitauswahl eines Umgebungselements überschreibt den Arbeitsbereich-Standard für Notizbücher und Spark-Job-Definitionen, die mit dieser Umgebung verbunden sind.
Aktivieren von Runtime 2.0 in arbeitsbereichseinstellungen
So legen Sie Runtime 2.0 als Standard für den gesamten Arbeitsbereich fest:
Navigieren Sie zur Seite "Arbeitsbereichseinstellungen" in Ihrem Fabric-Arbeitsbereich .
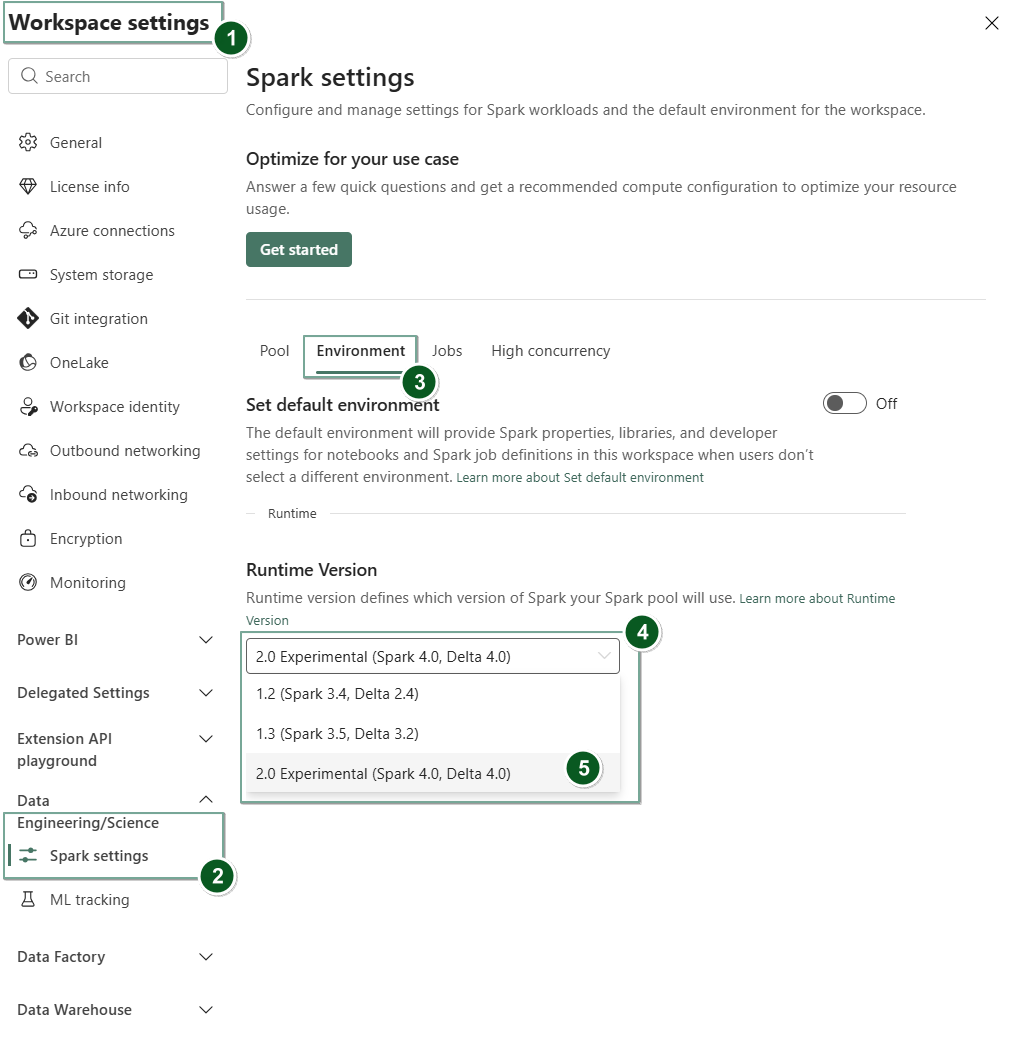
Wählen Sie die Registerkarte "Datentechnik/Wissenschaft " und dann "Spark"-Einstellungen aus.
Wählen Sie die Registerkarte Umgebung aus.
Im Dropdown zur Laufzeitversion wähle 2.0 (Spark 4.1, Delta 4.2) und speichere deine Änderungen.
Runtime 2.0 wird als Standardlaufzeit für Ihren Arbeitsbereich festgelegt.
Aktivieren von Runtime 2.0 in einem Umgebungselement
So verwenden Sie Runtime 2.0 mit bestimmten Notizbüchern oder Spark-Auftragsdefinitionen:
Erstellen Sie ein neues Umgebungselement , oder öffnen Sie ein vorhandenes Element.
Im Runtime-Dropdown-Menü wählen Sie 2.0 (Spark 4.1, Delta 4.2),speichern und Ihre Änderungen veröffentlichen .
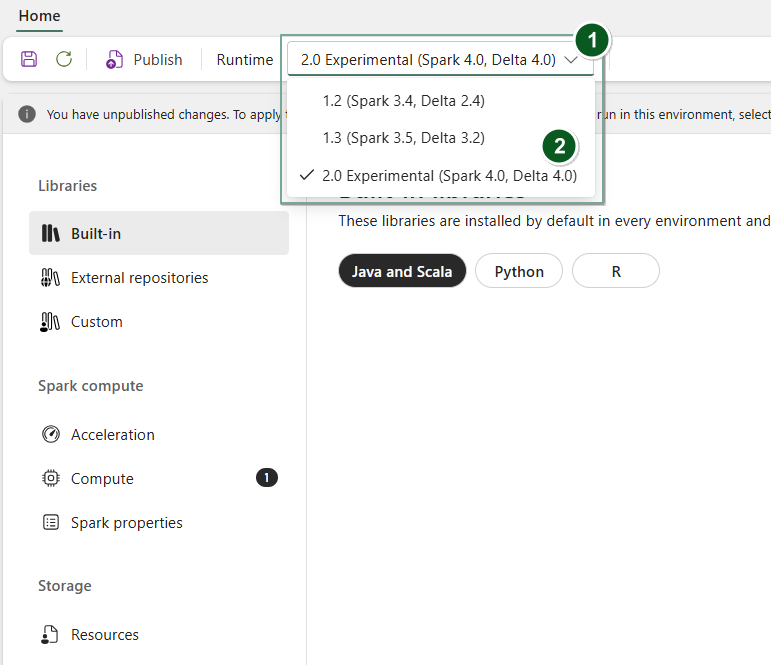
Verwenden Sie als Nächstes dieses Element „Umgebung“ mit Ihrem Notizbuch oder Ihrer Spark-Job-Definition.
Sie können jetzt mit den neuesten Verbesserungen und Funktionen arbeiten, die in Fabric Runtime 2.0 eingeführt wurden (Spark 4.1 und Delta Lake 4.2).
Hinweis
Bevor Sie einen bestehenden Arbeitsbereich oder eine Umgebung auf Runtime 2.0 umstellen, überprüfen Sie Ihre Bibliotheken, Spark-Einstellungen und Workloads. Für Kompatibilitätsüberlegungen und einen gestuften Migrationsprozess siehe Migrieren von Runtime 1.3 zu Runtime 2.0.
Tipp
Um aktuelle Informationen, eine ausführliche Liste der Änderungen und spezifische Versionshinweise für Fabric-Runtimes zu erhalten, sollten Sie Spark-Runtimes – Versionen und Updates lesen und abonnieren.
Wichtigste Highlights
Verbesserungen der Leistungs- und Ausführungs-Engine
Fabric Runtime 2.0 enthält das systemeigene Ausführungsmodul, das erhebliche Leistungsverbesserungen gegenüber Open-Source-Spark bietet. Die Engine verwendet die vektorisierte Verarbeitung, um Spark-Abfragen in der Lakehouse-Infrastruktur zu beschleunigen, ohne dass Codeänderungen erforderlich sind.
Wichtige Leistungsfeatures in Runtime 2.0:
- Bis zu sechs mal schneller: Benchmarks zeigen im Vergleich zu Open-Source-Spark auf TPC-DS Workloads bis zu sechs mal schnellere Leistung an.
- Vektorisierte CSV-Analyse: Das systemeigene Ausführungsmodul enthält einen vektorisierten CSV-Parser, der die CSV-Erfassung und Abfrageworkloads beschleunigt. Vektorisierte JSON-Analyse und Spark Structured Streaming-Unterstützung sind für zukünftige Updates geplant.
Informationen zum Aktivieren des nativen Ausführungsmoduls finden Sie unter natives Ausführungsmodul für Fabric Data Engineering.
Apache Spark 4.1
Apache Spark 4.0 markierte einen bedeutenden Meilenstein als die erste Version der 4.x-Serie, die den kollektiven Aufwand der lebendigen Open-Source-Community verkörperte. Fabric Runtime 2.0 wird jetzt auf Apache Spark 4.1 ausgeführt, das auf dieser Grundlage mit zusätzlichen Verbesserungen basiert.
In dieser Version wird Spark SQL erheblich mit leistungsstarken neuen Features erweitert, die zur Steigerung der Ausdrucksfähigkeit und Vielseitigkeit für SQL-Workloads entwickelt wurden, z. B. unterstützung von VARIANT-Datentypen, SQL benutzerdefinierte Funktionen, Sitzungsvariablen, Pipesyntax und Zeichenfolgensortierung. PySpark zeigt kontinuierliche Bemühungen um sowohl die funktionale Vielseitigkeit als auch das gesamte Entwicklererlebnis, indem es eine native Plotting-API, eine neue Python-Datenquellen-API, Unterstützung für Python UDTFs sowie einheitliches Profiling für PySpark UDFs bietet, neben zahlreichen weiteren Verbesserungen. Strukturiertes Streaming entwickelt sich mit wichtigen Ergänzungen, die eine bessere Kontrolle und einfaches Debuggen bieten, insbesondere die Einführung der Willkürlichen Zustands-API v2 für eine flexiblere Zustandsverwaltung und die Zustandsdatenquelle zum einfacheren Debuggen.
Hier können Sie die vollständige Liste und detaillierte Änderungen überprüfen:
Hinweis
In Spark 4.x ist SparkR veraltet und kann in einer zukünftigen Version entfernt werden.
Delta Lake 4.2
Delta Lake 4.2 baut auf früheren Delta-Lake-Veröffentlichungen auf und setzt das Engagement fort, Delta Lake formatübergreifend, einfacher zu bedienen und leistungsfähiger zu machen. Es umfasst leistungsstarke neue Features, Leistungsoptimierungen und grundlegende Verbesserungen für die Zukunft offener Data Lakehouses.
Die vollständige Liste und detaillierte Änderungen, die mit Delta Lake 3.3, 4.0, 4.1 und 4.2 eingeführt wurden, finden Sie:
Datenlayout und -optimierung
Runtime 2.0 unterstützt Datenlayout- und Optimierungsfeatures für Delta-Tabellen:
- Z-Sortierung: Organisieren Sie Daten in Delta-Tabellendateien nach angegebenen Spalten, um die Abfrageleistung für gefilterte Abfragen zu verbessern.
- Liquid Clustering: Ein flexibler Clustering-Ansatz, der das Datenlayout automatisch ohne manuelle Wartung optimiert.
- Paralleles Laden von Delta-Snapshots: Das native Ausführungsmodul lädt Delta-Tabellen-Snapshots parallel und reduziert dadurch die Startzeit von Abfragen bei großen Tabellen.
Von Bedeutung
Die spezifischen Funktionen von Delta Lake 4.2 sind experimentell und funktionieren nur auf Spark-Erlebnissen, wie Notebooks und Spark-Job-Definitionen. Wenn Sie dieselben Delta Lake-Tabellen über mehrere Microsoft Fabric-Workloads hinweg verwenden müssen, aktivieren Sie diese Features nicht. Um mehr darüber zu erfahren, welche Protokollversionen und -funktionen über alle Microsoft Fabric-Erfahrungen kompatibel sind, siehe Delta Lake Table Format Interoperability.
Rechenverwaltung in Runtime 2.0
Runtime 2.0 unterstützt die folgenden Rechnerverwaltungsfeatures:
- Ressourcenprofile: Konfigurieren Sie vordefinierte Ressourcenzuordnungen für Spark-Sitzungen so, dass sie den Workloadanforderungen entsprechen und Kosten steuern.
- Benutzerdefinierte Livepools (Vorschau):Erstellen Sie dedizierte, vorgewärmte Spark-Pools, die die Startzeit der Sitzung reduzieren. Benutzerdefinierte Livepools sind in der Vorschau für Runtime 2.0-Workloads verfügbar.
Einschränkungen und Hinweise
- Delta Lake 4.x-spezifische Features sind experimentell und funktionieren nur für Spark-Umgebungen, wie Notizbücher und Spark-Auftragsdefinitionen. Wenn Sie die gleichen Delta Lake-Tabellen für mehrere Fabric-Workloads verwenden müssen, aktivieren Sie diese Features nicht. Weitere Informationen finden Sie unter Interoperabilität des Delta Lake-Tabellenformats.
- Die VS Code-Erweiterung für Fabric Spark unterstützt Runtime 2.0 für die Entwicklung von Notizbüchern und Spark-Auftragsdefinitionen.
Verwandte Inhalte
- Migration von Runtime 1.3 zu Runtime 2.0
- Apache Spark Runtimes in Fabric – Übersicht, Versionsverwaltung und Unterstützung für mehrere Runtimes
- Anleitung zur Migration von Spark Core
- Anleitung zur Migration von SQL, DataSets und DataFrame
- Anleitung zur Migration von strukturiertem Streaming
- Anleitung zur Migration von MLlib (Maschinelles Lernen)
- Anleitung zur Migration von PySpark (Python in Spark)
- Anleitung zur Migration von SparkR (R in Spark)