Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Azure NetApp Files
Microsoft Fabric
Azure KI Search
Microsoft Foundry
Azure Machine Learning
Lösungsmöglichkeiten
In diesem Artikel wird eine Lösungsidee beschrieben. Ihr Cloudarchitekt kann diesen Leitfaden verwenden, um die Hauptkomponenten einer typischen Implementierung dieser Architektur zu visualisieren. Verwenden Sie diesen Artikel als Ausgangspunkt, um eine gut durchdachte Lösung zu entwerfen, die den spezifischen Anforderungen Ihrer Workload entspricht.
Diese Lösungsidee beschreibt, wie die Azure NetApp Files Object REST-API Organisationen dabei hilft, vorhandene Unternehmensdateidaten für Analysen und KI zu verwenden, ohne sie zuerst in einen separaten Objektspeicher zu kopieren. Amazon S3-kompatible Anwendungen können Dokumentsuche und KI-unterstützte Analysen unterstützen, während vorhandene NFS- und SMB-Workflows weiterhin auf diese Daten zugreifen. Das Vermeiden einer separaten Quelldatenkopie kann die Zeit für das Onboarding von Analyseworkloads reduzieren, doppelte Speicherkosten reduzieren und die Synchronisierungspipeline entfernen, die Teams andernfalls erstellen, überwachen und behandeln würden. Weniger Quelldatenrepositorys bedeuten auch weniger Kopien zum Steuern und Schützen. Dieser Ansatz unterstützt die inkrementelle Modernisierung, ohne dass Organisationen ihre vorhandenen dateibasierten Anwendungen ersetzen müssen.
Architecture
Diese Architektur konzentriert sich auf Microsoft Fabric Integration mit Azure NetApp Files über die Objekt-REST-API. Das Diagramm zeigt auch Azure Databricks als alternativer Analyseanwender derselben Azure NetApp Files Daten. Sie müssen nicht beide Plattformen bereitstellen. Vorhandene Anwendungen greifen je nach Volumenkonfiguration und Clientanforderungen weiterhin über NFS oder SMB auf die Daten zu.
Azure Databricks Berechnen des Azure NetApp Files Objekt-REST-API-Endpunkts über S3-kompatible Anforderungen mithilfe des Hadoop S3A-Connectors. Dieser alternative Analysepfad verwendet nicht das lokale Datengateway oder Microsoft OneLake.
Die nachgeschalteten KI-Dienste im Diagramm sind illustrativ. Ihre Aufnahmeintegration wird nicht angezeigt.
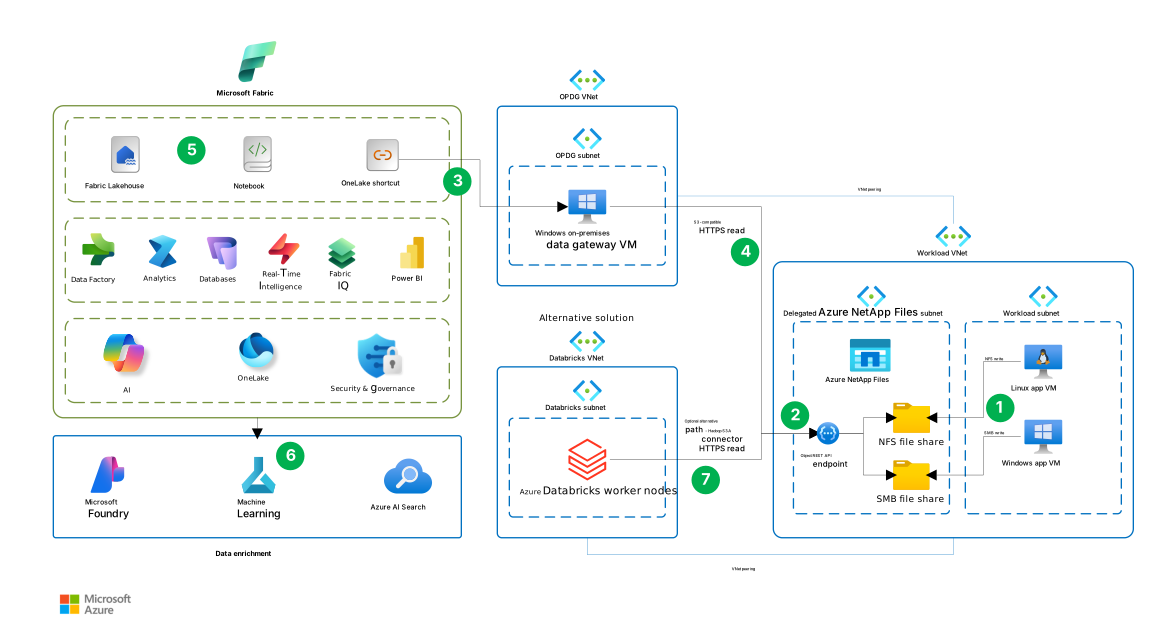
Laden Sie eine Visio-Datei dieser Architektur herunter.
Datenfluss
Die folgenden nummerierten Interaktionen beschreiben das Architekturdiagramm. In den Schritten 1 bis 5 wird der primäre Microsoft Fabric Pfad beschrieben. Schritt 6 stellt optionale nachgelagerte Datenanreicherung dar. Schritt 7 ist ein alternativer Analysepfad, nicht eine Fortsetzung des Fabric Flusses. Die Pfeile mit der Bezeichnung HTTPS-Leserichtung zeigen Anforderungen an den Objekt-REST-API-Endpunkt an; die angeforderten Daten werden an den Verbraucher zurückgegeben.
Anwendungen schreiben Dateidaten. Im Workload-Subnetz schreibt die VM der Linux-Anwendung in die NFS-Dateifreigabe, und die Windows Anwendungs-VM schreibt in die SMB-Dateifreigabe. Azure NetApp Files hosten beide Freigaben im delegierten Subnetz.
Die Objekt-REST-API macht die Dateidaten verfügbar. Der Endpunkt im delegierten ANF-Subnetz bietet S3-kompatiblen Zugriff auf konfigurierte Verzeichnisse auf den Azure NetApp Files Volumes. Die Verbindungen vom Endpunkt zu den NFS- und SMB-Freigaben stellen den Zugriff auf die vorhandenen Daten dar, keine Kopie in einen separaten Objektspeicher.
Fabric greift über eine OneLake-Verknüpfung auf die Daten zu. Die Verknüpfung verweist auf die Azure NetApp Files Daten über eine Verbindung, die die Windows lokalen Datengateway-VM im OPDG-Subnetz (lokales Datengateway) verwendet. Die OneLake-Verknüpfung ist mit diesem Gateway verbunden.
Das Gateway liest aus der Objekt-REST-API. Das Gateway verwendet das Peering zwischen dem OPDG-VNet und dem Workload-VNet, um den Endpunkt zu erreichen. Der S3-kompatible HTTPS-Lesepfad verbindet das Gateway mit dem Endpunkt, der auf die referenzierten Dateidaten für Fabric zugreift. Die Verbindungsanforderungen finden Sie unter Verbinden von OneLake mit einem Azure NetApp Files Volume.
Fabric verarbeitet und analysiert die Daten. Unterstützte Fabric Workloads die Daten über die Verknüpfung nutzen. Beispielsweise lesen Notizbücher die referenzierten Dateien und schreiben abgeleitete Ergebnisse in Lakehouse-Tabellen zur Analyse und Power BI Berichterstellung. Das Feld Fabric im Diagramm zeigt diese Verarbeitungs- und Analysefunktionen.
Optionale nachgeschaltete Dienste bereichern die Daten. Der Pfeil unter Fabric führt zur Datenanreicherungsgruppe, die Microsoft Foundry, Azure Machine Learning und Azure KI-Suche enthält. Dieser Schritt stellt eine optionale nachgelagerte Verarbeitung dar. Das Diagramm zeigt nicht die Aufnahme oder Orchestrierung, die zum Verbinden dieser Dienste erforderlich ist, und die OneLake-Verknüpfung stellt diese Integrationen nicht her.
Alternativ Azure Databricks die Dateidaten direkt lesen. Arbeitsknoten im Databricks-Subnetz verwenden den Hadoop S3A-Connector, um HTTPS-Leseanforderungen an denselben Objekt-REST-API-Endpunkt über die peered virtual networks zu senden. Dieser Pfad ersetzt den Fabric Zugriffs- und Verarbeitungspfad in den Schritten 3 bis 5. Er durchgibt nicht das lokale Datengateway oder OneLake.
Wählen Sie den Verknüpfungsort basierend auf der Beabsichtigten Nutzung der Daten aus:
- Vorhandene kompatible Delta-Tabellen. Erstellen Sie eine Tabellenverknüpfung im Tabellenabschnitt des Lakehouse, die auf die vollständige Delta-Tabelle einschließlich des Transaktionsprotokolls ausgerichtet ist. Fabric erkennt das Ziel als Tabelle, die Sie über Spark und den SQL-Analyseendpunkt abfragen können, während die Quelldaten auf Azure NetApp Files verbleiben.
- Dateien für den direkten Zugriff oder die Verarbeitung. Erstellen Sie Verknüpfungen im Abschnitt "Dateien " des Lakehouse. Kompatible Workloads können eigenständige Parkett-, CSV- und JSON-Dateien zusätzlich zu Dokumenten lesen, ohne zuerst die Quelldateien in OneLake zu kopieren. Wenn nachgelagerte Analysen Lakehouse-Tabellen erfordern, transformieren oder laden Sie die Quelldaten in abgeleitete Delta-Tabellen in OneLake.
Eigenständige Parkettdateien sind nicht automatisch Delta-Tabellen. Eine Verknüpfung in "Dateien" registriert ihr Ziel nicht automatisch als Tabelle. Weitere Informationen finden Sie unter Wo sie Verknüpfungen in einem Seehaus platzieren können.
Components
Die folgenden Komponenten unterstützen die Fabric-fokussierte Architektur und die optionale Azure Databricks Alternative.
Azure NetApp Files ist ein vollständig verwalteter Dateispeicherdienst, der auf der NetApp-Technologie basiert. In dieser Architektur speichert es das Unternehmensdatenset und stellt den NFS-, SMB- und S3-kompatiblen Objektzugriff über die Objekt-REST-API bereit. Außerdem werden Snapshot- und Replikationsfunktionen bereitgestellt.
Azure NetApp Files Objekt-REST-API macht vorhandene Dateidaten über eine S3-kompatible Schnittstelle verfügbar. In dieser Architektur können kompatible Analyse- und KI-Anwendungen auf die Daten zugreifen, ohne zuerst eine separate Objektspeicherkopie zu erstellen. Die Schnittstelle unterstützt eine Teilmenge von Amazon S3-Vorgängen. Vergewissern Sie sich, dass die unterstützten Vorgänge die Anforderungen Ihrer Anwendung erfüllen, bevor Sie diese Integration auswählen.
Microsoft Fabric ist eine Analyseplattform, die Datenbewegungen, Datenverarbeitung, Erfassung, Transformation, Datenstromverarbeitung durch Real-Time Intelligence und Berichtsaufbau vereint. In dieser Architektur bietet sie die Analyseplattform zum Verarbeiten und Analysieren von Daten aus Azure NetApp Files über OneLake-Verknüpfungen.
OneLake ist der einheitliche logische Datensee für Fabric. In dieser Architektur stellen OneLake-Verknüpfungen die referenzierten Azure NetApp Files Daten für unterstützte Fabric Workloads zur Verfügung.
Azure Virtual Network bietet private Konnektivität zwischen den Azure Ressourcen in dieser Architektur. Das virtuelle Netzwerkpeering ermöglicht dem virtuellen Gatewaycomputer und optionalen Azure Databricks Compute, um den Azure NetApp Files Object REST-API-Endpunkt zu erreichen.
Ein lokales Datengateway verbindet OneLake-Verknüpfungen mit dem Azure NetApp Files Bucketendpunkt. Trotz seines Namens wird das Gateway in dieser Architektur im Standardmodus auf einem Azure virtuellen Computer mit einem unterstützten Windows Betriebssystem ausgeführt. Wählen Sie ein Image aus, das die Anforderungen für die Gatewayinstallation erfüllt. Server Core-Installationen und Windows Container werden nicht unterstützt. Das Gateway initiiert ausgehende Verbindungen über Azure Relay, um mit Fabric zu kommunizieren. Es sind keine eingehenden Verbindungen von Fabric erforderlich. Konfigurieren Sie Ihre Firewall oder Ihren Proxy so, dass die in den Kommunikationseinstellungen für das lokale Datengateway beschriebenen ausgehenden Endpunkte zugelassen werden.
Azure Databricks ist eine optionale alternative Analyseplattform für Data Engineering- und Machine Learning-Workloads. Die Spark-Aufträge verwenden den Hadoop S3A-Connector, der für den Objekt-REST-API-Endpunkt konfiguriert ist, um auf das Azure NetApp Files-Dataset zuzugreifen, anstatt den Fabric Integrationspfad zu verwenden.
Alternatives
Diese Architektur umfasst mehrere Komponenten, die Sie je nach den funktionalen und nichtfunktionellen Anforderungen Ihrer Workload durch andere Azure-Dienste oder -Ansätze ersetzen können. Betrachten Sie die folgenden Alternativen und ihre Kompromisse.
Storage
Berücksichtigen Sie die Protokollanforderungen der Anwendungen und die gemessene Leistung, wenn Sie zwischen Azure Blob Storage und Azure NetApp Files wählen:
Wählen Sie Blob Storage aus, wenn Clients die Blob Storage REST-API oder NFS 3.0 verwenden können und keine SMB oder NFS 4.1 erfordern. Beide Schnittstellen können auf dieselben Daten zugreifen. Der Blob Storage NFS 3.0-Zugriffspfad ist für hochdurchsatzintensive sequenzielle Workloads optimiert, bei denen der Durchsatz mehr als eine niedrige Latenz ist.
Wählen Sie Azure NetApp Files aus, wenn Anwendungen und Analyseworkloads über SMB oder NFS 4.1 und die S3-kompatible Objekt-REST-API auf dieselben Dateien zugreifen müssen oder wenn Dateianwendungen zufällige E/A-Vorgänge mit geringer Latenz erfordern. Für Daten, die bereits auf Azure NetApp Files basieren, fügt die Objekt-REST-API Analysezugriff hinzu, ohne Quellanwendungen oder -daten zu migrieren.
Messen Sie bei beiden Optionen die End-to-End-Latenz und den Durchsatz unter gleichzeitiger Quellanwendungs- und Analyselast. DIE NFS- oder SMB-Leistung richtet keine Objekt-REST-API oder Fabric Leistung ein. Testen Sie daher den beabsichtigten Zugriffspfad anhand der Anforderungen der Workload. Vergleichen Sie die Gesamtkosten, einschließlich Anwendungsänderungen, Migration und fortlaufender Duplizierung und Synchronisierung. Einen Protokoll- und Workloadvergleich finden Sie unter Vergleich Azure Speicherdienste.
Integration
Azure Databricks Aufträge können den Hadoop S3A-Connector verwenden, um Azure NetApp Files Daten über die Objekt-REST-API ohne OneLake oder das lokale Datengateway zu lesen. Konfigurieren Sie TLS-Vertrauensstellung und sicher gespeicherte Anmeldeinformationen, und überprüfen Sie erforderliche Schreibvorgänge, bevor Sie sich auf das Zurückschreiben verlassen. Wenn Sie Initialisierungsskripts benötigen, verwenden Sie Cluster-bezogene Skripts, die in Unity-Katalogvolumes gespeichert sind, auf unterstützter Berechnung, und folgen Sie den aktuellen Azure Databricks Anleitungen für das Init-Skript.
Szenariodetails
Verwenden Sie dieses Muster, wenn dasselbe Dataset Anwendungen bedienen muss, die ein bereitgestelltes Dateisystem und Analysen oder KI-Dienste erwarten, die eine S3-kompatible Objektschnittstelle erwarten.
Anwendungen, die auf virtuellen Computern oder in Containern ausgeführt werden, können weiterhin Azure NetApp Files über NFS oder SMB verwenden. Sie können z. B. vorhandenen Dateizugriffscode, bereitgestellte Freigaben und Verzeichnisstrukturen verwenden. Die Azure NetApp Files Objekt-REST-API ordnet das Stammverzeichnis eines Volumes oder ein Unterverzeichnis einem S3-kompatiblen Bucket zu, sodass kompatible Objektclients auf dieselben zugrunde liegenden Dateien zugreifen können.
Dieser Ansatz ist nützlich, wenn Sie vorhandenen dateibasierten Workloads Analyse- oder KI-Funktionen hinzufügen möchten, ohne die Quellanwendungen für die Verwendung des Objektspeichers zu ändern. Nachgeschaltete Workflows können weiterhin abgeleitete Daten wie transformierte Datasets, Indizes, Einbettungen und Caches nach Bedarf erstellen.
Wenn Datei- und Objektclients auf dieselben Daten zugreifen, berücksichtigen Sie Unterschiede in Identitäts-, Berechtigungs-, Sperr- und Anwendungskonsistenzanforderungen. Definieren Sie, wie Produzenten signalisieren, dass eine Datei oder ein Batch abgeschlossen ist, bevor Objektanwender sie verarbeiten. Produzenten sollten das Schreiben und Schließen von Dateien beenden, bevor sie die Bereitschaft signalisieren und diese Dateien unverändert lassen, während die Verbraucher sie verarbeiten. Testen Sie diese Übergabe auf unterbrochene Schreibvorgänge und verarbeiten Sie Wiederholungen.
Die Identitäts- und Autorisierungsmodelle unterscheiden sich auch über Zugriffsmethoden hinweg. Ursprüngliche Dateiberechtigungen pro Benutzer werden nicht automatisch in Fabric übertragen. Konfigurieren Sie Fabric Berechtigungen für die vorgesehenen Verbraucher, und stellen Sie sicher, dass die von der Objekt-REST-API verwendete Identität nur Zugriff auf die erforderlichen Quelldaten hat. Weitere Informationen finden Sie unter Sicherheit.
Zuordnen von Verzeichnissen zu separaten Buckets, wenn Verbraucher unterschiedliche Zugriffsebenen benötigen. Datenklassifizierung, Aufbewahrung, nachgeschaltete Autorisierung und Governance abgeleiteter Daten bleiben Arbeitsauslastungsaufgaben. Weitere Informationen finden Sie unter Erstellen eines Buckets.
Potenzielle Anwendungsfälle
Diese Architektur kann Workloads unterstützen, die strukturierte oder unstrukturierte Daten analysieren müssen, die bereits in Azure NetApp Files gespeichert sind. Die folgenden Beispiele veranschaulichen verschiedene Möglichkeiten, wie Fabric diese Daten nutzen können.
Dokumentenverarbeitung
Anwendungen können Dokumente, Bilder oder andere unstrukturierte Dateien mithilfe von NFS oder SMB auf Azure NetApp Files speichern. Ein Fabric-Notizbuch kann abgeschlossene Dateien mithilfe einer OneLake-Verknüpfung lesen und deren Inhalte an einen Dokumentverarbeitungsdienst senden, z. B. Azure Dokumentintelligenz, zur Extraktion. Speichern Sie die resultierenden strukturierten Daten in Lakehouse-Tabellen für Validierung, Analyse und Berichterstellung.
Anleitungen zur Integration finden Sie unter Document Intelligence-Integration über SynapseML.
Datenanalyse
Anwendungen können strukturierte Daten wie CSV- oder Parkettdateien in eine Azure NetApp Files Freigabe schreiben. Fabric Notizbücher können abgeschlossene Dateien mithilfe der OneLake-Verknüpfung lesen, mit anderen Lakehouse-Daten kombinieren und abgeleitete Ergebnisse in Lakehouse-Tabellen schreiben.
Dieses Muster kann Szenarien wie Engineering- und Qualitätsanalyse, Sensordatenanalyse und Betriebsberichte unterstützen, ohne dass die Quellanwendungen ihre Dateien speichern müssen.
Erstellen Sie für vorhandene kompatible Delta-Datasets eine OneLake-Verknüpfung im Abschnitt "Tables " des Lakehouses, die auf die vollständige Delta-Tabelle ausgerichtet ist, einschließlich des Transaktionsprotokolls. Fabric können das Ziel dann als Tabelle erkennen, und die Quelldaten können auf Azure NetApp Files verbleiben. Weitere Informationen finden Sie unter Wo sie Verknüpfungen in einem Seehaus platzieren können.
KI-Suche und -Abruf
Dokumente, die auf Azure NetApp Files gespeichert sind, können auch als Quellinhalt für KI-Workloads dienen. Beispielsweise kann ein Verarbeitungsworkflow Dokumente über die OneLake-Verknüpfung lesen und verwenden, um einen Azure KI-Suche Index für die Abruferweiterungsgenerierung (RAG) zu erstellen.
Der Suchindex und alle Einbettungen sind abgeleitete Daten und werden getrennt von den Quelldateien gespeichert. Entwerfen Sie den Workflow so, dass indizierte Inhalte mit Quellaktualisierungen, Umbenennungen und Löschungen synchronisiert werden. Erzwingen Sie auch die entsprechenden Zugriffssteuerungen beim Abrufen von indizierten Inhalten, da die ursprünglichen SMB- und NFS-Berechtigungen nicht automatisch benutzerspezifische Suchberechtigungen werden.
Dasselbe Muster kann auf andere KI-Workloads erweitert werden. Beispielsweise können Fabric Notizbücher Datasets aus Quelldateien vorbereiten und die vorbereiteten Daten in OneLake für den Verbrauch durch Azure Machine Learning speichern. Integrationsoptionen und Einschränkungen finden Sie unter Integrieren von OneLake in Azure Machine Learning.
Überlegungen
Diese Überlegungen bilden die Säulen des Azure Well-Architected Framework, einer Reihe von Leitprinzipien, die Sie zur Verbesserung der Qualität eines Workloads verwenden können. Weitere Informationen finden Sie unter Well-Architected Framework. Weitere Anleitungen finden Sie unter Well-Architected Framework-Empfehlungen für Azure NetApp Files.
Reliability
Zuverlässigkeit trägt dazu bei, dass Ihre Anwendung die Verpflichtungen erfüllen kann, die Sie für Ihre Kunden vornehmen. Weitere Informationen finden Sie unter Prüfliste zur Entwurfsüberprüfung für Zuverlässigkeit.
Azure NetApp Files läuft auf einer fehlertoleranten Bare-Metal-Flotte mit ONTAP und bietet eine SLA mit hoher Verfügbarkeit. Für zusätzlichen Schutz vor Verfügbarkeitszonen oder regionalen Ausfällen können Sie optional die zonenübergreifende oder regionsübergreifende Replikation konfigurieren. Diese Replikation ist asynchron und erfordert ein vom Kunden initiiertes Failover auf das Zielvolume. Wählen Sie die Replikationsoption und den Zeitplan gemäß den Wiederherstellungszielen Ihrer Workload aus. Weitere Informationen finden Sie unter Azure NetApp Files Zuverlässigkeit.
Durch das Freigeben eines Datasets wird auch die Speicherverfügbarkeit zu einer gemeinsamen Abhängigkeit für Dateianwendungen und Analysen. Diese Speicherfunktionen stellen keine End-to-End-Verfügbarkeit für das Gateway, die Indizierungspipeline oder die Nutzung von Anwendungen her. Richten Sie Wiederherstellungsziele an der gesamten Workload aus, einschließlich gateways, nachgelagerter Verarbeitung und abgeleiteter Daten.
Ein einzelner virtueller Gatewaycomputer ist ein einzelner Fehlerpunkt für den Fabric Integrationspfad. Stellen Sie für unternehmenskritische Workloads mindestens zwei Gatewaymitglieder auf separaten virtuellen Computern in einem Gatewaycluster bereit. Stellen Sie sicher, dass jedes Mitglied den Objekt-REST-API-Endpunkt erreichen und die erforderlichen ausgehenden Verbindungen herstellen kann. Testen Sie das Verhalten der Workload, wenn ein Gatewaymitglied nicht verfügbar ist.
- Datei- und Volumewiederherstellung wird durch raumeffiziente Momentaufnahmen unterstützt. Teams können eine einzelne Datei wiederherstellen, ein vollständiges Volume wiederherstellen oder ein neues Volume aus einem Wiederherstellungspunkt nach versehentlichem Löschen, Beschädigung oder einem fehlgeschlagenen Analyseprozess erstellen. Informationen zu den verfügbaren Wiederherstellungsvorgängen finden Sie unter Azure NetApp Files snapshotbasierten Datenschutz.
Security
Sicherheit bietet Sicherheitsmaßnahmen gegen bewusste Angriffe und den Missbrauch Ihrer wertvollen Daten und Systeme. Weitere Informationen finden Sie unter Checkliste für die Entwurfsüberprüfung im Bereich Sicherheit.
Die Verwaltung weniger Quelldatenkopien kann die Anzahl der zu schützenden Repositorys reduzieren. Azure NetApp Files verschlüsselt ruhende Daten, und die Objekt-REST-API verwendet TLS zum Schutz von Daten während der Übertragung. Dateizugriffsberechtigungen hängen vom Protokoll ab:
SMB- und NFS-Clients verwenden weiterhin ihre vorhandenen Authentifizierungs- und Autorisierungsmodelle. Vorhandene NTFS-Zugriffssteuerungslisten (ACCESS Control Lists, ACLs), NFS-Berechtigungen und Identitätszuordnungsregeln bleiben für diese Clients wirksam.
Objekt-REST-API-Clients authentifizieren sich mithilfe eines S3-Zugriffsschlüssels. Bucketberechtigungen definieren, ob der Client schreibgeschützten oder schreibgeschützten Zugriff innerhalb des zugeordneten Verzeichnisses hat. Objektanforderungen enthalten nicht die Identität der einzelnen SMB-, NFS- oder downstream-Benutzer. Azure NetApp Files führt jeden Objektvorgang als konfigurierte imitierte Dateisystemidentität des Buckets aus. Vorhandene Dateiberechtigungen und ACLs werden nur anhand dieser Identität ausgewertet.
Die Identität des imitierten Dateisystems ist eine Benutzer-ID (UID) und eine Gruppen-ID (GID) für NFS-Volumes oder ein Benutzerkonto für SMB-Volumes. Dual-Protocol-Volumes verwenden den Identitätstyp, der ihrem konfigurierten Sicherheitsstil entspricht. Diese Identität bestimmt Dateizugriffsberechtigungen. Der S3-Zugriffsschlüssel authentifiziert den Objektclient. Weitere Informationen finden Sie unter Objekt-REST-API-Sicherheit und -Berechtigungen.
Eine mit OneLake S3 kompatible Verknüpfung authentifiziert sich beim Bucket mithilfe einer Zugriffstasten-ID und geheimer Zugriffstaste. Die NTFS-Quell-ACLs, NFS-Berechtigungen und einzelne Identitäten des Dateibesitzers werden nicht in OneLake kopiert oder zugeordnet. Fabric Benutzer über OneLake und Fabric Berechtigungen autorisiert sind. Sie können nur auf die Inhalte zugreifen, die über den Bucket und deren identitätswechselte Identität verfügbar gemacht werden, aber OneLake erzwingt nicht die ursprünglichen Berechtigungen pro Benutzerdatei. Microsoft Entra basierte OAuth, Dienstprinzipale und RoleArn werden für diesen Verknüpfungstyp nicht unterstützt.
Ein Fabric Benutzer kann z. B. mithilfe der Verknüpfung ein Dokument lesen, auch wenn sein persönliches SMB-Konto es nicht direkt lesen kann, wenn Fabric Berechtigungen den Zugriff zulassen und die identitätswechselte Identität des Buckets das Dokument lesen kann. Stellen Sie vor dem Verfügbarmachen eines Verzeichnisses sicher, dass die beabsichtigte Fabric Zielgruppe berechtigt ist, auf ihre Inhalte zuzugreifen.
Konfigurieren Sie die identitätswechselte Identität des Buckets nur mit den Von der Workload benötigten Quellberechtigungen. Beschränken Sie den Zugriff auf die Verknüpfung und das Seehaus. Verwenden Sie den Azure Key Vault-basierten Zertifikatworkflow und die Speicherung von Anmeldeinformationen, um TLS-Zertifikate und S3-Zugriffstasten zu verwalten. Definieren und testen Sie eine Drehungsprozedur, die Zertifikat- und Anmeldeinformationenänderungen mit Aktualisierungen für Fabric Verbindungen und andere Consumer koordiniert. Durch das Generieren neuer Bucketanmeldeinformationen wird das vorhandene Paar sofort ungültig. Planen Sie daher unterbrechungsfrei, während Sie Consumer aktualisieren und den Zugriff nach der Drehung überprüfen.
Wenn Sie ein selbstsigniertes TLS-Zertifikat verwenden, stellen Sie sicher, dass jeder Gatewayhost dem Zertifikat vertraut. Weitere Informationen finden Sie unter OneLake-Gatewayvoraussetzungen.
Sicherheit und Compliance hängen von der Konfiguration von Speicher-, Zugriffs- und Downstreamdiensten ab. Fügen Sie nachgelagerte Verarbeitung und abgeleitete Daten in Ihren Governance- und Compliancebereich ein. Anforderungen wie DSGVO und HIPAA gelten gegebenenfalls für die gesamte Workload. Weitere Informationen finden Sie unter Object REST API Security and permissions and Create an Amazon S3-kompatible Verknüpfung in OneLake.
Kostenoptimierung
Die Kostenoptimierung konzentriert sich auf Möglichkeiten, unnötige Ausgaben zu reduzieren und die betriebliche Effizienz zu verbessern. Weitere Informationen finden Sie unter Design Review-Checkliste für die Kostenoptimierung.
Das Vermeiden einer separaten Quelldatenkopie kann doppelte Speicher- und Synchronisierungskosten reduzieren. Ausgleich dieser Einsparungen gegenüber Azure NetApp Files Kapazitäts- und Leistungskosten, Gateway-Compute, Fabric Kapazität und nachgelagerter Verarbeitung und Speicher.
Diese Preisschätzung umfasst einen 1-TiB-Azure NetApp Files Standardkapazitätspool, einen Windows D8s_v5 virtuellen Computer für das lokale Datengateway, zwei 128-GiB P10-verwaltete Datenträger, ein NAT-Gateway mit einer öffentlichen IP-Adresse und ausgehende Datenverarbeitung, Fabric F2-Kapazität und 100 GB nativen OneLake-Speicher.
Die Konfiguration mit einem Gateway ist nicht hoch verfügbar. Optionale KI-Suche, Einbettungsdienste und Azure Databricks Kosten sind ausgeschlossen. Passen Sie die Ressourcen für die Kapazitäts-, Netzwerk- und Verfügbarkeitsanforderungen Ihrer Workload an.
Cooler Zugriff: Ebenen inaktiver Datenblöcke, einschließlich Momentaufnahmendaten, bis hin zu geringerer Speicherkosten, während Datei- und Objektzugriff beibehalten werden. Bewerten von Abrufgebühren, Latenz und Änderungen des dienstspezifischen Durchsatzes anhand des Zugriffsmusters der Workload.
Service levels and right-sizing: Wählen Sie eine Azure NetApp Files Serviceebene aus, die den Anforderungen für Kapazität und Durchsatz des Datasets entspricht. Mit der flexiblen Serviceebene können Sie die Poolkapazität und den Durchsatz unabhängig bereitstellen. Überprüfen Sie die Kapazität und den Durchsatz des abrechnenden Pools, da Sich die Anforderungen ändern, um dauerhafte Überbereitstellungen zu vermeiden.
Betriebliche Effizienz
Operational Excellence deckt die Betriebsprozesse ab, mit denen eine Anwendung bereitgestellt und in der Produktion ausgeführt wird. Weitere Informationen finden Sie in der Prüfliste für das Design Review von Operational Excellence.
OneLake-Tastenkombinationen reduzieren die Betriebskomplexität, indem eine Pipeline vermieden wird, die eine separate Quelldatenkopie für Analysen verwaltet. Ohne eine separate Kopierpipeline müssen Teams keine Kopieraufträge planen, aus Übertragungsfehlern wiederherstellen oder Quell- und kopierte Daten als Teil von Routinevorgängen abgleichen.
Quellanwendungs- und Analyseteams müssen Änderungen und Die Reaktion auf Vorfälle für das freigegebene Azure NetApp Files-Dataset koordinieren. Richten Sie den Besitz für Überwachung, Verarbeitungsfehler und Objekt-REST-API-Anmeldeinformationen und Zertifikatverwaltung ein.
Überwachen Sie Speicher, Gateway und Fabric Leistung, um Einschränkungen zu identifizieren und Kapazität oder Durchsatz anzupassen:
Verwenden Sie Azure Monitor, um den Volumenlese- und Schreibdurchsatz, Lese- und Schreibvorgänge, andere IOPS, durchschnittliche Lese- und Schreiblatenz, Kapazitätsverbrauch und den Indikator für den Durchsatzgrenzwert nachzuverfolgen. Warnung bei anhaltenden Latenzerhöhungen, wiederholten QoS-Begrenzungen und Kapazitätsschwellenwerten statt isolierter Spitzen; Azure NetApp Files Metriken werden über Intervalle aggregiert, und die Speicherlatenz enthält nicht jede clientseitige REST-Komponente.
Korrelieren Sie Speichermetriken mit clientseitigen Messungen wie Anforderungslatenz-Quantils, Objektgröße, Parallelität, Wiederholungen, HTTP-Statuscodes, CPU, Arbeitsspeicher und Netzwerkdurchsatz. Dadurch wird ein Volumendurchsatzlimit von einem untergeordneten Computeclient, ineffizienten SDK-Einstellungen, wenig Objektaufwand oder Netzwerkabstand unterschieden.
Überwachen Sie die CPU, den Arbeitsspeicher, den verfügbaren Speicherplatz und den Netzwerkdurchsatz der einzelnen Gatewaycomputer zusammen mit Gatewayfehlern und Arbeitsauslastungsabschlusszeiten. Konfigurieren Sie Warnungen für nachhaltigen Ressourcendruck und geringen Speicherplatz, wobei Schwellenwerte verwendet werden, die bei repräsentativen Workloadtests festgelegt wurden. Verwenden Sie Gatewaydiagnoseprotokolle , wenn Sie Fehler beheben oder langsamen Zugriff ausführen. Überwachen Sie den virtuellen Computer und das Netzwerk separat, da die Gatewaydiagnose keine vollständige Infrastrukturabdeckung bietet.
Überwachen Sie Fabric Kapazitätsauslastung und Drosselung mit der Fabric Kapazitätsmetriken-App. Konfigurieren Sie Kapazitätsauslastungsbenachrichtigungen für die zuständigen Administratoren. Korrelieren Sie die Kapazitätsauslastung mit Gateway- und Speichermessungen, um zu ermitteln, ob Verzögerungen beim Quellzugriff oder Fabric Verarbeitung auftreten, bevor Sie die Kapazität ändern.
Leistungseffizienz
Leistungseffizienz bezieht sich auf die Fähigkeit Ihrer Arbeitslast, effizient auf die Anforderungen der Benutzer zu skalieren. Weitere Informationen finden Sie in der Checkliste zur Entwurfsüberprüfung für die Leistungseffizienz.
Azure NetApp Files können sowohl Latenz-sensible NFS- oder SMB-Anwendungen als auch S3-kompatible Analysen oder KI-Verbraucher mit demselben Dataset unterstützen. Das Beibehalten der Quelldaten auf einem Volume kann die Kopierstufe entfernen, die andernfalls die Indizierung, Schulung oder Batchverarbeitung verzögern und Client-, Netzwerk- und Zielspeicherbandbreite nutzen würde.
Die Latenz von Unter millisekundenspeichern auf unterstützten Azure NetApp Files Servicelevels ist für NFS- und SMB-Workloads am direktsten relevant. Es garantiert keine End-to-End-Latenz für HTTPS-OBJEKT-REST-API-Anforderungen. Vergleichen Sie den S3-kompatiblen Zugriffspfad mit repräsentativen Objekten und Parallelität, bevor Sie ein Latenzziel festlegen.
Speichergröße: Größendurchsatz für die kombinierte Anforderung von Dateianwendungen und Objekt-Consumern. Der automatische QoS-Durchsatz wird mit dem Volumekontingent verknüpft. Manuelle qoS ermöglicht eine separate Zuordnung innerhalb des Durchsatzbudgets des Pools.. Messen Sie repräsentative Workloads, bevor Sie die Leistung anpassen.
Gatewaygröße: Größe der virtuellen Gatewaycomputer für die kombinierte Anforderung von Workloads, die über OneLake-Verknüpfungen auf Azure NetApp Files zugreifen. Verwenden Sie die Richtlinien für die Größe und Skalierung von Gateways als Ausgangspunkt. Überprüfen Sie die Größenanpassung mit repräsentativen Datenvolumes und gleichzeitigen Zugriff über die Tastenkombinationen. Messen Sie die CPU, den Arbeitsspeicher und den Netzwerkdurchsatz des Gateways zusammen mit den Abschlusszeiten der Workload, um zu ermitteln, ob Ressourcen des virtuellen Computers erhöht oder Gatewaymitglieder hinzugefügt werden sollen.
Fabric Kapazitätsanpassung: Größe Fabric Kapazität für die kombinierte Verarbeitungs- und Berichtsarbeitsauslastung, einschließlich Power BI. Befolgen Sie die Anweisungen im Fabric Kapazitätsplanungsleitfaden, um die Anfangskapazität zu schätzen, mit einem repräsentativen Pilotprojekt zu testen und die Kapazität basierend auf gemessener Auslastung und Drosselung anzupassen.
Platzieren Sie die Berechnung in der Nähe des Volumes, der Größe des Clientnetzwerks, und testen Sie es mit der tatsächlichen Workload. Erhöhen Sie Parallelität, und verwenden Sie entsprechend große Anforderungen für sequenzielle Analysen, aber kapitälische Parallelität, wenn Latenz oder Fehler steigen. Überprüfen Sie für NFS oder SMB die Bereitstellungs-, Protokoll- und Anwendungseinstellungen. Überprüfen Sie bei REST die Unterstützung für die erforderlichen API-Vorgänge des Clients, und testen Sie die Wiederverwendung von Verbindungen, das Uploadverhalten, wiederholungsversuche und die Objektauflistung.
Überprüfen Sie den End-to-End-Durchsatz und die Latenz unter gleichzeitiger Auslastung, und ausgleichen Sie die Analysenachfrage mit anforderungen an die Leistung der Quellanwendung.
Contributors
Dieser Artikel wird von Microsoft gepflegt. Die folgenden Mitwirkenden haben diesen Artikel geschrieben.
Hauptautoren:
- Dan Jackson | Cloud Solutions Architect, NetApp
- Anthony Mashford | Cloud Solutions Architect, NetApp
- Daniel Söderholm | Senior Solution Engineer, Cloud + AI-Plattformen, Microsoft
Andere Mitwirkende:
- Heather Grandy | Senior Solution Engineer, Data Platforms, Microsoft
Um nicht öffentliche LinkedIn-Profile zu sehen, melden Sie sich bei LinkedIn an.
Nächste Schritte
- Einführung in die Objekt-REST-API für Azure NetApp Files
- Verbinden von OneLake mit einem Azure NetApp Files Volume
- Init-Skripts in Azure Databricks
- Integrieren von OneLake in Azure Machine Learning