Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Gilt für: Azure SQL-Datenbank
Serverless ist eine Berechnungsebene für einzelne Datenbanken in Azure SQL-Datenbank, die die Berechnungsressourcen automatisch basierend auf der Arbeitslastnachfrage skaliert und nach der Menge der pro Sekunde genutzten Berechnung abrechnet. Wenn nur der verwendete Speicher in Rechnung gestellt wird, hält die serverlose Computeebene außerdem Datenbanken während inaktiver Zeiträume automatisch an und startet diese wieder, wenn es wieder zu Aktivität kommt. Die serverlose Computingebene ist in der Dienstebene Universell und in der Hyperscale-Dienstebene verfügbar.
Übersicht
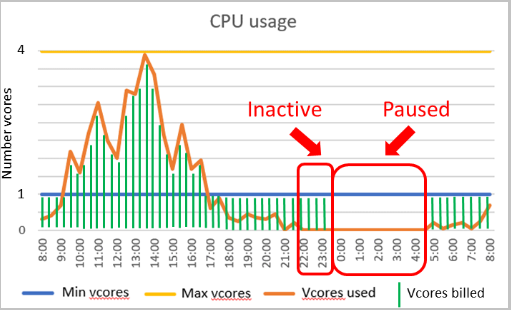
Ein Autoskalierungsbereich und eine Verzögerungszeit für das automatische Anhalten sind wichtige Parameter für die serverlose Rechenschicht. Die Konfiguration dieser Parameter beeinflusst die Leistung und die Computekosten der Datenbank.
Leistungskonfiguration
- Die Mindestanzahl virtueller Kerne und die maximale Anzahl virtueller Kerne sind konfigurierbare Parameter, die den Bereich der Computekapazität definieren, die für die Datenbank verfügbar ist. Arbeitsspeicher- und IO-Limits sind proportional zum angegebenen vCore-Bereich.
- Die automatische Pauseverzögerung ist ein konfigurierbarer Parameter, der die Zeitspanne definiert, in der die Datenbank inaktiv sein muss, bevor sie automatisch pausiert wird. Die Datenbank wird automatisch fortgesetzt, wenn die nächste Anmeldung oder andere Aktivität eintritt. Alternativ kannst du das automatische Pausieren deaktivieren. Weitere Informationen finden Sie unter Automatisches Anhalten und Fortsetzen im Tarif für serverloses Computing für Azure SQL-Datenbank.
Standardeinstellungen
In der folgenden Tabelle werden die verfügbaren Werte für diese Parameter aufgeführt.
| Parameter | Wertoptionen | Standardwert |
|---|---|---|
| Mindestanzahl virtueller Kerne | Hängt von den konfigurierten maximalen virtuellen Kernen ab – siehe Ressourceneinschränkungen. | 0,5 vCores |
| Verzögerung für automatisches Anhalten für allgemeine Zwecke | Minimum: 15 Minuten Maximal: 10.080 Minuten (sieben Tage) Inkremente: 1 Minute Automatisches Anhalten deaktivieren: -1 |
60 Minuten |
| Verzögerung der automatischen Pause für Hyperscale | Mindest: 60 Minuten Maximal: 10.080 Minuten (sieben Tage) Inkremente: 1 Minute Automatisches Anhalten deaktivieren: -1 |
60 Minuten |
Kosten
Die Kosten für eine serverlose Datenbank sind die Summe aus den Rechen- und Speicherkosten. Die Speicherkosten werden auf die gleiche Weise berechnet wie in der bereitgestellten Computeebene.
- Wenn der Rechenaufwand zwischen den von dir konfigurierten Mindest- und Maximalgrenzen liegt, basieren die Rechenkosten auf vCore und dem verwendeten Speicher.
- Wenn der Rechenaufwand unter den von dir konfigurierten Mindestlimits liegt, basieren die Rechenkosten auf den minimalen vCores und dem minimalen Speicher.
- Wenn die Datenbank angehalten wird, fallen keine Computekosten an, und es wird nur der verwendete Speicher berechnet.
Weitere Kostendetails finden Sie unter Abrechnung und Kostenszenarien für den Tarif für serverloses Computing.
Szenarien
Serverlos ist preis-/leistungsoptimiert für Einzeldatenbanken mit zeitweiligen, unvorhersehbaren Nutzungsmustern, bei denen eine gewisse Verzögerung in der Compute-Aufwärmphase nach Leerlaufzeiträumen ohne Nutzung akzeptabel ist. Im Gegensatz dazu ist die bereitgestellte Computeebene hinsichtlich Preis und Leistung für einzelne Datenbanken oder mehrere Datenbanken in elastischen Pools mit höherer durchschnittlicher Auslastung optimiert, bei denen es zu keiner Verzögerung beim Aufwärmen der Rechenkapazität kommen darf.
Ideal geeignete Szenarien für serverloses Computing
- Verwenden Sie serverlose Rechenleistung für einzelne Datenbanken mit intermittierenden, unvorhersehbaren Nutzungsmustern, die von Phasen der Inaktivität und einer niedrigeren durchschnittlichen Rechenauslastung über die Zeit abgewechselt werden.
- Verwenden Sie serverlose Rechenleistung für einzelne Datenbanken im bereitgestellten Compute-Tier, die häufig neu skaliert werden, oder wenn Sie das Reskalieren an den Service delegieren möchten.
- Verwenden Sie serverlose Rechenleistungen für neue Einzeldatenbanken ohne Nutzungshistorie, wenn die Rechengröße vor der Bereitstellung in der Azure SQL-Datenbank schwierig oder unmöglich zu schätzen ist.
Ideal geeignete Szenarien für bereitgestelltes Computing
- Verwenden Sie provisioned Compute für einzelne Datenbanken mit regelmäßigeren, vorhersehbaren Nutzungsmustern und einer höheren durchschnittlichen Rechenauslastung über die Zeit.
- Verwenden Sie bereitgestellte Computeleistung für Datenbanken, die keine Leistungseinbußen durch häufigeres Freigeben von Arbeitsspeicher oder Verzögerungen beim Fortsetzen aus einem pausierten Zustand tolerieren.
- Verwenden Sie provisioned Compute für mehrere Datenbanken mit intermittierenden, unvorhersehbaren Nutzungsmustern, die in elastische Pools für eine bessere Preis-Leistungs-Optimierung konsolidiert werden können.
Vergleich von Berechnungsebenen
Die folgende Tabelle enthält eine Zusammenfassung der Unterschiede zwischen der serverlosen Computeebene und der bereitgestellten Computeebene:
| Serverloses Computing | Bereitgestellte Rechenressourcen | |
|---|---|---|
| Datenbanknutzungsmuster | Wechselnde, unvorhersehbare Nutzung mit niedrigerer durchschnittlicher Computenutzung im Zeitverlauf. | Regelmäßigere Nutzungsmuster mit höherer durchschnittlicher Computenutzung im Zeitverlauf oder mehrere Datenbanken, die elastische Pools verwenden. |
| Aufwand bei der Leistungsverwaltung | Niedriger | Höher |
| Compute-Skalierung | Automatisch | Manuell |
| Anfängliche Rechenreaktionsfähigkeit | Geringer nach Inaktivitätszeiträumen | Unmittelbar |
| Granularität bei der Abrechnung | Pro Sekunde | Pro Stunde |
- Das beste Datenbanknutzungsmuster für serverlose Rechenleistungen ist intermittierend und unvorhersehbar, mit einer niedrigeren durchschnittlichen Rechenauslastung über die Zeit. Das beste Nutzungsmuster für bereitgestellte Rechenleistungen ist regelmäßiger mit einer höheren durchschnittlichen Rechenauslastung über die Zeit oder umfasst mehrere Datenbanken in elastischen Pools.
- Serverlose Rechenleistung erfordert einen geringeren Leistungsmanagement-Aufwand. Provisioned Compute erfordert höhere Leistungsmanagement-Anstrengungen.
- Serverlose Rechenleistung skaliert automatisch. Bereitgestelltes Compute wird manuell skaliert.
- Serverlose Rechenleistung weist nach inaktiven Phasen eine geringere anfängliche Reaktionsfähigkeit auf. Provisioned Compute reagiert sofort.
- Serverlose Rechenleistung wird pro Sekunde abgerechnet. Provisierte Rechenleistungen werden pro Stunde abgerechnet.
Kaufmodell und Dienstebene
In der folgenden Tabelle wird die serverlose Unterstützung basierend auf dem Kaufmodell, den Dienstebenen und der Hardware beschrieben:
| Kategorie | Unterstützt | Nicht unterstützt |
|---|---|---|
| Kaufmodell | vCore | DTU |
| Dienstebene |
Allgemeiner Zweck Hyperscale |
Geschäftskritisch |
| Hardware | Standard-Serie (Gen5) | Gesamte andere Hardware |
Automatisch skalierende serverlose Datenbanken
Weitere Informationen zur automatischen Skalierung und zur Reaktionsfähigkeit der serverlosen Compute-Schicht finden Sie unter Serverless Compute Tier Auto-Scaling für Azure SQL-Datenbank.
AutoAnhalten und automatisches Fortsetzen
- Serverlose automatische Pause und Auto-Fortsetzung sind in der General Purpose Service-Stufe verfügbar.
- Die serverlose automatische Pausierung und automatische Fortsetzung sind eine Vorschaufunktion von Azure SQL-Datenbank Hyperscale.
Für detaillierte Informationen zum Verhalten von Auto-Pause und Auto-Resume, Auslösern, Fehlerbehebung und Konnektivität siehe Auto-Pause und Auto-Resume in der serverlosen Compute-Ebene.
Erstellen einer neuen serverlosen Datenbank
Für Schritt-für-Schritt-Anweisungen zum Erstellen, Verschieben und Konfigurieren serverloser Datenbanken mit dem Azure-Portal, PowerShell, Azure CLI und T-SQL siehe Erstellen und konfigurieren Sie eine serverlose Datenbank.
Best Practices für den Tarif für serverloses Computing
Beachten Sie die folgenden Best Practices bei der Verwendung serverloser Datenbanken.
Implementierung von Anwendungs-Wiederholungslogik
Alle cloudverbundenen Anwendungen sollten Empfehlungen zur Verbindungs-Wiederversuchslogik verwenden. Vorübergehende Konnektivitätsfehler müssen in allen Cloud-Anwendungen mit Retry-Logik behandelt werden. Die Wiederholungslogik für serverlose Datenbanken ist besonders wichtig, da temporäre Konnektivitätsfehler durch Auto-Resume vorhersehbar sind.
Weitere Informationen finden Sie unter Fehlerbehebung bei Problemen mit der automatischen Wiederherstellung der Verbindung.
Überprüfen Sie die Interoperabilität, die automatische Pausen verhindert
Einige Funktionen und Einstellungen können verhindern, dass eine serverlose Datenbank automatisch pausiert. Du kannst die automatische Pause in der Datenbank deaktivieren, wenn diese Funktionen genutzt werden.
Weitere Informationen finden Sie unter Fehlerbehebung der automatischen Pause.
Bildschirm
Weitere Informationen zur Überwachung von Pausen- und Fortsetzungsereignissen Ihrer serverlosen Datenbank finden Sie unter Monitor the serverless compute tier for Azure SQL-Datenbank.
Ressourceneinschränkungen
Für Ressourcenbegrenzungen siehe General Purpose serverless compute und Hyperscale serverless compute.
Abrechnung
Für detaillierte Abrechnungsinformationen, einschließlich Rechenkostenberechnungen, Mindestrechenkostenabrechnung und Szenarienbeispielen für sowohl General Purpose als auch Hyperscale finden Sie unter Abrechnung für serverloses Computing.
Verfügbare Regionen
Informationen zur regionalen Verfügbarkeit finden Sie unter Serverlose Verfügbarkeit nach Region für Azure SQL-Datenbank.