Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Azure Data Explorer (ADX) ist eine vollständig verwaltete Analyseplattform zur Echtzeitanalyse großer Telemetrie- und Protokolldaten. In diesem Artikel wird erläutert, wie die Kosten pro GB im Azure-Daten-Explorer berechnet werden, welche Faktoren sie fördern und wie Sie Ihren Cluster auf Kosteneffizienz optimieren können. Big Data Analytics-Plattformen verwenden unterschiedliche Preismodelle. Viele Plattformen basieren auf den Preisen für Faktoren wie Abfragevolumen, Datenaufnahme, Speicherdauer und Computeressourcen. Diese Komplexität macht es schwierig, Preise für produkteübergreifend zu vergleichen.
Um die Kosten für die Nutzung von Azure Data Explorer zu verstehen, nutzt dieser Artikel die Metrik Kosten pro aufgenommenem GB. Diese Metrik ist die Gesamtclusterkosten (Compute, Speicher, Netzwerk und Dienstmarkup), dividiert durch die gesamten ursprünglichen Daten, die während dieses Zeitraums aufgenommen wurden .
Mit einer repräsentativen Momentaufnahme von ADX-Clustern im Juni 2025 wird die Beispielanalyse untermauert. In den folgenden Abschnitten werden die wichtigsten Ergebnisse der Analyse dargestellt, erläutert, was die Kostenvariationen antreibt und wie Benutzer die Kosten pro GB optimieren können, ohne die Leistung zu beeinträchtigen.
Hinweis
- Alle Kostenzahlen in diesem Artikel zeigen Listenpreise und enthalten keine Rabatte oder verpflichtungsbasierte Einsparungen.
- Für diese Beispielanalyse wird die Kosten pro GB in Sample Cost Units (SCUs) ausgedrückt, wobei jede SCU eine generische Kosteneinheit darstellt, z. B. einen US-Cent.
- Informationen zu Listenpreisen und deren Berechnung finden Sie unter Azure Data Explorer-Preisrechner.
Kostenanalyse pro eingespeistem GB
Das folgende Diagramm zeigt medianes täglich erfasstes GB in Originalgröße (Y-Achse) vs. Mediane Kosten pro erfasstes GB (X-Achse) für jede Kostengruppe. Blasengröße stellt den Anteil der Gesamtdaten der Gruppe dar, die in den Dienst eingespeist wurden.
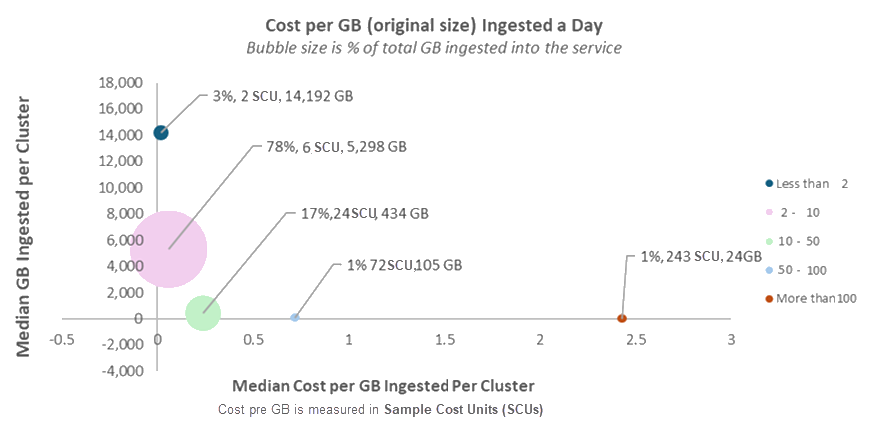
Die Kosten pro GB variieren je nach Cluster, aber einige Muster stechen hervor.
Die meisten Daten (>75%) werden zu Kosten zwischen 2 und 10 SCUs pro GB (vor Rabatten) aufgenommen.
Weniger als 5% der Daten wird erfasst bei weniger als 2 SCUs pro GB.
Auch innerhalb derselben Verwendungskategorie (oder "Blase") wird eine signifikante Variation angezeigt. In der größten Blase erfasst ein Cluster zum Beispiel bei 2 SCUs pro GB, während ein anderes erreicht 10 SCUs pro GB. Das ist ein 5X-Unterschied. In den nächsten Abschnitten werden die wichtigsten Gründe für diese Variation erläutert.
Cluster mit höheren Kosten pro GB sind weniger verbreitet und weisen in der Regel niedrigere Aufnahmevolumen auf. Im Allgemeinen bedeuten kleinere Datenvolumen höhere Kosten pro GB.
Von Bedeutung
Das Blasendiagramm zeigt, dass die Kosten pro erfasstes GB zwischen den Clustern variieren. Diese Variation weist nicht auf gute oder schlechte Methoden hin. Es spiegelt verschiedene Szenarien, Konfigurationen und Verwendungsmuster für den Dienst wider.
Beispielsweise kann ein Cluster Daten länger für die Compliance aufbewahren, wodurch die Speicherkosten erhöht werden. Eine andere Methode könnte Update-Richtlinien verwenden, die Daten während der Aufnahme verarbeiten, wodurch die Rechnerauslastung erhöht wird. Bei diesen Szenarien handelt es sich um beabsichtigte Entwurfsentscheidungen, die an bestimmten Zielen ausgerichtet sind, und sie wirken sich natürlich auf die Kosten pro GB aus.
Was treibt die Kosten pro erfasstes GB an?
Diese Schlüsselfaktoren liegen hinter den Abweichungen der Kosten pro GB, die pro Cluster aufgenommen werden:
Speicherdauer: Je länger Sie Daten speichern, desto höher sind die Kosten. Siehe Aufbewahrungsrichtlinie.
Hohe CPU-Auslastung: Aktionen wie schwere Abfragen, Datenverarbeitung oder Transformationen verursachen eine hohe CPU-Auslastung.
Cacheeinstellungen: Das Zwischenspeichern weiterer Daten erhöht die Leistung, kann aber die Kosten erhöhen. Siehe Cacherichtlinie.
Kalte Datennutzung: Abfragen, die auf kalte Daten zugreifen, lösen Lesevorgänge aus und fügen Kosten hinzu. Sehen Sie sich den heißen und kalten Cache an.
Datentransformation und Optimierung: Features wie Updaterichtlinien, materialisierte Ansichten und Partitionierung verbrauchen CPU-Ressourcen und können Kosten erhöhen. Siehe Aktualisieren von Richtlinien, materialisierten Ansichten und Partitionen.
Aufnahmevolumen: Cluster arbeiten kostengünstiger bei höheren Aufnahmevolumen.
Streaming vs. Warteschlangenbasierte Eingabe: Je nach Anwendungsfall weist jede Methode ein unterschiedliches Kostenprofil auf. Siehe Streaming und Warteschlangen.
Schemaentwurf: Breite Tabellen mit vielen Spalten benötigen mehr Rechen- und Speicherressourcen, wodurch Kosten entstehen.
Erweiterte Features: Optionen wie Follower, private Endpunkte und Python-Sandboxes verbrauchen weitere Ressourcen und können kostenaufwendiger werden.
Auswahl der Datenpipeline: Einige Aufnahmepfade kosten weniger. Beispielsweise ist die Ereignisaufnahme mit Event Grid in der Regel günstiger als Event Hubs.
Autoskalierung: Cluster, die keine automatische Skalierung verwenden, kosten häufig mehr, da sie ihre Größe nicht auf der Grundlage der Nachfrage anpassen.
Sie können die meisten dieser Faktoren so konfigurieren, dass sowohl die Leistung als auch die Kosten optimiert werden.
Ein genauerer Blick auf wichtige Kostentreiber
In diesem Abschnitt werden die wichtigsten Faktoren erläutert, die die kosten pro GB beeinflussen, die im Azure-Daten-Explorer aufgenommen wurden, und bietet Einblicke in die Verwaltung und Optimierung dieser Kosten.
Auswirkungen der Datenaufbewahrung auf die Kosten
In ADX werden alle erfassten Daten im beständigen Speicher gespeichert. Jede Tabellen- und materialisierte Ansicht verfügt über eine Aufbewahrungsrichtlinie , die definiert, wie lange die Daten aufbewahrt werden. Je länger die Daten aufbewahrt werden, desto höher ist die Kosten, basierend auf den Azure Storage-Preisen. Wenn Sie einen langfristigen Speicher benötigen, z. B. für die Einhaltung, erhöhen sich die Kosten pro GB, da sie laufende Speicherkosten umfasst.
Zusätzlich zur vom Cluster gemeldeten Umfangsgröße gibt es zwei zusätzliche Kostentreiber:
- Aufbewahrungspuffer: Standardmäßig werden zusätzliche 7 Tage Daten gespeichert, um vor versehentlichem Datenverlust zu schützen.
- Wiederherstellbarkeitsaufwand: Für Tabellen, in denen die Einstellung für die Wiederherstellbarkeit aktiviert ist (Standardeinstellung), werden Daten für weitere 14 Tage aufbewahrt. Dazu gehören zwischengeschaltete Blobs, die während der Zusammenführungs- und Neuerstellungsvorgänge generiert werden.
Clustergröße
Die Clustergröße ist die Anzahl der Computer (Knoten) im Cluster. Jede Maschine verursacht Kosten, abhängig vom Typ (SKU). Die Automatische Skalierung passt die Clustergröße basierend auf der CPU-Auslastung an, sodass das System Kosten und Leistung optimieren kann, indem leerlauffähige oder redundante Ressourcen vermieden werden.
Die Automatische Skalierung passt die Clustergröße an, um sicherzustellen, dass zwischengespeicherte Daten in den verfügbaren SSD-Speicherplatz passen. Daher kann ein großer Cache die Clustergröße erhöhen und wenn die CPU-Auslastung niedrig ist, kann dies zu höheren Kosten pro GB führen. Weitere Informationen zum Optimieren der Cachegröße finden Sie auf der Registerkarte Cluster Insight.See the Cache tabClusters Insight tool for more information on optimizing the cache size.
Cluster, die viele Abfragen ausführen oder CPU-schwere Aufgaben wie Materialisierte Ansichten, Updaterichtlinien oder Partitionierung ausführen, können den Cluster skalieren und die Kosten pro GB erhöhen. Beachten Sie, dass diese Features die Abfrageleistung erheblich erhöhen und die CPU-Auslastung der Abfrage reduzieren und so die Gesamteffizienz verbessern können.
Datenvolumen, das aufgenommen wurde
Wenn ein Cluster wächst, werden mehr Knoten hinzugefügt, wodurch die Gesamtkosten erhöht werden. Diese Kosten werden über alle aufgenommenen Daten verteilt, sodass je mehr Daten Sie aufnehmen, desto niedriger sind die Kosten pro GB.
Kaltdatennutzung
Wenn Abfragen häufig auf kalte Daten zugreifen, die auf dem Datenträger gespeichert sind, führen sie zu Lesevorgängen, die mehr Ressourcen verwenden, und können die Gesamtclusterkosten erhöhen.
Streaming vs. Warteschlangen-Ingestion
Jede Aufnahmemethode weist unterschiedliche Kosten-, Latenz- und Funktionalitätsmerkmale auf, sodass jede für unterschiedliche Szenarien besser ist. Für Kosten, Erfassen von Datenströmen ist billiger, wenn Sie viele kleine Tabellen mit rieselnden Daten erfassen, während Erfassen von Warteschlangen ist bei großen Tabellen kostengünstiger.
Tipp
Kosten pro aufgenommenem GB optimieren
Überprüfen Sie die Konfigurationen der wichtigsten Kostentreiber , um sicherzustellen, dass sie den Anforderungen ihres Clusters und den Serviceanforderungen für die Effizienz entsprechen. Im Besonderen:
- Minimieren Sie Zugriffe auf weniger häufig genutzte Daten, um Lesetransaktionen zu reduzieren.
- Aktivieren Sie die automatische Skalierung, um die Clustergröße dynamisch an die Anforderung abzugleichen.