Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Important
Diese Dokumentation wurde eingestellt und wird unter Umständen nicht aktualisiert.
Die auf Python basierende air CLI, die mit dem databricks-air Paket installiert wurde, ist inzwischen veraltet und wird nicht mehr aktiv gewartet.
Verwenden Sie die Databricks-CLI für neue Workloads. Siehe Verwenden der Databricks-CLI mit AI Runtime.
Jede Workload, die Sie mit air run übermitteln, ist sowohl eine Databricks-Jobausführung als auch ein MLflow-Lauf:
- Die Einzelvorgangsausführung (sichtbar auf der Seite Einzelvorgänge & Pipelines im Arbeitsbereich) verfolgt die Ausführung: Status, Rechenressourcen, Wiederholungen und Driver-Ausgabe.
- Die MLflow-Ausführung verfolgt das Experiment: Parameter, Metriken, Systemmetriken und Artefakte.
Eine Einreichung erstellt einen Auftragslauf und einen MLflow-Lauf. Ein Wiederholungsversuch erstellt einen neuen MLflow-Lauf.
Experimente und Ausführungen
Die folgenden Workload-YAML-Felder steuern das MLflow-Experiment, die Ausführung und die Artefaktspeicherung:
experiment_name: my-training # Creates or appends to this MLflow experiment
mlflow_run_name: baseline-lr3e5 # Names the MLflow run for this submission
# Stores artifacts in a UC volume
mlflow_artifact_location: /Volumes/main/default/mlflow-artifacts/my-training
compute:
  num_accelerators: 8
  accelerator_type: GPU_8xH100
command: torchrun --nproc_per_node=8 train.py
max_retries: 2
-
experiment_name(Erforderlich): Erstellt ein MLflow-Experiment mit diesem Namen, wenn eins nicht vorhanden ist, oder fügt eine neue Ausführung an das vorhandene Experiment an. Ein Experiment umfasst viele Durchläufe. -
mlflow_run_name(Optional): Legt den Ausführungsnamen fest. Falls kein Ausführungsname angegeben ist, wird standardmäßig der Experimentname (experiment_name) verwendet. -
mlflow_artifact_location(Optional): Legt den Wurzelstandort für Artefakte fest. Wenn ausgelassen, verwendet ein neues Experiment den Standard-DBFS-Standort, und ein bestehendes Experiment verwendet den mit demexperiment_nameStandort verknüpften Ort. Für ein Unity Catalog-Volume verwenden Sie/Volumes/<catalog>/<schema>/<volume>/.... Für ein bestehendes Experiment muss der angegebene Ort mit dem Artefaktstandort übereinstimmen oder weggelassen werden. -
max_retries(Optional): Jeder Wiederholungsversuch ist ein neuer MLflow,der im selben Experiment ausgeführt wird, sodass Sie Versuche vergleichen können. Die ursprüngliche Übermittlung und die zugehörigen Wiederholungen teilen einen Einzelvorgang.
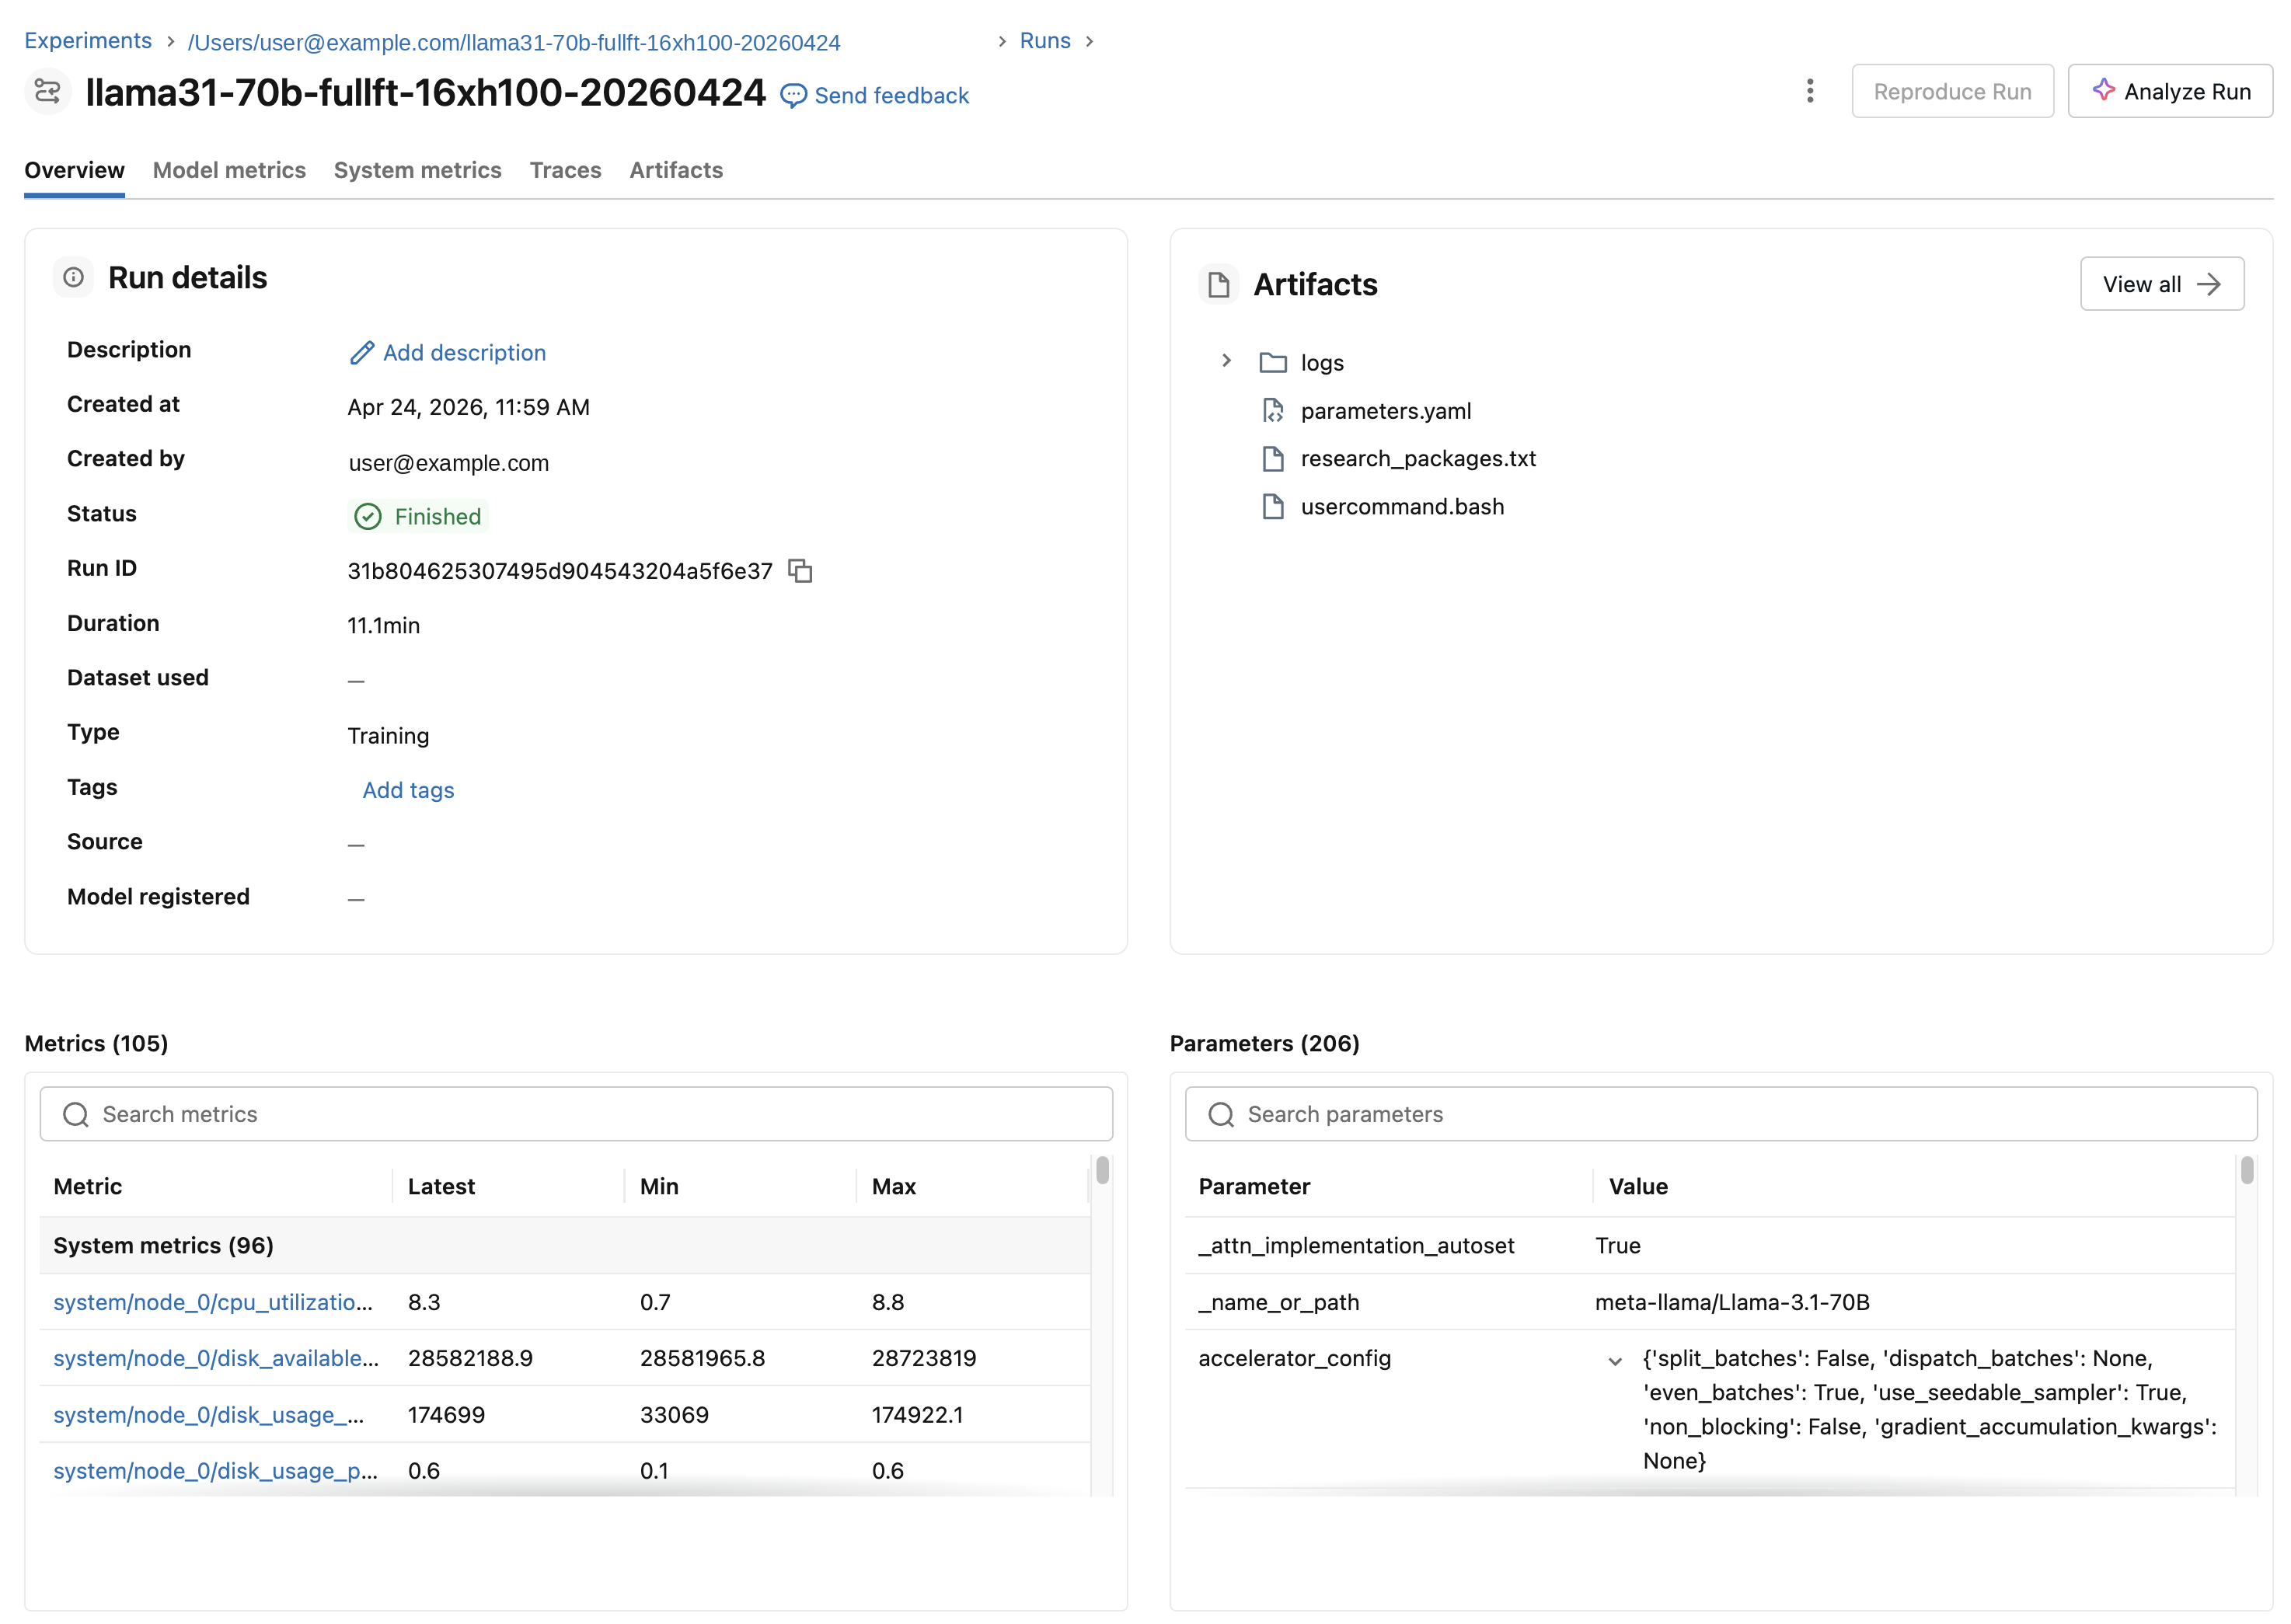
Navigieren zwischen Aufträgen, MLflow und vorherigen Arbeitslasten
Sie können von drei Stellen aus auf eine Ausführung zugreifen:
- Einzelvorgänge: Auf der Seite „Einzelvorgangsausführungen“ werden Ihre Ausführungen aufgelistet, und jede Ausführung ist mit seiner MLflow-Ausführung und Experiment verknüpft.
- MLflow: Auf der Seite "Experimente" werden Ihre MLflow-Experimente aufgelistet.
-
Vorherige Workloads:
air get run <job-run-id>Druckt klickbare Links zum Einzelvorgang, Experiment und MLflow-Ausführung des Ausführungsvorgangs.air list runslistet Ihre vorherigen Ausführungen auf und lässt Sie nach einer bestimmten Ausführung filtern.
air get run <job-run-id> # Links to the job, experiment, and MLflow run
air list runs # List previous runs; filter to find a specific run
Systemmetriken
GPU-, CPU- und Arbeitsspeichersystemmetriken werden für jede Ausführung automatisch erfasst. Es ist keine Konfiguration erforderlich. Zeigen Sie sie auf der Registerkarte " Systemmetriken " der MLflow-Ausführung an.
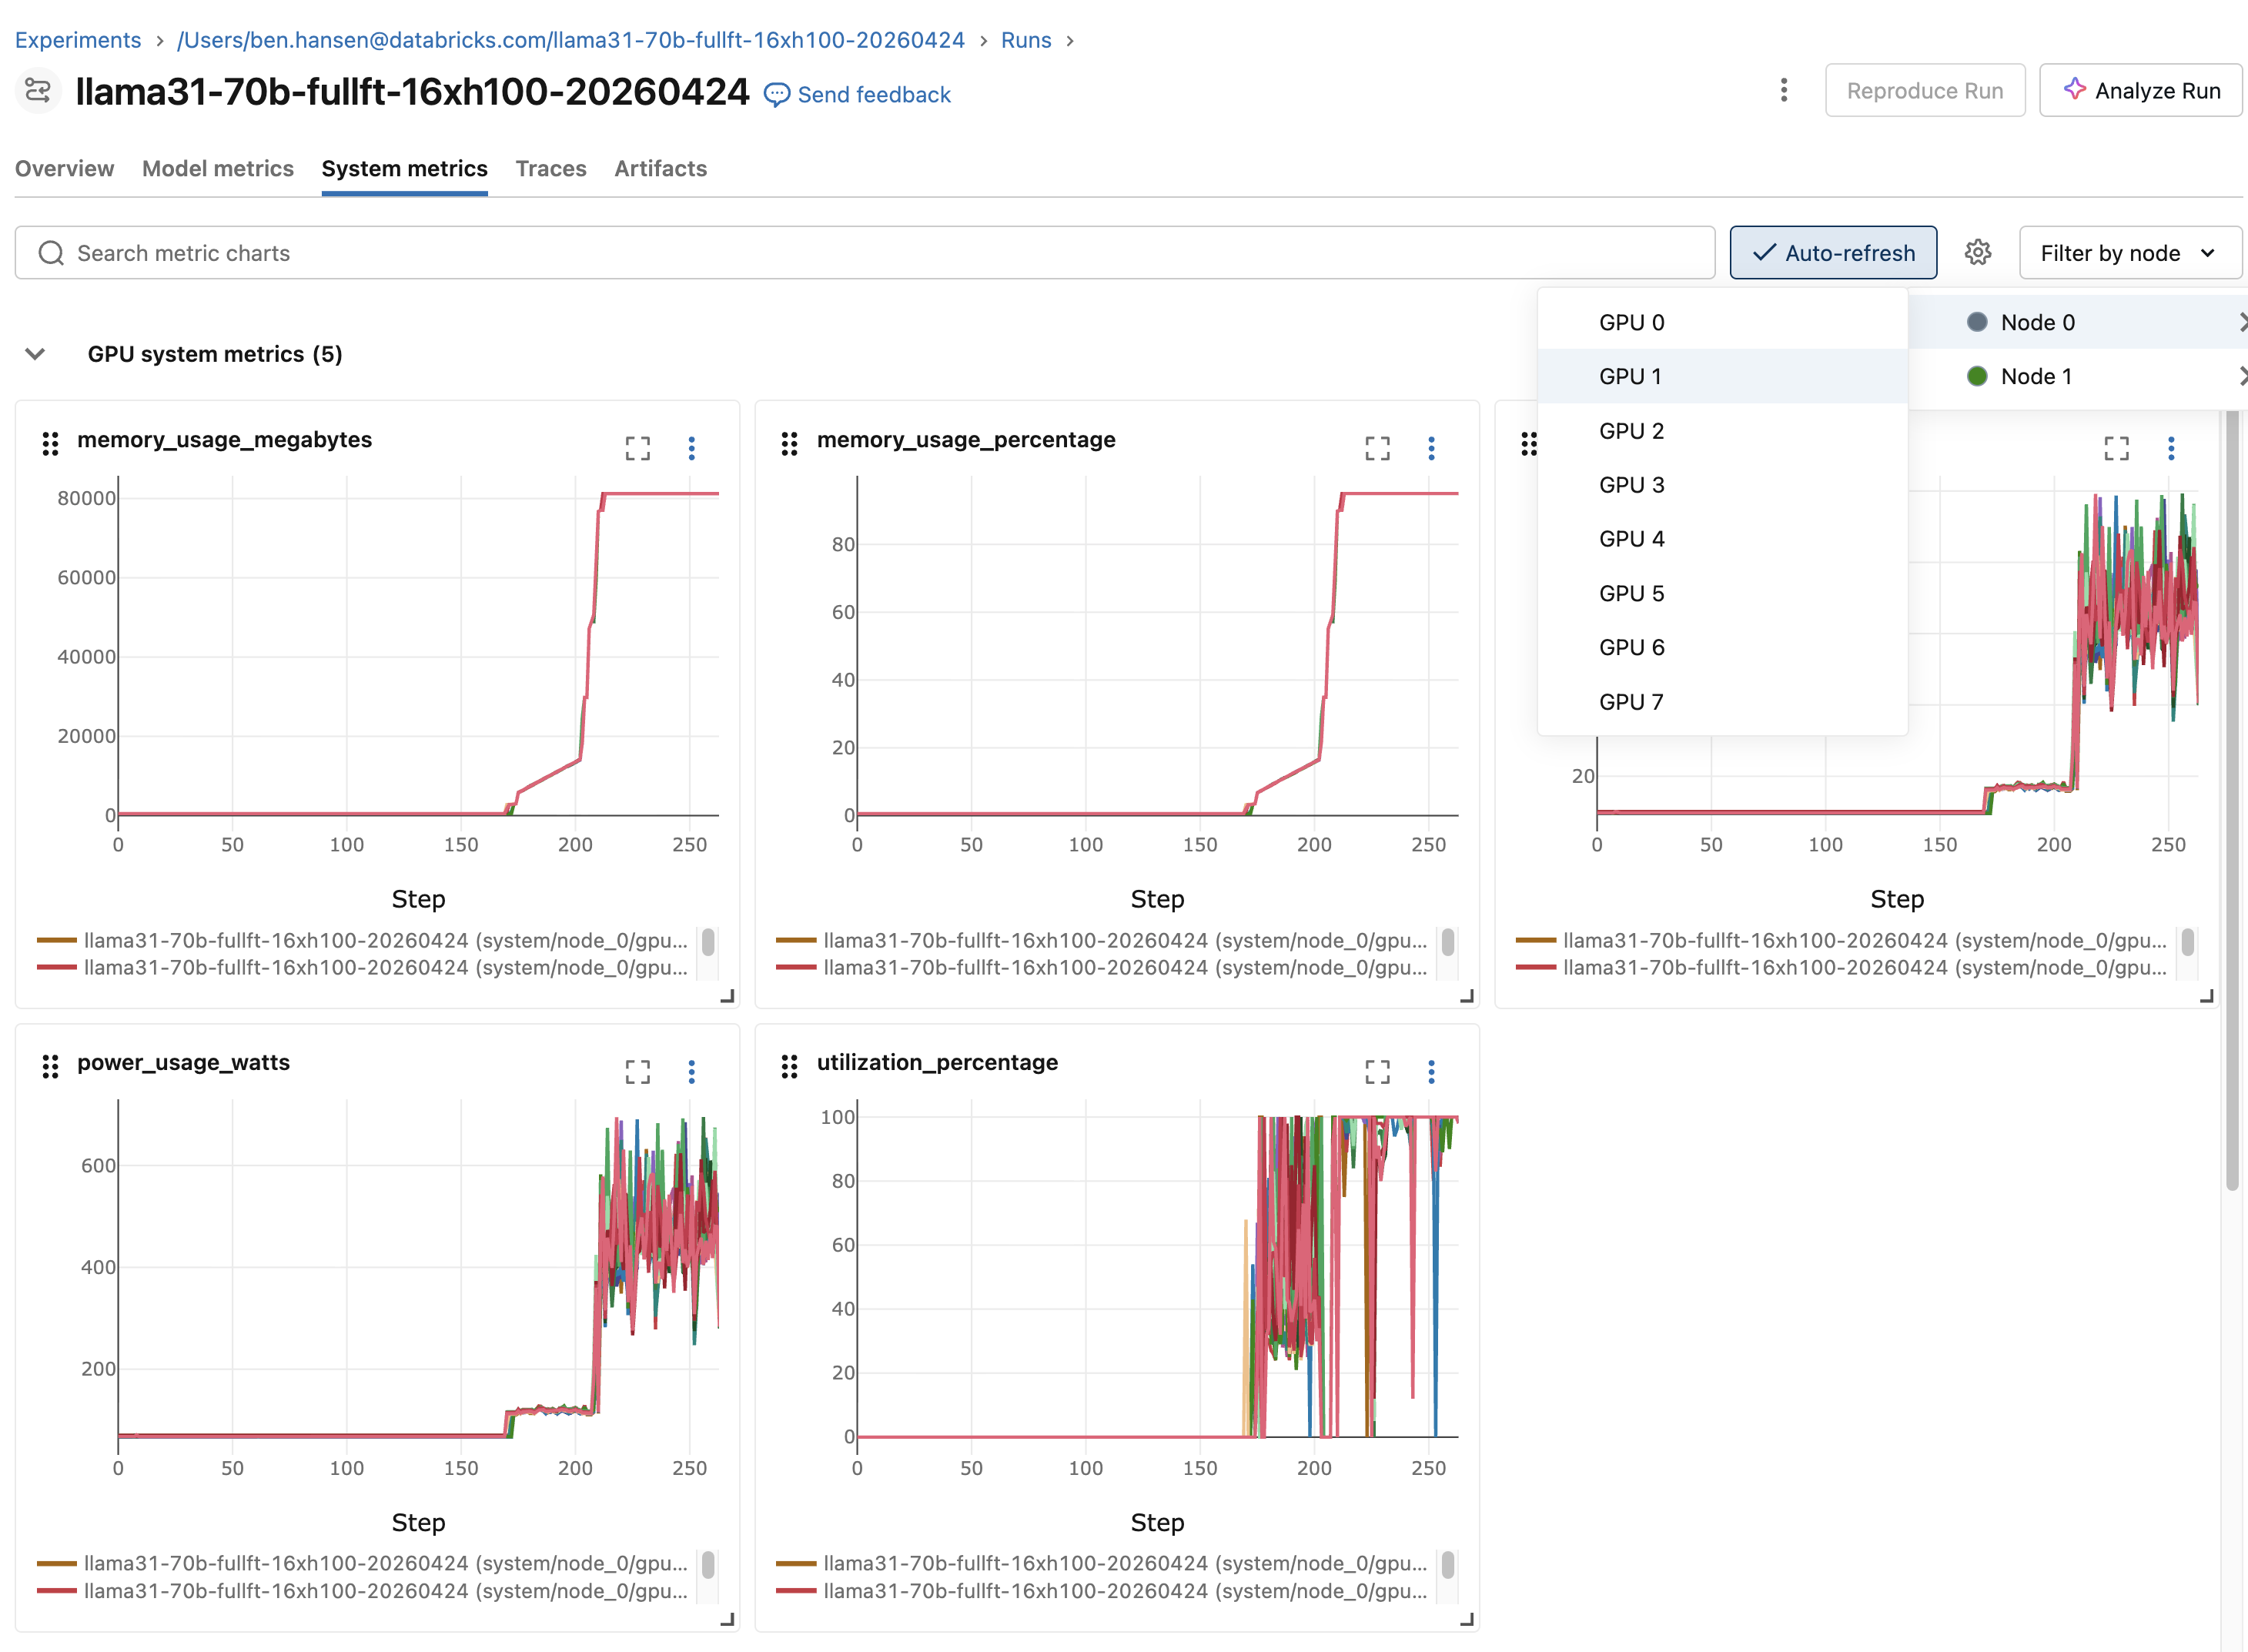
Protokollieren benutzerdefinierter Metriken
Die Plattform erstellt die MLflow-Ausführung und macht ihre ID für Ihren Schulungsprozess über die MLFLOW_RUN_ID Umgebungsvariable verfügbar. Verwenden Sie die MLflow-Tracking-API , um Ihre eigenen Parameter, Metriken und Artefakte für die Ausführung zu protokollieren.
Bei verteilten Arbeitslasten (Multiknoten) teilt jeder Knoten den gleichen MLflow-Lauf. Protokollieren Sie nur vom Rank-0-Prozess, sodass jede Metrik nur einmal erfasst wird:
import os

import mlflow

# Log from rank 0 only; all nodes share the same MLFLOW_RUN_ID.
if os.environ.get("RANK", "0") == "0":
    with mlflow.start_run(run_id=os.environ["MLFLOW_RUN_ID"]):
        mlflow.log_param("learning_rate", 3e-4)
        for step, loss in enumerate(training_losses):
            mlflow.log_metric("train_loss", loss, step=step)
Protokolle und Artefakte
Streamen oder Herunterladen der Protokolle einer Ausführung mit air logs:
air logs <job-run-id> # Stream logs from node 0
air logs <job-run-id> --node 2 # Logs from a specific node
air logs <job-run-id> --download-to ./logs/ # Download instead of streaming
Protokolle sind auch als Artefakte in einem MLflow-Run verfügbar. Um Modellprüfpunkte beizubehalten, schreiben Sie sie in ein Unity-Katalogvolume. Für Checkpointing-Muster siehe Trainingsleistung und Ausfallsicherheit in AI Runtime verbessern.