Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Feature-Tabellen können auf zwei Arten bereitgestellt werden:
- Model Serving: Stelle ein Modell bereit, das auf Feature-Tabellen trainiert wurde. Derselbe Endpunkt wird sowohl für die Feature-Suche als auch für die Modellinferenz verwendet. Der Endpunkt sucht Feature-Werte automatisch oder berechnet sie, wobei die beim Protokollieren des Modells verfolgte Herkunft verwendet wird. Verwenden Sie dies, um Modellvorhersagen bereitzustellen.
-
Feature Serving: Stellen Sie einen
FeatureSpecbereit, der direkt auf Feature-Tabellen verweist, ohne ein Modell. Der Endpunkt gibt die angeforderten Feature-Ergebnisse zurück. Verwenden Sie diese Option, wenn eine Anwendung Funktionswerte anstelle von Modellvorhersagen benötigt. Wenn Sie letztlich Features für Modellinferenz verwenden, empfiehlt Databricks, Model Serving direkt zu nutzen.
Beide Ansätze unterstützen vorberechnete und bedarfsorientierte Funktionen.
Anforderungen
- Databricks Runtime 14.2 ML oder höher.
- Um die Python-API zu verwenden, erfordert feature Serving
databricks-feature-engineeringVersion 0.1.2 oder höher, die in Databricks Runtime 14.2 ML integriert ist. Für frühere Versionen von Databricks Runtime ML installieren Sie die erforderliche Version manuell mithilfe von%pip install databricks-feature-engineering>=0.1.2. Wenn Sie ein Databricks-Notizbuch verwenden, müssen Sie den Python Kernel neu starten, indem Sie diesen Befehl in einer neuen Zelle ausführen:dbutils.library.restartPython(). - Für die Verwendung des Databricks SDK benötigt Feature Serving die
databricks-sdk-Version 0.18.0 oder höher. Um die erforderliche Version manuell zu installieren, verwenden Sie%pip install databricks-sdk>=0.18.0. Wenn Sie ein Databricks-Notizbuch verwenden, müssen Sie den Python Kernel neu starten, indem Sie diesen Befehl in einer neuen Zelle ausführen:dbutils.library.restartPython().
Databricks Feature Serving bietet eine Benutzeroberfläche und mehrere programmgesteuerte Optionen zum Erstellen, Aktualisieren, Abfragen und Löschen von Endpunkten. Dieser Artikel enthält Anweisungen für jede der folgenden Optionen:
- Databricks UI
- REST-API
- Python-API
- Databricks SDK
Um die REST-API oder das MLflow Deployments SDK zu verwenden, müssen Sie über ein Databricks-API-Token verfügen.
Wichtig
Als bewährte Sicherheitsmethode für Produktionsszenarien empfiehlt Databricks, Computer-zu-Computer-OAuth-Token für die Authentifizierung während der Produktion zu verwenden.
Für die Test- und Entwicklungsphase empfiehlt Databricks die Verwendung eines persönlichen Zugriffstokens, das Dienstprinzipalen anstelle von Arbeitsbereichsbenutzern gehört. Informationen zum Erstellen von Token für Dienstprinzipale finden Sie unter Verwalten von Token für einen Dienstprinzipal.
Authentifizierung für Feature Serving
Informationen zur Authentifizierung finden Sie unter Authorize access to Azure Databricks resources.
Erstellen der Datei FeatureSpec
Eine FeatureSpec ist ein benutzerdefinierter Satz von Features und Funktionen. Sie können Features und Funktionen in einer FeatureSpec kombinieren.
FeatureSpecs werden in Einheits-Katalog gespeichert und verwaltet und erscheinen im Catalog Explorer.
Die Tabellen, die in einem FeatureSpec angegeben sind, müssen in einem Online-Feature-Store oder einem Online-Store eines Drittanbieters veröffentlicht werden. Siehe Databricks Online Feature Stores.
Sie müssen das databricks-feature-engineering-Paket verwenden, um ein FeatureSpec zu erstellen.
Definieren Sie zunächst die Funktion:
from unitycatalog.ai.core.databricks import DatabricksFunctionClient

client = DatabricksFunctionClient()

CATALOG = "main"
SCHEMA = "default"

def difference(num_1: float, num_2: float) -> float:
  """
  A function that accepts two floating point numbers, subtracts the second one
  from the first, and returns the result as a float.

  Args:
      num_1 (float): The first number.
      num_2 (float): The second number.

  Returns:
      float: The resulting difference of the two input numbers.
  """
  return num_1 - num_2

client.create_python_function(
  func=difference,
  catalog=CATALOG,
  schema=SCHEMA,
  replace=True
)
Anschließend können Sie die Funktion in einer FeatureSpec:
from databricks.feature_engineering import (
  FeatureFunction,
  FeatureLookup,
  FeatureEngineeringClient,
)

fe = FeatureEngineeringClient()

features = [
  # Lookup column `average_yearly_spend` and `country` from a table in UC by the input `user_id`.
  FeatureLookup(
    table_name="main.default.customer_profile",
    lookup_key="user_id",
    feature_names=["average_yearly_spend", "country"]
  ),
  # Calculate a new feature called `spending_gap` - the difference between `ytd_spend` and `average_yearly_spend`.
  FeatureFunction(
    udf_name="main.default.difference",
    output_name="spending_gap",
    # Bind the function parameter with input from other features or from request.
    # The function calculates num_1 - num_2.
    input_bindings={"num_1": "ytd_spend", "num_2": "average_yearly_spend"},
  ),
]

# Create a `FeatureSpec` with the features defined above.
# The `FeatureSpec` can be accessed in Unity Catalog as a function.
fe.create_feature_spec(
  name="main.default.customer_features",
  features=features,
)
Angeben von Standardwerten
Um Standardwerte für Features anzugeben, verwenden Sie den default_values Parameter in der FeatureLookup. Sehen Sie sich das folgende Beispiel an:
feature_lookups = [
    FeatureLookup(
        table_name="ml.recommender_system.customer_features",
        feature_names=[
            "membership_tier",
            "age",
            "page_views_count_30days",
        ],
        lookup_key="customer_id",
        default_values={
          "age": 18,
          "membership_tier": "bronze"
        },
    ),
]
Wenn die Feature-Spalten mithilfe des rename_outputs Parameters umbenannt werden, muss default_values die umbenannten Feature-Namen verwenden.
FeatureLookup(
  table_name = 'main.default.table',
  feature_names = ['materialized_feature_value'],
  lookup_key = 'id',
  rename_outputs={"materialized_feature_value": "feature_value"},
  default_values={
    "feature_value": 0
  }
)
Python-Abhängigkeiten hinzufügen
Wenn eine benutzerdefinierte Funktion (UDF) Python-Pakete importiert, deklarieren Sie diese beim Erstellen des FeatureSpec. Der Parameter extra_pip_requirements benötigt databricks-feature-engineering Version 0.17.0 oder höher. Feature Serving installiert MLflow und databricks-feature-lookup-Pakete automatisch.
Wenn zum Beispiel ein UDF in Ihrer Feature-Spezifikation NumPy importiert, fügen Sie die Anforderung in die Spezifikation hinzu:
fe.create_feature_spec(
    name="main.default.customer_features_with_dependencies",
    features=features,
    extra_pip_requirements=["numpy==1.26.4"],
)
Verwenden Sie main.default.customer_features_with_dependencies als Namen der Spezifikation, wenn Sie den Endpunkt erstellen.
Jeder Eintrag in extra_pip_requirements muss eine PyPI-Anforderungsfolge sein, wie zum Beispiel numpy==1.26.4, oder ein Pfad zu einer .whl Datei in einem Unity-Catalog-Volume. Zum Beispiel für ein hochgeladenes Rad verwenden /Volumes/main/libraries/wheels/custom_features-1.0.0-py3-none-any.whl . Der Ersteller des Endpunkts muss über USE CATALOG für das Volume sowie über USE SCHEMA und READ VOLUME für den übergeordneten Katalog und das Schema verfügen.
Für Pakete aus einem privaten Repository konfigurieren Sie das Workspace Default Package Repository. Fügen Sie keine Pip-Befehlsoptionen wie --index-url, in extra_pip_requirements.
Abhängigkeiten in einer ENVIRONMENT Unity Catalog UDF-Klausel gelten für die offline SQL-Ausführung. Feature Serving kopiert sie nicht automatisch. Deklarieren Sie jedes von den UDFs benötigte Paket, einschließlich UDFs in den vorgelagerten Features, in den Anforderungen der Funktionsspezifikation.
Wenn die Endpunkt-Bereitstellung fehlschlägt, überprüfen Sie die Build-Logs auf Paketinstallationsfehler, Versionskonflikte oder Radzugriffsfehler. Siehe Überwachen der Modellqualität und Endpunktintegrität.
Ein Beispiel mit CustomUDF und FeatureViewSource finden Sie unter CustomUDF-Features in Serve und ihre Abhängigkeiten. Informationen zu Abhängigkeiten für die Modellbereitstellung finden Sie unter Abhängigkeiten für benutzerdefinierte UDFs.
Erstellen eines Endpunkts
FeatureSpec definiert den Endpunkt. Weitere Informationen finden Sie in Create custom model serving endpoints, the Python API documentation, or the Databricks SDK documentation for details.
Hinweis
Für Workloads, die latenzempfindlich sind oder hohe Abfragen pro Sekunde erfordern, bietet Model Serving Routenoptimierung für benutzerdefinierte Modellbereitstellungsendpunkte, siehe Routenoptimierung bei der Bereitstellung von Endpunkten.
Databricks SDK – Python
from databricks.sdk import WorkspaceClient
from databricks.sdk.service.serving import EndpointCoreConfigInput, ServedEntityInput

workspace = WorkspaceClient()

# Create endpoint
workspace.serving_endpoints.create(
  name="my-serving-endpoint",
  config = EndpointCoreConfigInput(
    served_entities=[
    ServedEntityInput(
        entity_name="main.default.customer_features",
        scale_to_zero_enabled=True,
        workload_size="Small"
      )
    ]
  )
)
Python-API
from databricks.feature_engineering.entities.feature_serving_endpoint import (
  ServedEntity,
  EndpointCoreConfig,
)

fe.create_feature_serving_endpoint(
  name="customer-features",
    config=EndpointCoreConfig(
    served_entities=ServedEntity(
      feature_spec_name="main.default.customer_features",
             workload_size="Small",
             scale_to_zero_enabled=True,
             instance_profile_arn=None,
    )
  )
)
REST-API
curl -X POST -u token:$DATABRICKS_API_TOKEN ${WORKSPACE_URL}/api/2.0/serving-endpoints \
    -H 'Content-Type: application/json' \
    -d '"name": "customer-features",
   "config": {
       "served_entities": [
           {
               "entity_name": "main.default.customer_features",
               "workload_size": "Small",
               "scale_to_zero_enabled": true
           }
       ]
   }'
Um den Endpunkt anzuzeigen, klicken Sie in der linken Randleiste der Databricks-Benutzeroberfläche auf Bereitstellen. Wenn der Status Bereit lautet, kann der Endpunkt auf Abfragen antworten. Weitere Informationen zur Modellbereitstellung finden Sie unter Model Serving.
Speichern des erweiterten DataFrames in der Ableitungstabelle
Für Endpunkte, die ab Februar 2025 erstellt wurden, können Sie das Modell konfigurieren, das den Endpunkt bedient, um den erweiterten DataFrame zu protokollieren, der die Nachschlagefunktionswerte und Funktionsrückgabewerte enthält. Der DataFrame wird in der Inferenztabelle für das bereitgestellte Modell gespeichert.
Anweisungen zum Festlegen dieser Konfiguration finden Sie unter Protokollfeatures-Lookup DataFrames in Inferencetabellen übertragen.
Informationen zu Inferenztabellen finden Sie unter Loganfragen und Antworten für bereitstellende Endpunkte (Legacy).
Abrufen eines Endpunkts
Sie können das Databricks SDK oder die Python-API verwenden, um die Metadaten und den Status eines Endpunkts abzurufen.
Databricks SDK – Python
from databricks.sdk import WorkspaceClient
workspace = WorkspaceClient()

endpoint = workspace.serving_endpoints.get(name="customer-features")
# print(endpoint)
Python-API
endpoint = fe.get_feature_serving_endpoint(name="customer-features")
# print(endpoint)
Abrufen des Schemas eines Endpunkts
Sie können das Databricks SDK oder die REST-API verwenden, um das Schema eines Endpunkts abzurufen. Weitere Informationen zum Endpunktschema finden Sie unter Abrufen eines Modells, das Endpunktschemas dient.
Databricks SDK – Python
from databricks.sdk import WorkspaceClient
workspace = WorkspaceClient()

# Create endpoint
endpoint = workspace.serving_endpoints.get_open_api(name="customer-features")
REST-API
ACCESS_TOKEN=<token>
ENDPOINT_NAME=<endpoint name>

curl "https://example.databricks.com/api/2.0/serving-endpoints/$ENDPOINT_NAME/openapi" -H "Authorization: Bearer $ACCESS_TOKEN" -H "Content-Type: application/json"
Abfragen eines Endpunkts
Sie können die REST-API, das MLflow Deployments SDK oder die Serving UI verwenden, um einen Endpunkt abzufragen.
Der folgende Code zeigt, wie Sie Anmeldeinformationen einrichten und den Client bei Verwendung des MLflow Deployments SDK erstellen.
  # Set up credentials
  export DATABRICKS_HOST=...
  export DATABRICKS_TOKEN=...
  # Set up the client
  import mlflow.deployments

  client = mlflow.deployments.get_deploy_client("databricks")
Hinweis
Als bewährte Methode für die Sicherheit empfiehlt Databricks, dass Sie bei der Authentifizierung mit automatisierten Tools, Systemen, Skripten und Anwendungen persönliche Zugriffstoken verwenden, die zu Dienstprinzipalen und nicht zu Benutzern des Arbeitsbereichs gehören. Informationen zum Erstellen von Token für Dienstprinzipale finden Sie unter Verwalten von Token für einen Dienstprinzipal.
Abfragen eines Endpunkts mithilfe von APIs
Dieser Abschnitt enthält Beispiele zum Abfragen eines Endpunkts mithilfe der REST-API oder des MLflow Deployments SDK.
MLflow Deployments SDK
Wichtig
Im folgenden Beispiel wird die predict()-API aus dem MLflow Deployments SDK verwendet. Diese API ist experimentell, und die API-Definition kann sich ändern.
import mlflow.deployments

client = mlflow.deployments.get_deploy_client("databricks")
response = client.predict(
    endpoint="test-feature-endpoint",
    inputs={
        "dataframe_records": [
            {"user_id": 1, "ytd_spend": 598},
            {"user_id": 2, "ytd_spend": 280},
        ]
    },
)
REST-API
curl -X POST -u token:$DATABRICKS_API_TOKEN $ENDPOINT_INVOCATION_URL \
  -H 'Content-Type: application/json' \
  -d '{"dataframe_records": [
          {"user_id": 1, "ytd_spend": 598},
          {"user_id": 2, "ytd_spend": 280}
      ]}'
Abfragen eines Endpunkts mithilfe der Benutzeroberfläche
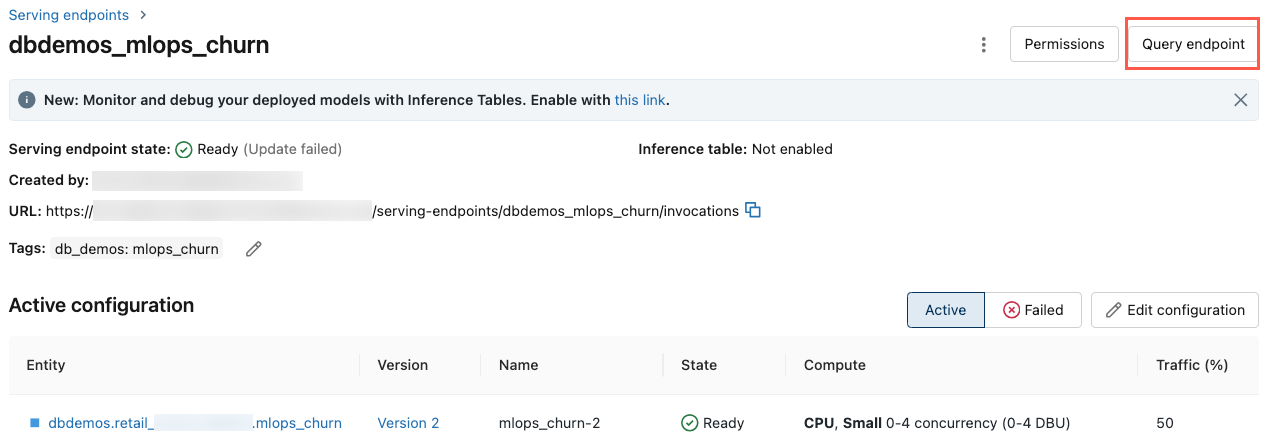
Sie können einen Dienstendpunkt direkt über die Benutzeroberfläche des Diensts abfragen. Die Benutzeroberfläche enthält generierte Codebeispiele, mit denen Sie den Endpunkt abfragen können.
Klicken Sie in der linken Randleiste des Azure Databricks Arbeitsbereichs auf Serving.
Klicken Sie auf den Endpunkt, den Sie abfragen möchten.
Klicken Sie oben rechts auf dem Bildschirm auf den Abfrageendpunkt.
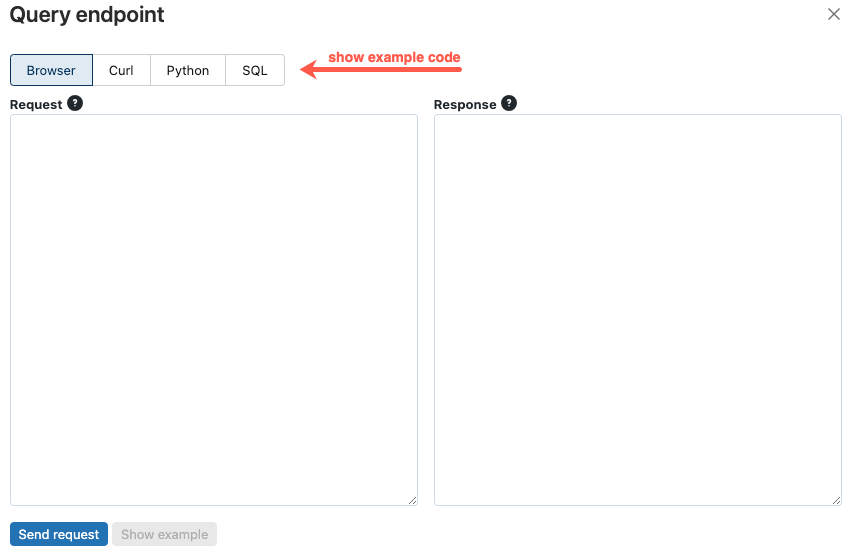
Geben Sie im Feld Anforderung den Anforderungstext im JSON-Format ein.
Klicke auf Anforderung senden.
// Example of a request body.
{
  "dataframe_records": [
    { "user_id": 1, "ytd_spend": 598 },
    { "user_id": 2, "ytd_spend": 280 }
  ]
}
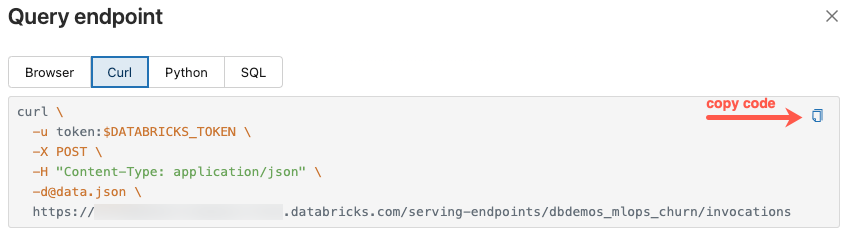
Der Query-Endpunkt enthält generierten Beispielcode in curl, Python und SQL. Klicken Sie auf die Registerkarten, um den Beispielcode anzuzeigen und zu kopieren.
Um den Code zu kopieren, klicken Sie oben rechts im Textfeld auf das Kopiersymbol.
Einen Endpunkt aktualisieren
Wichtig
Verwenden Sie zum Ändern der Konfiguration eines Feature Serving-Endpunkts (z. B. Ändern der FeatureSpec Größe oder Workload) immer die in diesem Abschnitt beschriebenen Update-APIs. Löschen Sie den Endpunkt nicht, und erstellen Sie ihn nicht neu, um Änderungen anzuwenden. Das Löschen eines Liveendpunkts verursacht sofortige Ausfallzeiten und unterbricht alle Anwendungen, die sie abfragen.
Sie können einen Endpunkt mithilfe der REST-API, des Databricks SDK oder der Dienstbenutzeroberfläche aktualisieren.
Aktualisieren eines Endpunkts mithilfe von APIs
Databricks SDK – Python
from databricks.sdk import WorkspaceClient
workspace = WorkspaceClient()

workspace.serving_endpoints.update_config(
  name="my-serving-endpoint",
  served_entities=[
    ServedEntityInput(
      entity_name="main.default.customer_features",
      scale_to_zero_enabled=True,
      workload_size="Small"
    )
  ]
)
REST-API
curl -X PUT -u token:$DATABRICKS_API_TOKEN ${WORKSPACE_URL}/api/2.0/serving-endpoints/<endpoint_name>/config \
  -H 'Content-Type: application/json' \
  -d '"served_entities": [
        {
            "name": "customer-features",
            "entity_name": "main.default.customer_features_new",
            "workload_size": "Small",
            "scale_to_zero_enabled": True
        }
    ]'
Aktualisieren eines Endpunkts mithilfe der Benutzeroberfläche
Führen Sie die folgenden Schritte aus, um die Serving UI zu bedienen:
- Klicken Sie in der linken Randleiste des Azure Databricks Arbeitsbereichs auf Serving.
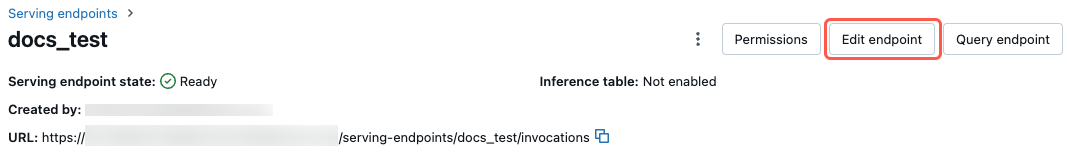
- Klicken Sie in der Tabelle auf den Namen des Endpunkts, den Sie aktualisieren möchten. Der Endpunktbildschirm wird angezeigt.
- Klicken Sie oben rechts auf dem Bildschirm auf Endpunkt bearbeiten.
- Bearbeiten Sie im Dialogfeld Endpunkt bearbeiten die Endpunkteinstellungen nach Bedarf.
- Klicken Sie auf Aktualisieren, um Ihre Änderungen zu speichern.
Abhängigkeiten eines Live-Feature-Serving-Endpunkts aktualisieren
Ein Feature Serving Endpunkt löst seine Abhängigkeiten auf, wenn er erstmals gebaut und bereitgestellt wird: die Rechte, die sein Service-Principal benötigt, um die Online-Tabelle (USE CATALOG, SELECT und EXECUTE) zu lesen, sowie FeatureSpec auf der in seinem USE SCHEMA beschriebenen Unity Catalog UDF. Der Endpunkt legt diese Berechtigungen beim Build fest und löst sie nicht bei einem einfachen erneuten Bereitstellen oder Neustart erneut auf. Wenn du die Online-Tabelle oder UDF neu erstellst, verliert der Endpunkt die Berechtigung darauf. Wenn du die UDF an Ort und Stelle aktualisierst, läuft der Endpunkt weiterhin mit der Originalversion. Feature-Lookups können fehlschlagen oder die alte UDF-Logik stillschweigend verwenden, selbst während der Endpunkt weiterhin Bereit meldet.
Sowohl für Online-Tabellen als auch für On-Demand-UDFs empfiehlt Databricks eine versionierte Migration: Eine neue Version der Abhängigkeit erstellen, einen neuen Endpunkt dagegen anlegen und den Datenverkehr zum neuen Endpunkt migrieren. Das hilft Ihnen, Ausfallzeiten und die in diesem Abschnitt beschriebenen Ausfallmodi zu vermeiden.
Erstelle eine Online-Tabelle neu
Warnung
Sie sollten eine unter einem Live-Feature-Serving-Endpunkt vorhandene Online-Tabelle nicht löschen und neu erstellen.
Wenn Sie einen Endpunkt erstellen, weist die Modellbereitstellung dem Dienstprinzipal des Endpunkts USE CATALOG für den Katalog der Online-Tabelle, USE SCHEMA für das Schema und SELECT für die Online-Tabelle zu. Das Löschen und Neuerstellen der Tabelle, auch mit demselben Namen, erzeugt in Unity Catalog ein neues sicherungsfähiges Element, sodass die SELECT-Berechtigung nicht übernommen wird. Der Service Principal verliert den Zugriff auf die Tabelle, das Token-Minting von OAuth schlägt fehl, und die Verbindung zum Online-Shop fällt auf Passwortauthentifizierung zurück und scheitert. Feature-Lookups scheitern dann mit Fehlern wie KeyError: 'OAUTH_TOKEN' oder password authentication failed.
Diese Fehler sind leicht zu übersehen: Der Endpunkt meldet weiterhin Bereit und die Synchronisationspipeline zeigt weiterhin erfolgreiche Durchläufe an, während Lookups fehlschlagen. Das Ändern des Synchronisationsmodus einer Online-Tabelle (zum Beispiel zwischen CONTINUOUS und SNAPSHOT) kann nicht direkt durchgeführt werden und erfordert das Neuerstellen der Tabelle, was dieses Problem ebenfalls auslösen kann.
Ein Endpunkt liest keine bestimmte Online-Tabelle. Es sucht Features über die Offline-Feature-Tabelle, die in ihrem FeatureSpec genannt ist, und wenn eine Feature-Tabelle in mehr als einer Online-Tabelle veröffentlicht wird, verwendet der Endpunkt die älteste. Das Veröffentlichen derselben Feature-Tabelle in einer zweiten Online-Tabelle verschiebt keinen Endpunkt auf die neue Online-Tabelle. Siehe Einschränkungen im Online-Feature Store.
Um Ausfallzeiten zu minimieren, versionieren Sie sowohl die Offline-Funktionstabelle als auch die Online-Tabelle:
- Erstelle eine neue Offline-Feature-Tabelle und füge die Version in ihren Namen ein (zum Beispiel,
customer_features_v2). - Veröffentlichen Sie die neue Featuretabelle in einer neuen Online-Tabelle. Weitere Informationen finden Sie unter Veröffentlichen einer Featuretabelle.
- Erstelle eine neue
FeatureSpec, die die neue Feature-Tabelle verwendet, und erstelle einen neuen Feature Serving Endpunkt, der sie bedient. - Leite den Datenverkehr zum neuen Endpoint um. Nachdem der alte Endpunkt keinen Datenverkehr mehr erhält, löschen Sie ihn und seine Online-Tabelle.
Aktualisieren Sie ein On-Demand-UDF
Warnung
Ändern Sie kein Unity Catalog-UDF, das von einem vorhandenen FeatureSpec verwendet wird.
Die On-Demand-UDF eines FeatureSpec ist zum Zeitpunkt der Bereitstellung in den Bereitstellungsendpunkt integriert. Eine einfache Aktualisierung oder erneute Bereitstellung verwendet dieselbe UDF in diesem Serving-Image wieder. Ein In-Place-Update des UDF unter demselben Namen wird nicht wirksam. Wenn du das UDF löschst und neu erstellst, verliert der Endpunkt ebenfalls EXECUTE, sodass Lookups, die das UDF verwenden, nicht mehr funktionieren.
FeatureSpecs und UDFs haben kein Versionsfeld, also Version nach Name: Erstelle ein neues UDF und ein neues FeatureSpec, erstelle einen neuen Endpunkt, der den neuen FeatureSpecverwendet, und migriere den Datenverkehr dorthin. Siehe Erstellen eines FeatureSpec.
Siehe On-demand-Feature-Berechnungsergebnis.
Wiederherstellen eines Endpunkts nach einer direkten Änderung
Wenn Sie eine vorhandene Abhängigkeit bereits geändert haben, erstellen Sie den Endpunkt so neu, dass seine Abhängigkeiten wieder aufgelöst werden. Erstellen Sie einen neuen FeatureSpec (oder registrieren Sie für einen Model Serving Endpunkt eine neue Modellversion) und aktualisieren Sie den Endpunkt , um ihn zu servieren. Das Ändern dessen, was der Endpunkt bereitstellt, erstellt den Endpunkt neu, der einen neuen Dienstprinzipal bereitstellt und die Berechtigungseinrichtung erneut ausführt. Keine dieser Möglichkeiten erstellt den Endpunkt zuverlässig neu: das Stoppen und erneute Starten, eine einfache erneute Bereitstellung oder das Ändern einer Umgebungsvariablen.
Einen Endpunkt löschen
Warnung
Diese Aktion kann nicht rückgängig gemacht werden. Das Löschen eines Endpunkts zur Featurebereitstellung führt zu sofortigen Ausfallzeiten für alle Anwendungen, die sie abfragen. Wenn Sie die Konfiguration des Endpunkts ändern möchten, verwenden Sie "Aktualisieren eines Endpunkts ", anstatt den Endpunkt zu löschen und neu zu erstellen.
Sie können einen Endpunkt mithilfe der REST-API, des Databricks SDK, der Python-API oder der Dienstbenutzeroberfläche löschen.
Löschen eines Endpunkts mithilfe von APIs
Databricks SDK – Python
from databricks.sdk import WorkspaceClient
workspace = WorkspaceClient()

workspace.serving_endpoints.delete(name="customer-features")
Python-API
fe.delete_feature_serving_endpoint(name="customer-features")
REST-API
curl -X DELETE -u token:$DATABRICKS_API_TOKEN ${WORKSPACE_URL}/api/2.0/serving-endpoints/<endpoint_name>
Löschen eines Endpunkts mithilfe der Benutzeroberfläche
Führen Sie die folgenden Schritte aus, um einen Endpunkt mithilfe der Serving UI zu löschen:
- Klicken Sie in der linken Randleiste des Azure Databricks Arbeitsbereichs auf Serving.
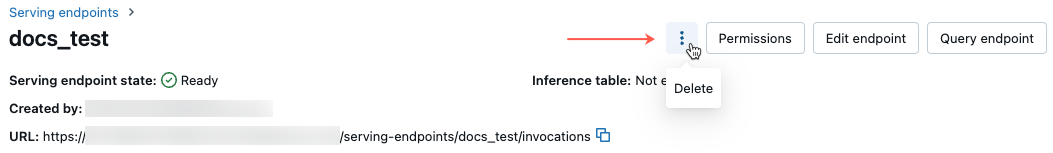
- Klicken Sie in der Tabelle auf den Namen des Endpunkts, den Sie löschen möchten. Der Endpunktbildschirm wird angezeigt.
- Klicken Sie oben rechts auf dem Bildschirm auf das
 und wählen Sie "Löschen" aus.
Überwachen der Integrität eines Endpunkts
Informationen zu den Protokollen und Metriken, die für Feature Serving-Endpunkte verfügbar sind, finden Sie unter Überwachen der Modellqualität und der Endpunktintegrität.
Zugriffssteuerung
Informationen zu Berechtigungen für Endpunkte zur Featurebereitstellung finden Sie unter Verwalten von Berechtigungen auf einem Modellbereitstellungsendpunkt.
Notebook mit Beispielen
Dieses Notizbuch veranschaulicht die Verwendung des Databricks SDK zum Erstellen eines Feature-Serving-Endpunkts mithilfe des Databricks Online Feature Store.