Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
In diesem Artikel wird der schnellste Weg gezeigt, eine Azure-gehostete Anwendung auszuführen, die ein über Microsoft Foundry bereitgestelltes Fireworks AI-Modell aufruft. Die Architektur beginnt mit einer containerisierten Anwendung, einem Feuerwerksbereitstellungsendpunkt und der grundlegenden geheimen Verwaltung. Fügen Sie Datenbanken, Warteschlangen, API-Gateways, Zwischenspeicherung und andere unterstützende Dienste nur hinzu, wenn Ihr Produkt sie benötigt.
Warum dies für Startups wichtig ist
Rückschlüsse sind eine der größten kontrollierbaren Kosten für ein KI-natives Unternehmen. Die von Ihnen ausgewählte Bereitstellungsarchitektur kann Kosten, Betriebsaufwand, Leistung und zukünftige Flexibilität beeinflussen.
Microsoft Foundry und Fireworks AI bieten:
- Azure-native Governance und Abrechnung
- Zugriff auf Open-Weight- und anpassbare Modelle
- Verwaltete Ableitungsinfrastruktur
- Eine konsistente Bereitstellungserfahrung
- Ein Weg von Experimenten zur Produktion, ohne GPU-Infrastruktur zu erstellen
Vergleichen der Ableitungsoptionen
| Auswahl | Strengths | Einschränkungen | Wenn es passt |
|---|---|---|---|
| Selbst gehostetes vLLM auf einer GPU-Flotte | Vollständige Kontrolle über Modell, Planung und Kosten | Erfordert dediziertes ML-Plattform-Engineering und laufende Vorgänge | Unternehmen der Serie C+ mit Plattformteams |
| Frontier-APIs für geschlossene Quellen | Schnellster Weg zum Experimentieren | Die Kosten können bei Skalierung steigen, und die Optionen zur Feinabstimmung können begrenzt sein. | Frühes Prototyping |
| Generische Cloud-KI-Dienste | Einfach zu integrieren | Weniger arbeitslastspezifische Optimierung | Apps, bei denen KI nicht der Kern-Differentiator ist |
| Fireworks auf Microsoft Foundry | Modelle mit offenen Gewichten und Anpassungsmöglichkeiten, Azure-native Governance und Abrechnung, verwaltete Inferenz | Erfordert Bereitstellung und Konfiguration von Foundry-Ressourcen | KI-native Startups, die auf Azure aufbauen |
Referenzarchitektur auf einen Blick
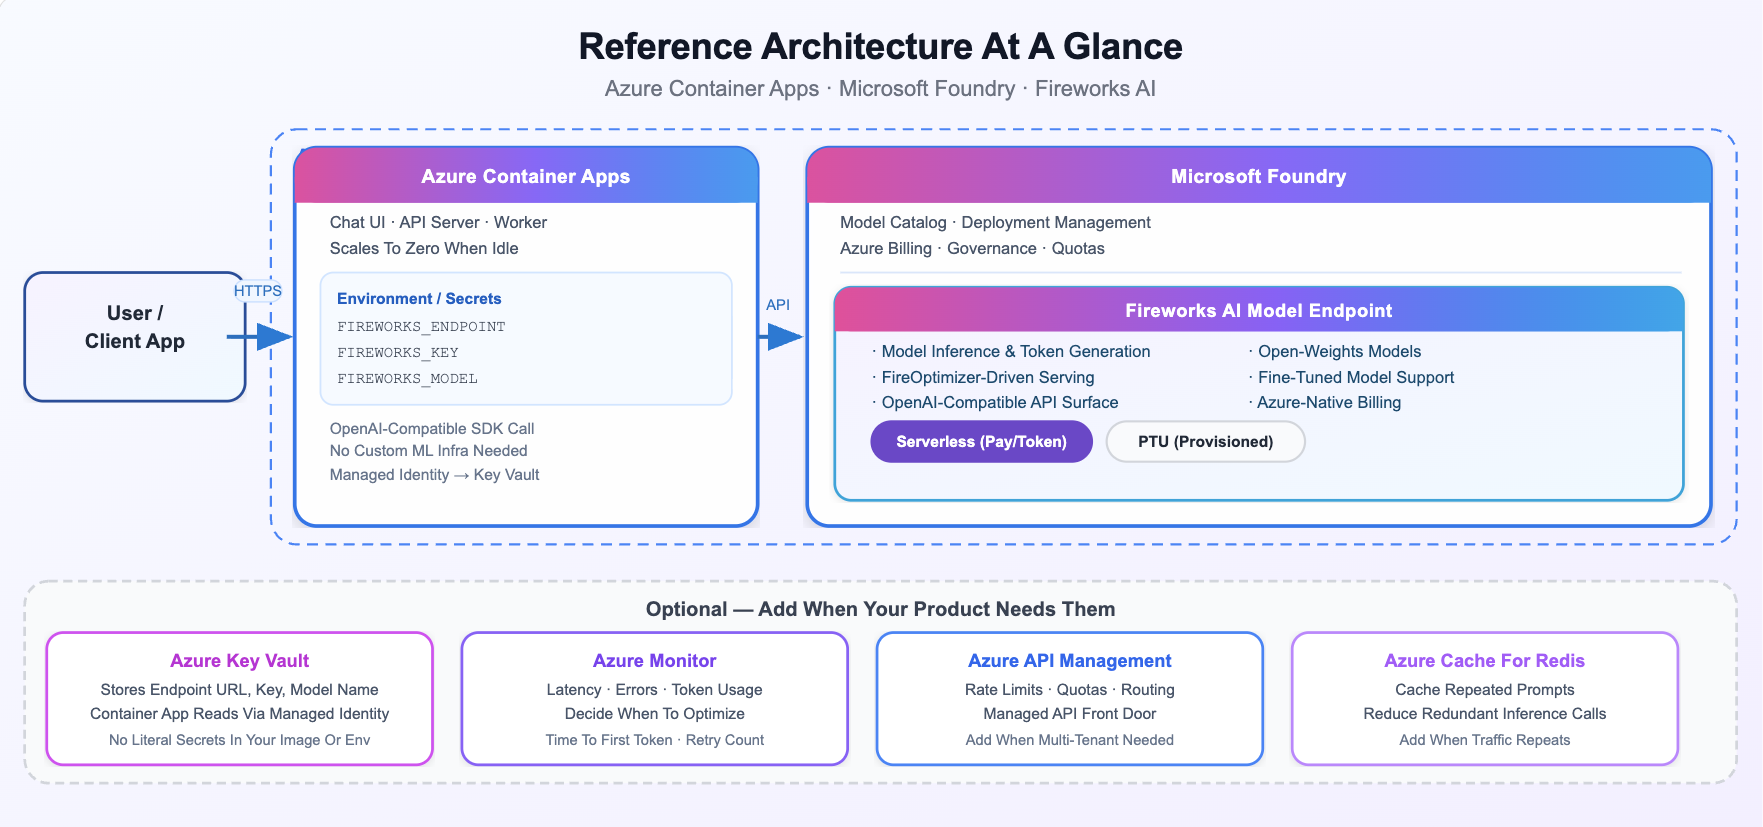
Die Architektur beginnt absichtlich klein und erweitert sich nur, wenn Anforderungen entstehen.
Components
| Component | Purpose |
|---|---|
| Azure Container Apps | Hosten der Anwendung oder API, die Rückschlussanforderungen sendet |
| Microsoft Foundry + Fireworks AI Modelle | Bietet Modellbereitstellung, Governance, Abrechnung und Inferenz. |
| Azure Container Registry | Speichert Containerimages |
| Verwaltung von Geheimnissen | Speichert Anmeldeinformationen und Endpunktinformationen sicher |
| Azure Monitor (optional) | Bietet Einblicke in die Beobachtbarkeit und Leistung |
Was Sie erstellen
- Eine über Microsoft Foundry gehostete Fireworks-Bereitstellung
- Eine containerisierte Anwendung, die die Bereitstellung aufruft
- Containerimagespeicher
- Eine Azure Container Apps Bereitstellung
- Sicherer Zugriff auf Bereitstellungsanmeldeinformationen
- Grundlegende Beobachtbarkeit und Validierung
Bevor Sie anfangen
Sie benötigen:
- Ein Azure-Abonnement
- Ein Microsoft Foundry-Projekt
- Berechtigungen für die Bereitstellung von Modellen in Foundry
- Berechtigungen zum Erstellen von Container-Apps-Ressourcen
- Berechtigungen zum Erstellen oder Verwenden von Azure Container Registry
Bereitstellungsworkflow
Schritt 1: Bereitstellen eines Feuerwerksmodells
- Erstellen oder Öffnen eines Microsoft Foundry-Projekts.
- Durchsuchen Sie den Modellkatalog, und wählen Sie ein Modell aus, das von Fireworks AI veröffentlicht wurde (Suchmodelle beginnend mit FW oder Durchsuchen nach Sammlung).
- Wählen Sie eine Bereitstellungsoption aus, die für Ihre Workload geeignet ist.
- Stellen Sie das Modell bereit, und notieren Sie die Bereitstellungsdetails.
Schritt 2: Sichere Bereitstellungseinstellungen
Ihre Anwendung erfordert Zugriff auf:
- Informationen zum Bereitstellungsendpunkt
- Anmeldeinformationen für Bereitstellung
- Bereitstellungsname
Bei Prototypen sind geheime Schlüssel auf Anwendungsebene möglicherweise ausreichend. Berücksichtigen Sie für Produktionsworkloads die verwaltete Identität und Azure Key Vault.
Schritt 3: Verbinden Ihrer Anwendung
Fireworks-Bereitstellungen stellen einen standardbasierten Inferenzendpunkt bereit, den Sie mit unterstützten SDKs aufrufen können. Anwendungen bieten in der Regel Folgendes:
- Endpunktstandort
- Authentifizierungsdaten
- Bereitstellungsname
- Anforderungsparameter
Tip
Vollständige Beispiele in Python und Azure Container Apps finden Sie im Begleit-GitHub Repository mit vollständigen Codebeispielen.
Schritt 4: Bereitstellen der Anwendung
Der einfachste Bereitstellungspfad ist:
- Containerisieren Sie die Anwendung.
- Speichern Sie das Bild in Azure Container Registry.
- Stellen Sie das Image für Azure Container Apps bereit.
- Konfigurieren Sie Secrets und Umgebungseinstellungen.
- Überprüfen Sie die Verbindung.
Messen vor dem Hinzufügen von Komplexität
Erfassen Sie einen kleinen Satz von Metriken, bevor Sie zusätzliche Komponenten einführen:
- Zeit bis zum ersten Token
- Gesamtantwortlatenz
- Anforderungsvolumen
- Fehlerrate
- Wiederholungsrate
- Tokenverbrauch
- Geschätzte Kosten pro Anforderung
- Nutzungsmuster für die Bereitstellung
Verwenden Sie diese Messungen, um zu bestimmen, welche architektonischen Verbesserungen tatsächlich erforderlich sind.
Hinzufügen von Produktionskomponenten nur bei Bedarf
| Wenn Sie etwas benötigen... | Hinzufügen... |
|---|---|
| Mandantenratenbegrenzung und API-Governance | Azure API Management |
| Wiederholte Eingabeaufforderungen und Zwischenspeichern | Azure Managed Redis |
| Benutzer- und Anwendungsstatus | Azure Database for PostgreSQL oder Azure Cosmos DB |
| Dateispeicherung | Azure Blob Storage |
| Hintergrundverarbeitung | Azure Service Bus |
| Netzwerksteuerungen für Unternehmen | Private Endpunkte und virtuelle Netzwerke |
Nächste Schritte
- Stellen Sie ein Feuerwerksmodell in Microsoft Foundry bereit.
- Überprüfen Sie die Begleitimplementierung GitHub.
- Fügen Sie Monitoring und Observability hinzu.
- Führen Sie nach Bedarf Persistenz und Zwischenspeichern ein.
- Bewerten Sie API-Management und Netzwerkisolation für Produktionsworkloads.