Σημείωμα
Η πρόσβαση σε αυτήν τη σελίδα απαιτεί εξουσιοδότηση. Μπορείτε να δοκιμάσετε να εισέλθετε ή να αλλάξετε καταλόγους.
Η πρόσβαση σε αυτήν τη σελίδα απαιτεί εξουσιοδότηση. Μπορείτε να δοκιμάσετε να αλλάξετε καταλόγους.
Αυτό το άρθρο σάς δείχνει πώς μπορείτε να δημιουργήσετε ένα μοντέλο εκμάθησης μηχανής με το SynapseML σε ένα σημειωματάριο Microsoft Fabric. Μπορείτε να δημιουργήσετε μια διοχέτευση εκπαίδευσης που χρησιμοποιεί χαρακτηριστικά κειμένου και παλινδρόμηση LightGBM για να προβλέψει τις αξιολογήσεις βιβλίων από το κείμενο αναθεώρησης. Μαθαίνετε επίσης πώς να χρησιμοποιείτε τα Foundry Tools για προκατασκευασμένη ανάλυση συναισθήματος.
- Δημιουργία σημειωματαρίου Fabric και επισύναψη lakehouse
- Εισαγωγή βιβλιοθηκών και φόρτωση δεδομένων
- Δημιουργήστε και εκπαιδεύστε μια διοχέτευση δόμησης κειμένου και παλινδρόμησης LightGBM
- Δημιουργήστε προβλέψεις
- (Προαιρετικός) Εκτέλεση ανάλυσης συναισθήματος Foundry Tools
Προαπαιτούμενα στοιχεία
Λάβετε μια συνδρομή Microsoft Fabric. Εναλλακτικά, εγγραφείτε για μια δωρεάν δοκιμαστική έκδοση του Microsoft Fabric.
Εισέλθετε στο Microsoft Fabric.
Μεταβείτε στο Fabric χρησιμοποιώντας την εναλλαγή εμπειριών στην κάτω αριστερή πλευρά της αρχικής σελίδας σας.
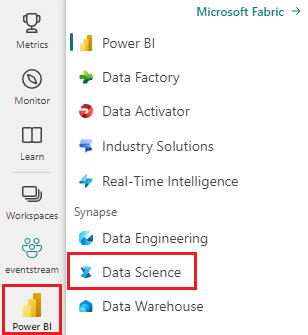
- Δημιουργήστε ένα νέο σημειωματάριο στον χώρο εργασίας Fabric.
- Συνδέστε ένα lakehouse στο σημειωματάριο. Στο τμήμα παραθύρου Εξερεύνηση , αναπτύξτε το στοιχείο Lakehouses και, στη συνέχεια, επιλέξτε Προσθήκη.
- (Προαιρετικός) Για να εκτελέσετε το βήμα ανάλυσης συναισθήματος, χρειάζεστε:
- Ένα κλειδί Foundry Tools. Ακολουθήστε τις οδηγίες στη Γρήγορη εκκίνηση: Δημιουργήστε έναν πόρο πολλαπλών υπηρεσιών για το Foundry Tools.
- Μια παρουσία Azure Key Vault με το κλειδί Foundry Tools αποθηκευμένο ως μυστικό.
Ρύθμιση του περιβάλλοντος
Στο σημειωματάριό σας, εισαγάγετε βιβλιοθήκες SynapseML και προετοιμάστε την περίοδο λειτουργίας Spark.
from pyspark.sql import SparkSession
from synapse.ml.core.platform import *

spark = SparkSession.builder.getOrCreate()
Επαλήθευση: Εκτελέστε το ακόλουθο κελί για να επιβεβαιώσετε ότι το Spark εκτελείται:
print(f"Spark version: {spark.version}")
Η έξοδος εμφανίζει τον αριθμό έκδοσης Spark. Αναμένεται οποιαδήποτε έκδοση 3.4 ή νεότερη. Η ακριβής έκδοση εξαρτάται από το χρόνο εκτέλεσης του Fabric.
Φόρτωση συνόλου δεδομένων
Φορτώστε το σύνολο δεδομένων κριτικών βιβλίων και χωρίστε το σε σύνολα εκπαίδευσης και δοκιμών. Το σύνολο δεδομένων περιέχει δύο στήλες: rating (ακέραιος αριθμός 1-5) και text (αναθεώρηση περιεχομένου).
train, test = (
    spark.read.parquet(
        "wasbs://publicwasb@mmlspark.blob.core.windows.net/BookReviewsFromAmazon10K.parquet"
    )
    .limit(1000)
    .cache()
    .randomSplit([0.8, 0.2])
)

display(train)
Επαλήθευση: Εκτελέστε το ακόλουθο κελί για να επιβεβαιώσετε ότι τα δεδομένα φορτώθηκαν σωστά:
print(f"Training rows: {train.count()}, Test rows: {test.count()}")
print(f"Columns: {train.columns}")
train.printSchema()
Η έξοδος δείχνει περίπου 800 σειρές εκπαίδευσης και 200 δοκιμαστικές σειρές, με δύο στήλες: rating (ακέραιος) και text (συμβολοσειρά). Ο ακριβής αριθμός σειρών ποικίλλει επειδή randomSplit δεν είναι ντετερμινιστικός.
Δημιουργία της διοχέτευσης εκπαίδευσης
Δημιουργήστε μια διοχέτευση που περιλαμβάνει το κείμενο της κριτικής με TextFeaturizer και προβλέπει την αξιολόγηση με LightGBMRegressor.
from pyspark.ml import Pipeline
from synapse.ml.featurize.text import TextFeaturizer
from synapse.ml.lightgbm import LightGBMRegressor

model = Pipeline(
    stages=[
        TextFeaturizer(inputCol="text", outputCol="features"),
        LightGBMRegressor(featuresCol="features", labelCol="rating", dataTransferMode="bulk")
    ]
).fit(train)
Επαλήθευση: Εκτελέστε το ακόλουθο κελί για να επιβεβαιώσετε ότι η διοχέτευση εκπαιδεύτηκε:
print(f"Pipeline stages: {len(model.stages)}")
print(f"Stage 1: {type(model.stages[0]).__name__}")
print(f"Stage 2: {type(model.stages[1]).__name__}")
Η έξοδος δείχνει δύο στάδια διοχέτευσης: TextFeaturizerModel και LightGBMRegressionModel.
Πρόβλεψη της εξόδου των δεδομένων δοκιμής
Καλέστε τη transform μέθοδο στο μοντέλο για να προβλέψετε τις αξιολογήσεις για τα δεδομένα δοκιμής και να εμφανίσετε τα αποτελέσματα.
predictions = model.transform(test)
display(predictions)
Επαλήθευση: Εκτελέστε το ακόλουθο κελί για να επιβεβαιώσετε ότι δημιουργήθηκαν προβλέψεις:
print(f"Prediction columns: {predictions.columns}")
print(f"Prediction count: {predictions.count()}")
predictions.select("rating", "prediction").show(5)
Η έξοδος παραθέτει τέσσερις στήλες (rating, text, features, prediction) και περίπου 200 γραμμές. Η prediction στήλη περιέχει την προβλεπόμενη αξιολόγηση του μοντέλου ως float. Συγκρίνετε το με την πραγματική rating στήλη για να αξιολογήσετε την απόδοση του μοντέλου.
(Προαιρετικός) Χρήση εργαλείων χυτηρίου για ανάλυση συναισθήματος
Εάν θέλετε να αναλύσετε το συναίσθημα των κριτικών βιβλίων σας, μπορείτε να χρησιμοποιήσετε την ενσωμάτωση του SynapseML με το Foundry Tools. Αυτό το βήμα χρησιμοποιεί το προκατασκευασμένο TextSentiment μοντέλο για την ταξινόμηση του συναισθήματος κειμένου, η οποία είναι διαφορετική εργασία από την πρόβλεψη αξιολόγησης στα προηγούμενα βήματα.
Σημαντικό
Αυτό το βήμα απαιτεί ένα κλειδί Foundry Tools που είναι αποθηκευμένο στο Azure Key Vault. Εάν παραλείψατε αυτές τις προϋποθέσεις, συμπληρώστε τις πρώτα ή παραλείψτε αυτήν την ενότητα.
Εκτελέστε τον ακόλουθο κώδικα με αυτές τις αντικαταστάσεις:
- Αντικαταστήστε το
<your-secret-name>με το όνομα του μυστικού κλειδιού του Foundry Tools στο Key Vault. - Αντικαταστήστε το
<your-key-vault-name>με το όνομα της Azure Key Vault σας παρουσίας.
from synapse.ml.services import TextSentiment
from synapse.ml.core.platform import find_secret

sentiment_model = TextSentiment(
    textCol="text",
    outputCol="sentiment",
    subscriptionKey=find_secret("<your-secret-name>", "<your-key-vault-name>")
).setLocation("eastus")

sentiment_results = sentiment_model.transform(test)
display(sentiment_results)
Σημείωση
Ενημερώστε την τιμή setLocation εάν ο πόρος Foundry Tools βρίσκεται σε διαφορετική περιοχή Azure (για παράδειγμα, "westus2" ή "westeurope").
Επαλήθευση: Εκτελέστε το ακόλουθο κελί για να επιβεβαιώσετε ότι η ανάλυση συναισθήματος ολοκληρώθηκε:
print(f"Sentiment columns: {sentiment_results.columns}")
sentiment_results.select("text", "sentiment").show(3, truncate=50)
Η έξοδος εμφανίζει τρεις στήλες (rating, text, sentiment). Η sentiment στήλη περιέχει δομημένα αποτελέσματα με ετικέτες όπως positive, negative, neutralή mixed για κάθε κριτική.
Αντιμετώπιση προβλημάτων
| Ζήτημα | Αιτία | Επίλυση |
|---|---|---|
JAVA_GATEWAY_EXITED σφάλμα κατά τη δημιουργία του SparkSession |
Εκτέλεση κώδικα εκτός σημειωματαρίου Fabric | Εκτελέστε αυτόν τον κώδικα σε ένα σημειωματάριο Fabric όπου το Spark είναι προρυθμισμένο. Μην εκτελείτε τοπικά χωρίς εγκατάσταση Spark. |
Could not find <secret> in keyvault <vault> |
Το όνομα ή το μυστικό όνομα του Key Vault είναι λανθασμένο ή η ταυτότητα του σημειωματαρίου δεν έχει πρόσβαση | Επαληθεύστε ότι τα ονόματα ταιριάζουν ακριβώς. Στην πύλη Azure, επιβεβαιώστε ότι η ταυτότητα του χώρου εργασίας Fabric έχει δικαίωμα Get για Key Vault μυστικούς κωδικούς. |
TextFeaturizer επιστρέφει κενά χαρακτηριστικά |
Η στήλη κειμένου εισαγωγής είναι null ή κενή | Ελέγξτε για μηδενικές τιμές: train.filter(train.text.isNull()).count() - Αφαιρέστε τα μηδενικά πριν από την προπόνηση. |
randomSplit επιστρέφει μη αναμενόμενο πλήθος γραμμών |
Ο τυχαίος διαχωρισμός του Spark είναι μη ντετερμινιστικός | Αυτή είναι η αναμενόμενη συμπεριφορά. Ορίστε έναν σπόρο για την αναπαραγωγιμότητα: .randomSplit([0.8, 0.2], seed=42) |
AnalysisException: Path does not exist |
Πρόβλημα δικτύου με πρόσβαση στο δείγμα blob δεδομένων | Επαληθεύστε τη συνδεσιμότητα δικτύου. Στο Fabric, επιβεβαιώστε ότι ο χώρος εργασίας σας μπορεί να έχει πρόσβαση σε εξωτερικές διευθύνσεις URL του Azure Blob Storage. |
| Το Foundry Tools επιστρέφει 401 ή 403 | Μη έγκυρο ή ληγμένο κλειδί συνδρομής | Δημιουργήστε ένα νέο κλειδί στην πύλη Azure στην ενότητα πόρων Foundry Tools Keys and Endpoint. Ενημερώστε τον μυστικό κωδικό Key Vault. |
setLocation επιστρέφει 404 |
Αναντιστοιχία περιοχής | Ορίστε τη θέση ώστε να ταιριάζει με την περιοχή Azure όπου δημιουργήσατε τον πόρο Foundry Tools. |
Εκκαθάριση των πόρων
Εάν δημιουργήσατε πόρους Azure για το προαιρετικό βήμα Foundry Tools και δεν τους χρειάζεστε πλέον, διαγράψτε τους για να αποφύγετε χρεώσεις:
- Στην πύλη Azure, διαγράψτε τον πόρο πολλαπλών υπηρεσιών Foundry Tools.
- Στην πύλη Azure, διαγράψτε την παρουσία Key Vault.
- Στον χώρο εργασίας Fabric, διαγράψτε το δοκιμαστικό σημειωματάριο εάν δεν το χρειάζεστε πλέον.