Σημείωμα
Η πρόσβαση σε αυτήν τη σελίδα απαιτεί εξουσιοδότηση. Μπορείτε να δοκιμάσετε να εισέλθετε ή να αλλάξετε καταλόγους.
Η πρόσβαση σε αυτήν τη σελίδα απαιτεί εξουσιοδότηση. Μπορείτε να δοκιμάσετε να αλλάξετε καταλόγους.
Ισχύει για:✅ Τελικό σημείο ανάλυσης SQL και Αποθήκη στο Microsoft Fabric
Σημαντικό
Αυτή η δυνατότητα βρίσκεται προεπισκόπηση.
Η δημιουργία συμπλεγμάτων δεδομένων στο Fabric αποθήκη δεδομένων οργανώνει δεδομένα για ταχύτερη απόδοση ερωτημάτων και μειωμένη χρήση υπολογιστών. Αυτό το εκπαιδευτικό βοήθημα περιγράφει τα βήματα για τη δημιουργία πινάκων με ομαδοποίηση δεδομένων, από τη δημιουργία ομαδοποιημένων πινάκων έως τον έλεγχο της αποτελεσματικότητάς τους.
Προαπαιτούμενα στοιχεία
- Ένας λογαριασμός μισθωτή Microsoft Fabric με ενεργή συνδρομή.
- Βεβαιωθείτε ότι έχετε έναν χώρο εργασίας με δυνατότητα Microsoft Fabric: Δημιουργήστε έναν χώρο εργασίας.
- Βεβαιωθείτε ότι έχετε ήδη δημιουργήσει μια Αποθήκη. Για να δημιουργήσετε μια νέα αποθήκη, ανατρέξτε στην ενότητα Δημιουργία αποθήκης στο Microsoft Fabric.
- Βασική κατανόηση της T-SQL και αναζήτηση δεδομένων.
Εισαγωγή δείγματος δεδομένων
Αυτό το εκπαιδευτικό βοήθημα χρησιμοποιεί το σύνολο δειγμάτων δεδομένων NY Taxi. Για να εισαγάγετε τα δεδομένα ταξί της Νέας Υόρκης στην αποθήκη σας. Χρησιμοποιήστε το εκπαιδευτικό πρόγραμμα εκμάθησης Φόρτωση δείγματος δεδομένων στην αποθήκη δεδομένων .
Δημιουργία πίνακα με ομαδοποίηση δεδομένων
Για αυτό το σεμινάριο, χρειαζόμαστε δύο αντίγραφα του πίνακα NYTaxi: το κανονικό αντίγραφο του πίνακα όπως εισάγεται από το σεμινάριο και ένα αντίγραφο που χρησιμοποιεί ομαδοποίηση δεδομένων. Χρησιμοποιήστε την ακόλουθη εντολή για να δημιουργήσετε έναν νέο πίνακα χρησιμοποιώντας CREATE TABLE AS SELECT το (CTAS), με βάση τον αρχικό πίνακα NYTaxi:
CREATE TABLE nyctlc_With_DataClustering
WITH (CLUSTER BY (lpepPickupDatetime))
AS SELECT * FROM nyctlc
Σημείωμα
Το παράδειγμα προϋποθέτει το όνομα του πίνακα που δίνεται στο σύνολο δεδομένων NY Taxi στο πρόγραμμα εκμάθησης Φόρτωση δείγματος δεδομένων στην αποθήκη δεδομένων. Εάν χρησιμοποιήσατε διαφορετικό όνομα για τον πίνακά σας, προσαρμόστε την εντολή για αντικατάσταση nyctlc με το όνομα του πίνακα.
Αυτή η εντολή δημιουργεί ένα ακριβές αντίγραφο του αρχικού πίνακα NYTaxi, αλλά με ομαδοποίηση δεδομένων στη lpepPickupDatetime στήλη. Στη συνέχεια, χρησιμοποιούμε αυτήν τη στήλη για την υποβολή ερωτημάτων.
Ερώτημα δεδομένων
Εκτελέστε ένα ερώτημα στον πίνακα NYTaxi και επαναλάβετε το ίδιο ακριβώς ερώτημα στον πίνακα NYTaxi_With_DataClustering για σύγκριση.
Σημείωμα
Για αυτήν την ανάλυση, είναι ωφέλιμο να εξετάσετε την απόδοση του ψυχρού cache και των δύο εκτελέσεων – δηλαδή, χωρίς να χρησιμοποιήσετε τις δυνατότητες προσωρινής αποθήκευσης του Fabric αποθήκη δεδομένων. Επομένως, εκτελέστε κάθε ερώτημα ακριβώς μία φορά πριν δείτε τα αποτελέσματα στις Πληροφορίες ερωτήματος.
Χρησιμοποιούμε ένα ερώτημα που επαναλαμβάνεται συχνά στην Αποθήκη. Αυτό το ερώτημα υπολογίζει το μέσο ποσό ναύλου ανά έτος μεταξύ των ημερομηνιών 2008-12-31 και 2014-06-30:
SELECT
    YEAR(lpepPickupDatetime),
    AVG(fareAmount) as [Average Fare]
FROM
    NYTaxi
WHERE
    lpepPickupDatetime BETWEEN '2008-12-31' AND '2014-06-30'
GROUP BY
    YEAR(lpepPickupDatetime)
ORDER BY
    YEAR(lpepPickupDatetime) DESC
OPTION (LABEL = 'Regular');
Σημείωμα
Η επιλογή ετικέτας που χρησιμοποιείται σε αυτό το ερώτημα είναι χρήσιμη όταν συγκρίνουμε τις λεπτομέρειες ερωτήματος του Regular πίνακα με αυτόν που χρησιμοποιεί τη δημιουργία συμπλεγμάτων δεδομένων αργότερα χρησιμοποιώντας προβολές πληροφοριών ερωτήματος.
Στη συνέχεια, επαναλαμβάνουμε το ίδιο ακριβώς ερώτημα, αλλά στην έκδοση του πίνακα που χρησιμοποιεί ομαδοποίηση δεδομένων:
SELECT
    YEAR(lpepPickupDatetime),
    AVG(fareAmount) as [Average Fare]
FROM
    NYTaxi_With_DataClustering
WHERE
    lpepPickupDatetime BETWEEN '2008-12-31' AND '2014-06-30'
GROUP BY
    YEAR(lpepPickupDatetime)
ORDER BY
    YEAR(lpepPickupDatetime) DESC
OPTION (LABEL = 'Clustered');
Το δεύτερο ερώτημα χρησιμοποιεί την ετικέτα Clustered για να μας επιτρέψει να προσδιορίσουμε αυτό το ερώτημα αργότερα με τις Πληροφορίες ερωτήματος.
Ελέγξτε την αποτελεσματικότητα της ομαδοποίησης δεδομένων
Μετά τη ρύθμιση της ομαδοποίησης, μπορείτε να αξιολογήσετε την αποτελεσματικότητά της χρησιμοποιώντας το Query Insights. Το Query Insights στο Fabric αποθήκη δεδομένων καταγράφει ιστορικά δεδομένα εκτέλεσης ερωτημάτων και τα συγκεντρώνει σε χρήσιμες πληροφορίες, όπως ο εντοπισμός ερωτημάτων μεγάλης διάρκειας ή συχνά εκτελούμενων.
Σε αυτήν την περίπτωση, χρησιμοποιούμε το Query Insights για να συγκρίνουμε τη διαφορά στα δεδομένα που σαρώνονται μεταξύ των κανονικών και των ομαδοποιημένων υποθέσεων.
Χρησιμοποιήστε το παρακάτω ερώτημα:
SELECT
    label,
    submit_time,
    row_count,
    total_elapsed_time_ms,
    allocated_cpu_time_ms,
    result_cache_hit,
    data_scanned_disk_mb,
    data_scanned_memory_mb,
    data_scanned_remote_storage_mb,
    command
FROM
    queryinsights.exec_requests_history
WHERE
    command LIKE '%NYTaxi%'
    AND label IN ('Regular','Clustered')
ORDER BY
    submit_time DESC;
Αυτό το ερώτημα λαμβάνει λεπτομέρειες από την exec_requests_history προβολή. Για περισσότερες πληροφορίες, δείτε queryinsights.exec_requests_history (Transact-SQL).
Το ερώτημα φιλτράρει τα αποτελέσματα με τους ακόλουθους τρόπους:
- Ανακτά μόνο τις σειρές που περιέχουν το
NYTaxiκείμενο στο όνομα της εντολής (όπως χρησιμοποιήθηκε στα ερωτήματα δοκιμής) - Ανακτά μόνο σειρές όπου η τιμή της ετικέτας ήταν είτε κανονική είτε ομαδοποιημένη
Σημείωμα
Μπορεί να χρειαστούν μερικά λεπτά για να γίνουν διαθέσιμες οι λεπτομέρειες του ερωτήματός σας στις Πληροφορίες ερωτήματος. Εάν το ερώτημά σας στο Query Insights δεν επιστρέψει αποτελέσματα, δοκιμάστε ξανά μετά από λίγα λεπτά.
Εκτελώντας αυτό το ερώτημα, παρατηρούμε τα ακόλουθα αποτελέσματα:

Και τα δύο ερωτήματα έχουν πλήθος σειρών 6 και παρόμοιους χρόνους υποβολής. Το Clustered ερώτημα δείχνει total_elapsed_time_ms του 1794, allocated_cpu_time_ms του 1676 και data_scanned_remote_storage_mb του 77.519. Το Regular ερώτημα δείχνει total_elapsed_time_ms 2651, allocated_cpu_time_ms 2600 και data_scanned_remote_storage_mb 177.700. Αυτοί οι αριθμοί δείχνουν ότι παρόλο που και τα δύο ερωτήματα επέστρεψαν τα ίδια αποτελέσματα, η Clustered έκδοση χρησιμοποίησε περίπου 36% λιγότερο χρόνο CPU από την Regular έκδοση και σάρωσε περίπου 56% λιγότερα δεδομένα στο δίσκο. Δεν χρησιμοποιήθηκε κρυφή μνήμη σε καμία από τις δύο εκτελέσεις ερωτημάτων. Αυτά είναι σημαντικά αποτελέσματα που συμβάλλουν στη μείωση του χρόνου εκτέλεσης ερωτημάτων και της χρήσης κατανάλωσης και καθιστούν τη lpepPickupDatetime στήλη ισχυρή υποψήφια για ομαδοποίηση δεδομένων.
Σημείωμα
Αυτός είναι ένας μικρός πίνακας, με περίπου 76 εκατομμύρια σειρές και 2 GB όγκου δεδομένων. Παρόλο που αυτό το ερώτημα επιστρέφει μόνο έξι γραμμές στη συνάθροισή του (μία για κάθε έτος στην περιοχή), σαρώνει περίπου 8,3 εκατομμύρια γραμμές στην περιοχή ημερομηνιών που παρέχεται πριν από τη συγκέντρωση των αποτελεσμάτων. Τα πραγματικά δεδομένα παραγωγής με μεγαλύτερους όγκους δεδομένων μπορούν να προσφέρουν πιο σημαντικά αποτελέσματα. Τα αποτελέσματά σας ενδέχεται να διαφέρουν ανάλογα με το μέγεθος των εκχωρημένων πόρων, τα προσωρινά αποθηκευμένα αποτελέσματα ή τη ταυτόχρονη εκτέλεση κατά τη διάρκεια των ερωτημάτων.
Επιλογή στηλών ομαδοποίησης από τον φόρτο εργασίας σας
Για πίνακες παραγωγής, χρησιμοποιήστε παρατηρούμενα μοτίβα ερωτημάτων αντί να μαντέψετε ποιες στήλες θα ομαδοποιηθούν. Η δυνατότητα λειτουργιών της sqldw-cli δεξιότητας αναλύει το ιστορικό Query Insights, κατατάσσει τα επαναλαμβανόμενα μοτίβα ερωτημάτων κατά απομακρυσμένα δεδομένα που σαρώνονται και προσδιορίζει στήλες που χρησιμοποιούνται σε WHERE κατηγορήματα.
Πριν ξεκινήσετε, εγκαταστήστε το Skills for Fabric, βεβαιωθείτε ότι η αποθήκη έχει πρόσφατη δραστηριότητα ερωτημάτων και επιβεβαιώστε ότι έχετε ρόλο χώρου εργασίας Συμβάλλοντα ή ανώτερο. Στη συνέχεια, ανοίξτε το GitHub Copilot CLI και χρησιμοποιήστε μια προτροπή όπως αυτή:
Use the sqldw-cli skill to recommend clustering columns for
<workspace-name>/<warehouse-name> based on the last seven days of workload.
Rank candidates by total remote data scanned, consider columns used in WHERE
predicates, and explain each column's cardinality and data type suitability.
Use read-only diagnostics.
Η ικανότητα προσδιορίζει τα μοτίβα ερωτημάτων με τον μεγαλύτερο αντίκτυπο σάρωσης, εξάγει τους πίνακες και τις στήλες φίλτρου από αυτά τα ερωτήματα και κατατάσσει τους υποψηφίους ομαδοποίησης. Διαβάστε τις συστάσεις με αυτές τις οδηγίες:
- Προτιμήστε στήλες που φιλτράρουν επανειλημμένα μεγάλους πίνακες και χρησιμοποιούν τιμές πληθικότητας από μέση προς υψηλή, όπως ημερομηνίες ή αναγνωριστικά.
- Υπέρ στηλών που χρησιμοποιούνται σε κατηγορήματα επιλεκτικής περιοχής ή ισότητας στην
WHEREπρόταση. - Μην επιλέγετε στήλες μόνο επειδή εμφανίζονται σε συνθήκες σύνδεσης ισότητας. Αυτές οι συνθήκες δεν επωφελούνται από την ομαδοποίηση δεδομένων.
- Μην χρησιμοποιείτε περισσότερες από τέσσερις στήλες συμπλέγματος και μην προσθέτετε περισσότερες στήλες από όσες απαιτεί ο φόρτος εργασίας.
Για παράδειγμα, σκεφτείτε μια αποθήκη ηλεκτρονικού εμπορίου όπου Sales.SalesOrder περιέχει 1.5 δισεκατομμύρια σειρές και Sales.OrderLine περιέχει 6 δισεκατομμύρια σειρές. Μετά την ανάλυση επαναλαμβανόμενων ερωτημάτων, η δεξιότητα μπορεί να επιστρέψει αυτές τις συστάσεις:
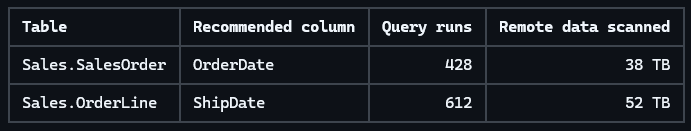
Οι στήλες ημερομηνίας είναι ισχυρές υποψήφιες επειδή φιλτράρουν τους μεγαλύτερους πίνακες, υποστηρίζουν κοινά κατηγορήματα περιοχής και παρέχουν περισσότερες ευκαιρίες παράβλεψης αρχείων από τις στήλες χαμηλής πληθικότητας, όπως OrderStatus ή SalesRegion.
Η sqldw-cli δυνατότητα λειτουργιών είναι μόνο για ανάγνωση. Προτείνει στήλες, αλλά δεν δημιουργεί ούτε αντικαθιστά πίνακες. Αφού εξετάσετε τη σύσταση, χρησιμοποιήστε το CTAS για να δημιουργήσετε ένα ομαδοποιημένο αντίγραφο του πίνακα:
CREATE TABLE Sales.SalesOrder_clustered
WITH (CLUSTER BY (OrderDate))
AS
SELECT * FROM Sales.SalesOrder;
Συγκρίνετε τους φόρτους εργασίας συμπλέγματος και μη συμπλέγματος για να επαληθεύσετε το αποτέλεσμα. Αφού επικυρώσετε τον ομαδοποιημένο πίνακα, μετονομάστε τον αρχικό πίνακα και, στη συνέχεια, μετονομάστε τον ομαδοποιημένο πίνακα στο αρχικό όνομα:
EXEC sp_rename 'Sales.SalesOrder', 'SalesOrder_old';
EXEC sp_rename 'Sales.SalesOrder_clustered', 'SalesOrder';
Ο αρχικός πίνακας παραμένει διαθέσιμος όσον Sales.SalesOrder_old αφορά την επαναφορά. Επαληθεύστε τους εξαρτώμενους φόρτους εργασίας και τον νέο πίνακα πριν καταργήσετε τον αρχικό πίνακα. Όταν δεν χρειάζεστε πλέον το αντίγραφο επαναφοράς, αποθέστε το:
DROP TABLE Sales.SalesOrder_old;