Nota:
El acceso a esta página requiere autorización. Puede intentar iniciar sesión o cambiar directorios.
El acceso a esta página requiere autorización. Puede intentar cambiar los directorios.
Importante
Esta característica se encuentra en su versión beta.
La memoria gestionada de agentes proporciona a tus agentes una memoria duradera y a largo plazo que persiste en todas las conversaciones. Azure Databricks almacena la memoria en Lakebase y gestiona el almacenamiento, la indexación y la búsqueda semántica por ti, para que tus agentes puedan recordar las preferencias del usuario, decisiones pasadas y el contexto acumulado sin que uses una base de datos.
Note
Durante la vista previa, se te factura por la instancia subyacente de Lakebase que almacena tus entradas de memoria. No se aplican cargos adicionales a la memoria gestionada en sí. Los precios pueden cambiar a medida que avance la vista previa.
Utiliza memoria gestionada cuando quieras que tus agentes:
- Recuerda las preferencias, los hechos y las decisiones del usuario a lo largo de conversaciones distintas.
- Personaliza las respuestas basándose en lo que un agente ha aprendido en sesiones anteriores.
- Comparte el conocimiento acumulado entre agentes y proyectos.
- Mejorar la precisión y la eficacia a lo largo del tiempo.
La memoria gestionada funciona con agentes construidos sobre cualquier framework. Para un historial de conversaciones a corto plazo dentro de una sola interacción, utiliza sesiones de agentes gestionados.
Requirements
- Instala Python 3.10 o superior para usar el SDK AgentKit. AgentKit SDK es el cliente de Python de Databricks para APIs de agentes que utilizan los ejemplos siguientes. También puedes llamar a la API REST directamente desde cualquier lenguaje, sin necesidad de Python.
Funcionamiento de la memoria administrada
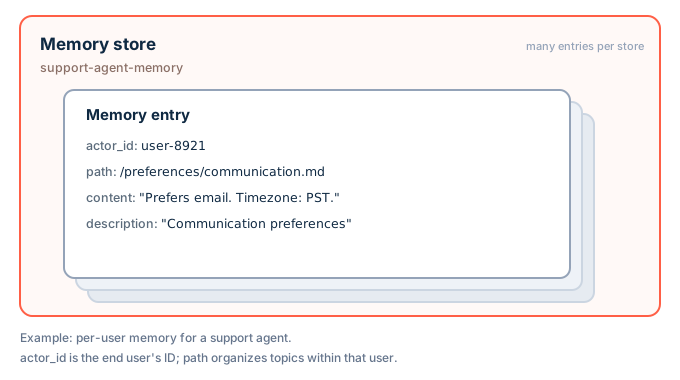
La memoria administrada tiene dos niveles:
- Un almacén de memorias es el contenedor, con ámbito de espacio de trabajo, para las memorias de un agente. Crear un almacén provisiona automáticamente el almacenamiento de respaldo de Lakebase. Identificas una tienda por su
display_name. - Una entrada de memoria es un contenido individual en un almacén. Cada entrada tiene un texto
contentlibre, un cortodescriptionusado para la recuperación y un conjunto de campos que la organizan y particionan:-
actor_id(requerido): a quién pertenece la memoria, como un usuario final u otro agente. -
session_id(opcional): registros de la sesión de la que se capturó la memoria, para rastreo y procedencia. Déjalo sin ajustar para la memoria que no esté ligada a una sesión específica. -
path(requerido): una ruta similar a un sistema de archivos que organiza las entradas dentro de un actor, como/preferences/response-style.md.
-
Una entrada se identifica de forma única por la combinación de actor_id, session_id, y path.
Recuperación
Recuperar la memoria de dos maneras:
-
Listas de entradas para un actor, opcionalmente filtradas por
session_ido unpathprefijo. Utilízalo para navegar o generar un índice de lo que sabe un agente. - Buscar las entradas de un actor con una consulta en lenguaje natural. La búsqueda devuelve las entradas más relevantes ordenadas por una puntuación de relevancia en texto completo (BM25).
Get started
Estos ejemplos configuran la memoria gestionada para un agente de soporte: crean un almacén de memoria, guardan la preferencia del usuario y la recuperan en una conversación posterior. Elige el cliente que se adapte a tu proyecto. El display_name de un almacén de memoria debe tener de 3 a 56 caracteres, empezar por una letra minúscula, terminar en una letra o un dígito y contener solo letras minúsculas, números y guiones.
AgentKit SDK
El SDK AgentKit es el cliente de Python de Databricks para APIs de agentes, distribuido en el databricks-agentbricks paquete. Se autentica con el WorkspaceClient del SDK de Databricks.
Instala el SDK AgentKit:
pip install databricks-agentbricksCrea un almacén de recuerdos para tu agente.
AgentKitClientAutentica con tusWorkspaceClientcredenciales:from databricks.sdk import WorkspaceClient from databricks_agentkit import AgentKitClient client = AgentKitClient(WorkspaceClient()) memory_store = client.memory_stores.create("support-agent-memory")Guarda un recuerdo después de que el agente aprenda algo duradero sobre un usuario.
actor_ides de quién es esta memoria,pathla organiza dentro de ese actor ydescriptionmejora la recuperación:memory_store.add( actor_id="user-123", path="/preferences/communication.md", content="Prefers email over phone. Timezone: PST. Enterprise subscription.", description="User 123 communication preferences", )Recuerda los recuerdos del usuario en una conversación posterior con una búsqueda en lenguaje natural:
results = memory_store.search(actor_id="user-123", query="communication preferences", limit=10)
API de REST
Los clientes invocan la API REST en /api/2.0/agents/memory-stores. Llámalo directamente para lenguajes distintos a Python.
Genera un token OAuth con la CLI de Databricks:
databricks auth login --host ${DATABRICKS_HOST}
export DATABRICKS_TOKEN=$(databricks auth token | jq -r .access_token)
Crea un almacén de recuerdos para tu agente:
curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \
  -d '{"display_name": "support-agent-memory", "description": "Support agent memory"}'
Guarda una entrada de memoria para un usuario.
actor_idindica de quién es esta memoria,pathla organiza ydescriptionmejora la recuperación:curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores/support-agent-memory/entries" \ -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \ -d '{"actor_id": "user-123", "path": "/preferences/communication.md", "content": "Prefers email over phone.", "description": "Communication preferences"}'Recuerda los recuerdos del usuario con una búsqueda en lenguaje natural:
curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores/support-agent-memory/entries:search" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \
  -d '{"actor_id": "user-123", "query": "communication preferences"}'
Dale a tu agente herramientas de memoria
Para que un agente decida cuándo guardar y recuperar la memoria, envuelve las operaciones del cliente como herramientas e indícale al agente cuándo debe usarlas en su mensaje del sistema. Establece el actor_id en el código de la aplicación de confianza a partir de la identidad verificada del usuario final. Nunca deje que el modelo elija qué memoria leer o escribir.
El siguiente ejemplo convierte el SDK de AgentKit memory_store de Comenzar en herramientas para el SDK de OpenAI Agents.
from agents import Agent, function_tool

def make_memory_tools(memory_store, actor_id: str):
    @function_tool
    def search_memory(query: str) -> str:
        """Search long-term memory for relevant facts about the user."""
        results = memory_store.search(actor_id=actor_id, query=query, limit=10)
        return "\n\n".join(f"{r.memory.path}: {r.memory.content}" for r in results) or "No memory found."

    @function_tool
    def save_memory(path: str, content: str, description: str = "") -> str:
        """Save a durable, long-term memory about the user."""
        memory_store.add(actor_id=actor_id, path=path, content=content, description=description)
        return f"Saved memory at {path}"

    return [search_memory, save_memory]

agent = Agent(
    name="Support agent",
    instructions="Save durable user preferences and recall them when relevant.",
    tools=make_memory_tools(memory_store, actor_id="user-123"),
)
El mismo patrón funciona con Claude Agent SDK y otros marcos: encapsule las operaciones de búsqueda y adición del almacén como herramientas del tipo que utiliza el marco.
Partición y memoria segura
Dentro de un almacén, actor_id es la forma de separar a quién pertenece cada memoria. Cada lista y búsqueda se limita a un solo actor_id, así que elige la estrategia que mejor se adapte a lo que tu agente necesita recordar:
-
Memoria privada para cada usuario: Establezca
actor_iden la identidad verificada del usuario final. Cada usuario recibe su propia partición, y el agente solo recupera las entradas de ese usuario.- Ejemplo: Un agente de soporte recuerda las preferencias de comunicación de un usuario y tickets anteriores.
-
Memoria compartida para un grupo: Establece
actor_iduna clave fija que elijas, como un ID de equipo, proyecto u organización. Todos leen y escriben los mismos recuerdos.- Ejemplo: Un agente de equipo recuerda un glosario compartido de términos de la empresa y convenciones internas.
-
Memoria segmentada según otro criterio: Crea
actor_ida partir de tus propios valores, como un identificador de inquilino o unuser:projectcompuesto.-
Ejemplo: Una aplicación multiinquilino establece
actor_iden{tenant}:{user}para que los usuarios de cada cliente permanezcan aislados entre sí.
-
Ejemplo: Una aplicación multiinquilino establece
Establece actor_id en el código de la aplicación en el contexto de un llamador de confianza: la identidad verificada del usuario final para la memoria por usuario, o una clave de confianza del equipo o del proyecto para la memoria compartida. Nunca dejes que el modelo lo eliga. Si tu estrategia depende de una identidad de usuario final, rechaza las solicitudes que no incluyan una en lugar de usar como alternativa un actor_id compartido.
Warning
actor_id separa las memorias, pero no es un mecanismo de control de acceso. Los almacenes de memoria gestionada están delimitados por espacio de trabajo, por lo que cualquier entidad que pueda acceder a un almacén puede leer y escribir todas las entradas de todos los actores. La tienda, no el actor, es el límite de seguridad. Para un aislamiento estricto entre inquilinos o usuarios, crea un almacén de memoria separado por cada frontera.
Para que otro principal, como el principal de servicio de tu agente, use una tienda, concédele acceso mediante la operación de conceder permisos de la tienda (memory_store.grant_permission(principal_id) en el SDK AgentKit).
Limitations
- La memoria gestionada proporciona solo memoria a largo plazo. Para el historial de conversaciones a corto plazo, consulta las sesiones de agentes gestionados.
- La búsqueda es una operación de texto completo (BM25) ordenada por relevancia que devuelve un conjunto de los N primeros resultados de hasta 100 entradas. No soporta paginación ni búsqueda por similitud vectorial.
- El control de acceso se aplica a nivel de tienda. No está disponible el control de acceso por entrada ni por actor.
- La tienda
display_namees inmutable tras la creación. Solodescriptionse puede actualizar.