Nota:
El acceso a esta página requiere autorización. Puede intentar iniciar sesión o cambiar directorios.
El acceso a esta página requiere autorización. Puede intentar cambiar los directorios.
Importante
Esta característica se encuentra en su versión beta.
Las sesiones gestionadas de agentes ofrecen a tus agentes un almacenamiento duradero y independiente del marco para el estado de sesión: el estado que un agente o marco mantiene para una interacción. Lo más común es el historial de conversaciones, la transcripción ordenada de mensajes, llamadas a herramientas y resultados que un agente lee al inicio de un turno y a los que añade a medida que se ejecuta. También puede ser cualquier otro estado en el que persista un marco para la interacción, como un grafo LangGraph. Azure Databricks lo almacena en Lakebase y gestiona el almacenamiento por ti, así que no construyes ni manejas la base de datos.
Note
Durante la vista previa, se te factura por la instancia subyacente de Lakebase que almacena tus sesiones. No se aplican cargos adicionales a las sesiones de agente administrado en sí mismas. Los precios pueden cambiar a medida que avance la vista previa.
Utiliza sesiones gestionadas cuando quieras:
- Guarda el historial de conversaciones de un agente para que se conserve tras los reinicios y pueda retomarse más adelante.
- Reconstruye el contexto completo (incluyendo llamadas a herramientas y razonamiento) en un mensaje de seguimiento.
- Enumera, reanuda y ramifica conversaciones anteriores desde tu propia interfaz.
Las sesiones gestionadas mantienen el estado de una única interacción (estado a corto plazo, en sesión). Para una memoria duradera y a largo plazo que persista en todas las conversaciones, utiliza memoria gestionada de agentes.
Requisitos
- Instala Python 3.10 o superior para usar el SDK AgentKit. AgentKit SDK es el cliente de Python de Databricks para APIs de agentes que utilizan los ejemplos siguientes. También puedes llamar a la API REST directamente desde cualquier lenguaje, sin necesidad de Python.
Cómo funcionan las sesiones gestionadas
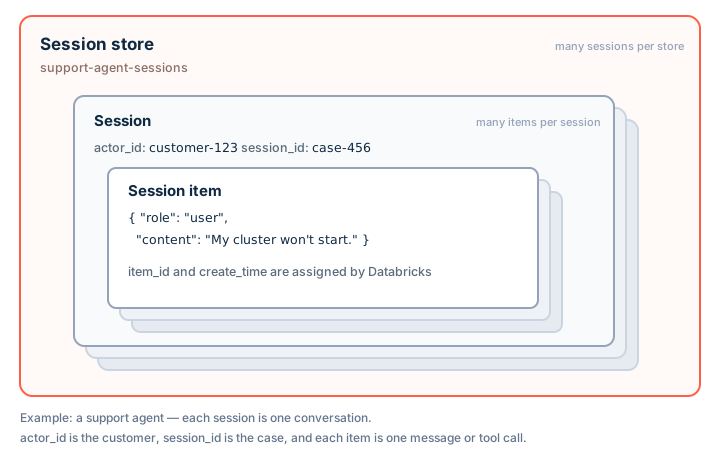
Las sesiones gestionadas tienen tres niveles:
- Un almacén de sesiones es el contenedor, con ámbito de espacio de trabajo, para las sesiones de un agente. Crear un almacén provisiona automáticamente el almacenamiento de respaldo de Lakebase. Eliges un espacio de trabajo único
session_store_name. - Una sesión es una interacción duradera (normalmente un hilo de conversación) dentro de una tienda. Una sesión se identifica por:
-
actor_id(requerido): a quién pertenece la sesión, como un usuario final u otro agente. Agrupa todas las sesiones de una asignatura para que puedas listarlas y filtrarlas juntas. Cuando crees una aplicación por usuario, estableceactor_idcon el ID del usuario (por ejemplo, la identidad verificada del usuario final obtenida mediante la autenticación de tu aplicación) para que las sesiones de cada usuario permanezcan agrupadas. Configúralo desde el contexto de la aplicación confiable, nunca un valor proporcionado por el modelo o el usuario. -
session_id(opcional): un ID elegido por el llamante para la interacción. El servicio genera una cuando la omites. -
parent_session_id(opcional): vincula una sesión con aquella de la que se bifurcó, para representar conversaciones bifurcadas.
-
- Un elemento de sesión es una entrada en el historial ordenado de una sesión. Cada elemento contiene un valor opaco compatible
datacon JSON, como un mensaje, una llamada a una herramienta, un resultado de herramienta o un bloque de razonamiento. Azure Databricks asigna a cada elemento unitem_idy uncreate_timey no inspecciona ni valida su contenido. Los elementos son inmutables una vez añadidos.
El servicio mantiene un orden determinista para los elementos de una sesión y autoriza cada operación realizada en el almacén de sesiones.
Get started
Estos ejemplos configuran sesiones gestionadas para un agente de soporte: crean un almacén de sesiones, inician una sesión para una conversación, añaden los turnos de la conversación y leen el historial en una petición posterior. Elige el cliente que se adapte a tu proyecto.
AgentKit SDK
El SDK AgentKit es el cliente de Python de Databricks para APIs de agentes, distribuido en el databricks-agentbricks paquete. Se autentica con el WorkspaceClient del SDK de Databricks.
Instala el SDK AgentKit:
pip install databricks-agentbricksCrea un almacén de sesiones y luego inicia una sesión para una única conversación.
actor_ides a quien pertenece la conversación; el opcionalsession_ididentifica de forma única esta conversación:from databricks.sdk import WorkspaceClient from databricks_agentkit import AgentKitClient client = AgentKitClient(WorkspaceClient()) session_store = client.session_stores.create("support-agent-sessions") session = session_store.add(actor_id="customer-123", session_id="case-456")Añade los turnos de la conversación mientras el agente corre. Cada elemento es cualquier valor compatible con JSON:
session.append_items(
    [
        {"type": "message", "role": "user", "content": "I need help with my cluster."},
        {"type": "message", "role": "assistant", "content": "Let's take a look."},
    ]
)
En una petición de seguimiento, recarga la sesión y lee su historial completo para reconstruir el contexto:
session = session_store.get("case-456")
# Request chronological order; list_items defaults to newest-first and auto-pages.
history = [item.data for item in session.list_items(order_by="create_time asc")]
API de REST
Los clientes invocan la API REST en /api/2.0/agents/session-stores. Llámalo directamente para lenguajes distintos a Python.
Genera un token OAuth con la CLI de Databricks:
databricks auth login --host ${DATABRICKS_HOST}
export DATABRICKS_TOKEN=$(databricks auth token | jq -r .access_token)
Crea una tienda de sesiones para tu agente:
curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/session-stores?session_store_name=support-agent-sessions" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \
  -d '{"description": "Support agent conversation history"}'
Inicia una sesión para una sola conversación.
actor_idindica a quién pertenece;session_ididentifica de forma única esta conversación:curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/session-stores/support-agent-sessions/sessions?session_id=case-456" \ -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \ -d '{"actor_id": "customer-123"}'Añade un turno de conversación mientras el agente corre:
curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/session-stores/support-agent-sessions/sessions/case-456/items:append" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \
  -d '{"items": [{"data": {"type": "message", "role": "user", "content": "I need help with my cluster."}}]}'
Lee la historia en orden cronológico para reconstruir el contexto:
curl -G "https://${DATABRICKS_HOST}/api/2.0/agents/session-stores/support-agent-sessions/sessions/case-456/items" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" --data-urlencode "order_by=create_time asc"
Los clientes también admiten la eliminación del elemento más reciente, el borrado de los elementos de una sesión y la bifurcación de una conversación en una copia independiente (opcionalmente hasta un elemento específico). Eliminar una sesión que tiene sesiones hijas requiere una opción forzada para encadenar la eliminación a ellas (por ejemplo, session.delete(force=True)).
Respaldar la sesión de un marco de trabajo de agente con sesiones administradas
Frameworks de agentes como el SDK de Agentes OpenAI y el SDK Claude Agent leen el historial de conversaciones al inicio de una ejecución y añaden nuevos elementos al final. El almacén de sesiones se ajusta directamente a ese patrón:
| Funcionamiento del marco | Llamada al almacén de sesiones |
|---|---|
| Leer historia |
list_items en orden cronológico (order_by="create_time asc") |
| Añadir elementos de turno |
append Los nuevos artículos |
| Deshacer el último elemento |
pop el elemento más reciente |
| Borrar el hilo |
clear Los elementos de la sesión |
Alcance y acceso
Las sesiones gestionadas almacenan los elementos de una sesión como valores opacos compatibles con JSON: el servicio persiste y devuelve lo que tu agente o framework añade, sin interpretarlo. No añade recursos de control de ejecución, como ejecuciones, puntos de control o aprobaciones, como conceptos de primera clase, aunque un marco que serialice dicho estado puede persistirlo en forma de elementos.
Los almacenes de sesión se limitan al espacio de trabajo, y el acceso se autoriza a nivel de almacén. Los actor_id campos y metadata solo admiten agrupación y filtrado; no conceden ni restringen el acceso. Establece el actor_id a partir del contexto de una aplicación de confianza, en lugar de un valor proporcionado por el modelo o el usuario.
Para que otro principal, como el principal de servicio de tu agente, use una tienda, concédele acceso mediante la operación de conceder permisos de la tienda (session_store.grant_permission(principal_id) en el SDK AgentKit).
Las sesiones gestionadas y la memoria gestionada son independientes. Eliminar una sesión o un almacén de sesión no elimina la memoria almacenada en un almacén de memoria.