Nota:
El acceso a esta página requiere autorización. Puede intentar iniciar sesión o cambiar directorios.
El acceso a esta página requiere autorización. Puede intentar cambiar los directorios.
Azure Batch ejecuta trabajos por lotes de informática paralela y de alto rendimiento (HPC) a gran escala en Azure. Batch crea y administra grupos de nodos de proceso, instala las aplicaciones que desea ejecutar y programa los trabajos para que se ejecuten en los nodos.
Cuando se usa Azure, la confiabilidad es una responsabilidad compartida. Microsoft proporciona una variedad de capacidades para apoyar la resiliencia y la recuperación. Es responsable de comprender cómo funcionan esas funcionalidades dentro de todos los servicios que usa y de seleccionar las funcionalidades que necesita para cumplir los objetivos empresariales y los objetivos de tiempo de actividad.
En este artículo se describe cómo hacer que Azure Batch sea resistente a errores transitorios, errores de nodos de proceso, errores de zona de disponibilidad, errores de toda la región y mantenimiento del servicio. También se describen las recomendaciones de implementación de producción, la arquitectura de confiabilidad de Batch, la copia de seguridad y la restauración, y la información clave sobre el acuerdo de nivel de servicio (SLA) de Azure Batch.
Recomendaciones de implementación de producción
Para cargas de trabajo de producción, siga los procedimientos recomendados para Azure Batch, incluidas estas recomendaciones de confiabilidad:
Diseñe tareas para tolerar interrupciones y reejecución. Haga que las tareas sean idempotentes, cree puntos de control para trabajos de larga duración y conserve los datos de salida y diagnóstico necesarios en un almacenamiento duradero. Para obtener más información, consulte Resistencia a errores transitorios y Resistencia a fallos de nodos de proceso.
Utilice varios nodos de proceso cuando la carga de trabajo debe continuar después de un error de nodo. No se garantiza que los nodos de proceso individuales permanezcan disponibles. Aprovisione suficientes nodos para que los nodos utilizables restantes puedan ejecutar tareas reprogramadas.
Use la colocación en zona de disponibilidad cuando se admita. Configure la ubicación de la zona de disponibilidad cuando la región, la SKU de máquina virtual (VM) y la configuración de la carga de trabajo lo admitan. Los nodos de zonas en buen estado pueden seguir ejecutando tareas durante una interrupción de zona, pero debe prever una capacidad reducida porque la capacidad de reemplazo depende de la cuota y la disponibilidad de la máquina virtual en las zonas en buen estado. Para obtener más información, consulte Resilience to availability zone failures (Resistencia a errores de zona de disponibilidad).
Diseñe trabajos para pools de destino dinámicamente en lugar de un identificador de pool fijo. Este diseño permite redirigir un trabajo a un grupo en buen estado si el grupo original deja de estar disponible o no logra escalar hasta la capacidad deseada. Mejora la continuidad empresarial durante el mantenimiento o fallo del pool.
Mantenga las configuraciones del pool actualizadas. Supervise las fechas de finalización del soporte de Azure Batch para imágenes y SKU de máquina virtual, y migre los pools antes de la fecha de EOL. Siga la guía de mantenimiento del servicio para mantener actualizado el agente de nodo de Batch.
Introducción a la arquitectura de confiabilidad
En esta sección se describen algunos de los aspectos importantes de cómo funciona el servicio que es más relevante desde una perspectiva de confiabilidad. En la sección se presenta la arquitectura lógica, que incluye algunos de los recursos y características que se implementan y usan. También se describe la arquitectura física, que proporciona detalles sobre cómo funciona el servicio en segundo plano.
Arquitectura lógica
Azure Batch usa varios tipos de recursos para ejecutar cargas de trabajo por lotes. La configuración de estos recursos determina cómo responde la carga de trabajo a fallos.
Todos los recursos y procesamiento de Batch están asociados a una cuenta de Batch. Una solución de Batch usa los siguientes componentes lógicos:
Cuenta de Batch: Un recurso regional con el que se asocian grupos, trabajos, tareas y otros recursos de Batch. Cree la cuenta y seleccione su región, el modo de asignación del pool y la configuración de autenticación.
Pool: Colección de nodos de proceso en los que se ejecutan las tareas. La configuración de un grupo de nodos define su imagen de máquina virtual y tamaño, recuento de nodos de destino, comportamiento de escalado, redes y ubicación de zona. Configura cada grupo para proporcionar la capacidad, la selección de ubicación y el entorno operativo que requiere la carga de trabajo. El número de nodos de destino es la capacidad solicitada, pero el número de nodos asignados puede ser menor debido a límites de cuota, restricciones de capacidad o errores de asignación.
Trabajos y tareas: Un trabajo administra una colección de tareas y está asociado a un pool. Una tarea ejecuta una aplicación o un script en un nodo de proceso. Puede definir trabajos, tareas, restricciones, dependencias, comportamiento de reintento y el grupo en el que se ejecuta cada trabajo.
Cuenta de almacenamiento asociada: Una cuenta de Azure Storage que, opcionalmente, se vincula a una cuenta de Batch. La mayoría de las soluciones de Batch usan una cuenta de almacenamiento asociada para archivos de aplicación, archivos de recursos de tareas, datos de entrada y datos de salida.
Después de vincular una cuenta de almacenamiento a una cuenta de Batch, Batch hace referencia a ella como la cuenta de autostorage. Se requiere una cuenta de autostorage para los paquetes de aplicación y también puede almacenar archivos de recursos de tareas.
La confiabilidad de una solución de Batch depende de sus recursos de almacenamiento. Es responsable de seleccionar una configuración de redundancia de almacenamiento que cumpla los requisitos de recuperación al crear la cuenta de almacenamiento. Mueva la salida de la tarea y otros datos duraderos de los nodos de proceso al almacenamiento. Para obtener información sobre las opciones de confiabilidad de Azure Storage, consulte Confiabilidad en Azure Blob Storage.
Para obtener más información, consulte Flujo de trabajo y recursos del servicio Batch y cuentas de Batch y cuentas de Azure Storage.
Arquitectura física
Azure Batch tiene un plano de control regional que procesa las operaciones de administración en cuentas de Batch y otros recursos de Batch, como grupos de nodos, trabajos y tareas. Es independiente de los nodos de proceso que ejecutan tareas.
Los grupos de nodos de Azure Batch usan Azure Virtual Machines y Virtual Machine Scale Sets. Un nodo de proceso es una máquina virtual que procesa parte de una carga de trabajo de Batch. Cada nodo pertenece a un grupo de nodos y ejecuta tareas que el servicio Batch le asigna. El agente de nodo de Batch se ejecuta en cada nodo y proporciona la interfaz de comando y control entre el nodo y el servicio Batch. Los nodos de proceso y su almacenamiento local son efímeros. Cuando un nodo sale de un pool, se pierden los cambios en su sistema operativo y los archivos.
El modo de asignación de grupos de la cuenta de Batch determina dónde crea Batch los recursos de proceso y relacionados con la máquina virtual:
- Modo de asignación del grupo de servicios: Batch asigna los recursos en suscripciones de Azure administradas por el servicio Batch.
- Modo de asignación del grupo en la suscripción del usuario: Batch crea los recursos directamente en la suscripción que contiene la cuenta de Batch.
Las responsabilidades de la arquitectura física se dividen de la siguiente manera:
Microsoft: Microsoft opera el plano de control regional de Batch y la infraestructura de servicio. Batch aprovisiona nodos de proceso según la configuración del grupo y la capacidad disponible, programa tareas, supervisa el estado del nodo e intenta recuperar nodos después de errores de infraestructura. Batch puede volver a poner en cola las tareas interrumpidas para su ejecución en otro nodo disponible.
Usted: Seleccione la imagen y el tamaño de la máquina virtual, los tipos de nodo, el recuento de nodos de destino, la configuración de escalado, las redes y la ubicación de la zona de disponibilidad.
También es responsable de mantener la capacidad suficiente para tolerar fallos de nodo, supervisar los estados de nodo y tarea, mantener el sistema operativo invitado y el agente de nodo actuales, diseñar tareas para tolerar la reexecución y mover datos duraderos fuera de los nodos de cómputo.
La recuperación de nodos por lotes no garantiza que una carga de trabajo continúe sin interrupciones. Para obtener más información, consulte Resiliencia a fallos de nodos de cálculo.
Resistencia a errores transitorios
Los errores transitorios son errores breves e intermitentes en los componentes. Se producen con frecuencia en un entorno distribuido como la nube y son una parte normal de las operaciones. Los errores transitorios se corrigen después de un breve período de tiempo. Es importante que las aplicaciones puedan controlar errores transitorios, normalmente mediante el reintento de solicitudes afectadas.
Todas las aplicaciones hospedadas en la nube deben seguir las instrucciones de control de errores transitorios de Azure cuando se comunican con cualquier API, bases de datos y otros componentes hospedados en la nube. Para más información, vea Recomendaciones para gestionar errores temporales.
Dentro de una solución de Batch, los errores transitorios pueden afectar tanto a las aplicaciones como a los scripts que se ejecutan como tareas y a las aplicaciones que llaman a las API de Batch para administrar los recursos de Batch. Batch proporciona mecanismos de reintento en el nivel de tarea. Es responsable de configurar restricciones de tareas, hacer que las tareas sean idempotentes (sin efectos adversos al ejecutarlas varias veces) y configurar el comportamiento de reintento para las llamadas al servicio Batch y otras dependencias.
Reintentos de tareas y límites de tiempo
Configure maxTaskRetryCount para controlar cuántas veces Batch reintenta una tarea después de que su proceso salga con un código de salida distinto de cero:
- El valor predeterminado,
0, significa que Batch no vuelve a intentar la tarea después de un código de salida distinto de cero. - Un entero positivo establece un número máximo de reintentos después del intento inicial.
- Un valor de
-1permite reintentos ilimitados. Este valor no se recomienda porque un error persistente puede hacer que la tarea se ejecute indefinidamente.
Diseñe cada tarea para que sea idempotente para que los reintentos no provoquen daños en los datos ni la salida duplicada. Para las tareas de larga duración, use puntos de comprobación para que un reintento pueda continuar desde el progreso guardado. Para obtener más información, consulte Diseño de reintentos y reejecución.
Establezca la maxWallClockTime limitación en una tarea o trabajo para interrumpir el trabajo que no avance en un período aceptable. Un límite de tiempo también limita el efecto de los errores repetidos. Seleccione los recuentos de reintentos y los límites de tiempo que se alinean con los objetivos de recuperación de la carga de trabajo.
Errores transitorios en dependencias de tareas
Las aplicaciones y scripts que se ejecutan como tareas de Batch suelen llamar a otros componentes, como Azure Storage, bases de datos o API. Batch no administra las solicitudes individuales que el código de tarea envía a estas dependencias. Implemente el control de errores transitorios en el código de tarea o use las características de reintento proporcionadas por el SDK de la dependencia. Siga las instrucciones de cada dependencia para identificar los errores que se pueden reintentar, seleccionar la configuración adecuada del intervalo de espera entre reintentos y del tiempo de espera, y respetar las instrucciones de reintento, como el encabezado Retry-After. Vuelva a intentar solo las operaciones que sean seguras para repetirse.
Si un error de dependencia hace que el proceso de tarea salga con un código de salida distinto de cero, Batch puede reintentar toda la tarea según maxTaskRetryCount. Sin embargo, Batch no vuelve a intentar una solicitud de dependencia individual dentro de una tarea en ejecución.
Reintentos de solicitudes de Batch API
Las aplicaciones que se ejecutan fuera del servicio pueden llamar a las API de Batch para crear y administrar grupos, trabajos, tareas, nodos de cómputo y otros recursos de Batch. Configure estos clientes con directivas de reintento que abarquen al menos cinco minutos para gestionar fallos transitorios del servicio Batch o de red.
Use la compatibilidad de reintento del SDK integrado cuando esté disponible. Por ejemplo, la biblioteca cliente Azure.Compute.Batch para .NET expone el comportamiento de reintento a través de Azure.Core las opciones de reintento.
Si interactúa directamente con las API del servicio Batch desde el código, espere varios segundos antes de volver a intentarlo, use el backoff exponencial con aleatorización (jitter) para evitar las solicitudes de reintento sincronizadas y respete el encabezado Retry-After devuelto con respuestas de limitación como 429 Too Many Requests y 503 Service Unavailable.
Un tiempo de espera de solicitud no significa necesariamente que Batch no haya procesado la solicitud. Después de un tiempo de espera, vuelva a intentar la operación cuando sea seguro hacerlo o recupere el estado del recurso para determinar si la operación original se realizó correctamente. Para obtener más información, consulte Manejo y detección de errores en Azure Batch.
Resistencia a fallos de nodos de cómputo
Un nodo de proceso puede dejar de estar disponible debido a un error de infraestructura, un problema del sistema operativo o un problema de configuración. Batch intenta recuperar nodos afectados por errores de infraestructura, pero no puede recuperar automáticamente todos los fallos relacionados con la configuración. Por ejemplo, si no se puede instalar un paquete de aplicación o un contenedor, debe corregir el problema subyacente y podría necesitar quitar y reemplazar el nodo afectado.
Si un fallo de nodo interrumpe una tarea, Batch puede reintentar la tarea en el mismo nodo, si es posible, hasta un límite interno. Si la tarea no puede continuar en ese nodo, Batch puede volver a ponerla en cola para su ejecución en otro nodo disponible. Estos reintentos de recuperación controlados por el servicio son independientes de maxTaskRetryCount y pueden producirse incluso cuando su valor es 0.
proceso de recuperación de nodos administrados por Microsoft
Microsoft administra la recuperación de nodos controlada por el servicio y la puesta en cola de tareas. Si el servicio Batch deja de recibir latidos de un nodo durante el tiempo suficiente como para desencadenar la recuperación, Batch puede realizar las siguientes acciones:
-
Aislar el nodo: Batch trata el nodo como no operativo, establece su estado en
unusabley deja de programar nuevas tareas en él. - Identificar las tareas afectadas: Batch identifica las tareas que se estaban ejecutando en el nodo como candidatas para la reprogramación.
-
Volver a poner en cola las tareas aptas: Si una tarea afectada todavía sigue en el estado
running, Batch puede restablecerla aactivepara que el programador pueda asignarla a otro nodo. Batch no restablece ni vuelve a ejecutar una tarea ya persistida en el estadocompleted. - Recuperar el nodo: Batch intenta restaurar el nodo a un estado correcto o reemplazar la máquina virtual subyacente.
La recuperación no es instantánea. Una tarea puede permanecer en estado running mientras Batch detecta el fallo del nodo e intenta volver a programar la tarea. Si no hay ningún otro nodo de proceso disponible, la tarea puede permanecer en ese estado hasta que Batch pueda volver a programarla. Para obtener más información, consulte Limitaciones conocidas de las tareas de Batch.
Si el nodo original reanuda las señales de latido correctas antes de que comience el reemplazo, Batch puede devolverlo a un estado estable. Si el reemplazo ya ha comenzado, Batch puede quitar la máquina virtual original y aprovisionar un reemplazo.
Sus responsabilidades
La recuperación controlada por el servicio no garantiza la ejecución ininterrumpida de tareas ni suficiente capacidad restante. Usted es responsable de las siguientes acciones:
Mantener capacidad suficiente: Si la carga de trabajo debe continuar mientras un nodo no está disponible, aprovisione suficientes nodos para que los nodos restantes ejecuten tareas reprogramadas. Sin otro nodo utilizable, las tareas interrumpidas deben esperar.
Supervisión de la capacidad utilizable: Realice un seguimiento de los recuentos y estados de nodos agregados para que pueda detectar cuándo un grupo ya no tiene suficientes nodos utilizables para la carga de trabajo. Estados como
unusable,startTaskFailed,unknownepreemptedindican una capacidad reducida. Para obtener más información, consulte Supervisión de soluciones de Batch mediante el recuento de tareas y nodos por estado.Investigar nodos de problema: Si las tareas producen un error repetidamente, se vuelven a poner en cola o permanecen en estado
runningdespués de que su nodo asignado se vuelva inutilizable o salga del grupo, use metadatos de tareas para determinar si los problemas están asociados a un nodo específico.Antes de quitar un nodo de problema, cargue los registros del agente de nodo de Azure Batch y conserve los registros de tareas pertinentes porque al quitar el nodo se eliminan sus archivos locales. Los registros del agente de Node pueden ayudar a Soporte técnico de Microsoft diagnosticar problemas de servicio o nodo de Batch, mientras que los registros de tareas, como stdout y stderr, pueden ayudarle a identificar problemas de configuración y aplicación. Para más información, consulte Archivos de registro del agente de Node.
Proteja el progreso y los datos de la tarea: Diseñe tareas para tolerar interrupciones y re-ejecución. Mueva puntos de control, salida y otros datos duraderos fuera de los nodos de proceso porque su almacenamiento local es efímero.
Para obtener más información, consulte Errores de grupo y nodo de Azure Batch y control y detección de errores en Azure Batch.
Resistencia a errores de zona de disponibilidad
Las zonas de disponibilidad son grupos físicamente independientes de centros de datos dentro de una región de Azure. Cuando una zona falla, los servicios pueden transferirse a una de las zonas restantes.
Batch permite el uso de zonas de disponibilidad de dos maneras principales:
Plano de control: El plano de control de Batch tiene resiliencia de zona en muchas regiones. En esas regiones, las operaciones de administración en cuentas de Batch y otros recursos de Batch pueden continuar durante un fallo de zona. Microsoft no publica qué regiones proporcionan esta resiliencia del plano de control.
Grupos de nodos: Puede configurar un grupo de Batch para usar la colocación en zona de disponibilidad. Si una zona deja de estar disponible, los nodos de proceso de las zonas en buen estado siguen estando disponibles para la programación de tareas.
Para la selección de ubicación de nodos de proceso, este modelo de soporte es similar a la redundancia de zona en otros servicios de Azure, ya que un único grupo puede contener nodos de proceso en varias zonas de disponibilidad. Sin embargo, Batch distribuye los nodos entre zonas de la mejor manera posible. Intenta usar todas las zonas de la región, pero no garantiza la colocación en cada zona ni una distribución uniforme. No puede seleccionar zonas específicas ni controlar el número de nodos colocados en cada zona.
En el diagrama siguiente se muestra un ejemplo de cuenta de Batch. La cuenta tiene un único grupo con sus nodos distribuidos en tres zonas de disponibilidad:
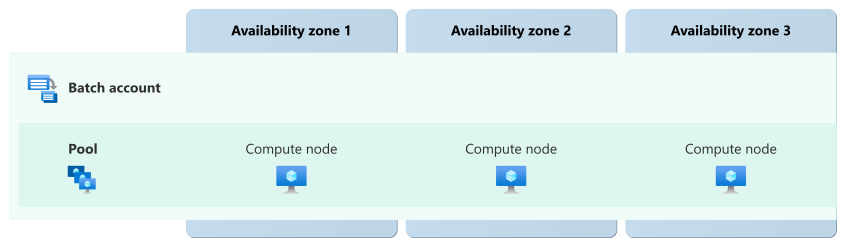
El diagrama muestra una cuenta de Batch que contiene un pool. El pool tiene tres nodos de proceso, con un nodo que se muestra en cada una de las zonas de disponibilidad 1, 2 y 3. La ubicación de zona de disponibilidad se aplica a los nodos de proceso y no determina la resiliencia de zona del plano de control de Batch. La distribución es un ejemplo porque Batch usa el equilibrio de mejor esfuerzo y no garantiza un nodo en cada zona.
Es responsable de hacer que otros recursos dependientes, como las cuentas de almacenamiento, sean resistentes a zonas. Revise las guías de confiabilidad de cada servicio. Para obtener más información, consulte Guías de confiabilidad para servicios de Azure.
Requirements
Compatibilidad con regiones: Cree el grupo en una región de Azure que admita zonas de disponibilidad.
Disponibilidad de la SKU de máquina virtual: La SKU de máquina virtual seleccionada debe estar disponible en más de una zona de la región. Use la API Resource SKUs List para comprobar el campo
locationInfode la SKU de máquina virtual.Acceso a la suscripción: Para un modo de asignación del grupo de suscripciones de usuario, la suscripción no debe tener una restricción de oferta de zona para la SKU de máquina virtual seleccionada. Compruebe
ResourceSkuRestrictionsen la respuesta de la API lista de SKU de recursos. Si existe una restricción, envíe una solicitud de soporte técnico para solicitar su eliminación.Comunicación entre nodos: Un grupo no puede usar una directiva de selección de ubicación de zona de disponibilidad cuando la comunicación entre nodos está habilitada con una SKU de máquina virtual habilitada para InfiniBand.
Distribución de instancias a través de zonas
Al habilitar la ubicación en zonas de disponibilidad, Batch intenta asignar nodos de proceso en todas las zonas de disponibilidad de la región seleccionada. Esta asignación se realiza de la mejor manera posible. Batch controla la distribución y es posible que el número de nodos de cada zona no sea igual.
Cost
Batch no agrega ningún cargo por habilitar la ubicación en la zona de disponibilidad. Se le facturará la capacidad de proceso, el almacenamiento, las redes y otros recursos de Azure utilizados por la carga de trabajo. Si aprovisiona nodos adicionales para tolerar la pérdida de una zona, a esos nodos se les aplican sus cargos normales. Para obtener más información, consulte precios de Azure Batch.
Configurar soporte de zonas de disponibilidad
Crear un nuevo pool con ubicación en zona de disponibilidad: Para crear un pool con la ubicación en zona de disponibilidad habilitada, consulte Creación de un pool de Batch entre zonas de disponibilidad.
Cambiar la asignación de la zona de disponibilidad en un grupo existente: Debe seleccionar la asignación de la zona de disponibilidad al crear el grupo. No se puede cambiar un grupo existente para usar zonas de disponibilidad.
Puede crear un grupo de reemplazo y actualizar cada uno de los trabajos para usarlo mediante los pasos siguientes:
Deshabilite la tarea: Use la operación Deshabilitar tarea y seleccione cómo Batch controla las tareas que se ejecutan al enviar la solicitud:
-
Espera: Azure Batch deja de iniciar nuevas tareas y permite que las tareas en ejecución finalicen en el pool existente. El trabajo permanece en el estado
disablinghasta que finalicen las tareas en ejecución. - Requeue: Lote interrumpe las tareas en ejecución y las devuelve a la cola. Las tareas se pueden volver a ejecutar después de habilitar la tarea.
- Finalizar: Batch interrumpe las tareas en ejecución y las marca como completadas con información de error que indica que fueron terminadas. Las tareas no se vuelven a ejecutar después de habilitar la tarea.
Las tareas que ya están en el estado
active, lo que significa que están en cola pero no en ejecución, permanecen en cola con cada opción.Espere hasta que el trabajo alcance el estado
disabledantes de continuar. En ese momento, no se está ejecutando ninguna tarea y Batch no programará nuevas tareas.-
Espera: Azure Batch deja de iniciar nuevas tareas y permite que las tareas en ejecución finalicen en el pool existente. El trabajo permanece en el estado
Edite el grupo del trabajo: Use la operación Actualizar trabajo para establecer el
poolInfo.poolIddel trabajo en el grupo de reemplazo. Batch solo permite que esta propiedad cambie mientras el trabajo está en eldisabled. Asegúrese de que el grupo de reemplazo existe y tiene capacidad utilizable antes de habilitar la tarea. Si el grupo de nodos no existe, Batch acepta la actualización, pero no puede programar tareas hasta que cree el grupo de nodos.Active el trabajo: Use la operación Activar trabajo. El trabajo pasa del estado
enablingal estadoactive. A continuación, Batch programa tareas en cola, incluidas las tareas devueltas a la cola por la opción Requeue , en el grupo de reemplazo. Las tareas que finalizaron mientras Batch aplicaba la opción Esperar y las tareas completadas por la opción Terminar no se ejecutan de nuevo.
Planeamiento y administración de capacidad
El proceso de recuperación de nodos normal de Batch intenta reemplazar los nodos que se vuelven inutilizables durante un error de zona y restaura el grupo a su recuento de nodos de destino configurado. No aumenta ese objetivo. Para conservar la capacidad suficiente para que la carga de trabajo continúe cuando una zona no esté disponible, considere la posibilidad de sobreaprovisionar la capacidad del pool mediante el escalado automático o manualmente:
Si usa el escalado automático: Haga referencia a la
$UsableNodeCountvariable definida por el servicio en la fórmula de escalado automático del grupo para detectar cuándo la capacidad utilizable está por debajo de la línea base que requiere la carga de trabajo.$UsableNodeCountes una variable de escalado automático de Batch para el grupo cuya fórmula se está evaluando, no una métrica de Azure Monitor. Azure Monitor publica métricas de recuento de nodos de Batch en el ámbito de la cuenta de Batch y esas métricas no tienen unapoolIddimensión.Si administra la capacidad manualmente: Use la operación List Pool Node Counts para recuperar los recuentos de nodos dedicados y nodos Spot en cada estado de cada grupo. La operación no devuelve un único recuento de nodo utilizable. Evalúe los estados compatibles con tareas, como
idleyrunning, frente a estados con problemas o no disponibles, comounusable,unknown,offlineystartTaskFailed. Es posible que los recuentos devueltos no sean actuales, por lo que enumere los nodos de proceso del grupo si necesita un recuento exacto.
Batch distribuye nodos entre zonas de la mejor manera posible, por lo que es posible que la distribución real no sea igual. No suponga que los nodos se distribuyen de forma equitativa entre zonas al planear la capacidad. Compruebe que la carga de trabajo puede cumplir sus objetivos de recuperación con una capacidad del pool reducida.
Comportamiento cuando todas las zonas están en buen estado
En esta sección se describe qué esperar cuando un grupo de Batch usa la ubicación de la zona de disponibilidad y todas las zonas están operativas.
Operación entre zonas: Batch programa tareas en nodos de proceso disponibles en todo el grupo, independientemente de la zona que contiene cada nodo.
Replicación de datos entre zonas: Los nodos de proceso por lotes son efímeros y Batch no replica archivos de tareas entre zonas. Es responsable de mover datos de entrada, salida, puntos de control y diagnóstico que deben sobrevivir a la pérdida de nodo al almacenamiento duradero. Configure la redundancia de la cuenta de almacenamiento para cumplir los requisitos de disponibilidad.
Comportamiento durante un fallo de zona
En esta sección se describe qué esperar cuando un grupo de Batch usa la ubicación de zona de disponibilidad y una zona de disponibilidad no está disponible.
Detección y respuesta: Microsoft supervisa el servicio Batch y el estado del nodo de proceso. Durante un fallo de zona, Batch detecta una pérdida sostenida de latido de los nodos afectados e inicia su proceso normal de recuperación de nodos. Los nodos de las zonas en buen estado siguen estando disponibles y Batch puede seguir programando tareas en ellos.
Batch intenta restaurar el grupo a su recuento de nodos de destino configurado a través de su proceso de recuperación normal, pero no aumenta ese número objetivo. Es responsable de solicitar capacidad adicional si el objetivo no proporciona suficiente capacidad para la carga de trabajo.
- Notificación: Microsoft no le notifica automáticamente cuando una zona está inactiva. Sin embargo, puede usar Azure Service Health para comprender el estado general del servicio, incluidos los errores de zona, y puede configurar alertas de Service Health para notificarle problemas.
Tareas activas: Las tareas que se ejecutan en los nodos afectados se interrumpen. Batch puede volver a programar tareas en los nodos disponibles como parte de su comportamiento de recuperación interno. Diseñe tareas para tolerar reintentos y reexecución, como se describe en Resistencia a errores transitorios y Resistencia a errores de nodo de proceso.
Pérdida de datos esperada: Los archivos de los nodos de proceso afectados no están disponibles durante la interrupción y se pierden si los nodos se regeneran con una imagen o se quitan del grupo. Batch no replica estos archivos entre zonas. Los datos guardados en el almacenamiento duradero permanecen disponibles según la configuración de redundancia del recurso de almacenamiento.
Tiempo de inactividad esperado: Las tareas en nodos en buen estado continúan. Las tareas interrumpidas experimentan tiempo de inactividad hasta que Batch puede reprogramarlas en nodos utilizables. Si no hay ningún nodo utilizable disponible, es posible que una tarea permanezca en el estado
runninghasta que Batch pueda volver a programarla. El tiempo de recuperación depende de la capacidad disponible del grupo y de la carga de trabajo en cola.Las operaciones de administración en cuentas de Batch y otros recursos de Batch continúan si la cuenta está en una región donde el plano de control tiene resistencia zonal. En otras regiones, es posible que las operaciones de administración no estén disponibles hasta que se recupere la zona afectada.
Redistribución: Después de una pérdida sostenida de la señal de latido, Batch marca los nodos afectados como
unusabley los envía para su reemplazo a través de su proceso normal de recuperación de nodos. Batch intenta restaurar el grupo a su recuento de nodos de destino configurado, pero la capacidad de reemplazo depende de la cuota y la disponibilidad de la máquina virtual en las zonas en buen estado.Los trabajos permanecen asociados al pool durante este proceso. Batch continúa programando tareas de trabajos activos en nodos utilizables en zonas en buen estado. Si los nodos de reemplazo se asignan y se pueden usar, Batch también puede programar tareas en esos nodos.
Este proceso de recuperación no aumenta el número configurado de nodos de destino. Si la carga de trabajo requiere capacidad más allá de ese objetivo, aumente manualmente o configure la fórmula de escalado automático del grupo para hacerlo.
Recuperación de zona
Batch administra el proceso de recuperación cuando una zona se recupera después de un fallo. Batch sigue el mismo proceso definido en Resistencia a errores de nodos de proceso.
Batch no garantiza que los nodos se reequilibren uniformemente entre zonas de disponibilidad después de la recuperación. La colocación de zona sigue haciéndose en la medida de lo posible.
Prueba de fallos de zona
No se puede simular una interrupción real de la zona de disponibilidad Azure para las pruebas. En su lugar, use un grupo no productivo para interrumpir las tareas representativas y sacar suficientes nodos de cómputo fuera del servicio para aproximar la pérdida de capacidad esperada. Considere la posibilidad de usar las siguientes operaciones de nodo admitidas:
- Reinicie los nodos seleccionados.
- Deshabilite la programación de tareas en los nodos seleccionados.
- Quite los nodos seleccionados del pool.
Cuando una operación le permite elegir cómo controlar las tareas en ejecución, seleccione la opción Requeue para que Batch pueda programar las tareas interrumpidas en los nodos restantes.
Durante la prueba, compruebe que Batch vuelve a programar las tareas interrumpidas y que la reexecución no produce una salida duplicada o incoherente. Confirme que los puntos de control y los resultados permanecen disponibles en el almacenamiento duradero, la supervisión detecta la pérdida de nodos y la reducción de capacidad, y la carga de trabajo puede terminar con la capacidad restante.
Estas operaciones validan la interrupción y la reprogramación de tareas, la idempoencia, los puntos de control y la gestión de salida persistente. Sin embargo, no reproducen todos los efectos de un error en toda la zona.
Resistencia a errores en toda la región
Una cuenta de Batch y sus agrupaciones se limitan a una región de Azure. Si la región experimenta un fallo, los trabajos y grupos de Batch podrían verse afectados.
Batch no replica cuentas, la configuración del pool, trabajos, tareas, paquetes de aplicación ni datos de tareas a otra región, y no proporciona conmutación por error integrada entre regiones. Es responsable de implementar y operar una solución de Batch de varias regiones cuando la carga de trabajo debe tolerar un fallo que afecte a toda una región.
Soluciones multirregión personalizadas para la resiliencia
Para crear una solución multirregional, implemente al menos una cuenta de Batch en cada región que use el diseño de recuperación. Las cuentas por lotes funcionan de forma independiente entre regiones. Es responsable de seleccionar las regiones, implementar y operar los recursos en cada región y coordinar la configuración, la replicación, la conmutación por error y el failback.
Puede diseñar un enfoque activo-activo que envíe el trabajo en varias regiones durante el funcionamiento normal o un enfoque activo-pasivo que mantenga la implementación secundaria lista para la conmutación por error. Los diseños activos-activos pueden reducir el tiempo de recuperación porque ambas implementaciones procesan el trabajo durante las operaciones normales, mientras que los diseños activos-pasivos pueden reducir los costos de proceso de estado estable.
En la lista siguiente se proporcionan ejemplos de sus responsabilidades al diseñar la solución:
Implementación: Cree previamente las cuentas de Batch, los grupos de nodos o las definiciones de implementación de grupos de nodos, las cuentas de almacenamiento, los recursos de red y otras dependencias en cada región. Compruebe que cada región seleccionada admite las características de Batch, los tamaños de máquina virtual y los servicios dependientes que requiere la carga de trabajo. Mantenga cada cuenta de Batch y los recursos de almacenamiento utilizados por sus tareas en la misma región cuando sea posible para evitar latencia innecesaria. Defina cuentas, grupos y recursos auxiliares de Batch mediante el uso de la infraestructura como código para que la configuración se pueda reproducir de forma coherente entre regiones.
Cuotas y capacidad: Compruebe las cuotas aplicables de la cuenta de Batch, la suscripción y la familia de máquinas virtuales en cada región de recuperación y solicite aumentos antes de una interrupción cuando sea necesario. Una cuota es un límite, no una garantía de capacidad. La disponibilidad de la máquina virtual varía según la región, la familia de máquinas virtuales y el momento. Para más información, consulte Cuentas de Batch y cuotas de núcleos.
Replicación de datos: Mantenga los paquetes de aplicación, las imágenes de contenedor, los datos de entrada y los datos de referencia disponibles en cada región de recuperación. Batch no reproduce estos elementos por usted.
Replicación de almacenamiento: Configure la redundancia de almacenamiento y la replicación de datos entre regiones en función del objetivo de punto de recuperación. Compruebe que los datos replicados son accesibles desde cada región de recuperación. Para conocer las opciones de confiabilidad del almacenamiento, consulte Confiabilidad en Azure Blob Storage.
Selección de región: Si las aplicaciones funcionan con su cuenta de Batch, diseñelas para que puedan seleccionar otra cuenta de Batch y sus recursos de almacenamiento asociados sin necesidad de una implementación de código.
Conmutación por error: Batch no mueve automáticamente la carga de trabajo a otra región. Es responsable de detectar una interrupción, determinar cómo afecta la interrupción a la carga de trabajo, detener envíos a la cuenta de Batch afectada, dirigir el nuevo trabajo a una cuenta de Batch en una región no afectada y decidir si se deben volver a enviar trabajos interrumpidos. La salida de trabajo o tarea que no se ha replicado fuera de la región afectada podría no estar disponible o perderse. El tiempo de recuperación depende del modelo de implementación, la capacidad disponible, la replicación de datos y la automatización.
Recuperación de regiones: Una vez restaurada la disponibilidad del servicio en la región afectada, valide la cuenta de Batch, los grupos, las dependencias de almacenamiento y el estado del trabajo antes de dirigir el trabajo a esa región. Resuelva las tareas duplicadas o completadas parcialmente antes del reenvío. Batch no coordina este proceso ni reconcilia el estado entre las cuentas regionales.
Pruebas: Pruebe periódicamente el proceso de recuperación regional completo en un entorno que no sea de producción. Simula que una implementación regional no está disponible, dirige los envíos a otra cuenta regional de Batch, valida el acceso a los paquetes de aplicación y los datos de entrada, ejecuta trabajos representativos, recopila la salida y practica la devolución de la implementación recuperada al servicio. Mida los resultados en función del objetivo de tiempo de recuperación y el objetivo de punto de recuperación.
Copias de seguridad y restauración
Azure Batch no es un almacén duradero para los datos de entrada y salida de la carga de trabajo. Microsoft mantiene el servicio Batch, pero es responsable de conservar la configuración y los datos necesarios para volver a crear la carga de trabajo:
Configuración de Batch: Defina cuentas, pools, trabajos y recursos auxiliares de Batch mediante el uso de la infraestructura como código, como Bicep y definiciones de trabajo controladas por versiones. Estos artefactos proporcionan una manera repetible de volver a crear la configuración en la misma región u otra región. Pruebe periódicamente que las definiciones pueden desplegar un grupo y ejecutar un trabajo representativo.
Metadatos de Batch: Batch conserva los registros de trabajos y tareas hasta que se elimina el trabajo o tarea asociado, pero estos registros no son una copia de seguridad. Si necesita conservar este historial, conserve los registros necesarios fuera de Batch.
Datos en nodos de proceso: Los nodos de proceso son efímeros y sus sistemas de archivos no son una copia de seguridad ni un almacén duradero. Los datos de un nodo se pierden cuando se reinstala la imagen del nodo o sale de un grupo. Batch también puede eliminar archivos de tareas después de que expire su período de retención. Guarde la salida requerida y los registros de diagnóstico en el almacenamiento duradero antes de que se complete una tarea. Para las tareas de larga duración, guarde los puntos de comprobación durante la ejecución. Para obtener más información, consulte Conservar la salida de trabajos y tareas y Supervisar Azure Batch.
Datos en cuentas de autostorage: Una cuenta de autostorage asociada puede contener paquetes de aplicación y archivos de recursos de tareas. Además de configurar la redundancia que cumpla los objetivos de recuperación, considere si necesita proteger estos datos frente a la eliminación accidental o la corrupción de datos. Para obtener más información, consulte Copia de seguridad y recuperación en Azure Blob Storage.
Pruebas de restauración y recuperación
Para recuperar, implemente Batch y la configuración de recursos auxiliares, restaure o vuelva a conectar los artefactos de la aplicación y los datos de entrada necesarios y vuelva a enviar el trabajo que no se completó. Pruebe periódicamente la reconstrucción de recursos y la restauración de datos en un entorno de recuperación aislado o no de producción. Utilice definiciones controladas por versiones y datos respaldados, ejecute un trabajo representativo, compruebe la salida y el acceso resultantes a las dependencias, y mida el tiempo de recuperación y el punto de recuperación logrados con respecto a los objetivos. Compruebe que las tareas son idempotentes para que el reenvío de trabajo incierto no dañe los datos ni cree una salida duplicada.
Resistencia al mantenimiento del servicio
Microsoft realiza el mantenimiento de la plataforma y coordina las actualizaciones de infraestructura para Azure Batch y otros servicios. Es responsable de configurar el comportamiento de actualización del pool y diseñar tareas para tolerar interrupciones.
Mantenimiento del host: Azure usa técnicas de mantenimiento como la migración en vivo siempre que sea posible. Si el mantenimiento requiere que un nodo de proceso se reinicie o mueva, se pueden interrumpir las tareas en ejecución y Batch podría volver a programarlas. Haga que las tareas sean idempotentes y guarden los puntos de control y la salida en un almacenamiento duradero.
Sistema operativo invitado: Es responsable de mantener el sistema operativo invitado y el agente de nodo de Batch actuales. El comportamiento de actualización del sistema operativo depende de la imagen y la configuración de actualización. Con la configuración adecuada, las actualizaciones automáticas de imágenes del sistema operativo para los grupos de Batch pueden actualizar los nodos del grupo sin interrumpir las tareas en ejecución. Las actualizaciones automáticas de imágenes del sistema operativo no admiten todas las imágenes de sistema operativo de Batch.
Actualizaciones del agente de Node: Las actualizaciones automáticas de imágenes del sistema operativo no actualizan automáticamente el agente de nodo de Batch. Los agentes de nodo por lotes no se actualizan automáticamente mientras un grupo tenga nodos de proceso. Para recibir un agente de nodo más reciente, cambie el tamaño del grupo a cero nodos y vuelva a escalarlo o reemplace el grupo. Antes de quitar nodos, conserve los registros de diagnóstico y salida de tareas necesarios. Para más información, consulte Actualizaciones del agente de nodo de Batch.
Siga las recomendaciones para la implementación en producción y la guía sobre fallos de nodos de proceso para ayudar a la carga de trabajo a continuar o recuperarse cuando las tareas de mantenimiento interrumpen las tareas o hacen que los nodos de proceso no estén disponibles.
Acuerdo de nivel de servicio
El acuerdo de nivel de servicio (SLA) para Azure servicios describe la disponibilidad esperada de cada servicio y las condiciones que la solución debe cumplir para lograr esa expectativa de disponibilidad. Para obtener más información, consulte los SLAs de los servicios en línea.
El SLA de disponibilidad de Azure Batch se aplica a las operaciones que realiza en Batch API. Para obtener información detallada sobre los tipos de operaciones que se incluyen, revise la redacción del Acuerdo de Nivel de Servicio. El tamaño del pool, la distribución de zona y los servicios dependientes afectan a la disponibilidad de un extremo a otro de la carga de trabajo, pero no cambian los términos del Acuerdo de Nivel de Servicio de Batch.