Nota:
El acceso a esta página requiere autorización. Puede intentar iniciar sesión o cambiar directorios.
El acceso a esta página requiere autorización. Puede intentar cambiar los directorios.
Al usar Frontier Tuning, las organizaciones pueden adaptar los modelos de IA para reflejar su terminología, estilo de comunicación y procesos comerciales únicos. Al ajustar los modelos de lenguaje de gran tamaño (LLM) con sus propios datos, puede mejorar la precisión, el tono y la relevancia de las respuestas de Copilot en todo el espacio empresarial.
Frontier Tuning va más allá de la retención y la recuperación para entrenar a los LLM específicos del inquilino en los datos de su organización mientras mantiene controles sólidos de seguridad, cumplimiento, gobernanza y administración empresariales. Los LLM están ajustados para tareas específicas como resumen de documentos, redacción de documentos, respuesta de expertos, edición de estilos, validación de documentos y optimización.
Este artículo explica el ciclo de aprendizaje de Frontier Tuning y cómo elegir una mejora enfocada. También cubre cómo las herramientas y los entornos de ajuste de muestra admiten la evaluación y el entrenamiento.
Importante
El ajuste de Microsoft Copilot está disponible actualmente para un conjunto limitado de clientes a través de programas de acceso anticipado. El acceso a través de Frontier está previsto para abril de 2026. Las características y los requisitos están sujetos a cambios.
El ciclo de aprendizaje de ajuste
El bucle de aprendizaje conecta su flujo de trabajo, evidencia de evaluación y decisiones de mejora:
- Codifique el flujo de trabajo. Captura instrucciones de tareas, muestras representativas, estándares de calidad y el conocimiento y las herramientas necesarias para el trabajo.
- Revela los huecos. Evaluar tareas realistas con criterios explícitos para identificar éxitos y fracasos.
- Seleccione un cambio. Use los datos probatorios para seleccionar una mejora enfocada y, a continuación, comparar los resultados.
Estas no son etapas de entrenamiento obligatorias. Si la línea base cumple con sus requisitos, detenerse sin un cambio es un resultado válido.
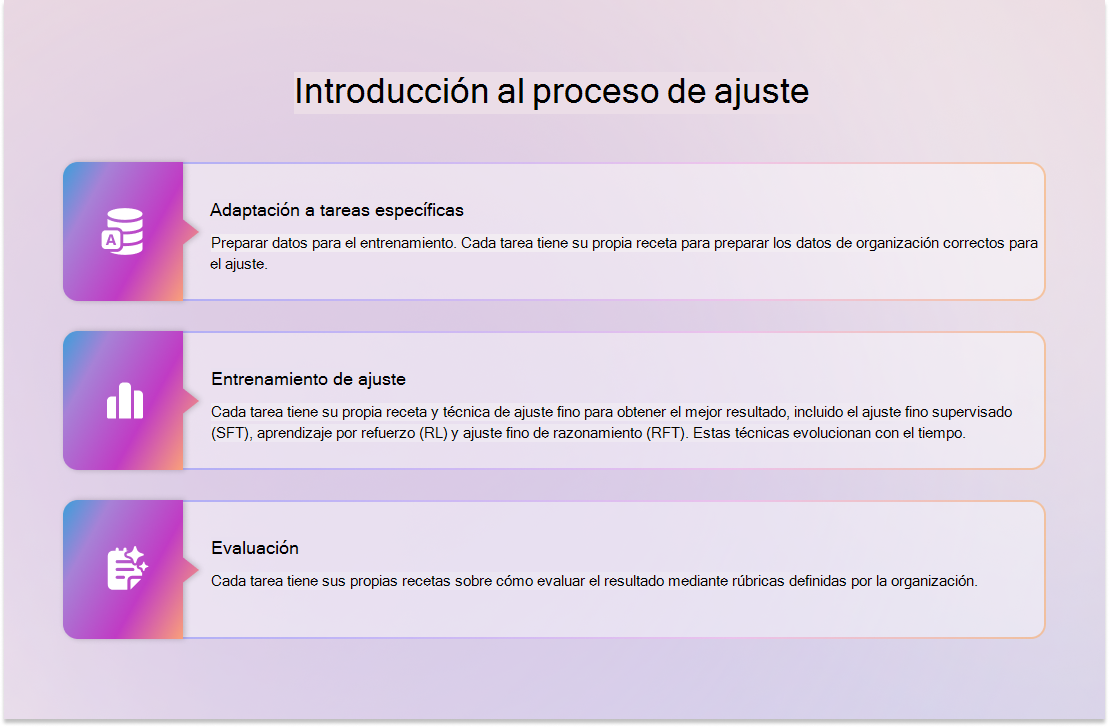
Introducción al proceso de ajuste
Para ajustar los modelos de IA para tu organización mediante el modelo Frontier Tuning-Tuning, sigue estos pasos de entrenamiento y ajuste:
Adaptación específica de la tarea : preparar datos para el entrenamiento. Cada tarea tiene su propia receta para preparar los datos de organización correctos para el ajuste.
Entrenamiento de ajuste : cada tarea tiene su propia receta y técnica de ajuste para obtener el mejor resultado mediante el uso de datos de la organización. Estas técnicas incluyen, entre otras, Ajuste fino supervisado (SFT), Aprendizaje por refuerzo (RL) y Ajuste fino de razonamiento (RFT). Estas recetas y técnicas también evolucionan con el tiempo.
Evaluación : evalúe las respuestas según los criterios de evaluación que reflejan las expectativas de su organización. Compare los resultados antes y después del ajuste en lugar de suponer que el ajuste mejora cada respuesta.
Las herramientas, ejemplos y criterios de evaluación que elija deben ajustarse a la tarea. Por ejemplo, una tarea de ejemplo que usa datos simulados necesita aptitudes y criterios de evaluación que coincidan con esos datos.
Nota
Los modelos que ajuste son privados. Los datos no se usan para entrenar modelos generales para otros inquilinos. Todo el procesamiento de los datos se realiza en el inquilino al que solo los usuarios autorizados tienen acceso para entrenar y usar. Individuos específicos, generalmente administradores, tienen control sobre el proceso de entrenamiento.
Ajuste de entornos
Un entorno de ajuste reúne los artefactos y herramientas para un escenario de ajuste:
- Las habilidades describen lo que el modelo debe hacer para una tarea; Sus descripciones ayudan a enrutar las solicitudes.
- Los ejemplos proporcionan entradas de ejemplo para evaluación o entrenamiento.
- Los criterios de evaluación definen requisitos para evaluar las respuestas, como la integridad o el cumplimiento de las instrucciones.
- Las herramientas proporcionan acciones que el agente puede realizar, como buscar correo o leer un archivo de SharePoint. Un conector agrupa herramientas para un servicio.
Algunas referencias de conocimiento pueden incluir sitios de SharePoint, archivos y carpetas de SharePoint o OneDrive, conversaciones de Teams y reuniones. La configuración del modelo y de la inferencia determina cómo se ejecuta una aptitud.
Los expertos en la materia pueden capturar y revisar la experiencia o los comentarios para proponer habilidades, criterios de evaluación o muestras para que el propietario del entorno las revise. Trate este flujo de trabajo de contribución por separado de los trabajos de evaluación y ajuste; No asuma que la aprobación de una contribución entrena un modelo.
Por qué son importantes los criterios de evaluación
Los criterios de evaluación hacen explícitos los estándares de calidad de sus expertos: lo que una respuesta debe incluir o evitar. Son un instrumento de medición para calificar y comparar respuestas, no un reemplazo de las instrucciones de habilidades o los pesos del modelo. En las estrategias de inferencia admitidas, la retroalimentación basada en criterios también puede influir en la respuesta candidata seleccionada.
Adaptación a tareas específicas
La adaptación específica de la tarea ocurre después de ingerir sus corpus. Esta adaptación implica procesar el contenido de la organización desde su formato original a un formato de texto sin formato con una instrucción por línea.
Ajuste fino supervisado
Use el ajuste fino supervisado para adaptar un modelo previamente entrenado a tareas específicas o requisitos organizacionales mediante el entrenamiento en pares de entrada y salida etiquetados. Este proceso ayuda al modelo a aprender a producir respuestas que se ajustan a los formatos, el tono y las necesidades de cumplimiento preferidos de su organización. Ajuste fino supervisado:
- Enseña estructura y tono: los modelos aprenden a responder de manera que reflejen la voz de su organización.
- Mejora la precisión de las tareas: mediante el entrenamiento con ejemplos de alta calidad, el modelo se vuelve más fiable para casos de uso empresariales.
- Compatible con el cumplimiento: puede entrenar modelos para reconocer y responder al lenguaje normativo y las clasificaciones internas.
Aprendizaje de refuerzo
Utilice el aprendizaje por refuerzo como técnica posterior al entrenamiento para adaptar los LLM al estilo de comunicación, el tono y las preferencias de uso de herramientas únicos de su organización. A diferencia del ajuste fino supervisado, que enseña al modelo a producir resultados correctos a partir de ejemplos etiquetados, el aprendizaje por refuerzo optimiza las cualidades subjetivas al aprender de las señales de retroalimentación.
El aprendizaje por refuerzo es útil cuando se quiere que el modelo:
- Refleja un tono de voz específico (empático, formal, conciso).
- Prefiere determinadas herramientas (como las API de Microsoft Graph en lugar de la recuperación basada en RAG).
- Evite recuperar contenido de orígenes confidenciales (como documentos etiquetados con ACL).
- Aprende de los comentarios de los usuarios para mejorar continuamente.
El aprendizaje por refuerzo refina el modelo al puntuar los resultados en función de las preferencias de la organización, utilizando comentarios humanos y automatizados para guiar el aprendizaje. Por ejemplo, si Copilot recibe comentarios positivos sobre una respuesta a una pregunta sobre una directiva de vacaciones, el modelo refuerza esa respuesta y la reutiliza en contextos similares. Por el contrario, si una respuesta se marca por tono o contenido, el modelo aprende a evitar ese patrón.
Herramientas en el flujo de trabajo de ajuste
La elección de la herramienta afecta a tres etapas del flujo de trabajo:
| Fase | Papel de las herramientas |
|---|---|
| inferencia. | El agente o el modelo ajustado llaman a las herramientas mientras manejan las solicitudes. |
| Evaluación. | El agente llama a las herramientas para completar tareas de muestra y las respuestas se evalúan según los criterios de evaluación. |
| Formación. | El modelo llama a herramientas mientras aprende de sus tareas. |
Las herramientas reales llaman a un servicio y usan sus datos. Las herramientas virtualizadas siguen leyendo datos reales, pero interceptar escrituras admitidas durante la evaluación y el entrenamiento. Las herramientas ficticias utilizan sus propios datos proporcionados en lugar de sus servicios.
El modelo aprende a trabajar con las herramientas que encuentra durante el entrenamiento, incluidos sus nombres, entradas, resultados y errores. Las diferencias en la inferencia pueden afectar su comportamiento. El entrenamiento también requiere herramientas con más frecuencia que el uso normal, por lo que debe tener en cuenta la carga de servicio, los requisitos de privacidad y los efectos secundarios al elegir las herramientas.
Para conocer los tipos de herramientas, el comportamiento de la etapa y el ciclo de vida de la conexión, consulte Herramientas y conectores en Frontier Tuning.
Empezar con un entorno de optimización de ejemplo
Un entorno de ajuste de ejemplo le ofrece un punto de partida para probar el flujo de trabajo antes de preparar sus propios datos empresariales. La creación de un entorno de ajuste a partir de una plantilla de ejemplo agrega artefactos ya preparados y datos ficticios para un escenario de ejemplo. El contenido depende de la plantilla.
Puede inspeccionar las aptitudes y ejemplos incluidos, evaluar las respuestas iniciales de un modelo y ejecutar ajustes para comparar los resultados. Los resultados de la muestra no establecen el rendimiento en sus escenarios comerciales; evaluar con datos representativos antes de su uso en producción.
Para obtener el flujo de trabajo de ejemplo, consulta Probar el ajuste de Frontier con un entorno de ajuste de ejemplo.
Evaluar antes y después del ajuste
Evalúe un modelo base disponible para establecer una línea base antes de iniciar un trabajo de ajuste. Una vez completado el ajuste, evalúe el modelo resultante con las mismas muestras de evaluación y criterios de evaluación.
Compare los resultados con los criterios que correspondan a su tarea. Compruebe si hay llamadas a herramientas erróneas, así como diferencias en la calidad de la respuesta: las limitaciones o los tiempos de espera pueden afectar a los resultados de la evaluación y a lo que aprende el modelo. El ajuste no necesariamente mejora todas las respuestas.
Para una comparación interpretable:
- Mantenga los casos de validación gobernados y retenidos y sus derivados fuera de los insumos de generación, refinamiento y capacitación. Las etiquetas de muestra por sí solas no establecen separación.
- Mantenga fijas las instrucciones, el estado de la fuente y la herramienta, el modelo y la versión, las opciones de inferencia, el contenido de la muestra y las identificaciones, los criterios de evaluación y los calificadores, y las condiciones de repetición. Cambie solo la variable que está probando. Registre los controles no disponibles y la deriva como limitaciones.
- Después del cambio de criterios, califique tanto una nueva línea de base como al candidato con los criterios revisados antes de atribuir una ganancia de calidad.
- Inspeccione la cobertura calificada, los resultados reales y la evidencia de la herramienta junto con los puntajes. Un trabajo completado no se comprueba como tarea correcta.
- Comparar la latencia y el consumo con el alcance de medición conocido; El uso faltante no es evidencia de consumo cero.
Elija una mejora enfocada
Elija por la brecha observada, no por una ruta de escalado obligatoria.
| Objetivo de mejora | Qué cambia | Decisión de realizar pruebas |
|---|---|---|
| Configuración de inferencia. | Cómo funciona un modelo fijo, sin entrenar sus pesos. | ¿Puede una estrategia diferente mejorar los resultados dentro de una latencia y un consumo aceptables? |
| Instrucciones de habilidades o criterios de evaluación. | Las instrucciones guían la ejecución; Los criterios cambian la medición y pueden afectar a la selección admitida. | ¿La brecha refleja instrucciones o estándares poco claros que necesitan revisión de expertos? |
| Entrenamiento con peso del modelo. | El modelo en sí se adapta a través del entrenamiento. | ¿Mejora el modelo entrenado su modelo base en condiciones de evaluación coincidentes? |
La referencia pública v1 se describe Simple como una ejecución, BestOfN como selección de candidatos puntuados y TreeSearch como exploración de alternativas.
Revisar cambios y aprobaciones
La revisión de expertos, la aceptación del contenido, los cambios de recursos autorizados, el permiso de la herramienta en tiempo de ejecución, el consentimiento de la operación de pago y la publicación son decisiones independientes. Inspeccione el estado actual antes de aprobar un cambio. Compruebe si la operación propone resultados o los guarda inmediatamente; Revise antes de autorizar las operaciones de guardado inmediato e inspeccione el estado guardado después.
La ruta de acceso de refinamiento pública v1 usa Training ejemplos. Al aplicar un resultado de refinamiento de criterios, se reemplaza todo el conjunto, en lugar de las sugerencias seleccionadas.
Adaptación y mantenimiento avanzados
Mediante la combinación de varias técnicas de ajuste, puede crear modelos que reflejen el tono de su organización, los patrones de finalización de tareas y los requisitos de Gobierno de datos de Microsoft Purview. Estos modelos subyacentes aplican la voz única y el conocimiento operativo de su organización a:
- Mantenga un tono y formato coherentes en todas las tareas.
- Incorpore conocimientos específicos del dominio para tareas como la redacción de documentos, el resumen y el suministro de respuestas expertas a preguntas.
- Respetar los controles de acceso y las directivas de clasificación de datos durante el entrenamiento y la inferencia.
- Genere respuestas precisas alineadas con sus estándares internos y las expectativas de los usuarios.
Todas las evaluaciones son confidenciales y se rigen por los principios de inteligencia artificial responsable de Microsoft.
Puede continuar evolucionando su agente a medida que haya nuevos datos disponibles y ajustar el modelo al:
- Cargando nuevos datos.
- Actualizar sus objetivos y métricas de evaluación para adaptarse a nuevos tipos de tareas o cambios normativos.
Cuando cambie los datos de tareas, las herramientas o los criterios de evaluación, evalúe de nuevo para evaluar el efecto. Revise los resultados, los comentarios de los usuarios y el desfase antes de decidir si se necesita un nuevo trabajo de aprendizaje. Las ediciones posteriores de habilidades, criterios o muestras no vuelven a entrenar un modelo ya producido en la referencia pública v1.