Nota
El acceso a esta página requiere autorización. Puede intentar iniciar sesión o cambiar directorios.
El acceso a esta página requiere autorización. Puede intentar cambiar los directorios.
Migre las cargas de trabajo del proceso clásico al proceso sin servidor. El proceso sin servidor controla automáticamente el aprovisionamiento, el escalado, las actualizaciones en tiempo de ejecución y la optimización.
La mayoría de las cargas de trabajo clásicas pueden migrar con cambios mínimos o sin código. Esta página se centra en esas cargas de trabajo. Algunas características, como df.cache, aún no se admiten en sin servidor, pero no requerirán cambios de código una vez disponibles. Algunas cargas de trabajo que dependen de cuadernos de R o Scala requieren proceso clásico y no podrán migrar a sin servidor. Para obtener una lista completa de las limitaciones actuales, consulte Limitaciones de proceso sin servidor.
Migrar con el agente de migración
Importante
Esta característica se encuentra en su versión beta. Los administradores de espacios de trabajo pueden activarlo desde la página de Previsualizaciones optando por la vista previa del Compute Agent . Consulte Administrar versiones preliminares de Azure Databricks.
Puedes usar un agente de migración para migrar un solo cuaderno o trabajo a computación sin servidor. El agente revisa el entorno de la carga de trabajo, las librerías, las configuraciones de Spark, las etiquetas y el código, y luego propone cada cambio como una sugerencia individual para que la aceptes o la rechaces. Los cambios aceptados se aplican en vigor y pueden revertirse.
Lo que el agente revisa y cambia
| Area | Qué hace el agente |
|---|---|
| Medio ambiente y bibliotecas | Traduce las instalaciones de bibliotecas a una especificación de entorno sin servidor, incluyendo instalaciones de %pip, scripts de inicialización de clústeres, bibliotecas de clústeres en trabajos y referencias a un índice de paquetes privado. |
| Variables de entorno | Traduce las variables del entorno del clúster a sus equivalentes sin servidor, preservando referencias secretas de espacio de trabajo y omitiendo valores gestionados por la plataforma. |
| Acceso a datos y almacenamiento | Reescribe las rutas incompatibles con el entorno sin servidor, como el disco local, dbfs:/ y las rutas de montaje, a volúmenes de Unity Catalog. El agente aplica automáticamente las reescrituras que no presentan ambigüedades y te pide que elijas un volumen cuando el destino es ambiguo. |
| Configuraciones de Spark | Clasifica cada configuración de Spark, comenta las configuraciones que son seguras para descartar, y marca y elimina configuraciones que serverless no soporta. Abarca tanto configuraciones conectadas al clúster como configuraciones en el cuaderno. |
| Código de carga de trabajo | Reescribe el código que serverless no admite en equivalentes compatibles, como operaciones de RDD reescritas como operaciones de DataFrame, y ajusta el código al comportamiento de SQL en modo ANSI en entornos serverless. |
| Etiquetas | Traduce etiquetas personalizadas de clúster, como una etiqueta de centro de costes, a sus equivalentes sin servidor. |
| Modo rendimiento | Sugiere un modo de rendimiento basado en la configuración del clúster. Consulte Elegir un modo de rendimiento. |
Requisitos
Se recomienda el acceso de administrador al espacio de trabajo para asegurar una migración completa. Esto se debe a que el agente también inspecciona los scripts globales de init a nivel de espacio de trabajo más allá de la carga de trabajo objetivo. Podrías migrar si tienes
CAN MANAGEpermiso para la carga de trabajo, pero sin permisos de administrador puede resultar en la ausencia de bibliotecas, ajustes de entorno o etiquetas.Confirma que tienes acceso al agente. Escribe
/computeen Genie Code./computeDebería aparecer en el menú de autocompletado. Si no aparece, un administrador del espacio de trabajo debe activar la vista previa en tu espacio de trabajo.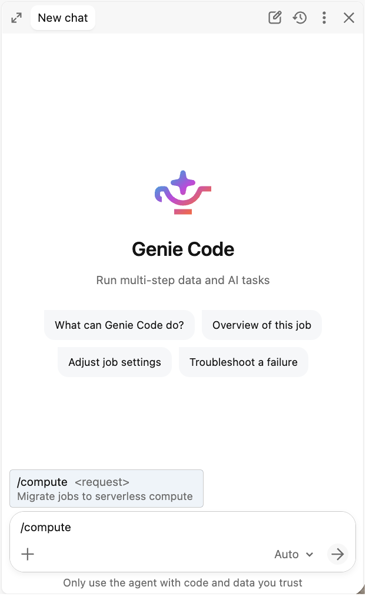
Migrar un cuaderno de notas
- Abre el cuaderno que quieres migrar.
- Abre el código Genie y ejecuta
/compute migrate to serverlessdesde la paleta/de comandos. - Revisa los hallazgos del agente. El agente escanea el entorno, las bibliotecas y el código del portátil, y propone un cambio para cada elemento que lo necesite, como mover una instalación de biblioteca a una especificación de entorno o reescribir una celda de código para ejecutarla en serverless.
- Acepta o rechaza cada cambio propuesto.
- Aplica los cambios que aceptaste. Se escriben en el cuaderno in situ.
- Conecta el portátil a serverless y ejecuta para confirmar que se comporta como esperas. Consulta Verificar una carga de trabajo migrada.
Migrar un trabajo
- Abre el trabajo al que quieres migrar.
- Abre el código Genie y ejecuta
/compute migrate to serverlessdesde la paleta/de comandos. - El agente clona tu trabajo e intenta migrar el trabajo clonado a serverless.
- Revisa los hallazgos del agente. Para un trabajo multitarea, el agente enumera cada tarea y su configuración de clúster por tarea, y propone cambios para cada una mientras preserva el calendario del trabajo.
- Acepta o rechaza cada cambio propuesto a lo largo de la superficie de migración: entorno y bibliotecas, configuraciones de Spark y cualquier código de carga de trabajo que deba cambiar.
- Aplica los cambios que aceptaste. La proceso del trabajo se cambia a sin servidor.
- Ejecuta el trabajo en serverless y confirma los resultados. Consulta Verificar una carga de trabajo migrada.
- Opcionalmente, como paso final, el agente promueve el clon migrado. Copia la configuración y los cuadernos del clon de nuevo en tu trabajo original (manteniendo el mismo ID de trabajo, horario y permisos), y luego elimina el clon. Si omites la promoción y mantienes ambas tareas, pausa la programación de la tarea que no estés ejecutando; de lo contrario, el mismo disparador activará ambas y podrá duplicar las escrituras u otros efectos secundarios.
Verifica una carga de trabajo migrada
El agente propone y aplica cambios, pero no ejecuta tu carga de trabajo ni verifica su salida. Siempre ejecuta una carga de trabajo migrada en serverless y confirma los resultados antes de depender de ella, especialmente para cargas que escriben en tablas de producción. Si el agente propone un cambio que parece incorrecto, recháchalo y envíanos feedback para que podamos mejorar al agente. Consulte Enviar comentarios de producto.
Tip
Mientras validas una carga de trabajo migrada, ejecuta en modo optimizado para el rendimiento. Arranca más rápido que el modo estándar, así que obtienes una retroalimentación más rápida al confirmar los resultados. Cambia al modo que mejor se adapte a la carga de trabajo antes de ejecutarlo en producción. Consulte Elegir un modo de rendimiento.
Cuando el agente encuentra algo que no puede migrar de forma segura, informa de un bloqueador y se detiene por defecto. Puedes instruirle explícitamente para que avance más allá de ciertos bloqueadores de compatibilidad o dependencias, pero hacerlo acepta el riesgo de que esas dependencias, atribución de costes o comportamiento en tiempo de ejecución no se transfieran, y la carga de trabajo pueda fallar en serverless.
Revertir cambios en la migración
Los cambios que aplica el agente son reversibles.
Si se trata de un cuaderno, ábrelo y restaura la revisión inmediatamente anterior a la migración. Consulte el historial de versiones en los cuadernos de Databricks.
Para un trabajo, si no promocionaste el clon migrado, tu trabajo original nunca se modificaba: ejecutarlo como antes y eliminar el clon. Si has promovido el clon, restaura a partir de la copia de seguridad que el agente creó antes de realizar ningún cambio:
- Abre la carpeta de copia de seguridad en tu espacio de trabajo principal:
/Workspace/Users/<your-username>/serverless-migration/backups/job-<job-id>/<timestamp>/. El agente mostró este camino durante la migración. Si hay varias marcas de tiempo, elige la que está justo antes de la migración. - Abre
job.yaml, que contiene la configuración de tu tarea previa a la migración, y vuelve a aplicar esa configuración a la misma tarea mediante una solicitudPOST /api/2.2/jobs/reset, que sobrescribe la configuración de la tarea con la configuración que proporciones. También puedes pegarlos en la definición JSON del trabajo en la interfaz. Esto devuelve el trabajo a la computación clásica. - Abre
mapping.yaml, que enumera cada archivo con copia de seguridad y la ruta original de la que provenía. Copia cada archivo de copia de seguridad de nuevo sobre su ruta original para deshacer las reescrituras del código. - Ejecuta el trabajo para confirmar que se comporta igual que antes de la migración.
La migración nunca borra esta copia de seguridad. Las tareas que el agente no modificó, como las provenientes de Git, SQL o dbt, se registran en job.yaml, pero sus archivos no se copian en la copia de seguridad, así que, si es necesario, restáuralos desde tu fuente de referencia.
Limitaciones conocidas
- Los siguientes se consideran bloqueadores: imágenes personalizadas, variantes de ML Runtime, versiones de Databricks Runtime anteriores a la versión 13, configuraciones de Spark que no pueden ignorarse de forma segura en entornos sin servidor y dependencias como eggs, JARs y bibliotecas de Maven. Un bloqueador significa que el agente se detiene en lugar de migrar ese elemento. Puedes resolverlo tú mismo y ejecutar la migración de nuevo, o decirle al agente que migre igualmente, lo que deja ese elemento sin resolver y puede hacer que la carga de trabajo falle en serverless.
- El agente lee scripts de inicialización almacenados en archivos del espacio de trabajo o volúmenes de Unity Catalog. Los scripts de init almacenados en ABFSS o DBFS no pueden leerse y se reportan como bloqueadores.
- El agente no inspecciona todos los atributos clásicos de cómputo. La entrega de registros del clúster y las claves SSH no se modelan y, aunque detecta muchas dependencias de puntos de montaje de DBFS a partir del código de las cargas de trabajo, no enumera ni resuelve todos los puntos de montaje.
- Las API de caché y puntos de control, las vistas temporales globales, las llamadas a la gestión de montajes DBFS y el código Scala o R son bloqueadores duros por defecto. Puedes indicar al agente que continúe, pero la funcionalidad no resuelta se mantiene sin cambios y puede fallar en serverless.
- Actualmente, los trabajos con más de 10 tareas migrables no pueden ser migrados.
- El agente migra una carga de trabajo a la vez. No existe un flujo de trabajo de descubrimiento a nivel de flota, migración masiva o aprobación administrativa.
- El agente propone cambios y aplica los que aceptas, pero no ejecuta tu carga de trabajo ni verifica la corrección de la salida. Verifica una carga de trabajo migrada antes de depender de ella para los datos de producción.
- Si la fuente de verdad de tu carga de trabajo es un Databricks Asset Bundle o una carpeta Git, el agente aplica cambios al objeto de espacio de trabajo existente. Reconcilia esos cambios con tu paquete o repositorio para que un despliegue posterior no sobrescriba la migración.
Migrar manualmente a una arquitectura sin servidor
Para migrar las cargas de trabajo de proceso clásico a proceso sin servidor, siga estos pasos:
- Compruebe los requisitos previos: compruebe que el acceso al área de trabajo, las redes y el almacenamiento en la nube cumplen los requisitos. Consulte Antes de empezar.
- Código de actualización: realice los cambios necesarios en el código y la configuración. Consulte Actualización del código.
- Probar las cargas de trabajo: validar la compatibilidad y la integridad antes de realizar la transacción. Consulte Prueba de las cargas de trabajo.
- Elija un modo de rendimiento: seleccione el modo de rendimiento que mejor se adapte a los requisitos de la carga de trabajo. Consulte Elegir un modo de rendimiento.
- Migración en fases: implemente incrementalmente sin servidor, empezando por cargas de trabajo nuevas y de bajo riesgo. Consulte Migración en fases.
- Supervisar los costos: realice un seguimiento del consumo de DBU sin servidor y configure alertas. Consulte Supervisión de los costos.
Antes de empezar
Antes de empezar a migrar, es posible que tenga que actualizar algunas configuraciones heredadas en el área de trabajo.
| Prerrequisito | Acción | Detalles |
|---|---|---|
| Espacio de trabajo está habilitado para Unity Catalog | Migración desde Metastore de Hive si es necesario | Upgrade un área de trabajo de Azure Databricks a Unity Catalog |
| Redes configuradas | Sustituir el emparejamiento de VPC por NCC, Private Link o reglas de firewall | Redes de plano de proceso sin servidor |
| Acceso al almacenamiento en la nube | Reemplazar patrones de acceso a datos heredados por ubicaciones externas del catálogo de Unity | Conexión al almacenamiento de objetos en la nube mediante el catálogo de Unity |
Confirme que el área de trabajo está en una región admitida.
Actualización del código
En las secciones siguientes se enumeran los cambios de código y configuración necesarios para que las cargas de trabajo sean compatibles con sin servidor.
Acceso a datos
Los patrones de acceso a datos heredados no son compatibles en entornos sin servidor. Actualice el código para usar el catálogo de Unity en su lugar.
| Patrón clásico | Reemplazo sin servidor | Detalles |
|---|---|---|
Rutas de acceso de DBFS (dbfs:/...) |
Volúmenes del catálogo de Unity | ¿Qué son los volúmenes del catálogo de Unity? |
| Tablas del Metastore Hive | Tablas de Unity Catalog (o federación HMS) | Upgrade un área de trabajo de Azure Databricks a Unity Catalog |
| Credenciales de la cuenta de almacenamiento | Ubicaciones externas del Catálogo de Unity | Conexión al almacenamiento de objetos en la nube mediante el catálogo de Unity |
| JDBC JAR personalizados | Federación de Lakehouse | ¿Qué es la federación de consultas? |
Advertencia
El acceso a DBFS está limitado en modo sin servidor. Actualice todas las dbfs:/ rutas de acceso a los volúmenes del catálogo de Unity antes de migrar. Para obtener más información, consulte Migración de archivos almacenados en DBFS.
Ejemplo: Reemplazar las rutas de acceso de DBFS y las referencias de Metastore de Hive
# Classic
df = spark.read.csv("dbfs:/mnt/datalake/data.csv", header=True)
df.write.parquet("dbfs:/mnt/output/results")
df = spark.table("my_database.my_table")

# Serverless
df = spark.read.csv("/Volumes/main/sales/raw_data/data.csv", header=True)
df.write.parquet("/Volumes/main/analytics/output/results")
df = spark.table("main.my_database.my_table")  # three-level namespace
API y código
Algunas API y patrones de código no se admiten en un entorno sin servidor. Haga referencia a esta tabla para ver si el código debe actualizarse.
| Patrón clásico | Reemplazo sin servidor | Detalles |
|---|---|---|
API de RDD (sc.parallelize, rdd.map) |
API de DataFrame | Comparación de Spark Connect con Spark classic |
df.cache(), df.persist() |
Eliminar llamadas de almacenamiento en caché | Limitaciones de proceso sin servidor |
spark.sparkContext, sqlContext |
Use spark (SparkSession) directamente |
Comparación de Spark Connect con Spark classic |
Variables de Hive (${var}) |
SQL DECLARE VARIABLE o cadenas f de Python |
DECLARE VARIABLE |
| Configuraciones de Spark no admitidas | Quite las configuraciones no admitidas. La mayoría de las configuraciones se ajusta automáticamente sin servidor. | Configuración de las propiedades de Spark para cuadernos y trabajos sin servidor |
Ejemplo: Reemplazar las operaciones RDD por DataFrames
from pyspark.sql import functions as F

# sc.parallelize + rdd.map
# Classic:  rdd = sc.parallelize([1, 2, 3]); rdd.map(lambda x: x * 2).collect()
df = spark.createDataFrame([(1,), (2,), (3,)], ["value"])
result = df.select((F.col("value") * 2).alias("value")).collect()

# rdd.flatMap
# Classic:  sc.parallelize(["hello world"]).flatMap(lambda l: l.split(" ")).collect()
df = spark.createDataFrame([("hello world",)], ["line"])
words = df.select(F.explode(F.split("line", " ")).alias("word")).collect()

# rdd.groupByKey
# Classic:  rdd.groupByKey().mapValues(list).collect()
df = spark.createDataFrame([("a", 1), ("b", 2), ("a", 3)], ["key", "value"])
grouped = df.groupBy("key").agg(F.collect_list("value").alias("values")).collect()

# rdd.mapPartitions → applyInPandas
import pandas as pd
def process_group(pdf: pd.DataFrame) -> pd.DataFrame:
    return pd.DataFrame({"total": [pdf["id"].sum()]})
result = (spark.range(100).repartition(4)
    .groupBy(F.spark_partition_id())
    .applyInPandas(process_group, schema="total long").collect())

# sc.textFile → spark.read.text
df = spark.read.text("/Volumes/catalog/schema/volume/file.txt")
Ejemplo: Reemplazar SparkContext y almacenamiento en caché
from pyspark.sql.functions import broadcast

# sc.broadcast → broadcast join
result = main_df.join(broadcast(lookup_df), "key")

# sc.accumulator → DataFrame aggregation
total = df.agg(F.sum("amount")).collect()[0][0]

# sqlContext.sql → spark.sql
result = spark.sql("SELECT * FROM main.db.table")

# df.cache() → remove caching calls
# Materialize expensive intermediate results to Delta as a workaround:
df = spark.read.parquet(path)
result = df.filter("status = 'active'")
expensive_df.write.format("delta").mode("overwrite").saveAsTable("main.scratch.temp")
result = spark.table("main.scratch.temp")
Bibliotecas y entornos
Puede administrar bibliotecas y entornos en el nivel de área de trabajo mediante entornos base y en el nivel de cuaderno mediante el entorno sin servidor del cuaderno.
| Patrón clásico | Reemplazo sin servidor | Detalles |
|---|---|---|
| Scripts de inicialización | Entornos sin servidor | Configuración del entorno sin servidor |
| Bibliotecas con ámbito de clúster | Bibliotecas con ámbito de cuaderno o de entorno | Configuración del entorno sin servidor |
| Bibliotecas de Maven/JAR | Compatibilidad con tareas JAR para trabajos; PyPI para cuadernos | Tarea JAR para trabajos |
| Contenedores de Docker | Entornos sin servidor para necesidades de biblioteca | Configuración del entorno sin servidor |
Fije paquetes de Python en requirements.txt para entornos reproducibles. Consulte Especificar versiones del paquete de Python.
Transmisión en línea
Las cargas de trabajo de streaming son compatibles en el entorno sin servidor, pero ciertos desencadenadores no se admiten. Actualice el código para usar los desencadenadores admitidos.
| Desencadenador de Spark | Soportado | Notas |
|---|---|---|
Trigger.AvailableNow() |
Sí | Recomendado |
Trigger.Once() |
Sí | Esto está obsoleto. Utilice Trigger.AvailableNow() en su lugar. |
Trigger.ProcessingTime(interval) |
No | Devuelve INFINITE_STREAMING_TRIGGER_NOT_SUPPORTED |
Trigger.Continuous(interval) |
No | Utilice el modo continuo de Lakeflow pipelines en su lugar |
Valor predeterminado (sin establecer .trigger()) |
No | Omitir .trigger() predetermina a ProcessingTime("0 seconds"), lo cual no es compatible en entornos sin servidor. Siempre establezca .trigger(availableNow=True) explícitamente. |
Para streaming continuo, migre a canalizaciones declarativas de Spark en modo continuo o use trabajos de programación continua con AvailableNow. Para orígenes grandes, establezca maxFilesPerTrigger o maxBytesPerTrigger para evitar errores de falta de memoria.
Ejemplo: Corrección de desencadenadores de streaming
# Classic (not supported on serverless — default trigger is ProcessingTime)
query = df.writeStream.format("delta").outputMode("append").start()

# Serverless (explicit AvailableNow trigger)
query = (df.writeStream.format("delta").outputMode("append")
    .trigger(availableNow=True)
    .option("checkpointLocation", checkpoint_path)
    .start(output_path))
query.awaitTermination()

# With OOM prevention for large sources
query = (spark.readStream.format("delta")
    .option("maxFilesPerTrigger", 100)
    .option("maxBytesPerTrigger", "10g")
    .load(input_path)
    .writeStream.format("delta")
    .trigger(availableNow=True)
    .option("checkpointLocation", checkpoint_path)
    .start(output_path))
Prueba de las cargas de trabajo
- Prueba de compatibilidad rápida: ejecute la carga de trabajo en el proceso clásico con el modo de acceso estándar y Databricks Runtime 14.3 o superior. Si la ejecución se ejecuta correctamente, la carga de trabajo puede migrar a sin servidor sin cambios en el código.
- Comparación A/B (recomendada para producción): ejecute la misma carga de trabajo en el clásico (control) y sin servidor (experimento). Comparar tablas de salida y verificar la corrección. Iteración hasta que las salidas coincidan.
- Configuraciones temporales: puede establecer temporalmente configuraciones de Spark admitidas durante las pruebas. Quítelos una vez que sean estables.
Elegir un modo de rendimiento
Los trabajos y canalizaciones sin servidor admiten dos modos de rendimiento: estándar y optimizados para el rendimiento. El modo de rendimiento que elija depende de los requisitos de carga de trabajo.
| Mode | Availability | Startup | Más adecuado para |
|---|---|---|---|
| Estándar | Trabajos, pipelines de Lakeflow | 4-6 minutos | Lote sensible a los costos |
| Optimizado para el rendimiento | Cuadernos, trabajos, pipelines de Lakeflow | Segundos | Interactivo, sensible a la latencia |
Migración en fases
- Nuevas cargas de trabajo: Comience todos los cuadernos y trabajos nuevos en modalidad sin servidor.
- Cargas de trabajo de bajo riesgo: migre cargas de trabajo de PySpark/SQL ya en modo de acceso estándar y Databricks Runtime 14.3 o superior.
- Cargas de trabajo complejas: migre las cargas de trabajo que necesitan cambios de código (reescrituras de RDD, actualizaciones de DBFS, correcciones de desencadenadores).
- Cargas de trabajo restantes: revise periódicamente a medida que se expandan las funcionalidades.
Supervisión de costos
La facturación sin servidor se basa en el consumo de DBU, no en el tiempo de actividad del clúster. Valide las expectativas de costos con cargas de trabajo representativas antes de migrar a escala. Para obtener herramientas y estrategias para supervisar los costos sin servidor, consulte Supervisión del costo del proceso sin servidor.
Recursos adicionales
- Procedimientos recomendados para el proceso sin servidor: sugerencias de optimización para cargas de trabajo sin servidor
- Limitaciones de proceso sin servidor: lista completa de las limitaciones actuales y las características no admitidas
- Configuración del entorno sin servidor: Administración de bibliotecas y dependencias
- Configuraciones de Spark admitidas: configuraciones de Spark disponibles en serverless
- Spark Connect frente a Spark clásico: diferencias de comportamiento en la arquitectura sin servidor
- Seguridad de red sin servidor: NCC, Private Link y configuración del firewall
- Notas de la versión de computación sin servidor: Realizar un seguimiento de las nuevas capacidades a medida que se lanzan
- Guía de actualización del catálogo de Unity: Migración desde Metastore de Hive al catálogo de Unity
También puede consultar las siguientes entradas de blog para obtener más información:
- ¿Qué es la informática sin servidor?: Información general sobre las funcionalidades sin servidor y los resultados del cliente
- Evolución de la ingeniería de datos: Cómo la computación sin servidor está transformando cuadernos y trabajos de Lakeflow: Cómo el procesamiento sin servidor impulsa los trabajos y canalizaciones de Lakeflow