Remarque
L’accès à cette page requiert une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page requiert une autorisation. Vous pouvez essayer de modifier des répertoires.
Contrôlez la fréquence à laquelle votre application envoie des requêtes à un service afin de rester dans les limites de limitation du débit ainsi que dans la capacité globale du service. Cette approche vous permet d’éviter ou de réduire les erreurs liées à la limitation du débit et de prévoir plus précisément le débit.
La limitation du débit est appropriée dans de nombreux scénarios, mais il est particulièrement utile pour les tâches automatisées répétitives à grande échelle telles que le traitement par lots.
Contexte et problème
L’exécution d’un grand nombre d’opérations sur un service limité peut entraîner une augmentation du trafic et un débit réduit, car vous devez suivre les demandes rejetées, puis réessayer les opérations. À mesure que le nombre d’opérations augmente, une limite de limitation peut nécessiter plusieurs passes de renvoi de données, ce qui entraîne un impact plus important sur les performances.
Par exemple, prenons le processus problématique suivant de nouvelle tentative en cas d’erreur pour l’ingestion de données dans Azure Cosmos DB :
Votre application doit ingérer 10 000 enregistrements dans Azure Cosmos DB. Chaque enregistrement coûte 10 unités de requête (RU) à ingérer, donc un total de 100 000 UNITÉS de requête est nécessaire pour terminer le travail.
Votre instance Azure Cosmos DB dispose d’une capacité approvisionnée de 20 000 RUs.
Vous envoyez les 10 000 enregistrements au service Azure Cosmos DB. Celui-ci écrit correctement 2 000 enregistrements et en rejette 8 000.
Vous renvoyez les 8 000 enregistrements restants au service Azure Cosmos DB. Celui-ci écrit correctement 2 000 enregistrements et en rejette 6 000.
Vous renvoyez les 6 000 enregistrements restants au service Azure Cosmos DB. Celui-ci écrit correctement 2 000 enregistrements et en rejette 4 000.
Vous renvoyez les 4 000 enregistrements restants au service Azure Cosmos DB. Celui-ci écrit correctement 2 000 enregistrements et en rejette 2 000.
Vous renvoyez les 2 000 enregistrements restants au service Azure Cosmos DB. Tous ont été écrits avec succès.
Le travail d’ingestion se termine correctement, mais seulement après l’envoi de 30 000 enregistrements à Azure Cosmos DB. L’ensemble du jeu de données se compose uniquement de 10 000 enregistrements.
Il existe d’autres facteurs à prendre en compte dans cet exemple :
Un grand nombre d’erreurs peut également entraîner un travail supplémentaire pour consigner ces erreurs et traiter les données de journal résultantes. L’approche précédente gère 20 000 erreurs et la journalisation de ces erreurs peut imposer un coût de traitement, de mémoire ou de ressource de stockage.
Étant donné que vous ne connaissez pas les limites de limitation du service d’ingestion, vous n’avez pas de moyen de définir les attentes quant au temps nécessaire au traitement des données. Une limitation de débit peut vous permettre de calculer le temps requis pour l’ingestion.
Solution
Une limitation de débit peut réduire votre trafic, voire améliorer le débit en réduisant le nombre d’enregistrements envoyés à un service sur une période donnée.
Un service peut limiter les demandes en fonction de différentes métriques au fil du temps, telles que :
- Nombre d’opérations (par exemple, 20 requêtes par seconde).
- Quantité de données (par exemple, 2 Gio par minute).
- Le coût relatif des opérations (par exemple, 20 000 RU par seconde).
Quelle que soit la métrique que vous utilisez pour la limitation, votre implémentation de limitation de débit implique le contrôle du nombre et/ou de la taille des opérations envoyées au service pendant une période spécifique. La limitation du débit optimise votre utilisation du service sans dépasser sa capacité de limitation.
Dans les scénarios où vos API peuvent gérer les requêtes plus rapidement que ce que permettent les services d'ingestion limités par le débit, vous devez contrôler la vitesse à laquelle vous utilisez le service. Traiter la restriction uniquement comme une incompatibilité de débit de données et mettre en mémoire tampon les demandes d’ingestion jusqu’à ce que le service se rétablisse crée un risque. Si votre application cesse de répondre dans ce scénario, toutes les données mises en mémoire tampon peuvent être perdues.
Pour éviter ce risque, envisagez d’envoyer vos enregistrements à un système de messagerie durable qui peut gérer votre débit d’ingestion complet (Les services tels que Azure Event Hubs peuvent gérer des millions d’opérations par seconde.) Vous pouvez ensuite utiliser un ou plusieurs processeurs de travaux pour lire les enregistrements du système de messagerie à un débit contrôlé qui se trouve dans les limites du service limité. L’envoi d’enregistrements au système de messagerie permet d’économiser de la mémoire interne ne vous permettant d’extraire de la file d’attente que les enregistrements qui peuvent être traités pendant un intervalle de temps donné.
Azure fournit quelques services de messagerie durables que vous pouvez utiliser avec ce modèle, savoir :
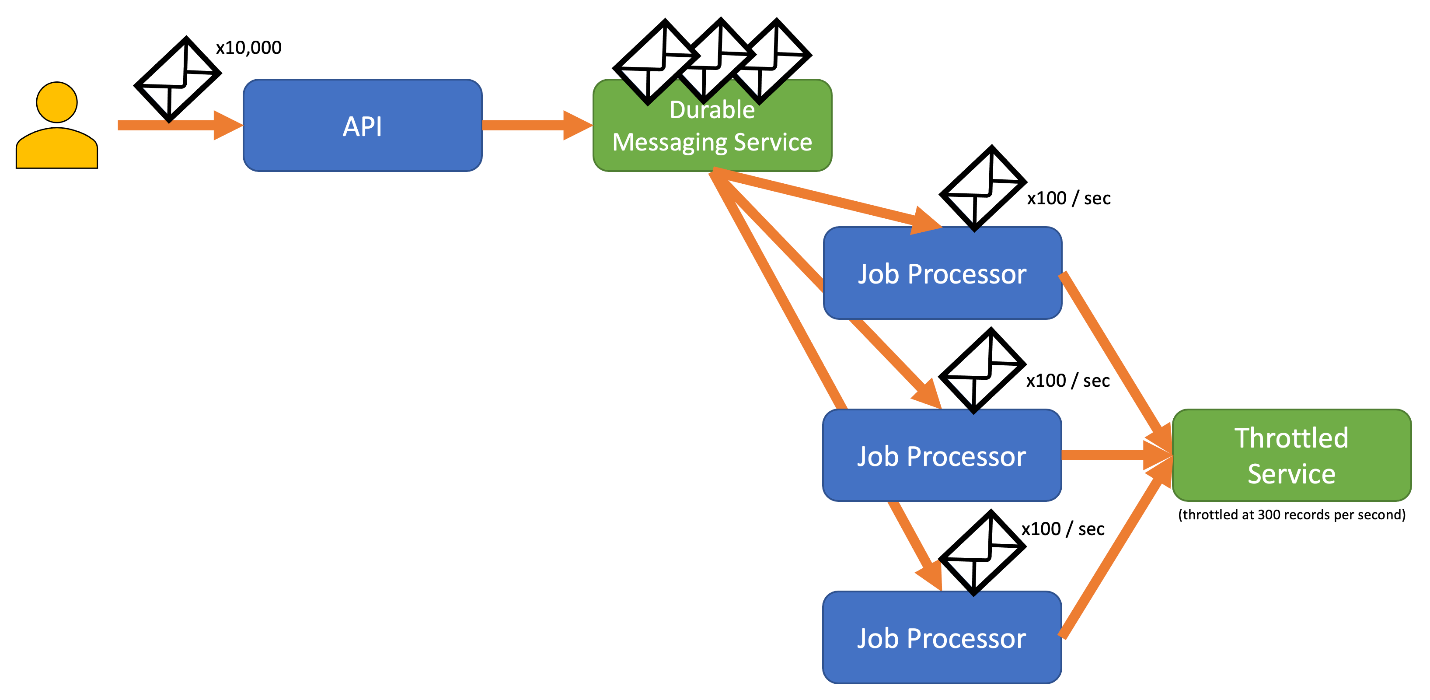
Lorsque vous envoyez des enregistrements, la période que vous utilisez pour les émettre peut être plus fine que la période sur laquelle le service applique une limitation de débit. Les systèmes définissent souvent des limitations en fonction des intervalles de temps que vous pouvez facilement comprendre et utiliser. Toutefois, pour l’ordinateur exécutant un service, ces délais peuvent être très longs par rapport à la vitesse à laquelle il peut traiter des informations. Par exemple, un système peut appliquer une limitation par seconde ou par minute, alors que la vitesse d’exécution du code est généralement de l’ordre de quelques nanosecondes ou millisecondes.
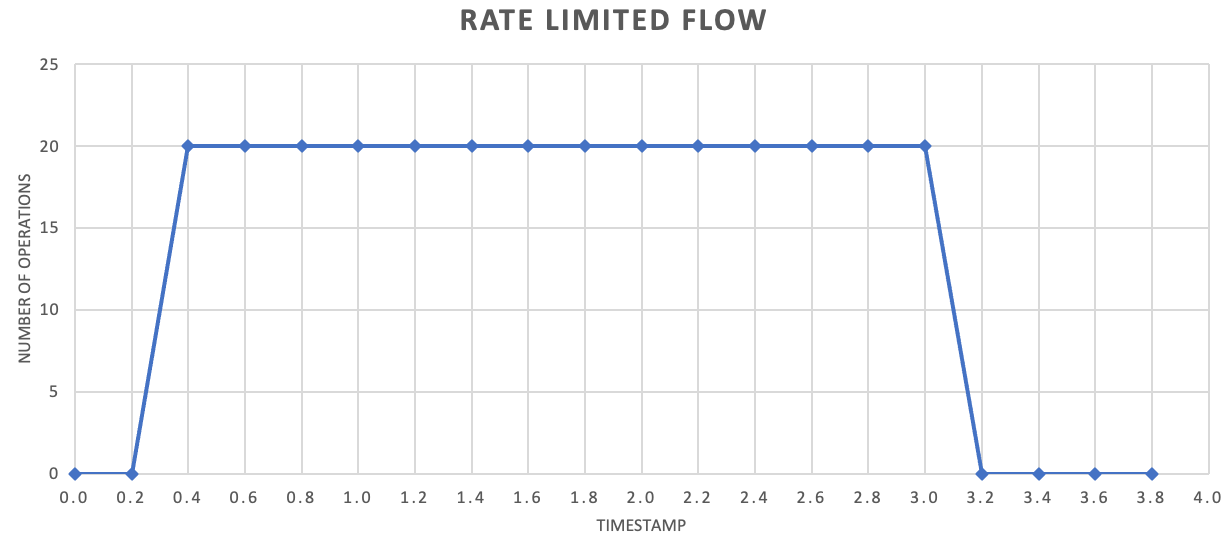
Bien qu’il ne soit pas nécessaire, il est souvent recommandé d’envoyer un plus petit nombre d’enregistrements plus fréquemment pour améliorer le débit. Par conséquent, au lieu d’essayer de regrouper des enregistrements en lots pour une publication une fois par seconde ou une fois par minute, vous pouvez procéder avec une granularité plus fine afin de maintenir une consommation de vos ressources (mémoire, processeur et réseau) à un rythme plus régulier. Cette approche empêche les goulots d’étranglement potentiels causés par des rafales soudaines de requêtes. Par exemple, si un service autorise 100 opérations par seconde, l’implémentation d’un limiteur de débit peut réguler les requêtes en libérant 20 opérations toutes les 200 millisecondes, comme illustré dans le graphique suivant.
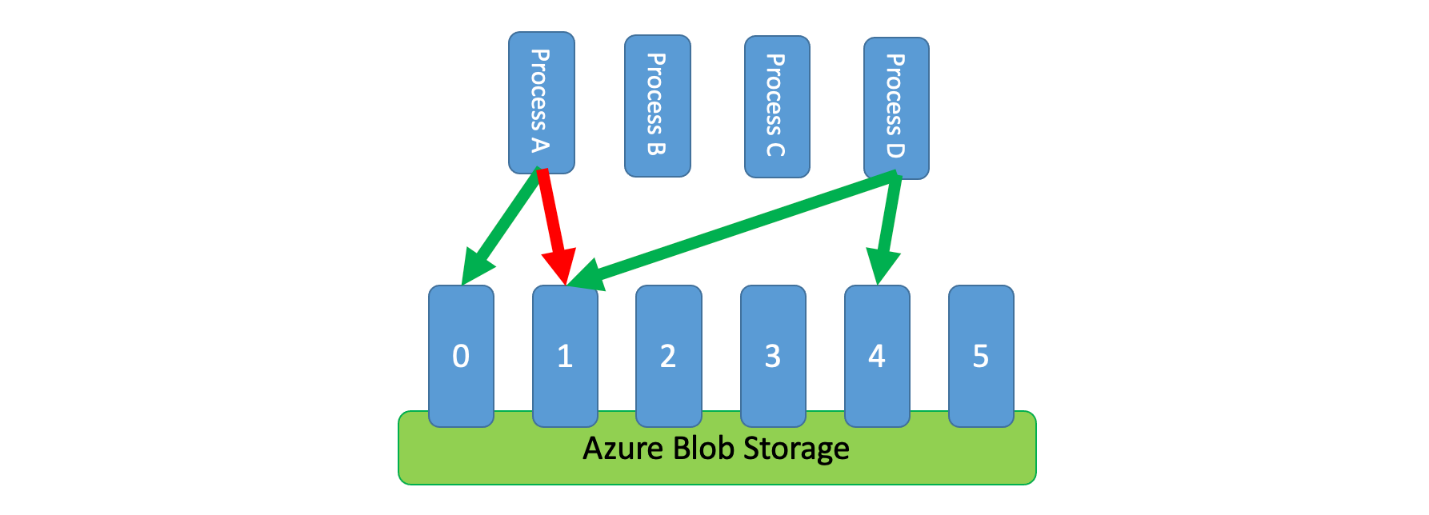
Par ailleurs, il est parfois nécessaire que plusieurs processus non coordonnés partagent un service limité. Pour implémenter la limitation de débit dans ce scénario, vous pouvez partitionner logiquement la capacité du service, puis utiliser un système d’exclusion mutuelle distribuée pour gérer les verrous exclusifs sur ces partitions. Les processus non coordonnés peuvent alors se disputer les verrous sur ces partitions chaque fois qu’ils ont besoin de capacité. Une certaine capacité est allouée à chaque partition pour laquelle un processus détient un verrou.
Par exemple, si le système limité autorise 500 requêtes par seconde, vous pouvez créer 20 partitions pour 25 requêtes par seconde chacune. Si un processus doit émettre 100 requêtes, il peut demander quatre partitions au système d’exclusion mutuelle distribuée. Le système peut accorder deux partitions pendant 10 secondes. Le processus limite alors le débit à 50 requêtes par seconde, accomplit la tâche en deux secondes, puis libère le verrou.
Une façon d’implémenter ce modèle consiste à utiliser stockage Azure. Dans ce scénario, vous créez un blob de 0 octet par partition logique dans un conteneur. Vos applications peuvent alors obtenir des baux exclusifs directement sur ces blobs pendant une brève période de temps (par exemple, 15 secondes). Pour chaque bail accordé à une application, elle peut utiliser la quantité de capacité de cette partition. L’application doit ensuite suivre l’heure du bail afin que, lorsque l’heure expire, l’application puisse cesser d’utiliser la capacité qu’elle a accordée. Lorsque vous implémentez ce modèle, vous voudrez souvent que chaque processus tente de prendre en bail une partition choisie au hasard lorsqu’il a besoin de capacité.
Pour réduire encore davantage la latence, vous pouvez allouer une petite quantité de capacité exclusive à chaque processus. Un processus ne cherche alors à obtenir un bail sur une capacité partagée que s’il a besoin de dépasser sa capacité réservée.
En guise d’alternative à stockage Azure, vous pouvez également implémenter ce type de système de gestion des baux à l’aide de technologies telles que ZooKeeper, etcd, et Redis/Redsync.
Problèmes et considérations
Tenez compte des points suivants lorsque vous décidez comment implémenter ce modèle :
Bien que le modèle de limitation de débit puisse réduire le nombre d’erreurs de limitation, votre application doit toujours gérer correctement les erreurs de limitation qui peuvent se produire.
Vérifiez que les nouvelles tentatives sont coordonnées avec la limitation du débit. Les tentatives de nouvelle exécution aveugles ou excessivement agressives peuvent augmenter la charge et créer des tempêtes de tentatives ; il faut donc propager les signaux de contre-pression (par exemple, HTTP 429 avec
Retry-After) et limiter le nombre de tentatives de nouvelle exécution, avec de courts délais aléatoires entre chaque tentative.Si votre application a plusieurs flux de travail qui accèdent au même service limité, vous devez les intégrer à votre stratégie de limitation de débit. Par exemple, vous pouvez prendre en charge le chargement en masse d’enregistrements dans une base de données, mais aussi l’exécution de requêtes sur les enregistrements de cette même base de données. Vous pouvez gérer la capacité en vous assurant que tous les flux de travail sont gérés par le biais du même mécanisme de limitation de débit. Vous pouvez également réserver des pools de capacité distincts pour chaque flux de travail.
Un service bridé peut être utilisé dans plusieurs applications. Dans certains cas, il est possible de coordonner cette utilisation (comme indiqué précédemment dans cet article). Si vous commencez à constater un nombre d’erreurs de limitation du débit plus élevé que prévu, cela peut indiquer une contention entre des applications qui accèdent à un service. Dans ce cas, vous devrez peut-être envisager de réduire temporairement le débit imposé par votre mécanisme de limitation de débit jusqu’à ce que l’utilisation d’autres applications diminue.
Quand utiliser ce modèle
Utilisez ce modèle dans les situations suivantes :
Vous devez réduire les erreurs de limitation du débit renvoyées par un service soumis à une limitation de débit.
Vous souhaitez minimiser le trafic, par rapport à des approches naïves de relance en cas d'erreur.
Vous devez réduire la consommation de mémoire en supprimant les enregistrements uniquement lorsqu’il y a suffisamment de capacité pour les traiter.
Ce modèle peut ne pas convenir lorsque :
L’opération nécessite une exécution immédiate et synchrone avec une latence très faible et ne peut pas tolérer la mise en file d’attente ou le traitement différé.
Le principal goulot d’étranglement n’est pas le débit de requêtes, mais plutôt le parallélisme ou la contention des ressources (par exemple, la saturation du processeur ou des tâches longues toujours en cours d’exécution). Dans ces cas, les contrôles de mise à l’échelle ou d’accès concurrentiel sont plus appropriés.
Conception de la charge de travail
Évaluez comment utiliser le modèle de limitation de débit dans la conception d'une charge de travail pour répondre aux objectifs et principes abordés dans les piliers de l'infrastructure Azure Well-Architected. Le tableau suivant fournit des conseils sur la façon dont ce modèle prend en charge les objectifs de chaque pilier.
| Pilier | Comment ce modèle soutient les objectifs des piliers. |
|---|---|
| Les décisions de conception de fiabilité aident votre charge de travail à devenir résiliente au dysfonctionnement et à s’assurer qu’elle se rétablit dans un état entièrement opérationnel après une défaillance. | Cette tactique protège le client en reconnaissant et en respectant les limitations et les coûts de communication avec un service lorsque le service préfère éviter une utilisation excessive. - RE :07 Autopréservation |
Si ce modèle introduit des compromis au sein d’un pilier, considérez-les contre les objectifs des autres piliers.
Example
L’exemple d’application suivant permet aux utilisateurs d’envoyer des enregistrements de divers types à une API. Chaque type d’enregistrement a un processeur de travaux unique qui effectue les étapes suivantes :
- Validation
- Enrichissement
- Insertion de l’enregistrement dans la base de données
Tous les composants de l’application (API, processeur de travaux A et processeur de travaux B) sont des processus distincts qui peuvent être mis à l’échelle indépendamment. Les processus ne communiquent pas directement entre eux.
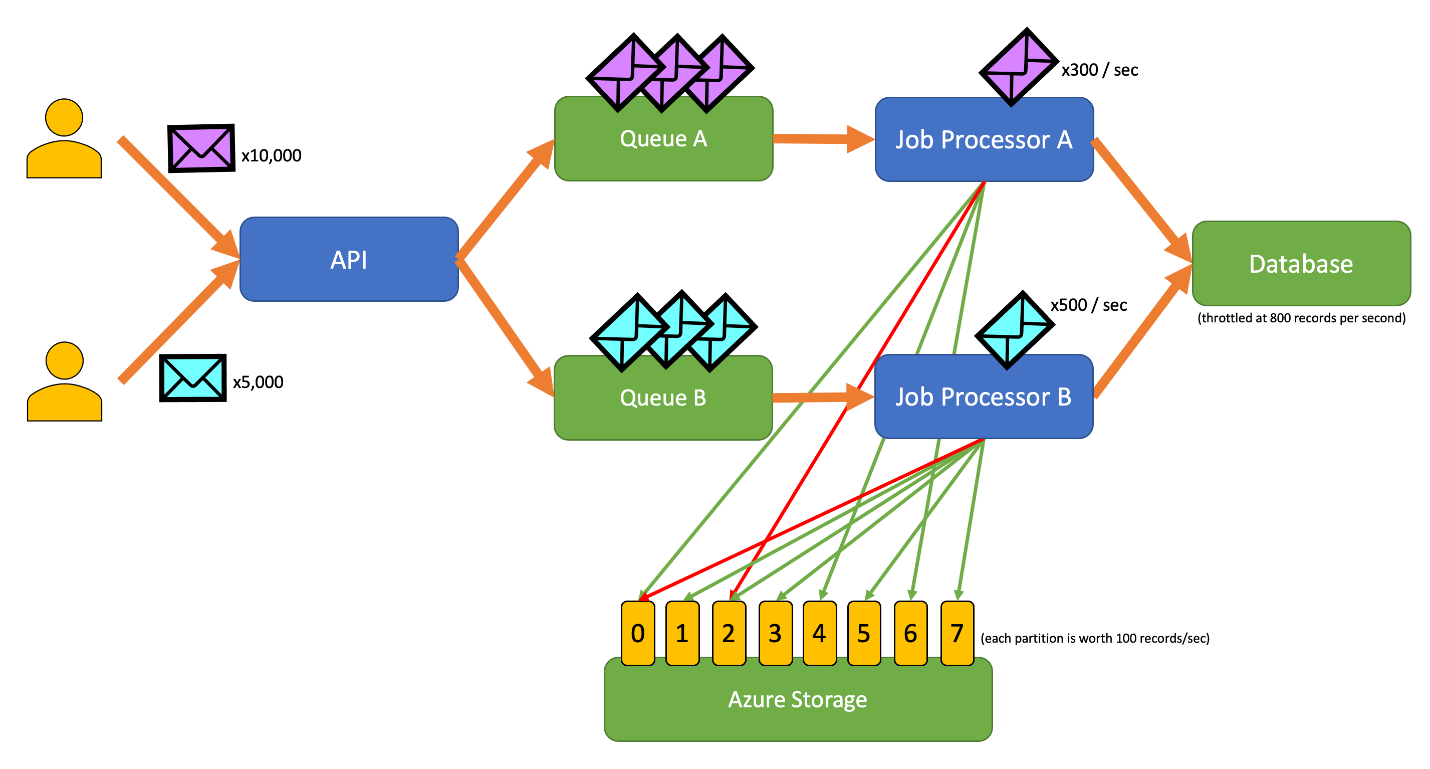
Dans cet exemple, chaque bail de blob représente une part fixe du débit autorisé de la base de données. Un processeur ne peut extraire de la file d’attente et écrire qu’à un débit correspondant à la somme des débits des baux qu’il détient actuellement. À mesure que les processeurs gagnent ou perdent des baux au fil du temps, leur taux d’écriture autorisé change, ce qui maintient le trafic total de la base de données dans la limite configurée tout en permettant à toutes les tâches en attente de progresser.
Ce diagramme incorpore le flux de travail suivant :
- Un utilisateur envoie 10 000 enregistrements de type A à l’API.
- L’API met en file d’attente ces 10 000 enregistrements dans la file d’attente A.
- Un utilisateur envoie 5 000 enregistrements de type B à l’API.
- L’API met en file d’attente ces 5 000 enregistrements dans la file d’attente B.
- Le processeur de tâches A constate que la file d’attente A contient des enregistrements et tente d’acquérir un bail exclusif sur le blob 2.
- Le processeur de tâches B constate que la file d’attente B contient des enregistrements et tente d’obtenir un bail exclusif sur le blob 2.
- Le processeur de tâches A ne parvient pas à obtenir le bail.
- Le processeur de tâches B obtient le bail sur l’objet blob 2 pendant 15 secondes. Il peut à présent limiter le débit des requêtes adressées à la base de données, à 100 requêtes par seconde.
- Le processeur de tâches B retire 100 enregistrements de la file d’attente B, puis les écrit.
- Une seconde s’écoule.
- Le processeur de tâches A voit que la file d’attente A contient davantage d’enregistrements et tente d’obtenir un bail exclusif sur le blob 6.
- Le processeur de tâches B voit que la file d’attente B contient davantage d’enregistrements et tente d’obtenir un bail exclusif sur le blob 3.
- Le processeur de tâches A acquiert un bail sur le blob 6 pendant 15 secondes. Il peut à présent limiter le débit des requêtes adressées à la base de données, à 100 requêtes par seconde.
- Le processeur de tâches B obtient un bail sur le blob 3 pendant 15 secondes. Il peut à présent limiter le débit des requêtes adressées à la base de données, à 200 requêtes par seconde. (Il conserve également le bail pour le blob 2.)
- Le processeur de tâches A retire 100 enregistrements de la file d’attente A puis les écrit.
- Le processeur de tâches B retire 200 enregistrements de la file d’attente B et les écrit.
- Une seconde s’écoule.
- Le processeur de tâches A voit que la file d’attente A contient davantage d’enregistrements et tente d’obtenir un bail exclusif sur le blob 0.
- Le processeur de tâches B en file d’attente B contient davantage d’enregistrements, et tente d’obtenir un bail exclusif sur le blob 1.
- Le processeur de tâches A acquiert le bail du blob 0 pendant 15 secondes. Il peut à présent limiter le débit des requêtes adressées à la base de données, à 200 requêtes par seconde. (Il conserve également le bail pour le blob 6.)
- Le processeur de tâches B obtient un bail sur le blob 1 pendant 15 secondes. Il peut à présent limiter le débit des requêtes adressées à la base de données, à 300 requêtes par seconde. (Il conserve également le bail pour les blobs 2 et 3.)
- Le processeur de tâches A retire 200 enregistrements de la file d’attente A puis les écrit.
- Le processeur de tâches B retire 300 enregistrements de la file d’attente B et les écrit.
- Et ainsi de suite.
Après 15 secondes, un ou les deux travaux ne seront toujours pas terminés. À mesure que les baux expirent, un processeur doit également réduire le nombre de requêtes qu’il extrait et écrit.
 Les implémentations de ce modèle sont disponibles dans différents langages de programmation :
Étapes suivantes
Les conseils suivants peuvent également être pertinents lorsque vous implémentez ce modèle :
Limitation avancée des requêtes avec Gestion des API Azure. Utilisez-le comme contrôle d’admission complémentaire en périphérie pour appliquer des limites de taux d’appel et des quotas par clé, et pour renvoyer aux clients des signaux cohérents de limitation.
Choisir entre les différents services de messagerie Azure. Choisissez la meilleure infrastructure de messagerie durable pour la mise en tampon et l’ingestion contrôlée.
Gérez les erreurs temporaires dans les applications Azure. Concevoir un comportement de nouvelle tentative afin que les clients se désactivent correctement lorsque les limites sont atteintes.
Ressources associées
Les modèles et conseils suivants peuvent également être pertinents lorsque vous implémentez ce modèle :
Throttling. Le modèle de limitation de débit est généralement implémenté en réponse à un service limité.
Retry. Lorsque des requêtes adressées à un service soumis à une limitation de débit entraînent des erreurs de limitation du débit, il est généralement approprié de réessayer ces requêtes après un délai approprié.
Lissage de charge basé sur les files d’attente est similaire au modèle de limitation du débit, mais diffère sur plusieurs points essentiels :
Une limitation de débit n’a pas nécessairement besoin d’utiliser des files d’attente pour gérer la charge, mais elle a besoin d’utiliser un service de messagerie durable. Par exemple, un modèle de limitation de débit peut utiliser des services comme Apache Kafka ou Event Hubs.
Le modèle de limitation du débit introduit le concept d’un système d’exclusion mutuelle distribué entre des partitions, ce qui vous permet de gérer la capacité allouée à plusieurs processus non coordonnés qui communiquent avec le même service soumis à une limitation de débit.
Un modèle de niveau de charge Queue-Based s’applique chaque fois qu’il existe une incompatibilité des performances entre les services ou que vous souhaitez améliorer la résilience. Il s’agit donc d’un modèle plus large que la limitation de débit, qui est plus spécifiquement préoccupé par l’accès efficace à un service limité.