Remarque
L’accès à cette page requiert une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page requiert une autorisation. Vous pouvez essayer de modifier des répertoires.
Important
Cette fonctionnalité est en version bêta. Pour l’utiliser, un administrateur d’espace de travail doit activer Agent Memory Sessions depuis la page Previews. Consultez Gérer les préversions d’Azure Databricks.
La mémoire des agents donne à vos agents une mémoire à long terme qui persiste à travers les conversations. Azure Databricks stocke la mémoire dans Lakebase et gère le stockage, l’indexation et la recherche pour vous, afin que vos agents puissent se souvenir des préférences utilisateur, des décisions passées et du contexte accumulé sans que vous ayez à gérer une base de données.
Note
Lors de la prévisualisation, vous êtes facturé pour l’instance Lakebase sous-jacente qui stocke vos entrées mémoire. Aucuns frais supplémentaire ne s’applique à la mémoire d’agent elle-même. Les tarifs peuvent évoluer au fur et à mesure de l’avancement de la prévisualisation.
Utilisez la mémoire des agents lorsque vous souhaitez que vos agents :
- Gardez à l’esprit les préférences des utilisateurs, les faits et les décisions issues des conversations séparées.
- Personnalisez les réponses en fonction de ce qu’un agent a appris lors des sessions précédentes.
- Partagez les connaissances accumulées entre agents et projets.
- Améliorez la précision et l’efficacité au fil du temps.
La mémoire des agents fonctionne avec des agents construits sur n’importe quel framework. Pour un historique de conversation à court terme au sein d’une seule interaction, utilisez des sessions d’agent. Pour une vue d’ensemble de la façon dont les sessions, la mémoire et les pipelines mémoire s’articulent, voir Mémoire et sessions de l’agent.
Pour stocker la mémoire dans une base de données Lakebase que vous gérez vous-même, consultez l’approche historique Self-managed agent memory (Lakebase).
Requirements
- Installez Python 3.10 ou version supérieure pour utiliser le SDK AgentKit. Le SDK AgentKit est le client Python de Databricks pour les API d’agents, utilisé dans les exemples ci-dessous. Vous pouvez aussi appeler l’API REST directement depuis n’importe quel langage, sans besoin de Python.
- Pour utiliser
memory_store.put()oumemory_store.list(path=...), installezdatabricks-agentbricksversion 0.6.0 ou supérieure.
Comment fonctionne la mémoire des agents
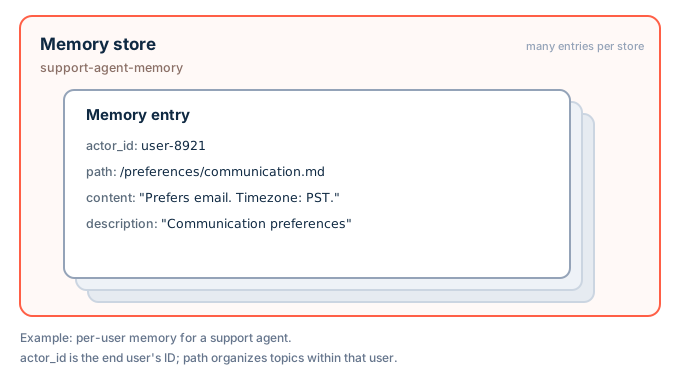
La mémoire de l’agent comporte deux niveaux :
- Un magasin de mémoire est le conteneur propre à l’espace de travail pour les mémoires d’un agent. La création d’un espace de stockage provisionne automatiquement le stockage Lakebase sous-jacent. Vous identifiez un magasin par son identifiant de magasin, que vous choisissez lors de la création du magasin.
- Une entrée mémoire est un contenu individuel dans un magasin. Chaque entrée contient un texte
contentlibre, un courtdescriptiontexte utilisé pour la récupération, et un ensemble de champs qui l’organisent et la partitionnent :-
actor_id(obligatoire) : à qui appartient la mémoire, par exemple à un utilisateur final ou un autre agent. -
session_id(optionnel) : la session à laquelle appartient la mémoire. Ne définissez pas cette valeur pour les données qui s’appliquent à toutes les sessions de l’agent. -
path(obligatoire) : un chemin de type système de fichiers qui organise les entrées au sein d’un acteur, tel que/preferences/response-style.md.
-
Une entrée est identifiée de manière unique par la combinaison de actor_id, session_id, et path. Le même chemin sous deux sessions différentes, ou sous une session et sans session, contient deux entrées distinctes.
Les entrées arrivent dans un stockage de deux manières : votre agent ou application les écrit directement, ou un pipeline mémoire les distille à partir des conversations dans un stockage de session.
Recherche
Récupérer la mémoire de deux façons :
-
Lister les entrées d’un acteur, filtrées optionnellement par
session_id, un préfixepath, ou unpathexact. Utilisez-le pour parcourir ou afficher un index de ce que sait un agent. - Rechercher des entrées pour un acteur avec une requête en langage naturel. La recherche renvoie les entrées les plus pertinentes, classées par score de pertinence.
Un session_id filtre sur l’une ou l’autre opération ne renvoie que les entrées enregistrées lors de cette session. Il ne retourne pas les entrées sauvegardées sans session.
Get started
Les exemples du SDK AgentKit et de l’API REST configurent la mémoire d’un agent d’assistance : ils créent un magasin de mémoire, enregistrent une préférence de l’utilisateur, puis la récupèrent lors d’une conversation ultérieure. L’exemple de l’interface de ligne de commande (CLI) Agent Bricks connecte un magasin de mémoire à un agent que vous créez et déployez à l’aide de la CLI. Choisissez le client qui correspond à votre projet. Un identifiant mémoire doit compter de 3 à 56 caractères, commencer par une lettre minuscule, se terminer par une lettre ou un chiffre, et ne contenir que des lettres minuscules, des chiffres et des traits d’union.
AgentKit SDK
Le SDK AgentKit est le client Python Databricks pour les API d’agents, distribué dans le databricks-agentbricks paquet. Il s’authentifie à l’aide du SDK Databricks WorkspaceClient.
Installez le SDK AgentKit :
pip install databricks-agentbricksCréez un stockage de mémoire pour votre agent.
AgentKitClients’authentifie avec vosWorkspaceClientidentifiants :from databricks.sdk import WorkspaceClient from databricks_agentkit import AgentKitClient client = AgentKitClient(WorkspaceClient()) memory_store = client.memory_stores.create("support-agent-memory")create()échoue si le magasin de certificats existe déjà. Lors des sessions ultérieures, ouvrez plutôt le stockage existant :memory_store = client.memory_stores.get("support-agent-memory")Sauvegardez un souvenir après que l’agent ait appris quelque chose de durable sur un utilisateur.
actor_idindique à qui appartient cette mémoire,pathl’organise au sein de cet acteur etdescriptionaméliore la récupération :memory_store.add( actor_id="user-123", path="/preferences/communication.md", content="Prefers email over phone. Timezone: PST. Enterprise subscription.", description="User 123 communication preferences", )add()échoue avecALREADY_EXISTSsi une entrée existe déjà à ce chemin. Pour créer l’entrée ou mettre à jour celle existante, appelezmemory_store.put()avec les mêmes arguments.Rappelez-vous les souvenirs de l’utilisateur lors d’une conversation ultérieure avec une recherche en langue naturelle :
results = memory_store.search(actor_id="user-123", query="communication preferences", limit=10)Supprimez les mémoires enregistrées à ce chemin lorsque vous n’en avez plus besoin :
for memory in memory_store.list(actor_id="user-123", path="/preferences/communication.md"):
    memory.delete()
REST API
Les clients appellent l’API REST sous /api/2.0/agents/memory-stores. Appelez-la directement pour d’autres langages que Python.
Définissez le nom d’hôte de votre espace de travail, sans
https://, et générez un jeton OAuth avec la CLI Databricks :export DATABRICKS_HOST=<workspace-hostname> databricks auth login --host https://${DATABRICKS_HOST} export DATABRICKS_TOKEN=$(databricks auth token | jq -r .access_token)Créez une base de mémoire pour votre agent :
curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores?managed_memory_store_id=support-agent-memory" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \
  -d '{"description": "Support agent memory"}'
Sauvegardez une entrée mémoire pour un utilisateur.
actor_idindique à qui appartient cette mémoire,pathl’organise etdescriptionen améliore la récupération :curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores/support-agent-memory/entries" \ -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \ -d '{"actor_id": "user-123", "path": "/preferences/communication.md", "content": "Prefers email over phone.", "description": "Communication preferences"}'Si une entrée existe déjà à ce chemin, la requête échoue avec
ALREADY_EXISTS(HTTP 409). Pour mettre à jour l’entrée existante à la place, cherchez-la par chemin. La recherche renvoie les entrées du chemin pour chaque session dans unmanaged_memory_entriestableau :{ "managed_memory_entries": [ { "name": "memory-stores/support-agent-memory/entries/<entry-id>", "actor_id": "user-123", "path": "/preferences/communication.md", "content": "Prefers email over phone.", "description": "Communication preferences", "create_time": "2026-11-08T01:20:05Z", "update_time": "2026-11-08T01:20:05Z" } ] }Pour faire correspondre une session, comparez
session_id. Une entrée enregistrée sans session n’a pas de champsession_id, sélectionnez donc l’entrée qui n’en a pas. Le dernier segment de l’namede l’entrée est l’ID de l’entrée. La commande suivante recherche l’entrée enregistrée sans session et stocke son ID dansEID:EID=$(curl -s -G "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores/support-agent-memory/entries" \ -H "Authorization: Bearer ${DATABRICKS_TOKEN}" \ --data-urlencode "actor_id=user-123" --data-urlencode "path=/preferences/communication.md" \ | jq -r '.managed_memory_entries[] | select(.session_id == null) | .name | split("/") | last')Puis mettez à jour le contenu de l’entrée par son identifiant :
curl -X PATCH "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores/support-agent-memory/entries/${EID}?update_mask=content" \ -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \ -d '{"content": "Prefers email over phone. Timezone: PST."}'Rappelez les souvenirs de l’utilisateur avec une recherche en langue naturelle :
curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores/support-agent-memory/entries:search" \ -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \ -d '{"actor_id": "user-123", "query": "communication preferences"}'Les résultats classés sont dans
results, les plus pertinents en premier. Chaque résultat amanaged_memory_entryet a une pertinencescore, où un score plus élevé est plus pertinent. La réponse répète également les mêmes entrées, dans le même ordre et sans notes, dans un tableau de premier niveaumanaged_memory_entries. Ce tableau est obsolète, donc lisezresults:{ "results": [ { "managed_memory_entry": { "name": "memory-stores/support-agent-memory/entries/<entry-id>", "actor_id": "user-123", "path": "/preferences/communication.md", "content": "Prefers email over phone. Timezone: PST.", "description": "Communication preferences" }, "score": 0.87 } ], "managed_memory_entries": [ { "name": "memory-stores/support-agent-memory/entries/<entry-id>", "actor_id": "user-123", "path": "/preferences/communication.md", "content": "Prefers email over phone. Timezone: PST.", "description": "Communication preferences" } ] }Supprimez l’entrée lorsque vous n’en avez plus besoin. Cherchez-le à nouveau par chemin, puis supprimez-le par ID :
EID=$(curl -s -G "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores/support-agent-memory/entries" \ -H "Authorization: Bearer ${DATABRICKS_TOKEN}" \ --data-urlencode "actor_id=user-123" --data-urlencode "path=/preferences/communication.md" \ | jq -r '.managed_memory_entries[] | select(.session_id == null) | .name | split("/") | last') curl -X DELETE "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores/support-agent-memory/entries/${EID}" \ -H "Authorization: Bearer ${DATABRICKS_TOKEN}"
Briques de l’agent
Si vous construisez votre agent avec la CLI Agent Bricks, agentbricks init déclare un magasin de mémoire dans agent.toml.
agentbricks deploy crée le magasin s’il n’existe pas déjà et lui accorde l’accès à l’agent déployé.
Choisissez un chemin :
Démarrer vide (la plupart des agents) : déployez l’agent.
agentbricks deploycrée le magasin mémoire quiagentbricks inita déclaré. Pour déployer un agent nommémy-agent, exécutez ce qui suit :agentbricks deploy my-agentCommencez par les mémoires déjà présentes dans le store : créez d’abord le store, ajoutez des entrées, puis liez le store à l’agent et déployez-le.
Pour créer un magasin nommé
my-agent-memory, exécutez ce qui suit. La sortie inclut l’identifiant du magasin, un identifiant généré distinct du nom du magasin :agentbricks memory stores create --name my-agent-memoryPour ajouter une entrée, exécutez ce qui suit, en remplaçant
<store-id>par l’identifiant de magasin de l’étape précédente :agentbricks memory entries create --store <store-id> --actor-id you@example.com \ --path /preferences/style.md --content "Prefers Python and concise answers with code examples."Pour lier le magasin de clés et déployer l’agent, exécutez la commande suivante.
agentbricks memory bindremplace le nom du magasin dansagent.toml, etagentbricks deploytrouve le magasin existant par son nom et l’utilise au lieu d’en créer un nouveau :agentbricks memory bind my-agent-memory agentbricks deploy my-agent
--path c’est la clé de l’entrée à l’intérieur du store, pas un fichier sur votre machine.
--actor-id est l’utilisateur auquel appartient la mémoire. Un agent déployé utilise l’adresse e-mail de l’utilisateur connecté comme identifiant d’acteur, renseignez donc chaque entrée avec l’adresse e-mail de l’utilisateur qui discute avec l’agent.
Dans la CLI Agent Bricks, memory bind et agentbricks deploy désignent un magasin par son nom. Les commandes qui agissent sur un seul magasin, comme memory entries create, prennent l’ID de magasin généré.
Donnez à votre agent des outils de mémoire
Pour permettre à un agent de décider quand enregistrer et récupérer des informations en mémoire, encapsulez les opérations du client sous forme d’outils et indiquez à l’agent quand les utiliser dans son prompt système. Définissez le actor_id dans le code d’application approuvé à partir de l’identité vérifiée de l’utilisateur final. Ne laissez jamais le modèle choisir quelle mémoire lire ou écrire.
L’exemple suivant encapsule le SDK AgentKit memory_store issu de Get started sous forme d’outils pour le SDK Agents d’OpenAI.
from agents import Agent, function_tool

def make_memory_tools(memory_store, actor_id: str):
    @function_tool
    def search_memory(query: str) -> str:
        """Search long-term memory for relevant facts about the user."""
        results = memory_store.search(actor_id=actor_id, query=query, limit=10)
        return "\n\n".join(f"{r.memory.path}: {r.memory.content}" for r in results) or "No memory found."

    @function_tool
    def save_memory(path: str, content: str, description: str = "") -> str:
        """Save a durable, long-term memory about the user, replacing any memory at the same path."""
        memory_store.put(actor_id=actor_id, path=path, content=content, description=description or None)
        return f"Saved memory at {path}"

    @function_tool
    def list_memories() -> str:
        """List the paths and descriptions of the user's long-term memories."""
        memories = memory_store.list(actor_id=actor_id)
        return "\n".join(f"{m.path}: {m.description}" if m.description else m.path for m in memories) or "No memory found."

    @function_tool
    def forget_memory(path: str) -> str:
        """Delete the long-term memory at a path, such as when the user asks you to forget it."""
        memories = list(memory_store.list(actor_id=actor_id, path=path))
        for memory in memories:
            memory.delete()
        return f"Forgot memory at {path}" if memories else f"No memory at {path}"

    return [search_memory, save_memory, list_memories, forget_memory]

agent = Agent(
    name="Support agent",
    instructions="Save durable user preferences, recall them when relevant, and forget them when the user asks.",
    tools=make_memory_tools(memory_store, actor_id="user-123"),
)
put() crée l’entrée, ou remplace le contenu de l’entrée déjà présent à ce chemin d’accès. Pour ajouter le contenu sous forme de nouvelles lignes à la place, passez append=True.
put() n’est pas atomique, donc les écritures concurrentes sur le même chemin peuvent se remplacer mutuellement.
list(path=...) renvoie les entrées sur ce chemin exact dans chaque session, donc forget_memory supprime également toute entrée enregistrée sur le chemin dans une session.
Le même schéma fonctionne avec le SDK Claude Agent et d’autres cadres de développement : encapsulez les opérations de recherche, d’ajout, de liste et de suppression du magasin en tant que type d’outil du cadre de développement.
Si vous exécutez également un pipeline mémoire sur le même magasin de mémoire, le pipeline peut réécrire, fusionner, diviser ou supprimer les entrées que votre agent sauvegarde pour n’importe quel acteur qu’il traite.
Partition et mémoire sécurisée
Dans un magasin, actor_id est ainsi qu’on distingue à qui appartiennent les souvenirs. Chaque liste et recherche se limite à un seul actor_id, alors choisissez la stratégie qui correspond à ce que votre agent doit retenir :
-
Mémoire privée pour chaque utilisateur : Réglez
actor_idsur l’identité vérifiée de l’utilisateur final. Chaque utilisateur reçoit sa propre partition, et l’agent ne se souvient que des entrées de cet utilisateur.- Exemple : Un agent support se souvient des préférences de communication d’un utilisateur et des tickets passés.
-
Mémoire partagée pour un groupe : Définissez
actor_idà une clé fixe que vous choisissez, telle qu’un identifiant d’équipe, de projet ou d’organisation. Tout le monde lit et écrit les mêmes souvenirs.- Exemple : Un agent d’équipe se souvient d’un glossaire partagé de termes de l’entreprise et des conventions internes.
-
Mémoire séparée selon un autre critère : Créez
actor_idà partir de vos propres valeurs, comme un ID de locataire ou unuser:projectcomposite.-
Exemple : Une application multi-locataire définit
actor_idsur{tenant}:{user}afin que les utilisateurs de chaque client restent isolés les uns des autres.
-
Exemple : Une application multi-locataire définit
Définissez actor_id dans votre code d’application depuis le contexte de l’appelant de confiance : l’identité vérifiée de l’utilisateur final pour la mémoire par utilisateur, ou une clé d’équipe ou de projet de confiance pour la mémoire partagée. Ne laissez jamais le modèle le choisir. Si votre stratégie dépend d’une identité utilisateur final, rejetez les requêtes qui n’en portent pas plutôt que de revenir à une identité partagée actor_id.
Warning
actor_id sépare les mémoires, mais ce n’est pas un contrôle d’accès. Les magasins de mémoire sont étendus à l’espace de travail, donc tout principal pouvant atteindre un magasin peut lire et écrire chaque entrée à travers tous les acteurs. Le magasin, pas l’acteur, est la frontière de sécurité. Pour une isolation stricte entre locataires ou utilisateurs, créez un stockage mémoire séparé par frontière.
Pour permettre à un autre principal, comme le principal de service de votre agent, d’utiliser un magasin, accordez-lui l’accès via l’opération de concession d’autorisation du magasin (memory_store.grant_permission(principal_id) dans le SDK AgentKit). Seul le créateur de la boutique ou un administrateur de l’espace de travail peut accorder l’accès. Voir Gérer les permissions pour la mémoire des agents et les magasins de session pour les niveaux d’autorisation, les opérations prises en charge et les exemples.
Limitations
- La mémoire des agents ne fournit que la mémoire à long terme. Pour l’historique des conversations à court terme, voir les sessions d’agent.
- La recherche classe les entrées selon leur pertinence, combinant le texte intégral (BM25) et la correspondance sémantique sur le contenu et la description de chaque entrée. Il retourne jusqu’à 100 entrées et ne prend pas en charge la pagination.
- Le contrôle d’accès est appliqué au niveau du magasin. Le contrôle d’accès par entrée et par acteur n’est pas disponible.
- Le contrôle d’accès au magasin couvre les entrées du magasin. Tout utilisateur de l’espace de travail peut lister et obtenir des magasins de mémoire, y compris leurs identifiants et descriptions.
- Vous ne pouvez pas changer l’identifiant d’un magasin après l’avoir créé. Seul
descriptionpeut être mis à jour. - Un espace de travail peut avoir au maximum 50 magasins de mémoire. Pour augmenter cette limite, contactez votre représentant Databricks.
Étapes suivantes
- Mémoire et sessions de l’agent : Apprenez quand utiliser les sessions, la mémoire ou les deux.
- Sessions avec les agents : Stockez l’historique des conversations à court terme au sein d’une seule interaction.
- Pipelines de mémoire de l’agent : Distillent automatiquement les mémoires à partir des conversations dans un magasin de session.
- Gérer les autorisations pour la mémoire de l’agent et les magasins de session : accordez au principal de service de votre agent déployé l’accès à un magasin mémoire.
- Référence de l’API de l’agent : Appelez l’API REST du magasin mémoire.
- Mémoire d’agent autogérée (Lakebase) : (Hérité) Stockez la mémoire dans une base de données Lakebase que vous gérez vous-même.