Remarque
L’accès à cette page requiert une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page requiert une autorisation. Vous pouvez essayer de modifier des répertoires.
Spark SQL utilise un optimiseur basé sur le coût (CBO) pour choisir des plans de requête efficaces. Le CBO utilise des statistiques de tableaux et de colonnes, telles que la taille des tableaux et la distribution des données, pour estimer le coût des plans alternatifs et choisir celui avec le coût estimé le plus bas. C’est particulièrement important pour les requêtes avec plusieurs jointures, où un mauvais plan peut être de plusieurs ordres de grandeur plus lent qu’un bon.
Le CBO est activé par défaut, mais cela dépend des statistiques. Si les statistiques manquent ou sont obsolètes, le CBO peut choisir un ordre de jointure ou une stratégie de jointure inefficace. Collectez les statistiques des tableaux et des colonnes et maintenez-les à jour. Voir Collecter des statistiques.
Bonnes pratiques
Pour aider le CBO à choisir des plans de requête efficaces, suivez ces pratiques :
- Collectez des statistiques pour les tables utilisées dans les requêtes à jointures multiples. Si vous utilisez l’optimisation prédictive sur les tables gérées de Unity Catalog, les statistiques sont collectées pour vous. Voir Collecter des statistiques.
- Vérifiez les plans de requête lorsqu’une requête multi-jointure est plus lente que prévu. Les statistiques manquantes ou inexactes sont une cause fréquente. Voir Vérifier les plans de requête.
- Supprimer les statistiques ou désactiver le CBO uniquement pour atténuer un problème de planification spécifique causé par les statistiques. Voir Désactiver l’optimiseur basé sur le coût.
Collecter des statistiques
Pour tirer pleinement parti de l’optimiseur basé sur les coûts (CBO), il est important de collecter les statistiques de colonnes et les statistiques de tables. Vous pouvez utiliser la ANALYZE TABLE commande pour collecter manuellement des statistiques.
Conseil
Pour maintenir les statistiques à jour, exécutez ANALYZE TABLE après l’écriture dans la table.
Utilisez ANALYZE.
L’optimisation prédictive s’exécute ANALYZEautomatiquement, une commande permettant de collecter des statistiques sur des tables gérées par le catalogue Unity. Databricks recommande d’activer l’optimisation prédictive pour toutes les tables managées par Unity Catalog afin de simplifier la maintenance des données et de réduire les coûts de stockage. Voir ANALYZE TABLE ... STATISTIQUES DE CALCUL.
Vous pouvez supprimer des statistiques d’optimiseur afin que l’optimiseur ne s’appuie plus sur eux, par exemple, pour atténuer un problème de planification provoqué par les statistiques. Voir ANALYZE TABLE ... DROP STATISTICS.
Vérifier les plans de requête
Il existe plusieurs façons de vérifier le plan de requête.
EXPLAIN commande
Pour vérifier si le plan utilise des statistiques, utilisez la commande EXPLAINSQL.
Si des statistiques sont manquantes, il se peut que le plan de requête ne soit pas optimal.
== Optimized Logical Plan ==
Aggregate [s_store_sk], [s_store_sk, count(1) AS count(1)L], Statistics(sizeInBytes=20.0 B, rowCount=1, hints=none)
+- Project [s_store_sk], Statistics(sizeInBytes=18.5 MB, rowCount=1.62E+6, hints=none)
   +- Join Inner, (d_date_sk = ss_sold_date_sk), Statistics(sizeInBytes=30.8 MB, rowCount=1.62E+6, hints=none)
      :- Project [ss_sold_date_sk, s_store_sk], Statistics(sizeInBytes=39.1 GB, rowCount=2.63E+9, hints=none)
      :  +- Join Inner, (s_store_sk = ss_store_sk), Statistics(sizeInBytes=48.9 GB, rowCount=2.63E+9, hints=none)
      :     :- Project [ss_store_sk, ss_sold_date_sk], Statistics(sizeInBytes=39.1 GB, rowCount=2.63E+9, hints=none)
      :     :  +- Filter (isnotnull(ss_store_sk) && isnotnull(ss_sold_date_sk)), Statistics(sizeInBytes=39.1 GB, rowCount=2.63E+9, hints=none)
      :     :     +- Relation[ss_store_sk,ss_sold_date_sk] parquet, Statistics(sizeInBytes=134.6 GB, rowCount=2.88E+9, hints=none)
      :     +- Project [s_store_sk], Statistics(sizeInBytes=11.7 KB, rowCount=1.00E+3, hints=none)
      :        +- Filter isnotnull(s_store_sk), Statistics(sizeInBytes=11.7 KB, rowCount=1.00E+3, hints=none)
      :           +- Relation[s_store_sk] parquet, Statistics(sizeInBytes=88.0 KB, rowCount=1.00E+3, hints=none)
      +- Project [d_date_sk], Statistics(sizeInBytes=12.0 B, rowCount=1, hints=none)
         +- Filter ((((isnotnull(d_year) && isnotnull(d_date)) && (d_year = 2000)) && (d_date = 2000-12-31)) && isnotnull(d_date_sk)), Statistics(sizeInBytes=38.0 B, rowCount=1, hints=none)
            +- Relation[d_date_sk,d_date,d_year] parquet, Statistics(sizeInBytes=1786.7 KB, rowCount=7.30E+4, hints=none)
Important
La statistique rowCount est particulièrement importante pour les requêtes avec plusieurs jointures. Si rowCount est manquant, cela signifie qu’il n’y a pas assez d’informations pour le calculer (autrement dit, certaines colonnes requises n’ont pas de statistiques).
Dans Databricks Runtime 16.0 et versions ultérieures, la sortie de la EXPLAIN commande liste les tables référencées contenant des statistiques manquantes, partielles et complètes, par exemple :
== Optimizer Statistics (table names per statistics state) ==
  missing = date_dim, store
  partial =
  full    = store_sales
Corrective actions: consider running the following command on all tables with missing or partial statistics
  ANALYZE TABLE <table-name> COMPUTE STATISTICS FOR ALL COLUMNS
Interface utilisateur de Spark SQL
Utilisez la page de l’interface utilisateur de Spark SQL pour afficher le plan exécuté et la précision des statistiques.
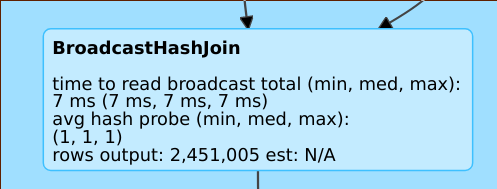
Une ligne telle rows output: 2,451,005 est: N/A signifie que cet opérateur produit environ 2 millions de lignes et qu’il n’y avait pas de statistiques disponibles.
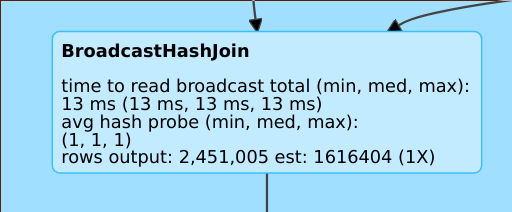
Une ligne telle que rows output: 2,451,005 est: 1616404 (1X) signifie que cet opérateur produit environ 2 millions de lignes, tandis que l’estimation était d’environ 1,6 million. Le facteur d’erreur d’estimation était donc de 1.
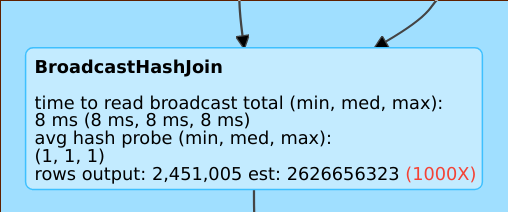
Une ligne telle que rows output: 2,451,005 est: 2626656323 signifie que cet opérateur produit environ 2 millions de lignes, tandis que l’estimation était d’environ 2 milliards. Le facteur d’erreur d’estimation était donc de 1 000.
Désactivez l’optimiseur basé sur le coût
Le CBO est activé par défaut. Vous désactivez l’optimiseur basé sur les coûts en modifiant l’indicateur spark.sql.cbo.enabled.
spark.conf.set("spark.sql.cbo.enabled", false)