Remarque
L’accès à cette page requiert une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page requiert une autorisation. Vous pouvez essayer de modifier des répertoires.
pg_durable est le moteur d’exécution durable à l’intérieur Azure HorizonDB. Il vous permet de définir des flux de travail SQL longs et multi-étapes (pipelines d'incorporation, travaux ETL, appels IA, travaux planifiés, flux d'approbation) et de les exécuter avec les mêmes garanties de fiabilité que vous attendiez d'un orchestrateur dédié comme Durable Functions, sans quitter Postgres.
pg_durable est également la couche d’exécution sous des pipelines IA durables. Si vous utilisez des pipelines d’IA, pg_durable c’est ce qui les fait survivre aux incidents, réessayer en cas d’échec et reprendre à partir de la dernière étape terminée.
Note
pg_durable est en version préliminaire.
Ce que signifie « durable »
Une fonction durable dans pg_durable est enregistrée sur disque à chaque étape. Cela vous donne un ensemble spécifique de garanties que vous n’obtenez pas à partir d’un bloc brut BEGIN ... COMMIT ou d’un travail cron :
- Survivre aux blocages et redémarrages de la base de données. Les étapes terminées ne sont pas réexécutées lorsque le serveur revient en ligne. Les étapes en cours reprendnt à partir du dernier point de contrôle. Les étapes en attente s’exécutent lorsque l’agent est de nouveau en ligne.
- Résiste aux longues attentes. Un flux de travail peut rester en veille pendant des heures, attendre une exécution planifiée par cron ou se bloquer en attendant un signal externe, puis reprendre là où il s’était arrêté.
- Résiste aux pannes. Les étapes ayant échoué peuvent être retentées automatiquement sans réexécuter la fonction entière.
- Capture l’identité. Une fonction s’exécute avec les privilèges de l’utilisateur qui l’a démarrée, et non avec les privilèges du worker en arrière-plan. Les charges de travail mutualisées restent isolées.
- Reste observable à partir de SQL. Vous pouvez inspecter l’état, l’historique, le nombre d’exécutions et les sorties via la même interface que celle que vous utilisez pour tout le reste dans HorizonDB : une
SELECTinstruction.
Ce que la durabilité ne fait pas automatiquement : elle ne rend pas à elle seule les opérations externes non idempotentes sûres à réessayer. Si une étape appelle une API externe qui facture de l’argent, concevez l’étape comme idempotente (par exemple, en passant une clé d’idempotency).
Quand utiliser pg_durable
Utilisez pg_durable quand vous devez travailler ainsi :
- Cela suffisamment longtemps pour échouer en cours d’exécution (génération d’incorporations entre des millions de lignes, tâche ETL en plusieurs étapes, renvoi).
- Doit être relancé en cas d’échec sans réexécuter les parties déjà exécutées avec succès.
- Doit être exécuté selon une planification (toutes les heures, chaque jour ouvré à 9 h).
- Doit attendre un événement externe (approbation, webhook, signal d’un autre système).
- Coordonne plusieurs étapes avec création de branche, de jointure ou concurrence.
- Est actuellement implémenté en tant qu’orchestrateur externe + une base de données Postgres, où la plupart du travail est la partie base de données.
Si votre charge de travail est une seule instruction transactionnelle courte, vous n’avez pas besoin pg_durable. Utilisez un standard INSERT / UPDATE.
Fonctionnement
Une fonction durable est un graphique des étapes que vous générez avec une DSL SQL et envoyez avec df.start(). Le graphe est enregistré, puis un processus en arrière-plan l’exécute.
Deux idées clés :
-
Le graphe de fonctions et l’état d’exécution sont stockés dans HorizonDB lui-même, dans les schémas
dfetduroxide. Les sauvegardes, la restauration dans le temps et la haute disponibilité s’appliquent automatiquement à l’état de votre workflow. Aucun état d’orchestrateur distinct à gérer. - Le composant Worker en arrière-plan est lancé par
shared_preload_libraries. Il détecte l’extension aprèsCREATE EXTENSIONet commence à exécuter des fonctions. Si la base de données redémarre, le composant Worker se rattache ensuite aux instances en cours d’exécution et reprend leur exécution.
Note
Le moteur d’exécution à l’intérieur de pg_durable repose sur Duroxide, le moteur d’exécution open source pour l’exécution durable en Rust de Microsoft (inspiré de Durable Task Framework et de Temporal). Le nom de schéma duroxide reflète ceci : c’est précisément là que Duroxide conserve l’historique d’orchestration, les ID de corrélation et l’état de relecture. Les garanties de relecture déterministe, d’ID d’événement corrélé et de minuterie durable que vous obtenez de pg_durable proviennent directement de Duroxide.
Activer pg_durable
Pour activer pg_durable sur Azure HorizonDB, commencez par configurer un groupe de paramètres, puis créez l’extension dans chaque base de données.
Utilisez ces articles de configuration :
- Créez un groupe de paramètres pour votre serveur.
- Définissez
shared_preload_librariespour inclurepg_durable. - Définissez
azure.extensionspour inclurepg_durable. - Appliquez le groupe de paramètres au serveur.
- Connectez-vous à chaque base de données cible et exécutez :
Créez l’extension dans chaque base de données où vous souhaitez l’utiliser :
CREATE EXTENSION IF NOT EXISTS pg_durable;
CREATE EXTENSION provisionne le df schéma (graphiques de fonction et vues de surveillance) et le duroxide schéma (état d’exécution). Le worker en arrière-plan détecte l’extension en quelques secondes et est prêt à exécuter des fonctions.
Votre première fonction durable
-- Start a one-step durable function
SELECT df.start('SELECT ''Hello, durable world!''');
-- Returns an 8-character instance ID, for example: a1b2c3d4

-- Check status
SELECT df.status('a1b2c3d4');

-- Get the result
SELECT df.result('a1b2c3d4');
Même une fonction à une seule étape est durable : si la base de données redémarre après df.start() et avant sa prise en charge par le processus de traitement, la fonction s’exécute quand même.
Note
df.start() envoie un flux de travail de façon asynchrone et retourne immédiatement. Pour les flux de travail à plusieurs étapes, utilisez df.list_instances(), , df.instance_info()ou df.status()df.result() pour confirmer l’achèvement avant de valider les effets secondaires.
Modèle de programme
Une fonction durable est un graphique créé à partir des étapes, des opérateurs et des fonctions intégrées. Les chaînes SQL simples sont automatiquement mises en forme. Vous n’avez donc pas besoin d’appeler df.sql() explicitement.
Operators
| Operator | Sens | Exemple |
|---|---|---|
~> |
Séquence : exécuter à gauche, puis à droite | 'SELECT 1' ~> 'SELECT 2' |
& |
Jointure : exécuter en parallèle, attendre tout | 'SELECT 1' & 'SELECT 2' |
| |
Concurrence : exécuter en parallèle, le premier l’emporte | fast_query | df.sleep(30) |
?>
!>
|
If / else : créer une branche sur une condition booléenne | cond ?> then_branch !> else_branch |
@> |
Boucle - répéter indéfiniment (opérateur préfixé) | @> body |
|=> |
Nom - enregistrer le résultat d’une étape | 'SELECT id FROM users LIMIT 1' |=> 'user_id' |
Compléments intégrés utiles
| Function | Purpose |
|---|---|
df.sleep(seconds) |
Suspendre pendant N secondes. Persiste entre les redémarrages. |
df.wait_for_schedule(cron) |
Patientez jusqu’à la prochaine correspondance d’une expression cron. |
df.wait_for_signal(name, timeout) |
Provoque un blocage jusqu’à ce qu’un élément externe df.signal() survienne. |
df.http(url, method, body, headers, timeout) |
Effectuez un appel HTTP en tant qu’activité durable, avec une nouvelle tentative en cas d’échec temporaire. |
df.if(cond, then, else) |
Branche conditionnelle. |
df.loop(body, cond) |
Répétez pendant qu’une condition SQL est vraie. |
df.join(a, b) / df.race(a, b) |
Exécution parallèle et en concurrence. |
df.join3(a, b, c) |
Pour une exécution parallèle à trois facteurs. |
df.start(body, label, database) |
Envoyez une fonction durable et retournez son ID d’instance. |
df.cancel(id, reason) |
Annulez une instance en cours d’exécution. |
df.status(id) / df.result(id) |
Inspectez les résultats. |
df.explain(input) |
Affichez le graphique de fonction pour la visualisation. |
En savoir plus sur toutes les fonctionnalités de pg_durable.
Variables
|=> capture le résultat d’une étape avec un nom ; les étapes ultérieures la référencent en tant que $name.
SELECT df.start(
    'SELECT 100 AS amount' |=> 'total'
    ~> 'SELECT $total * 2 AS doubled'
);
Exemples d’utilisation
ETL à plusieurs étapes avec nouvelles tentatives
Un ETL quotidien qui nettoie, charge, indexe et journalise :
SELECT df.start(
    'DELETE FROM target WHERE loaded_at < now() - INTERVAL ''1 day'''
    ~> 'INSERT INTO target SELECT * FROM staging'
    ~> 'REINDEX TABLE target'
    ~> 'INSERT INTO etl_log (job, finished_at) VALUES (''nightly'', now())',
    'nightly-etl'
);
Si la base de données redémarre entre le DELETE et le INSERT, le worker reprend à partir du INSERT - il ne réexécutera pas le DELETE.
Tâche planifiée (cron)
Exécutez une tâche de maintenance tous les jours de la semaine à 9 h :
SELECT df.start(
    @> (
        df.wait_for_schedule('0 9 * * 1-5')
        ~> 'CALL refresh_materialized_views()'
    ),
    'weekday-refresh'
);
Si vous souhaitez arrêter ce travail, vous pouvez exécuter la cancel fonction.
SELECT df.cancel('a1b2c3d4', 'stop test cron job');
Flux de travail d’approbation avec expiration
Attendez jusqu’à 24 heures pour un signal d’approbation externe, puis validez ou rejetez :
SELECT df.start(
    'SELECT order_id, total FROM orders WHERE id = 1' |=> 'order'
    ~> df.wait_for_signal('approval', 86400) |=> 'sig'
    ~> df.if(
        'SELECT NOT ($sig::jsonb->>''timed_out'')::boolean
            AND ($sig::jsonb->''data''->>''approved'')::boolean',
        'UPDATE orders SET status = ''approved'' WHERE id = $order_id',
        'UPDATE orders SET status = ''rejected'' WHERE id = $order_id'
    ),
    'order-approval'
);

-- Later, approve from anywhere
SELECT df.signal('a1b2c3d4', 'approval',
                 '{"approved": true, "approver": "jane@contoso.com"}');
Appel HTTP durable
df.http() effectue des appels externes sous forme d’activités durables : les réponses 5xx, les erreurs réseau et les délais d’attente font automatiquement l’objet de nouvelles tentatives.
SELECT df.start(
    df.http('https://api.example.com/users/123', 'GET') |=> 'user'
    ~> 'INSERT INTO users_cache (data) VALUES (($user::jsonb->>''body'')::jsonb)',
    'fetch-user'
);
En savoir plus sur la sécurité HTTP autorisée dans pg_durable.
Observer et opérer
Tout est interrogeable à partir de SQL. Il n’existe aucune interface utilisateur ou service distinct à apprendre.
-- All instances
SELECT * FROM df.list_instances();

-- Filter by status
SELECT * FROM df.list_instances() WHERE status = 'Running';
SELECT * FROM df.list_instances() WHERE status = 'Failed';

-- Detail for one instance
SELECT * FROM df.instance_info('a1b2c3d4');

-- Execution history (useful for retried or looped functions)
SELECT * FROM df.instance_executions('a1b2c3d4', 20);

-- The function graph as it ran
SELECT * FROM df.instance_nodes('a1b2c3d4');

-- System-wide metrics
SELECT * FROM df.metrics();
Pour vérifier que le travailleur est actif :
SELECT epoch_id, last_seen_at, now() - last_seen_at AS time_since_last_heartbeat
FROM df._worker_epoch;
Un time_since_last_heartbeat moins de 15 secondes signifie que le travailleur est sain. Toute valeur supérieure, ou l’absence totale de lignes, signifie que le composant Worker est à l’arrêt ou ne s’est pas initialisé.
Surveiller les flux de travail dans Visual Studio Code
L’extension PostgreSQL pour Visual Studio Code inclut un onglet
Ouvrir le volet Flux de travail
- Dans Visual Studio Code, ouvrez l’extension PostgreSQL.
- Dans Explorateur d'objets, cliquez avec le bouton droit sur votre base de données.
- Sélectionnez Pipelines & Flux de travail.
- Sélectionnez l’onglet Flux de travail .
Le volet gauche répertorie PG Durable Runs, et le volet central affiche les détails de l’instance de flux de travail sélectionnée.
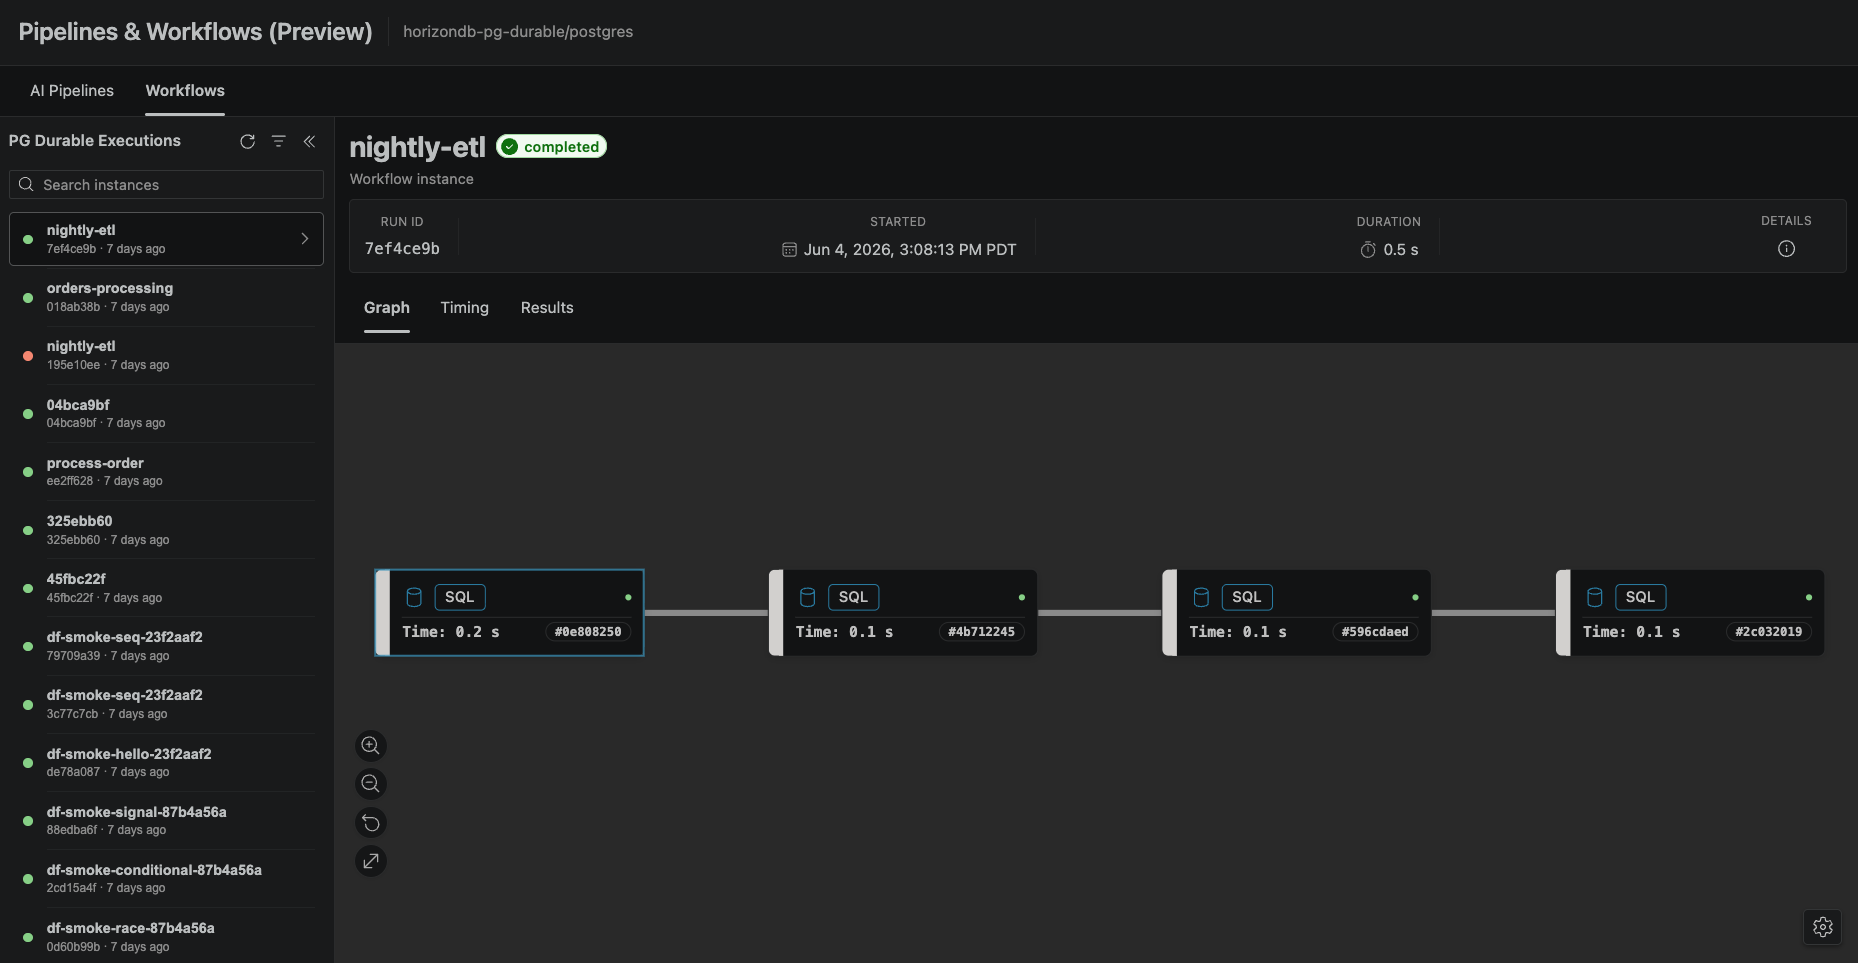
Inspecter les exécutions de flux de travail
Lorsque vous sélectionnez une exécution de flux de travail, passez en revue le résumé pour valider :
-
État :
completed,runningoufailed. - ID d’exécution : identificateur unique pour l’instance.
- Temps et durée démarrés : suivez la progression et les performances de l’exécution.
- Panneau Détails : Métadonnées d’exécution supplémentaires.
Utilisez les onglets disponibles pour approfondir les informations suivantes :
- Graphique : vue d’exécution pas à pas visuelle montrant la structure de flux de travail et le flux d’étape.
- Chronologie: vue centrée sur la durée pour l’analyse des performances et l’identification des goulots d’étranglement.
- Résultats : détails de sortie et de résultat de l’exécution du flux de travail.
Pour les flux de travail liés aux pipelines IA, une action Afficher la définition de pipeline (le cas échéant) vous permet de lier un flux de travail à sa définition de pipeline, utile pour comparer le comportement entre les exécutions ou examiner les régressions.
Identité et isolation
Les fonctions durables s’exécutent avec les privilèges de l’utilisateur qui les a soumis, et non avec les privilèges du composant Worker.
pg_durable capture à la fois session_user et current_user au moment de la soumission, de sorte que les fonctions soumises sous un SET ROLE contexte s’exécutent avec ce rôle effectif.
Cela signifie :
- Les utilisateurs voient et modifient uniquement les données auxquels ils disposent déjà d’autorisations d’accès.
- Les non-superutilisateurs ne peuvent pas élever leurs privilèges en soumettant une fonction durable.
- Les charges de travail mutualisées restent isolées tant que votre rôle et votre modèle d’octroi sont corrects.
Interaction entre les répliques, la sauvegarde et le PITR
- Sauvegarde et PITR. Le graphique de fonction (
dfschéma) et l’état d’exécution (duroxideschéma) sont stockés dans des tables régulières et sont inclus dans les sauvegardes HorizonDB. Une restauration à un point dans le temps restaure les deux. - Réplicas en lecture. Le composant Worker en arrière-plan s’exécute uniquement sur le serveur principal. Les réplicas en lecture peuvent interroger les
df.*vues de supervision, mais n’exécutent pas de fonctions. - Basculement. Après un basculement, le composant Worker sur le nouveau serveur principal commence là où l’ancien serveur principal s’était arrêté. Les instances en cours d’exécution reprennent à partir de leur dernier point de contrôle.
Comparé aux orchestrateurs externes
| Aspect | Orchestrateur externe | pg_durable |
|---|---|---|
| Deployment | Service distinct, identité distincte, magasin d’état distinct | Une base de données |
| Durabilité de l’état | la couche de stockage d’Orchestrator | Les mêmes sauvegardes, la même haute disponibilité et le PITR que vos données |
| Identity | Les composants Worker s’exécutent sous une identité du service | Les fonctions s’exécutent sous l’identité de l’utilisateur qui les soumet. |
| Modes d’échec | Réseau entre orchestrateur et base de données | Aucun - même processus |
| Idéal pour | Orchestration inter-système qui touche de nombreux services | Charges de travail où la plupart du travail se trouve dans ou près de Postgres |
pg_durable n’essaie pas de remplacer les orchestrateurs externes pour les pipelines inter-systèmes. C’est le bon choix quand la plupart du travail est le travail de base de données - incorporations, transformations, appels IA, maintenance planifiée - et l’ajout d’un autre service est plus coûteux que l’avantage.
Limitations pendant l'aperçu
-
df.http()effectue de nouvelles tentatives en cas d’erreurs réseau et 5xx. Les réponses 4xx sont renvoyées au workflow pour que vous les traitiez ; elles ne sont pas réessayées automatiquement. - Le composant Worker en arrière-plan prend en charge une seule base de données par instance. La distribution ramifiée vers plusieurs bases de données est prise en charge via
df.start(..., database => 'other_db')depuis une fonction s’exécutant dans la base de données du composant Worker. - Les définitions de fonction et l’état d’exécution ne sont pas portables d’une version majeure à l’autre de
pg_durableen préversion. Videz ou annulez les instances en cours d’exécution avant la mise à niveau.
Contenu connexe
- Implement des pipelines IA durables dans Azure HorizonDB (préversion)
- Fonctions d’IA dans l’extension azure_ai pour Azure HorizonDB (version préliminaire)
- Générer des incorporations vectorielles à l’aide de la fonction IA create_embeddings() (préversion)
- Autoriser les extensions dans Azure HorizonDB (préversion)
- Duroxide sur GitHub