Remarque
L’accès à cette page requiert une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page requiert une autorisation. Vous pouvez essayer de modifier des répertoires.
Ce tutoriel vous guide tout au long de la conversion de schémas de base de données Oracle en Azure Database pour PostgreSQL à l’aide de l’extension Visual Studio Code PostgreSQL avec Microsoft Foundry pour générer et passer en revue les définitions PostgreSQL.
Il traite de la connexion à votre source Oracle et à votre cible Azure Database pour PostgreSQL, de la configuration de Microsoft Foundry, de l’exécution de l’Assistant de migration et de la vérification des artefacts PostgreSQL générés. Avant de commencer, vérifiez que vous disposez d’un accès réseau et d’informations d’identification pour les serveurs et un déploiement Microsoft Foundry.
Voici ce que vous pouvez attendre pendant la conversion :
- Découverte de schéma : l’outil analyse vos objets de schéma Oracle.
- Traitement par l’IA : Microsoft Foundry traite et convertit les objets compatibles.
- Vérifications sur une base de données temporaire : l'outil tente d'effectuer la compilation et les vérifications statiques disponibles. La validation fonctionnelle, la validation des données et la validation de l'application restent distinctes.
- Révision de l’objet : Utilisez Conversion Explorateur d'objets pour inspecter les résultats et affiner les définitions PostgreSQL générées.
- Génération de sortie : les objets convertis avec succès sont enregistrés en tant que fichiers PostgreSQL.
Prerequisites
Cette section décrit les conditions préalables à l’utilisation de la fonctionnalité de conversion de schéma Oracle vers Azure Database pour PostgreSQL dans Visual Studio Code avant de commencer une conversion.
Configuration système requise
| Catégorie | Détails |
|---|---|
| Version de Visual Studio Code | 1.95.2 ou version ultérieure |
| abonnement GitHub Copilot | Pro+, Business, Enterprise |
Prise en charge du système d’exploitation
| Système d’exploitation | Détails du support |
|---|---|
| Windows | Architecture x64 uniquement |
| Linux | Architecture x64 |
| macOS | macOS 13+ |
Exigences relatives à la cible Azure Database pour PostgreSQL
| Composant | Exigences relatives à la version |
|---|---|
| Base de données Azure pour PostgreSQL | PostgreSQL version 15 ou ultérieure |
| Base de données scratch | Azure Database pour PostgreSQL – Serveur flexible |
Exigences relatives au modèle IA
Vous avez besoin de l’un des composants IA suivants configurés :
| Composant IA | Version du modèle |
|---|---|
| Microsoft Foundry | Déploiement GPT-5.2 |
configuration de déploiement de Microsoft Foundry
Dans Microsoft Foundry, créez un déploiement qui utilise le modèle gpt-5.2. Le nom du déploiement est celui que vous avez choisi lors de la création du déploiement ; il n’est pas obligé de correspondre au nom du modèle.
Le point de terminaison est votre URL de ressource Microsoft Foundry. Microsoft ressources Foundry exposent plusieurs noms d’hôte équivalents ; l’un des formats suivants est valide :
https://{your-resource}.services.ai.azure.comhttps://{your-resource}.openai.azure.comhttps://{your-resource}.cognitiveservices.azure.com
Remplacez {your-resource} par votre nom de ressource Microsoft Foundry (par exemple, oracletopg). Si vous devez appeler directement un itinéraire d’inférence, le chemin d’accès en version préliminaire actuel est /openai/responses?api-version=2025-04-01-preview.
Pour plus d’informations sur les formats de point de terminaison et les itinéraires d’inférence, consultez Endpoints pour les modèles Microsoft Foundry.
Tip
Pour acheminer le trafic de Microsoft Foundry via Gestion des API Azure afin d’assurer une gouvernance centralisée, le contrôle de débit et l’observabilité, configurez une passerelle d’IA en amont de votre ressource Foundry et utilisez l’URL de la passerelle comme point de terminaison. Pour plus d’informations, consultez Configurer la passerelle AI dans vos ressources Foundry.
Privilèges de base de données requis
Avant d’exécuter la conversion de schéma, vérifiez l’accès aux métadonnées sources et les autorisations sur la base de données de travail avec vos administrateurs de base de données. Le compte Oracle a besoin d’accéder aux métadonnées de schéma et aux vues de dictionnaire, et non aux données de ligne d’application. Le compte PostgreSQL doit pouvoir supprimer et recréer des schémas correspondants et créer des objets pour la validation. Utilisez un compte dédié le cas échéant et suivez le principe du privilège minimum.
Source des privilèges Oracle
Les privilèges minimaux suivants sont requis sur la base de données Oracle source :
| Privilège | Purpose |
|---|---|
| CONNECT | Connexion de base à une base de données |
| SELECT_CATALOG_ROLE | Accès aux vues de dictionnaire de données |
| SÉLECTIONNER TOUT DICTIONNAIRE | Lire les métadonnées système et les objets de dictionnaire |
CHOISIR SYS.ARGUMENT$ |
Accès à l’information sur les arguments des procédures et fonctions |
CHOISIR SYS.V_$RESOURCE_LIMIT |
Accès à l'utilisation et aux limites des sessions et des processus via V$RESOURCE_LIMIT sur la base de données |
Privilèges de base de données scratch
Configurez l’accès suivant sur la base de données scratch sélectionnée. Le niveau CREATE de la base de données n’accorde pas l’autorisation de supprimer un schéma appartenant à un autre rôle.
| Access | Purpose |
|---|---|
CONNECT sur la base de données |
Se connecter pour la conversion et la validation. |
CREATE sur la base de données |
Créez des schémas de validation. |
| Propriété des schémas correspondants ou utilisation d'un rôle disposant des autorisations appropriées. | Supprimez les schémas correspondants avant de les recréer. |
| Autorisation de créer des objets dans les schémas de validation | Créez et compilez des définitions converties. |
| Autorisations d’installation d’extension ou assistance de l’administrateur | Installez les extensions requises pour la conversion et la validation. |
Configuration réseau requise
- Connectivité sortante : points de terminaison Microsoft Foundry.
- Connectivité de la base de données : la source Oracle et le serveur flexible cible Azure Database pour PostgreSQL.
- Accès HTTPS : Visual Studio Code Extensions Marketplace et les services de GitHub Copilot.
- Accès au dépôt GitHub : https://github.com/microsoft/pgsql-tools/.
Client instantané Oracle (pour le mode client épais)
L’outil de conversion de schéma se connecte à Oracle à l’aide du mode client léger par défaut, ce qui ne nécessite aucun logiciel supplémentaire. Si votre environnement nécessite un mode client épais, installez Oracle Instant Client sur l’ordinateur qui s’exécute Visual Studio Code. L’outil lit votre configuration sqlnet.ora et tnsnames.ora et bascule automatiquement en mode étendu lorsqu’un paramètre l’exige.
Vous pouvez déterminer si le mode client épais est requis en vérifiant les fichiers de configuration réseau Oracle dans votre environnement source. Recherchez les paramètres suivants dans le sqlnet.ora fichier (généralement situés dans $ORACLE_HOME/network/admin/) :
| Paramètre | Indique que le mode épais est requis |
|---|---|
SQLNET.CRYPTO_CHECKSUM_CLIENT |
Définir sur REQUIRED ou REQUESTED pour le chiffrement réseau natif |
SQLNET.ENCRYPTION_CLIENT |
Définir sur REQUIRED ou REQUESTED pour le chiffrement réseau natif |
Authentification à Microsoft Foundry
Configurez l’une des méthodes d’authentification suivantes pour Microsoft Foundry :
| Méthode d’authentification | Spécifications |
|---|---|
| Clé API | URL du point de terminaison Microsoft Foundry et clé d’API. |
| Microsoft Entra ID | Extension de compte Azure connectée, rôle Foundry User (anciennement Azure AI User) attribué sur la ressource Microsoft Foundry. |
Processus de migration
Cette section décrit le flux de travail de conversion. Vous installez l’extension, initialisez un projet, connectez-vous à Oracle, passez en revue la découverte et configurez la base de données scratch et Microsoft Foundry. La conversion tente d'effectuer la compilation et les vérifications statiques disponibles dans la base de données temporaire. Vous passez ensuite en revue et affinez la sortie, déployez-la sur une base de données hors production distincte et validez-la indépendamment avant la mise en production.
Étape 1 : Installer l’extension PostgreSQL Visual Studio Code
Ouvrez Visual Studio Code.
Accédez à la vue Extensions (
Ctrl+Shift+X).Recherchez PostgreSQL et installez l’extension PostgreSQL publiée par Microsoft.
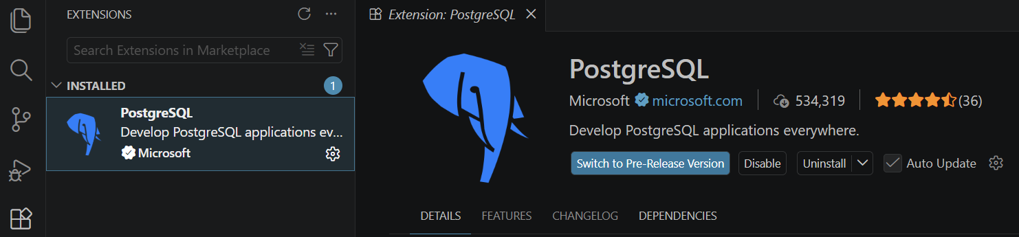
Étape 2 : Créer une connexion Azure Database pour PostgreSQL
Dans le panneau d’extension PostgreSQL, créez une connexion à votre instance Azure Database pour PostgreSQL serveur flexible.
Entrez les détails de connexion (hôte, base de données, nom d’utilisateur, mot de passe).
Testez et enregistrez la connexion.
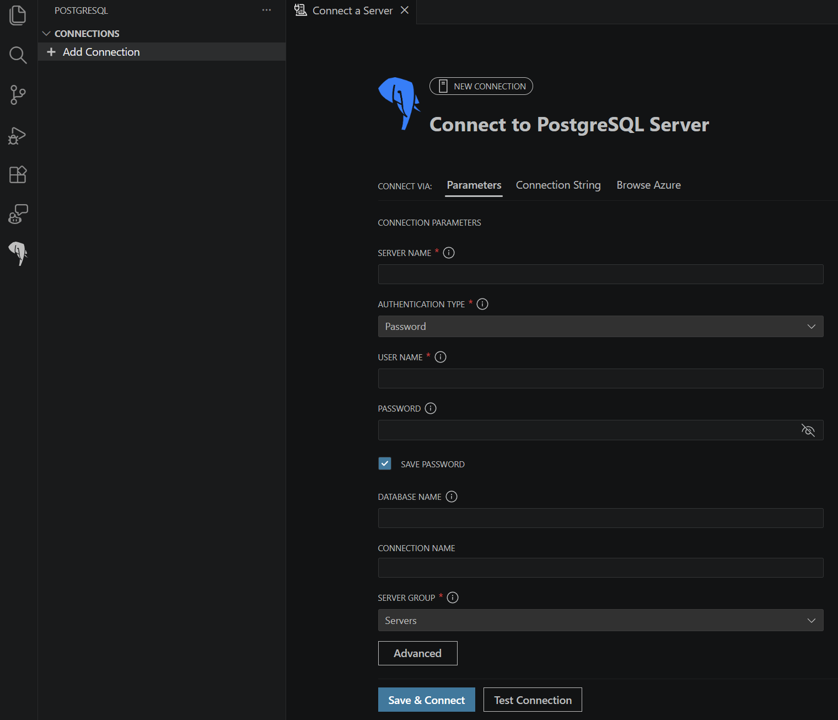
Étape 3 : Ouvrir un nouvel espace de travail
Créez un dossier sur votre ordinateur local pour le projet de migration.
Ouvrez le dossier en tant qu’espace de travail new workspace dans Visual Studio Code.
Étape 4 : Initialiser un projet de migration
Ouvrez l’extension PostgreSQL.
Accédez au panneau Migrations .
Sélectionnez Create Migration Project.
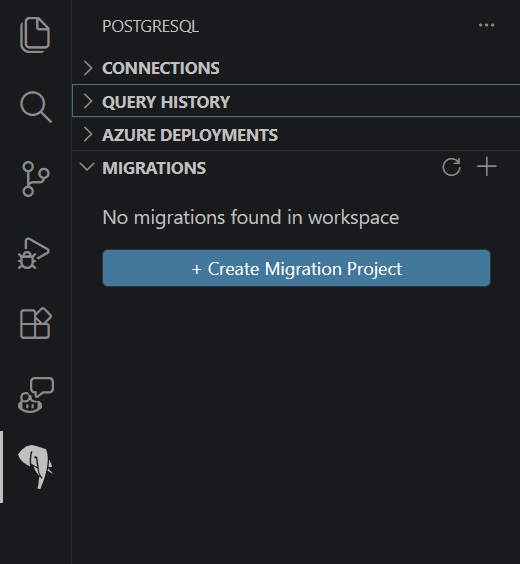
Étape 5 : Configurer les paramètres du projet
Dans l’Assistant Migration, entrez le nom de votre projet.
Sélectionnez Suivant pour continuer.
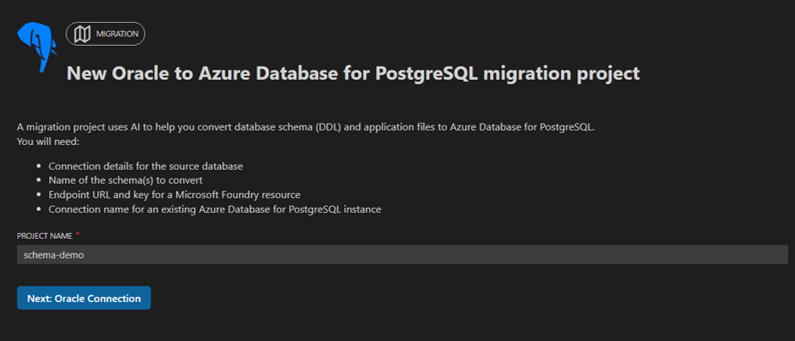
Étape 6 : Configurer la connexion Oracle
Entrez les détails de votre connexion Oracle :
- Nom de l’hôte ou du serveur.
- Numéro de port.
- Nom de la base de données ou du service.
- Nom d’utilisateur et mot de passe.
L’outil sélectionne automatiquement le mode client léger ou lourd à partir de vos paramètres
sqlnet.oraettnsnames.ora; l’interface utilisateur ne propose pas de sélecteur manuel. Le mode mince est utilisé par défaut. Si votresqlnet.oranécessite le mode Thick, assurez-vous qu’Oracle Instant Client est installé et que son emplacement est défini dans la variable d’environnementPATHavant de poursuivre. Pour plus d’informations, consultez Oracle Instant Client.Sélectionnez Charger des schémas. L’outil teste la connexion Oracle et, s’il réussit, répertorie tous les schémas définis par l’utilisateur disponibles dans Oracle.
Sélectionnez un ou plusieurs schémas à convertir en PostgreSQL.
Sélectionnez Suivant : Découverte.
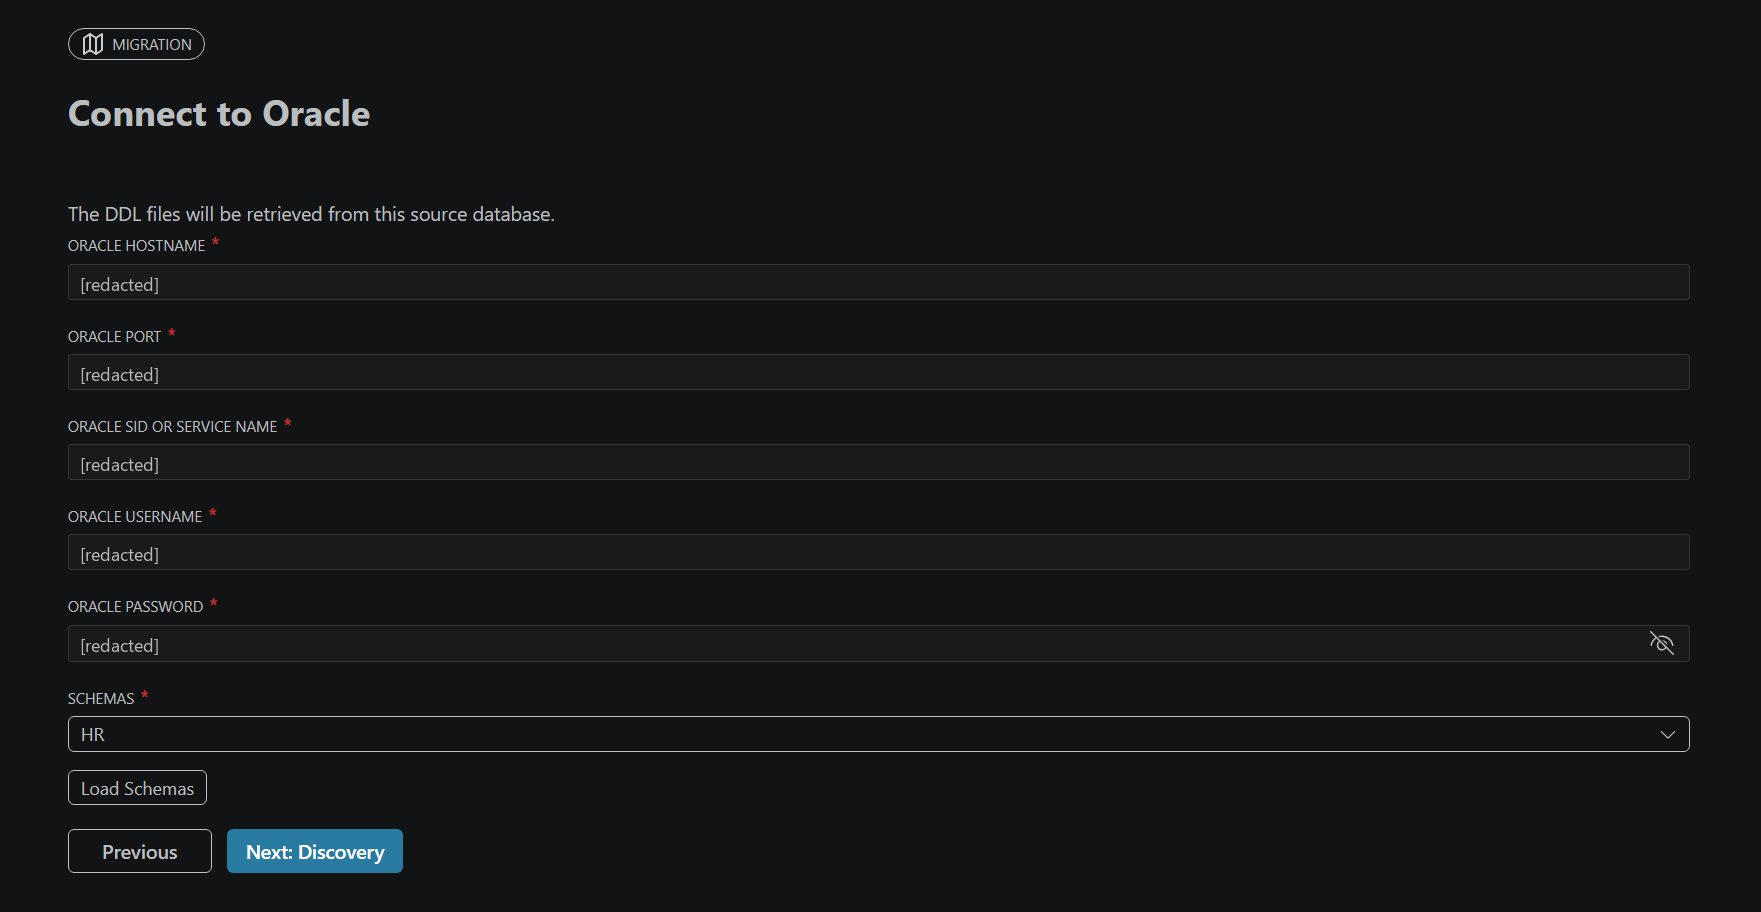
Étape 7 : Examiner les résultats de Discovery
La phase de découverte montre l’inventaire des sources et la portée d’extraction prévue. Aucune DDL n’est extraite à ce stade. Pour obtenir une explication des nombres récapitulatifs et de leur portée, consultez Découverte dans la vue d'ensemble de la conversion de schéma.
Attendez que la découverte soit terminée.
Sous Autorisations sources, passez en revue chaque vérification, son objectif et son résultat. Passez en revue les vérifications infructueuses avec votre administrateur de base de données Oracle. Après avoir résolu les problèmes d’autorisation, sélectionnez Actualiser la découverte et passez en revue les résultats mis à jour. Pour les autorisations requises, consultez les privilèges Oracle source.
Passez en revue les nombres récapitulatifs des objets découverts, objets à extraire, objets exclus et objets non valides.
Dépliez les types d’objets pris en charge pour examiner les nombres de À extraire, Exclus et Objets non valides par type. Un type pris en charge peut toujours avoir des objets exclus ; ces nombres ne sont pas des résultats de conversion.
Développez les types d’objets non pris en charge pour passer en revue les catégories non prises en charge trouvées sur la source. Pour plus d’informations sur la prise en charge et les alternatives PostgreSQL, consultez les limitations de conversion de schéma.
Sous Schémas dépendants, passez en revue les schémas référencés que vous n’avez pas sélectionnés. Sélectionnez Afficher le diagramme pour voir les références. Les nombres sur les connexions représentent des références de dépendances, et non le nombre d’objets à extraire ou à convertir.
Passez en revue la notification distincte concernant les schémas système Oracle référencés qui ne sont pas migrés. Ne traitez pas ces références comme des schémas d’application supplémentaires sélectionnés pour la conversion.
Si vous devez modifier la sélection des schémas, sélectionnez Previous pour revenir à Connect to Oracle, mettez à jour Schemas, puis sélectionnez de nouveau Next: Discovery. Passez en revue l’étendue mise à jour avant de continuer.
Sélectionnez J’ai examiné les objets, les exclusions et les schémas dépendants.
Sélectionnez Suivant : Connexion PostgreSQL.
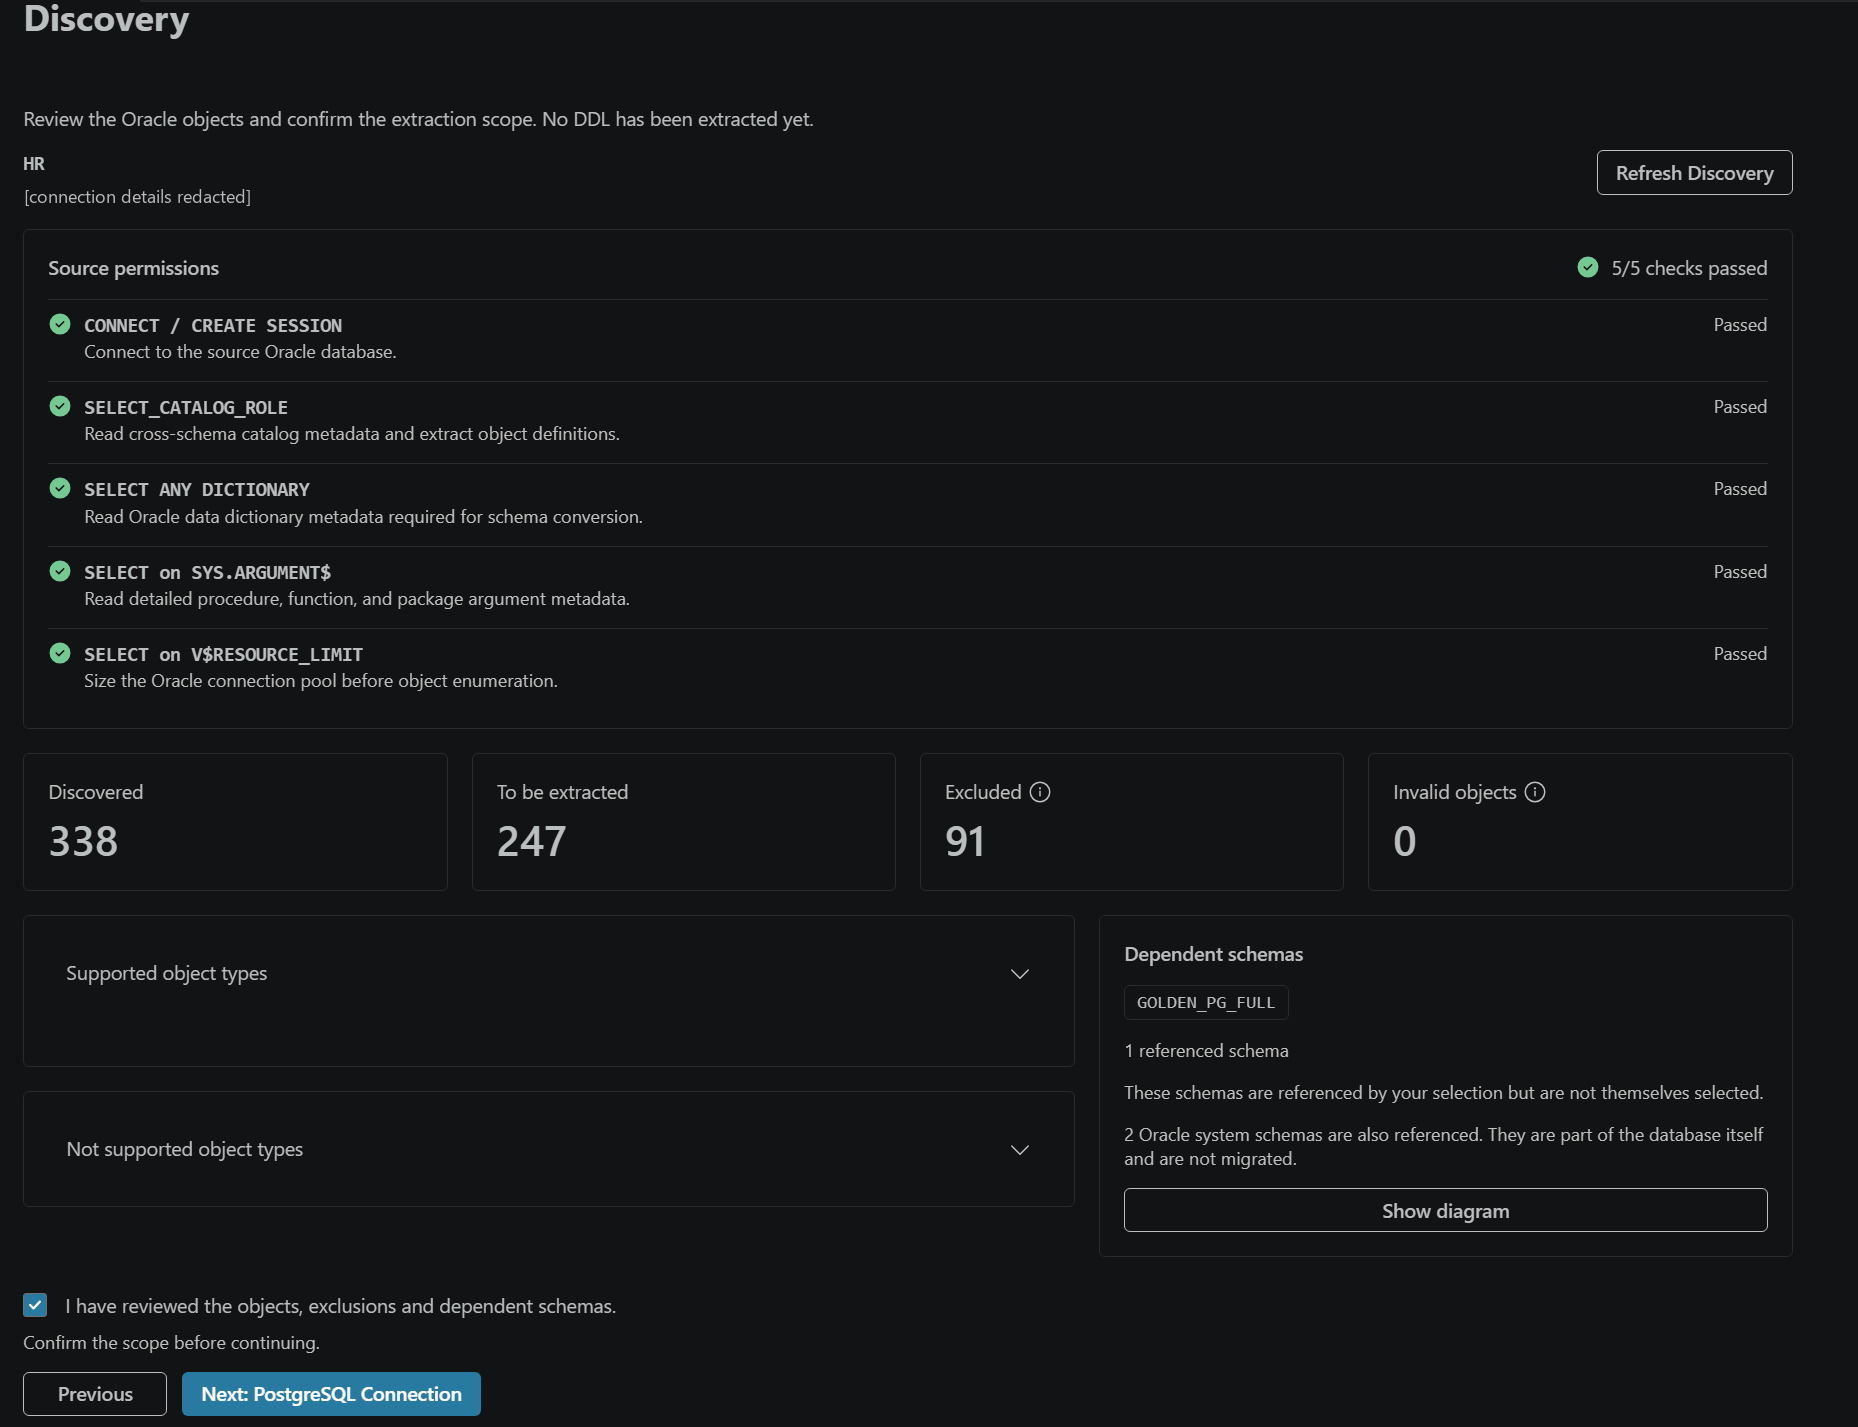
Étape 8 : Configurer une base de données temporaire Azure Database pour PostgreSQL
Utilisez une base de données scratch vide ou dédiée et inutilisée sans objets ni données que vous devez conserver. Pour obtenir des conseils de préparation, consultez Préparer la base de données de travail.
Sélectionnez la connexion Azure Database pour PostgreSQL que vous avez définie dans l’extension PostgreSQL.
Sélectionnez la base de données cible dans la liste déroulante.
Sélectionnez Verify Extensions. Si les extensions recommandées ne sont pas installées , passez en revue les extensions manquantes. Suivez les instructions de préparation de la base de données temporaire pour ajouter les extensions nécessaires à la liste d'autorisation du serveur et les installer dans la base de données sélectionnée, puis sélectionnez de nouveau Verify Extensions. Vous pouvez continuer malgré l’avertissement, mais les objets qui dépendent des extensions manquantes peuvent nécessiter des modifications manuelles.
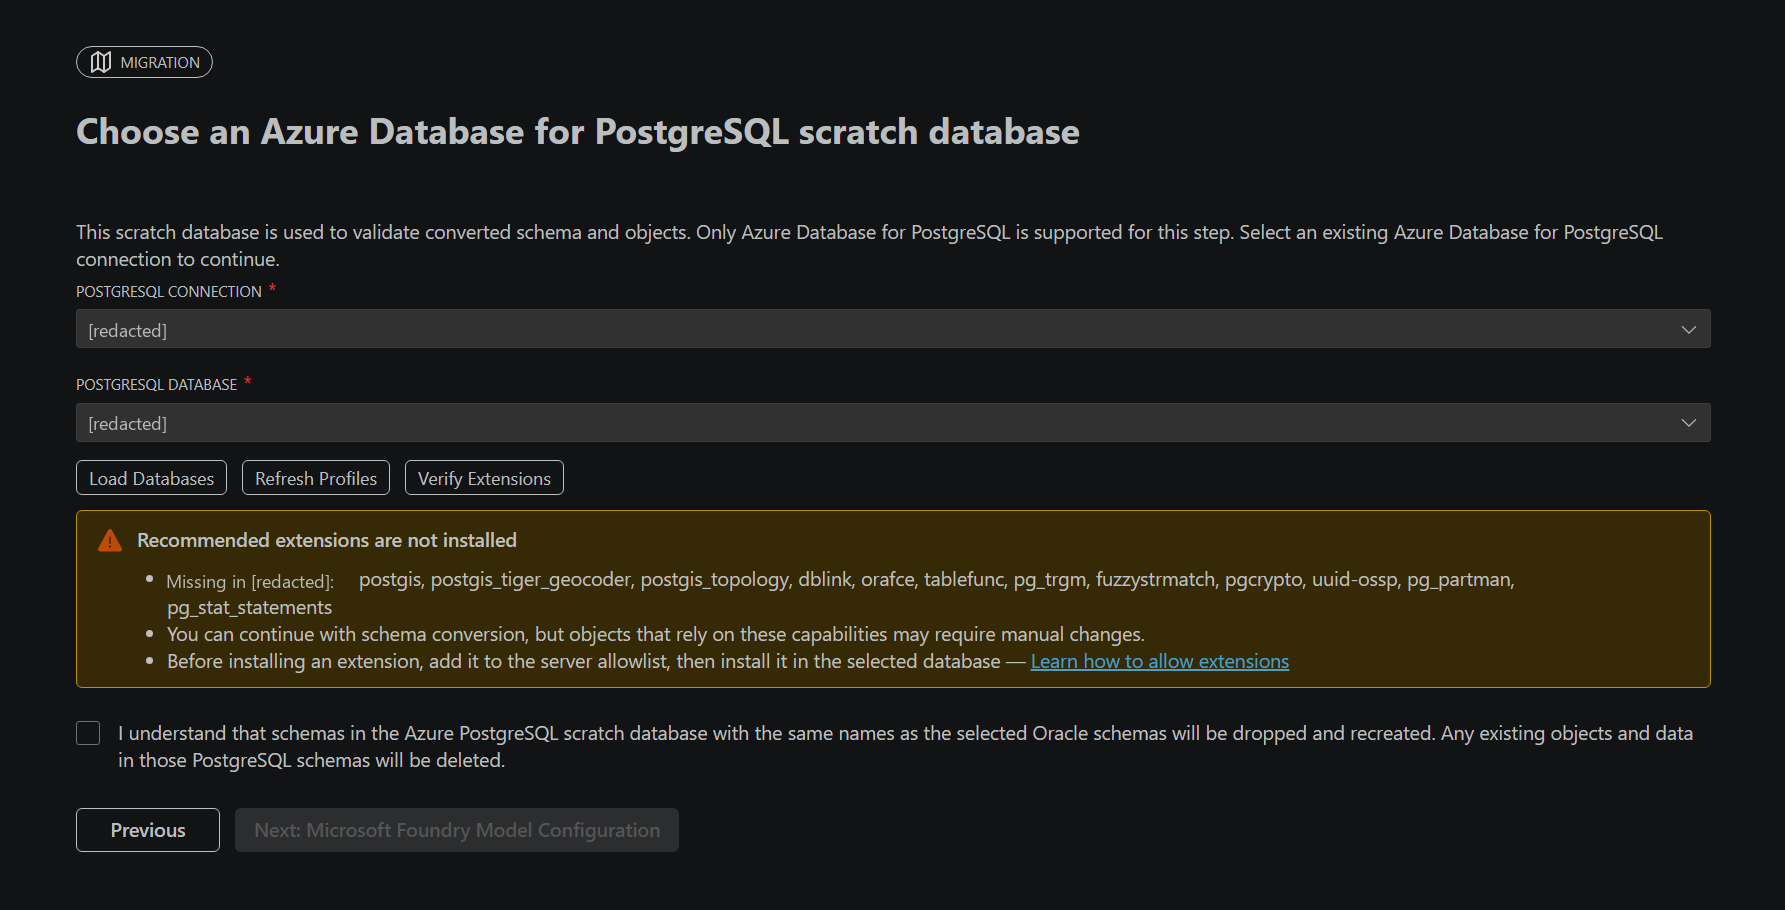
Cochez la case confirmant que les schémas temporaires correspondant aux schémas Oracle sélectionnés sont supprimés, puis recréés pendant la conversion, ce qui entraîne la suppression de leurs objets et données existants.
Sélectionnez Suivant : Configuration du modèle Microsoft Foundry.
Étape 9 : Configurer le modèle de langage Microsoft Foundry
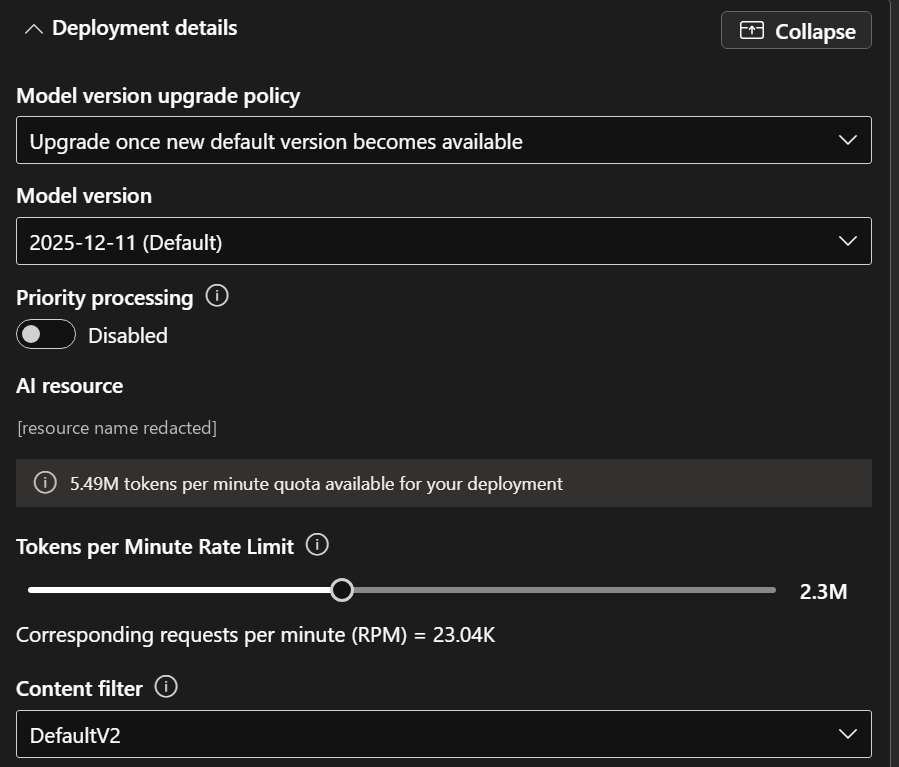
Dans Microsoft Foundry, allouez un quota de déploiement supérieur à 1 000 000 jetons par minute (TPM). L’exemple de déploiement suivant est configuré pour 2,3 millions de TPM ; le quota disponible indiqué est spécifique à cet environnement.
Revenez à l’Assistant de migration dans Visual Studio Code pour configurer la connexion du modèle :
- Entrez les détails de votre Microsoft Foundry :
- URL du point de terminaison.
- Nom du déploiement (nom que vous avez affecté au déploiement dans Microsoft Foundry ; le modèle sous-jacent doit être
gpt-5.2).
- Sélectionnez la méthode d’authentification :
- clé API : entrez la clé API de votre déploiement Microsoft Foundry.
- ID Microsoft Entra : Connectez-vous avec l’extension de compte Azure. L’outil acquiert automatiquement le jeton d’authentification. Vérifiez que l’identité de connexion a le rôle Foundry User (anciennement Azure AI User) sur la ressource Microsoft Foundry. Pour plus d’informations, consultez Contrôle d’accès en fonction du rôle pour Microsoft Foundry.
- Sélectionnez Test Microsoft Foundry Connection pour vérifier la configuration.
- Une fois la connexion établie, sélectionnez Create Migration Project.
Étape 10 : Exécuter la conversion de schéma
Le système navigue vers l’assistant de migration principal.
Sélectionnez Migrer pour démarrer le processus de conversion de schéma.
Surveillez la progression de la conversion dans l’interface Visual Studio Code.
Une fois la conversion terminée, le projet affiche La conversion du schéma est terminée et l’action Consulter le récapitulatif de la conversion.
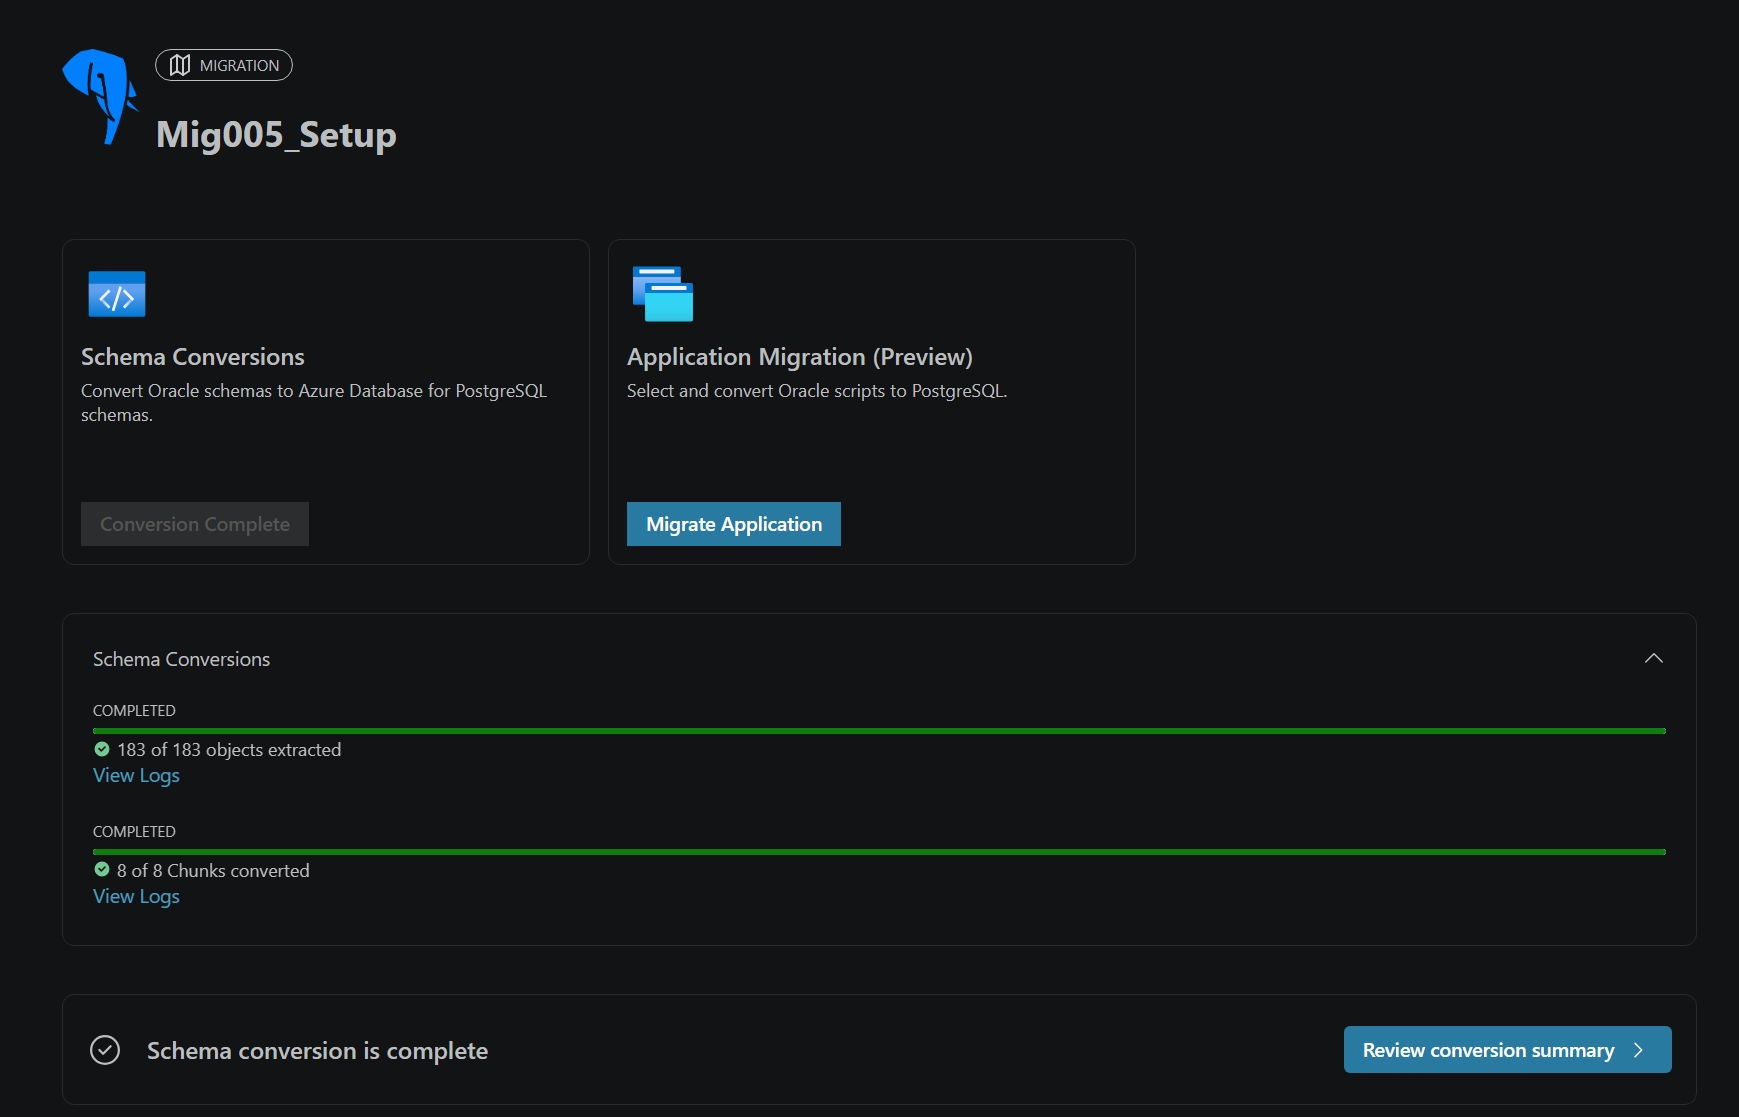
Étape 11 : Passer en revue le rapport de conversion de schéma
- Une fois la conversion de schéma terminée, le rapport de conversion HTML s’ouvre automatiquement.
- Passez en revue les résultats de découverte, d’extraction et de conversion et les notes au niveau de l’objet.
- Pour obtenir des conseils sur l’interprétation du rapport, consultez Afficher le rapport HTML pour la conversion de schéma Oracle.
Étape 12 : Examiner et affiner les objets convertis
Dans le projet de migration terminé, sélectionnez Vérifier le résumé de la conversion.
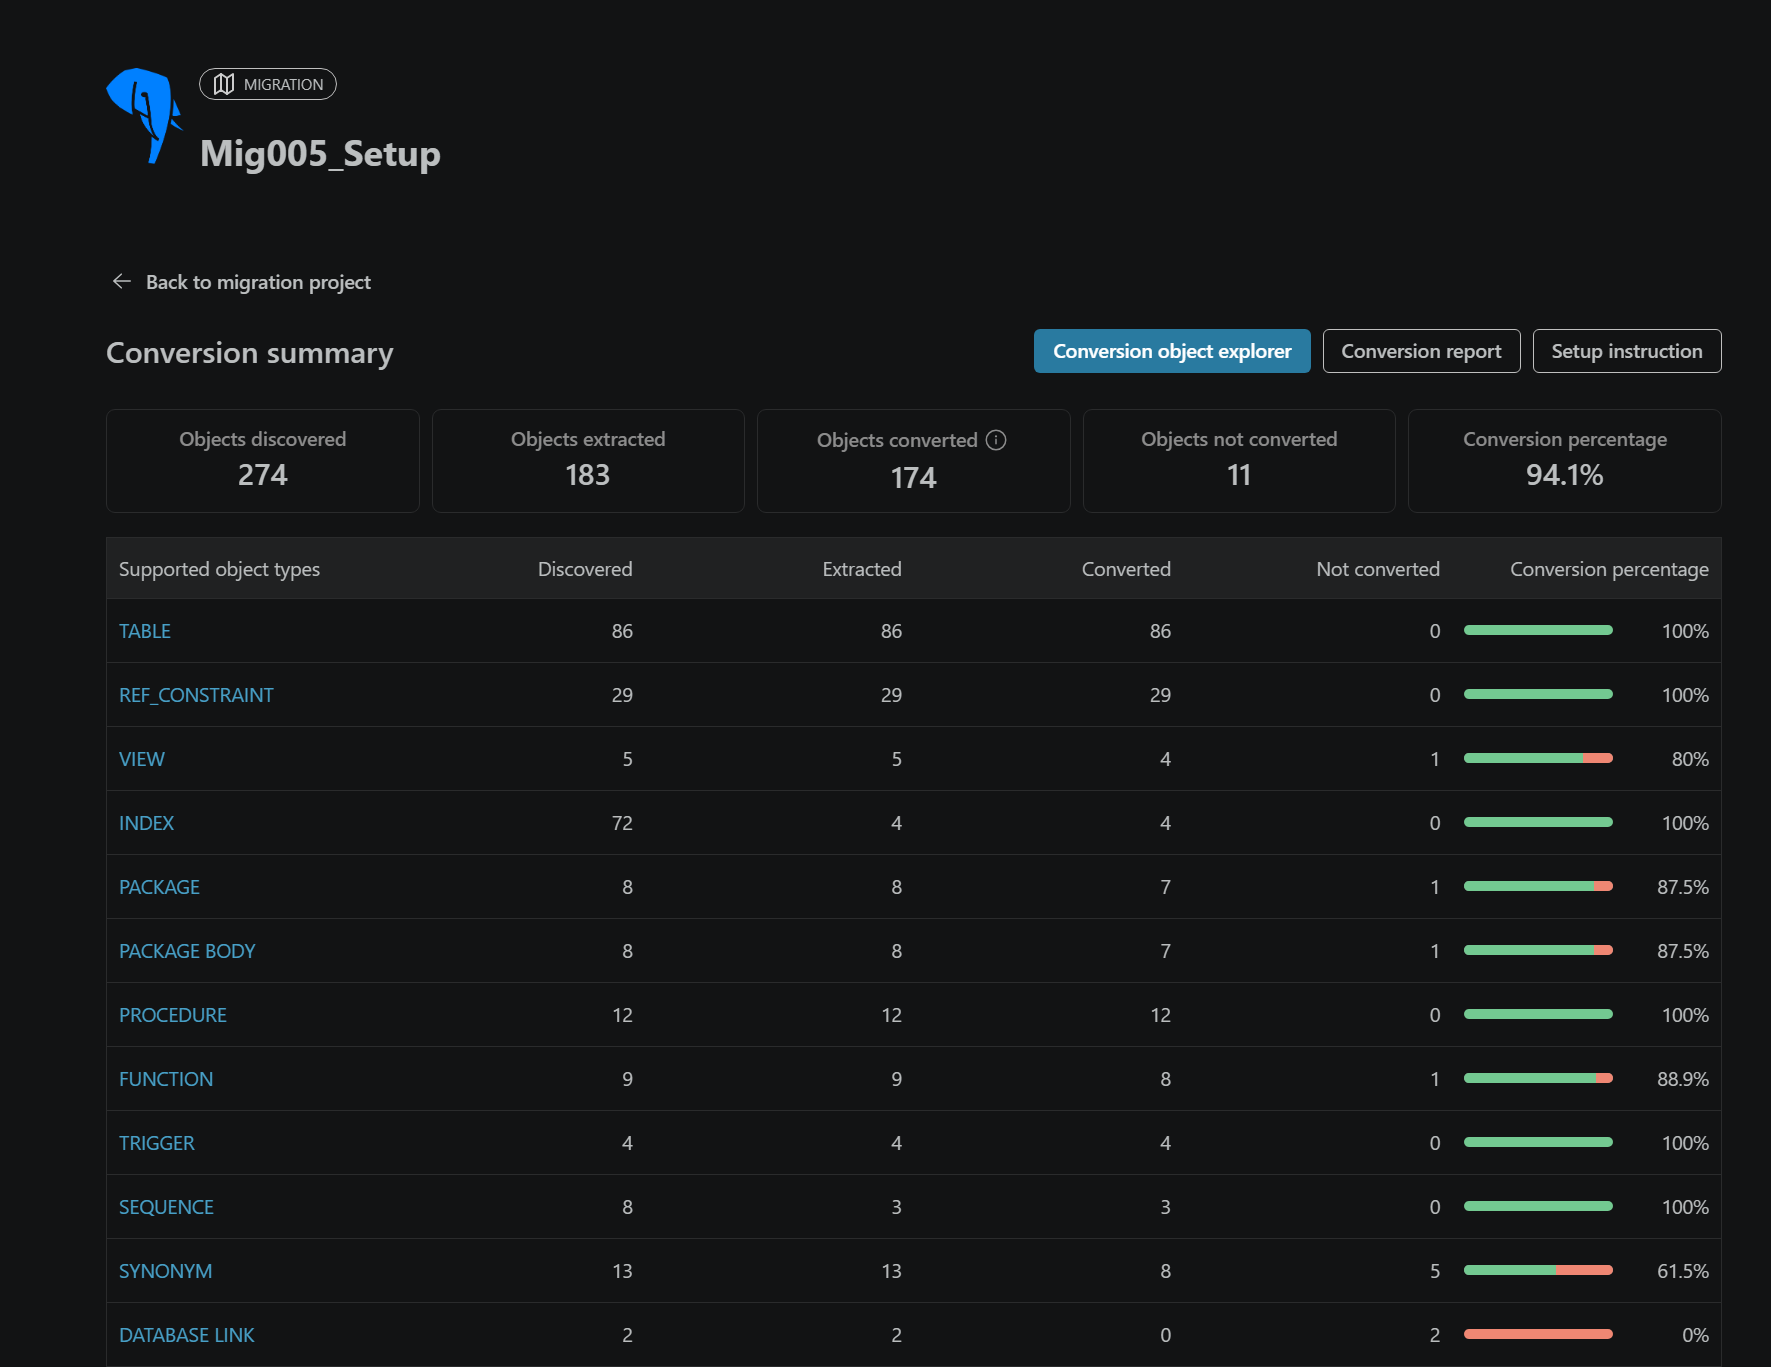
Sur la page résumé de conversion, sélectionnez l’explorateur d’objets de conversion.
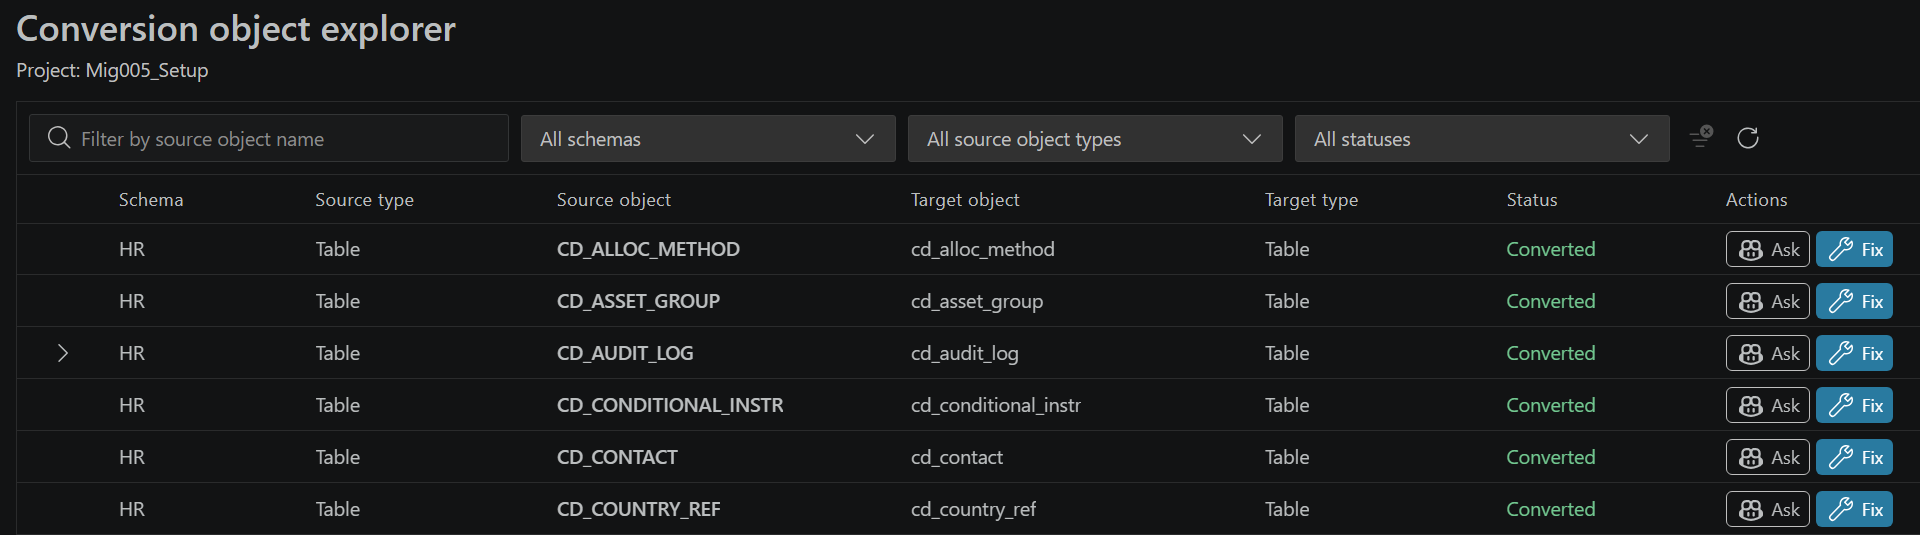
Sélectionnez un objet pour comparer ses définitions Oracle et PostgreSQL et lire ses notes de conversion.
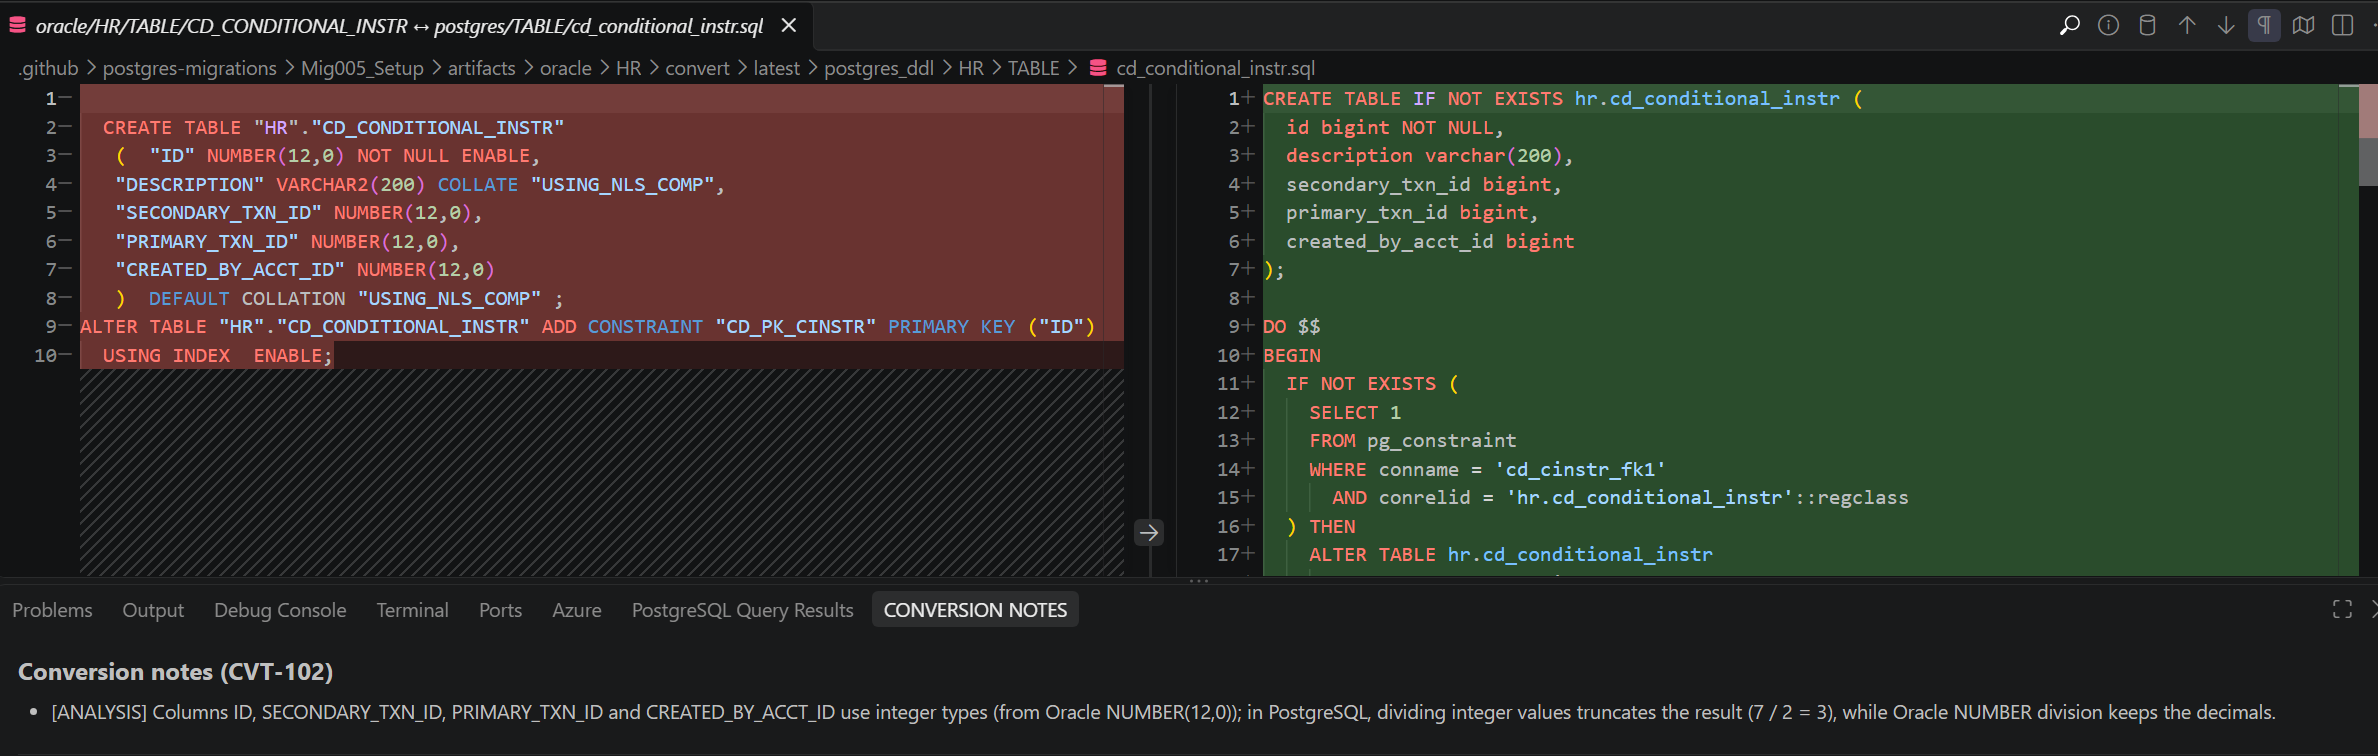
Utilisez Ask pour expliquer la conversion et ses dépendances, ou Corriger pour ouvrir un requête Copilot et apporter des modifications au fichier PostgreSQL.
Passez en revue les modifications et vérifiez que le SQL de déploiement inclut les corrections que vous envisagez de déployer. Ne présumez pas que la modification d'un fichier propre à un objet met à jour le fichier généré
deploy.sql.
Pour connaître les étapes de filtrage, de comparaison et de compilation manuelle, consultez Passer en revue les objets convertis dans Conversion Explorateur d'objets.
Étape 13 : Préparer le déploiement avec Setup Experience
Le flux de travail de conversion génère automatiquement des fichiers d’installation lorsqu’il se termine. L’ouverture des instructions de configuration ne démarre pas un déploiement.
- Dans le projet de migration terminé, sélectionnez Vérifier le résumé de la conversion.
- Sur la page Conversion summary, sélectionnez Setup instruction. Cette action devient disponible lorsque les fichiers d’installation sont prêts.
- Passez en revue le fichier généré
setup_instructions.md, qui s’ouvre dans l’éditeur. Visual Studio Code révèle également le dossier d’installation dans l’Explorateur. - Suivez Déployer les schémas convertis avec l’expérience d’installation pour préparer une base de données de destination hors production distincte, exécuter des vérifications de préparation, déployer les schémas convertis et passer en revue les résultats du déploiement.
Étape 14 : Valider le schéma déployé avant la mise en production
Utilisez la base de données hors production déployée à l’étape précédente pour les validations fonctionnelle, des données et de l’application, et non la base de données temporaire de conversion.
Si vous modifiez un objet après le déploiement, appliquez la correction manuellement :
- Connectez l’éditeur SQL au serveur PostgreSQL hors production et à la base de données où le schéma converti est déployé. Vérifiez la base de données active de l’éditeur.
- Passez en revue les références de schéma et sélectionnez l’instruction ou les instructions complètes que vous envisagez d’exécuter.
- Sélectionnez le bouton lecture pour exécuter uniquement les instructions sélectionnées. Passez en revue la sortie d’exécution et résolvez les erreurs avant de continuer.
- Vérifiez que les fichiers objet et sql de déploiement contiennent les corrections testées avant le déploiement de production. La mise à jour d’un fichier, la mise à jour d’un objet déployé et la mise à jour
deploy.sqlsont des actions distinctes.
Validez indépendamment le schéma déployé avec des données de test et des charges de travail d’application représentatives. Vérifiez les dépendances, les contraintes, la logique métier et les jeux de résultats sur la source Oracle, puis retestez après les corrections. Passez en revue les objets qui n’ont pas été convertis ou déployés, plutôt que de tester uniquement les conversions réussies.
Important
Responsabilité de validation du client : le même moteur IA utilisé pour la conversion de schéma peut également faciliter la validation et la révision. Les systèmes IA peuvent parfois confirmer leurs propres erreurs. Pour éviter la perte de données, les régressions fonctionnelles ou les problèmes de sécurité, validez indépendamment tous les objets convertis et les corrections au niveau de l’objet avant de déployer en production. Dans le cadre de vos contrôles, envisagez d’activer le filtrage de contenu Microsoft Foundry pour réduire les sorties dangereuses ou non souhaitées. Pour obtenir des conseils, consultez Content filtering for Microsoft Foundry Models.
Pour plus d’informations sur l’extension Visual Studio Code, consultez l’extension PostgreSQL pour Visual Studio Code et cursor.
Contenu connexe
- Qu’est-ce que la conversion de schéma Oracle vers Azure Database pour PostgreSQL - Serveur flexible ?
- Passer en revue les objets convertis dans Conversion Explorateur d'objets
- Déployer des schémas convertis avec Setup Experience
- Limites de conversion de schéma Oracle vers Azure Database pour PostgreSQL - Flexible Server