Remarque
L’accès à cette page requiert une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page requiert une autorisation. Vous pouvez essayer de modifier des répertoires.
Cet article présente un aperçu des méthodes disponibles pour ingérer des données dans un Eventhouse en utilisant l’expérience Get Data.
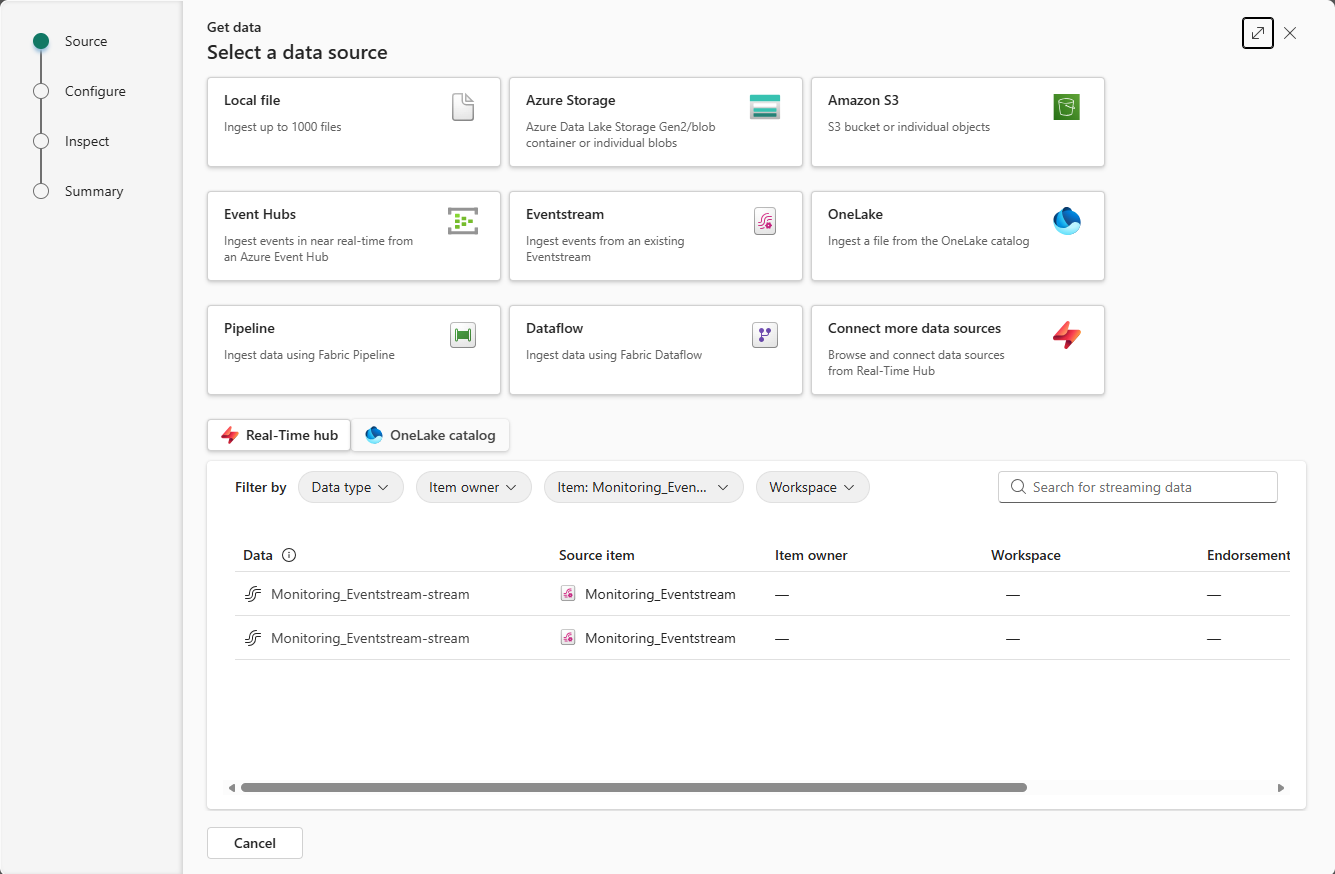
Sources de données
Vous pouvez ingérer des données dans un Eventhouse à partir des sources suivantes :
- Fichier local
- OneLake
- Hub en temps réel
- Eventstream
- Stockage Azure
- Azure Event Hubs
- Amazon S3
- Copie de pipeline de Data Factory
- Data Factory flux de données
- Événements métier d’Eventhouse et de Real-Time Dashboard
Sources de données supplémentaires
Si votre source n’est pas listée, sélectionnez Connecter plus de sources de données pour utiliser les connecteurs disponibles via Real-Time hub. Vous pouvez transférer des données dans Eventstream puis dans Eventhouse sans quitter le flux de travail Get Data. Dans ces cas, sélectionnez l’option Connecter plus de sources de données .
Prise en charge des messages volumineux (version préliminaire)
Important
Cette fonctionnalité est en version préliminaire.
Lorsque vous obtenez des données d’un flux d’événements ou d’un fichier local, l’aperçu des données inclut une case à cocher Autoriser les grandes valeurs pour string et colonnes dynamic . Lorsqu’activé, il permet à chaque cellule de données de contenir des valeurs allant de 1 Mo jusqu’à 32 Mo.
Cette capacité vous permet de garder une grande charge utile ensemble dans une seule cellule lorsque votre scénario l’exige.
Par exemple, stocker et traiter un document JSON volumineux dans un seul eventhouse string ou une seule colonne dynamic. Si votre scénario bénéficie plutôt d’un modèle de données plus structuré, vous pouvez transformer la charge utile en colonnes séparées en utilisant l’éditeur de traitement des événements d’Eventstream avant l’ingestion, ou une politique de mise à jour Eventhouse après l’ingestion.
Pour les scénarios analytiques, décomposer les gros messages en colonnes plus petites et structurées est généralement plus efficace. Cette approche peut réduire la consommation de mémoire et les opérations d’E/S (entrée/sortie) lors du stockage, de l’indexation et de l’interrogation des données.
Important
Dans le cadre de l’assistant d’ingestion, un mécanisme d’inférence de schéma analyse les 1 000 premiers enregistrements des données d’aperçu entrantes. S’il identifie une grande valeur parmi ces enregistrements, il sélectionne automatiquement la case à cocher et affiche un message qui vous informe que de grandes valeurs ont été détectées. Si une grande valeur apparaît plus tard dans les données, le moteur d’inférence de schéma ne la détecte pas automatiquement, et vous devez sélectionner manuellement la case à cocher pour ingérer des valeurs supérieures à 1 Mo par cellule.
Les formats AVRO, Parquet et TXT ne sont pas scannés pour les gros messages lors de cet assistant de configuration. Pour ces formats, vous devez sélectionner Autoriser les valeurs volumineuses si vous prévoyez que les valeurs stringdynamic dépassent 1 Mo par cellule.
La prise en charge des messages volumineux n’est pas disponible pour les raccourcis (tables externes) ni pour les tables avec accélération de requêtes via les raccourcis OneLake.
La disponibilité des données OneLake pour les tables avec des colonnes de grande valeur dépend des limites de taille cible.
Vous pouvez également activer cette option pour une colonne de tableau existante plus tard. Pour plus d’informations, voir Autoriser les grandes valeurs pour une colonne. Ce changement ne s’applique qu’aux nouvelles données ingérées à l’avenir ; les valeurs précédemment ingérées string sont tronquées à la limite (MaxValueSize la propriété de la politique par défaut est 1 Mo), dynamic les valeurs sont remplacées par nulles.
Lorsqu’elle est activée, la colonne utilise la politique d’encodage BigObjectIndexed32 , qui indexe de grandes valeurs pour la performance des requêtes mais augmente la consommation de mémoire. Pour vérifier si la politique est activée pour une colonne, consultez la politique d’encodage, ou consultez la table dans le panneau latéral des détails de la table dans Gérer et surveillez une table de base de données KQL. Pour plus d’informations sur la politique, voir Types de politiques d’encodage.