Remarque
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de modifier des répertoires.
Lorsque vous êtes prêt à créer une voix de synthèse vocale personnalisée pour votre application, commencez par collecter des enregistrements audio et des scripts associés pour entraîner le modèle vocal. Pour plus d’informations sur l’enregistrement d’échantillons vocaux, consultez le tutoriel. Le service Speech se sert de ces données pour créer une voix unique correspondant à la voix des enregistrements. Après avoir entraîné la voix, vous pouvez commencer à synthétiser la voix dans vos applications.
Toutes les données que vous chargez doivent respecter les exigences associées au type de données choisi. Il est important de mettre en forme correctement vos données avant leur chargement, ce qui garantit que les données sont traitées avec précision par le service Speech. Pour vérifier que vos données sont correctement formatées, voir Type de données d’entraînement.
Remarque
- Les utilisateurs qui disposent d’un abonnement standard (S0) peuvent charger cinq fichiers de données simultanément. Si vous atteignez la limite, patientez au moins jusqu’à la fin de l’importation de l’un de vos jeux de données. puis réessayez.
- Le nombre maximal de fichiers de données que les utilisateurs d’abonnement standard (S0) peuvent importer par abonnement est de 500 fichiers .zip. Pour plus d’informations, consultez quotas et limites du service Speech.
Charger vos données
Conseil / Astuce
Pour obtenir un exemple d’instruction de consentement et de données d’apprentissage, consultez le dépôt GitHub.
Pour charger des données d’entraînement, procédez comme suit :
Ces étapes continuent à partir de la page Personnaliser un modèle que vous avez ouverte dans Configurer une voix professionnelle.
Si vous avez fermé la page, reprenez la personnalisation de votre brouillon avant de continuer.
Dans Foundry (nouveau), organisez vos données d’apprentissage dans des jeux de données. Vous pouvez créer plusieurs jeux de données, charger des données sur chacun d’eux et sélectionner des jeux de données éligibles lorsque vous configurez l’entraînement.
À l’étape Données d’entraînement , sélectionnez Créer un jeu de données.
Dans le volet Créer un jeu de données , entrez un nom de jeu de données, puis sélectionnez Créer.
Sélectionnez le nouveau jeu de données dans la liste déroulante Sélectionner un jeu de données , puis sélectionnez Ajouter des données.
Dans le volet Ajouter des données , choisissez un type de données. Si vous utilisez les exemples de données, sélectionnez Énoncés individuels + transcription correspondante.
Pour Traité comme, choisissez un mode pris en charge par votre type de données :
- Segmenté : utilisez ce mode pour les énoncés individuels + transcription correspondante. Vous pouvez également l’utiliser pour audio long + transcription ou audio uniquement afin de segmenter les enregistrements en énoncés.
- Contextuel : disponible pour audio long + transcription et audio uniquement dans les langues prises en charge. Ce mode conserve les informations contextuelles et l’intonation naturelle. Vous ne pouvez pas combiner de données contextuelles avec des données segmentées.
Consultez les types de données d’entraînement pour connaître les combinaisons prises en charge et les restrictions linguistiques.
Chargez les données à l’aide de l’une des méthodes suivantes :
- Fichiers locaux : sélectionnez le fichier d’enregistrement à partir de votre ordinateur. Pour les types de données avec une transcription, sélectionnez également le fichier de script.
- Azure Blob: entrez l’URL du blob d’enregistrement. Pour les types de données avec une transcription, entrez également l’URL de l’objet blob de script.
Pour l’audio uniquement, ne fournissez pas de script. Le service génère la transcription pendant le traitement.
Sélectionnez Téléverser. La section Aperçu des données affiche les résultats de validation une fois le traitement terminé.
Si votre jeu de données n’est pas prêt pour l’entraînement, passez en revue l’aperçu des données et résolvez les problèmes de données. Vérifiez ensuite l’éligibilité pour la méthode d’entraînement et la version sélectionnées avant de continuer.
Afficher ou supprimer un jeu de données existant
Si vous avez chargé les données d’apprentissage incorrectes, recherchez le jeu de données sous l’ongletDonnées sous Services. Cet onglet est distinct des données dans le volet de navigation gauche.
- Ouvrez le projet Foundry qui contient le jeu de données.
- Sélectionnez Build>Services, puis sélectionnez l’onglet Données .
- Recherchez le jeu de données avec les balises Synthèse vocale et Voix professionnelle. Sélectionnez son nom pour passer en revue les détails, y compris les données acceptées et les données rejetées.
Pour supprimer un jeu de données indésirable :
Revenez auxdonnéesdes services>.
Dans la ligne du jeu de données, ouvrez le menu Actions (trois points), puis sélectionnez Supprimer.
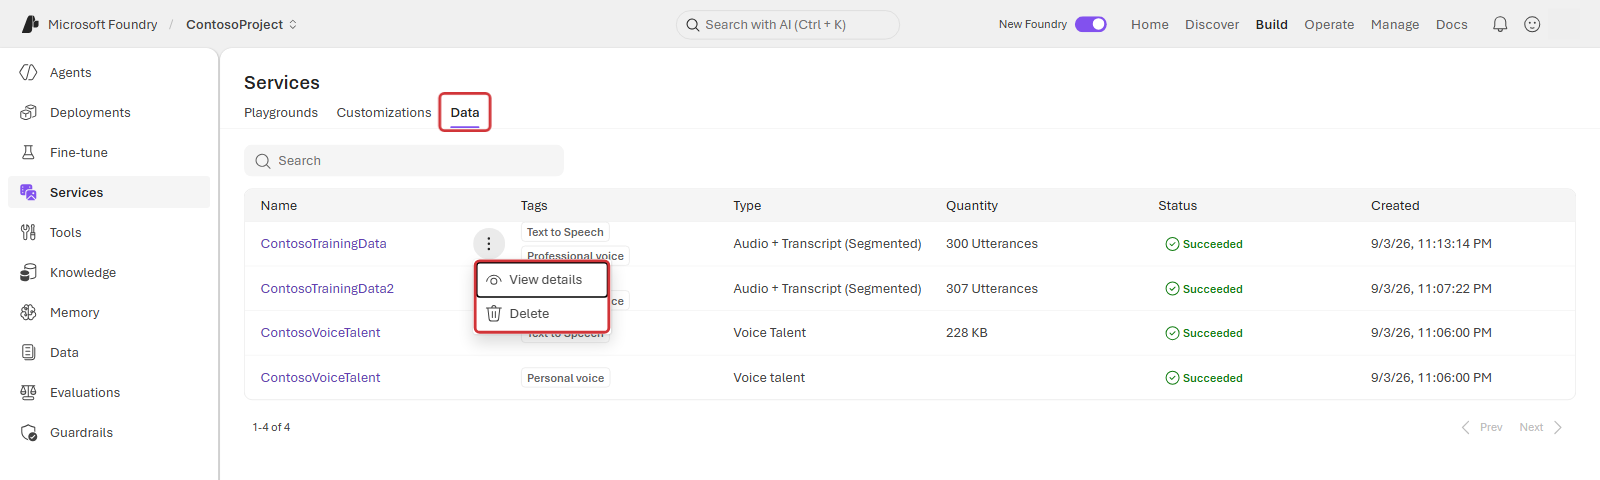
Dans la boîte de dialogue Supprimer la ressource du service IA , vérifiez que le nom affiché correspond au jeu de données que vous souhaitez supprimer.
Sélectionnez Supprimer pour confirmer ou Annuler pour conserver le jeu de données.
Important
La suppression ne peut pas être annulée. Vérifiez que vous avez sélectionné le jeu de données indésirable avant de le supprimer.
Pour créer un jeu de données de remplacement, revenez aux données d’apprentissage dans votre personnalisation et suivez Charger vos données.


Remarque
Les ID en double ne sont pas acceptés. Les énoncés avec le même ID sont supprimés.
Les noms audio en double seront retirés de l’apprentissage. Veillez à ce que les données sélectionnées ne comportent pas les mêmes noms audio au sein du fichier .zip ou dans plusieurs fichiers .zip. Si des ID d’énoncé (dans des fichiers audio ou de script) sont dupliqués, ils sont rejetés.
Le service valide automatiquement les données chargées. La validation vérifie les fichiers audio pour les exigences telles que le format de fichier, la taille et le taux d’échantillonnage. En cas d’erreurs, corrigez-les et chargez à nouveau les données.
Passez en revue les résultats de validation avant d’entraîner le modèle. Vous pouvez passer en revue les problèmes de prononciation et le niveau de bruit pour chaque énoncé. Le score de prononciation au niveau de la phrase est compris entre 0 et 100. Normalement, un score inférieur à 70 indique une erreur de prononciation ou un problème de correspondance du script. Les énoncés avec un score global inférieur à 70 sont rejetés. Un accent marqué peut réduire votre score de prononciation et affecter la voix numérique générée.
Examiner les problèmes de données
Avant de continuer à entraîner votre modèle vocal, passez en revue les résultats de validation et résolvez les problèmes de données.
Problèmes de données typiques
Les tableaux suivants décrivent les problèmes de données courants.
Rejeté automatiquement
Le processus d’apprentissage exclut les données avec ces problèmes. Le processus d’importation les ignore. Vous n’avez donc pas besoin de les supprimer. Résolvez les problèmes dans les fichiers sources, puis chargez les données corrigées pour l’entraînement.
| Catégorie | Nom | Descriptif |
|---|---|---|
| Scénario | Séparateur non valide | Vous devez séparer l’ID d’énoncé et le contenu du script par un caractère de tabulation. |
| Scénario | ID de script non valide | L’ID de ligne de script doit être numérique. |
| Scénario | Script dupliqué | Chaque ligne du contenu du script doit être unique. La ligne est dupliquée avec {}. |
| Scénario | Script trop long | La taille du script doit être inférieure à 1000 caractères. |
| Scénario | Aucun audio correspondant | L’ID de chaque énoncé (chaque ligne du fichier de script) doit correspondre à l’ID de l’audio. |
| Scénario | Aucun script valide | Aucun script valide n’a été trouvé dans ce jeu de données. Corrigez les lignes de script qui apparaissent dans la liste détaillée des problèmes. |
| Audio | Aucun script correspondant | Aucun fichier audio ne correspond à l’ID de script. Le nom des fichiers .wav doit correspondre aux ID du fichier de script. |
| Audio | Format audio non valide | Le format audio des fichiers .wav n’est pas valide. Vérifiez le format de fichier .wav à l’aide d’un outil audio comme SoX. |
| Audio | Taux d’échantillonnage faible | La fréquence d’échantillonnage des fichiers .wav ne peut pas être inférieure à 16 KHz. |
| Audio | Audio trop long | La durée audio est supérieure à 30 secondes. Fractionnez le contenu audio long en plusieurs fichiers. Il est judicieux de rendre les énoncés plus courts que 15 secondes. |
| Audio | Aucun audio valide | Aucun audio valide n’est trouvé dans ce jeu de données. Vérifiez vos données audio et chargez-les à nouveau. |
| Incompatibilité | Énoncé à faible score | Le score de prononciation au niveau de la phrase est inférieur à 70. Examinez le script et le contenu audio pour vérifier qu’ils correspondent. |
Corrigé automatiquement
Le système corrige automatiquement les problèmes suivants, mais vous devez vérifier et confirmer que les correctifs sont corrects.
| Catégorie | Nom | Descriptif |
|---|---|---|
| Incompatibilité | Silence résolu automatiquement | Le silence de début est détecté comme étant inférieur à 100 ms et est étendu automatiquement à 100 ms. Téléchargez le jeu de données normalisé et passez-le en revue. |
| Incompatibilité | Silence résolu automatiquement | Le silence de fin est détecté comme étant inférieur à 100 ms et est étendu automatiquement à 100 ms. Téléchargez le jeu de données normalisé et passez-le en revue. |
| Scénario | Texte normalisé automatiquement | Le texte est automatiquement normalisé pour les chiffres, les symboles et les abréviations. Examinez le script et le fichier audio pour vérifier leur correspondance. |
Vérification manuelle requise
Les problèmes non résolus répertoriés dans le tableau suivant affectent la qualité de l’entraînement, mais le processus d’entraînement n’exclut pas les données avec ces problèmes. Pour une formation de meilleure qualité, corrigez ces problèmes manuellement.
| Catégorie | Nom | Descriptif |
|---|---|---|
| Scénario | Texte non normalisé | Ce script contient des symboles. Normalisez les symboles pour qu’ils correspondent à l’audio. Par exemple, normalisez / par rapport à la barre oblique. |
| Scénario | Trop peu d’énoncés interrogatifs | Au moins 10 % de l’ensemble des énoncés doivent être des phrases interrogatives. Cela permet au modèle vocal d’exprimer correctement une tonalité interrogative. |
| Scénario | Pas assez d’énoncés exclamatifs | Au moins 10 % du total des énoncés doivent être des phrases exclamatives. Cela permet au modèle vocal d’exprimer correctement une tonalité enthousiaste. |
| Scénario | Aucun signe de ponctuation de fin valide | Ajoutez l’une des options suivantes à la fin de la ligne : arrêt complet (demi-largeur '.' ou pleine largeur '。 '), point d’exclamation (demi-largeur ' !' ou pleine largeur ' !'), ou point d’interrogation (demi-largeur ' ?' ou pleine largeur ' ?'). |
| Audio | Taux d’échantillonnage faible pour la voix neuronale | Il est recommandé que le taux d’échantillonnage de vos fichiers .wav soit de 24 KHz ou supérieur pour la création de voix neuronales. S’il est inférieur, le système l’élève automatiquement à 24 KHz. |
| Volume | Volume global trop faible | Le volume ne doit pas être inférieur à -18 dB (10 % du volume maximal). Vérifiez que le niveau moyen du volume se situe dans la plage appropriée pendant l’enregistrement de l’exemple ou la préparation des données. |
| Volume | Dépassement du volume | Un dépassement du volume est détecté à {} s. Réglez le matériel d’enregistrement pour éviter tout dépassement du volume au-delà de la valeur maximale. |
| Volume | Problème de silence au démarrage | Le silence des 100 premières ms n’est pas propre. Réduisez le niveau de bruit d’enregistrement et laissez un silence de début pour les 100 premières ms. |
| Volume | Résoudre le problème de silence | Le silence des 100 dernières ms n’est pas propre. Réduisez le niveau de bruit d’enregistrement et laissez un silence de fin pour les 100 dernières ms. |
| Incompatibilité | Mots à score faible | Examinez le script et le contenu audio pour vérifier qu’ils correspondent, et contrôlez le niveau de bruit de fond. Réduisez la durée du silence long ou fractionnez l’audio en plusieurs énoncés s’il est trop long. |
| Incompatibilité | Problème de silence au démarrage | Un audio supplémentaire est entendu avant le premier mot. Examinez le script et le contenu audio pour vérifier qu’ils correspondent, contrôlez le niveau du bruit de fond et laissez un silence pour les 100 premières ms. |
| Incompatibilité | Résoudre le problème de silence | Un audio supplémentaire est entendu après le dernier mot. Examinez le script et le contenu audio pour vérifier qu’ils correspondent, contrôlez le niveau du bruit de fond et laissez un silence pour les 100 derniers ms. |
| Incompatibilité | Ratio signal-bruit faible | Le niveau du ratio signal-bruit de l’audio est inférieur à 20 dB. Un niveau de 35 dB minimum est recommandé. |
| Incompatibilité | Aucun score disponible | Échec de la reconnaissance du contenu vocal dans cet audio. Vérifiez l’audio et le contenu du script pour vous assurer que l’audio est valide et qu’il correspond au script. |
Étape suivante
Dès que vous êtes prêt à créer une voix personnalisée pour la synthèse vocale dans votre application, vous devez dans un premier temps rassembler les enregistrements audio et les scripts associés pour commencer l’apprentissage du modèle vocal. Pour plus d’informations sur l’enregistrement d’échantillons vocaux, consultez le tutoriel. Le service Speech se sert de ces données pour créer une voix unique correspondant à la voix des enregistrements. Après avoir entraîné la voix, vous pouvez commencer la synthèse vocale dans vos applications.
Toutes les données que vous chargez doivent respecter les exigences associées au type de données choisi. Il est important de formater correctement vos données avant leur chargement, ce qui permet au service Speech de les traiter correctement. Pour vérifier que vos données sont correctement formatées, voir Type de données d’entraînement.
Remarque
- Les utilisateurs qui disposent d’un abonnement standard (S0) peuvent charger cinq fichiers de données simultanément. Si vous atteignez la limite, patientez au moins jusqu’à la fin de l’importation de l’un de vos jeux de données. puis réessayez.
- Le nombre maximal de fichiers de données qu’il est autorisé d’importer par abonnement est de 500 fichiers zip pour les utilisateurs disposant d’un abonnement standard (S0). Pour plus d’informations, consultez les Quotas et limites du service Speech.
Charger vos données
Quand vous êtes prêt à charger vos données, accédez à l’onglet Préparer des données d’entraînement pour ajouter votre premier jeu d’entraînement et charger des données. Un jeu d’apprentissage est un ensemble d’énoncés audio et de scripts correspondants utilisés pour effectuer l'apprentissage d’un modèle vocal. Vous pouvez utiliser un jeu d’entraînement pour organiser vos données d’entraînement. Le service vérifie la disponibilité des données pour chaque jeu d’apprentissage. Vous pouvez importer des données multiples dans un jeu d’apprentissage.
Pour charger des données d’entraînement, procédez comme suit :
- Connectez-vous à Speech Studio.
- Sélectionnez Voix personnalisée> Votre nom de projet >Préparer des données d’entraînement>Charger des données.
- Dans l’Assistant Chargement de données, choisissez un type de données, puis sélectionnez Suivant.
- Sélectionnez des fichiers locaux à partir de votre ordinateur ou entrez l’URL du stockage Blob Azure pour charger des données.
- Si vous avez sélectionné des types de données Audio + transcription long ou Audio uniquement dans les projets de prise en charge contextuelle, vous verrez une option pour choisir le mode de traitement :
- Traité en tant que contexte : traite l’audio tout en conservant des informations contextuelles pour des capacités conversationnelles améliorées et des modèles de parole plus naturels.
- Segmenté : transforme l’audio et la transcription en énoncés individuels à l’aide de la segmentation standard.
- Sous Spécifier le jeu d’entraînement cible, sélectionnez un jeu d’entraînement existant ou créez-en un. Si vous avez créé un jeu d’entraînement, vérifiez qu’il est sélectionné dans la liste déroulante avant de continuer.
- Sélectionnez Suivant.
- Entrez un nom et une description pour vos données, puis sélectionnez Suivant.
- Passez en revue les détails du chargement, puis sélectionnez Envoyer.
Remarque
Les ID en double ne sont pas acceptés. Les énoncés avec le même ID seront supprimés.
Les noms audio en double seront retirés de l’apprentissage. Veillez à ce que les données sélectionnées ne comportent pas les mêmes noms audio au sein du fichier .zip ou dans plusieurs fichiers .zip. Si des ID d’énoncé (dans des fichiers audio ou de script) sont dupliqués, ils sont rejetés.
Un jeu d’entraînement ne peut contenir que des données traitées en même mode. Par exemple, si vous chargez des données en utilisant le mode Traité comme contextuel dans un jeu d’entraînement, tous les chargements suivants vers ce même jeu d’entraînement doivent également utiliser le mode Traité comme contextuel.
Les fichiers de données sont validés automatiquement lorsque vous sélectionnez Envoyer. La validation des données passe par une série de vérifications des fichiers audio visant à contrôler leur format, leur taille et leur taux d’échantillonnage. En cas d’erreurs, corrigez-les et resoumettez-les.
Une fois que vous avez chargé les données, vous pouvez vérifier les détails dans la vue détaillée du jeu d’apprentissage. Dans la page de détails, vous pouvez vérifier plus précisément les problèmes de prononciation et le niveau de bruit de toutes vos données. Le score de prononciation au niveau de la phrase varie entre 0 et 100. Normalement, un score inférieur à 70 indique une erreur de prononciation ou un problème de correspondance du script. Les énoncés avec un score global inférieur à 70 sont rejetés. Un accent marqué peut réduire votre score de prononciation et affecter la voix numérique générée.
Résoudre les problèmes de données en ligne
Après le chargement, vous pouvez vérifier les détails des données du jeu d’apprentissage. Avant de continuer à entraîner votre modèle vocal, vous devez essayer de résoudre les problèmes de données.
Vous pouvez identifier et résoudre les problèmes de données par énoncé dans Speech Studio.
Traité comme segmenté
Dans la page de détails, rendez-vous à la page des Données acceptées ou celle des Données rejetées. Sélectionnez les phrases individuelles que vous souhaitez modifier, puis sélectionnez Modifier.

Vous pouvez choisir les problèmes de données à afficher selon vos critères.

La fenêtre Modifier s’affiche.

Mettez à jour la transcription ou le fichier d’enregistrement en fonction de la description du problème dans la fenêtre d’édition.
Vous pouvez modifier la transcription dans la zone de texte, puis sélectionner Terminé

Si vous devez mettre à jour le fichier d’enregistrement, sélectionnez Mettre à jour le fichier d’enregistrement, puis chargez le fichier d’enregistrement fixe (.wav).

Une fois les modifications apportées à vos données, vous devez vérifier la qualité des données en cliquant sur Analyser les données avant d’utiliser ce jeu de données pour l’entraînement.
Vous ne pouvez pas sélectionner ce jeu d’apprentissage pour le modèle d’apprentissage avant la fin de l’analyse.

Vous pouvez également supprimer des énoncés présentant des problèmes en les sélectionnant et en cliquant sur Supprimer.
Traité en tant que contexte
Contrairement au traitement en tant que segmenté, traité comme contextuel conserve les fichiers audio d’origine et génère des informations contextuelles correspondantes.
Dans la page de détails, cliquez sur des énoncés individuels avec « Nombre de problèmes ».

Les informations contextuelles sont présentées sous forme de segments. Sélectionnez le segment que vous souhaitez modifier, puis cliquez sur le bouton Modifier .

Vous pouvez choisir les problèmes de données à afficher selon vos critères.
Modifiez la transcription dans la zone de texte en fonction de la description du problème, puis sélectionnez Terminé.

Une fois que vous avez apporté des modifications à vos données, vous devez vérifier la qualité des données en cliquant sur Analyser les données avant d’utiliser ce jeu de données pour l’entraînement.
Vous ne pouvez pas sélectionner ce jeu d’apprentissage pour le modèle d’apprentissage avant la fin de l’analyse.
Remarque
La suppression d’un segment d’informations contextuelles n’exclut pas ce contenu de l’entraînement. Supprimez uniquement les segments lorsque leurs informations sont déjà incluses ou seront incluses dans des segments adjacents.
Les segments rejetés ne seront pas utilisés pour l’entraînement.
Problèmes de données typiques
Les problèmes sont divisés en trois types. Reportez-vous aux tableaux suivants pour vérifier les types d’erreurs respectifs.
Rejeté automatiquement
Les données avec ces erreurs ne seront pas utilisées pour l’apprentissage. Les données importées avec des erreurs seront ignorées. Vous n’avez donc pas besoin de les supprimer. Vous pouvez corriger ces erreurs de données en ligne ou charger à nouveau les données corrigées pour l’entraînement.
| Catégorie | Nom | Descriptif |
|---|---|---|
| Scénario | Séparateur non valide | Vous devez séparer l’ID d’énoncé et le contenu du script par un caractère de tabulation. |
| Scénario | ID de script non valide | L’ID de ligne de script doit être numérique. |
| Scénario | Script dupliqué | Chaque ligne du contenu du script doit être unique. La ligne est dupliquée avec {}. |
| Scénario | Script trop long | La taille du script doit être inférieure à 1000 caractères. |
| Scénario | Aucun audio correspondant | L’ID de chaque énoncé (chaque ligne du fichier de script) doit correspondre à l’ID de l’audio. |
| Scénario | Aucun script valide | Aucun script valide n’a été trouvé dans ce jeu de données. Corrigez les lignes de script affichées dans la liste détaillée des problèmes. |
| Audio | Aucun script correspondant | Aucun fichier audio ne correspond à l’ID de script. Le nom des fichiers .wav doit correspondre aux ID du fichier de script. |
| Audio | Format audio non valide | Le format audio des fichiers .wav n’est pas valide. Vérifiez le format de fichier .wav à l’aide d’un outil audio comme SoX. |
| Audio | Taux d’échantillonnage faible | La fréquence d’échantillonnage des fichiers .wav ne peut pas être inférieure à 16 KHz. |
| Audio | Audio trop long | La durée audio est supérieure à 30 secondes. Fractionnez le contenu audio long en plusieurs fichiers. Il est judicieux de rendre les énoncés plus courts que 15 secondes. |
| Audio | Aucun audio valide | Aucun audio valide n’est trouvé dans ce jeu de données. Vérifiez vos données audio et chargez-les à nouveau. |
| Incompatibilité | Énoncé à faible score | Le score de prononciation au niveau de la phrase est inférieur à 70. Examinez le script et le contenu audio pour vérifier qu’ils correspondent. |
Corrigé automatiquement
Les erreurs suivantes sont résolues automatiquement, mais vous devez vérifier et confirmer que les corrections ont été effectués.
| Catégorie | Nom | Descriptif |
|---|---|---|
| Incompatibilité | Silence résolu automatiquement | La durée du silence de début est détectée comme étant inférieure à 100 ms et a été étendue à 100 ms automatiquement. Téléchargez le jeu de données normalisé et passez-le en revue. |
| Incompatibilité | Silence résolu automatiquement | La durée du silence de fin est détectée comme étant inférieure à 100 ms et a été étendue à 100 ms automatiquement. Téléchargez le jeu de données normalisé et passez-le en revue. |
| Scénario | Texte normalisé automatiquement | Le texte est automatiquement normalisé pour les chiffres, les symboles et les abréviations. Examinez le script et le fichier audio pour vérifier leur correspondance. |
Vérification manuelle requise
Les erreurs non résolues énumérées dans le tableau suivant affectent la qualité de l’apprentissage, mais les données avec ces erreurs ne sont pas exclues lors de l’apprentissage. Pour un apprentissage de meilleure qualité, il est judicieux de corriger ces erreurs manuellement.
| Catégorie | Nom | Descriptif |
|---|---|---|
| Scénario | Texte non normalisé | Ce script contient des symboles. Normalisez les symboles pour qu’ils correspondent à l’audio. Par exemple, normalisez / par rapport à la barre oblique. |
| Scénario | Trop peu d’énoncés interrogatifs | Au moins 10 % de l’ensemble des énoncés doivent être des phrases interrogatives. Cela permet au modèle vocal d’exprimer correctement une tonalité interrogative. |
| Scénario | Pas assez d’énoncés exclamatifs | Au moins 10 % du total des énoncés doivent être des phrases exclamatives. Cela permet au modèle vocal d’exprimer correctement une tonalité enthousiaste. |
| Scénario | Aucun signe de ponctuation de fin valide | Ajoutez l’un des signes de ponctuation suivants à la fin de la ligne : point (demi-chasse « . » ou pleine chasse « 。 »), point d’exclamation (demi-chasse « ! » ou pleine chasse « ! ») ou point d’interrogation (demi-chasse « ? » ou pleine chasse « ? »). |
| Audio | Taux d’échantillonnage faible pour la voix neuronale | Un taux d’échantillonnage de 24 KHz ou supérieur est recommandé pour vos fichiers .wav en vue de créer des voix neuronales. Si la valeur est inférieure, elle est automatiquement augmentée à 24 KHz. |
| Volume | Volume global trop faible | Le volume ne doit pas être inférieur à -18 dB (10 % du volume maximal). Vérifiez que le niveau moyen du volume se situe dans la plage appropriée pendant l’enregistrement de l’exemple ou la préparation des données. |
| Volume | Dépassement du volume | Un dépassement du volume est détecté à {} s. Réglez le matériel d’enregistrement pour éviter tout dépassement du volume au-delà de la valeur maximale. |
| Volume | Problème de silence de début | Le silence des 100 premières ms n’est pas propre. Réduisez le niveau de bruit d’enregistrement et laissez un silence de début pour les 100 premières ms. |
| Volume | Problème de silence de fin | Le silence des 100 dernières ms n’est pas propre. Réduisez le niveau de bruit d’enregistrement et laissez un silence de fin pour les 100 dernières ms. |
| Incompatibilité | Mots à score faible | Examinez le script et le contenu audio pour vérifier qu’ils correspondent, et contrôlez le niveau de bruit de fond. Réduisez la durée du silence long ou fractionnez l’audio en plusieurs énoncés s’il est trop long. |
| Incompatibilité | Problème de silence de début | Un audio supplémentaire est entendu avant le premier mot. Examinez le script et le contenu audio pour vérifier qu’ils correspondent, contrôlez le niveau du bruit de fond et laissez un silence pour les 100 premières ms. |
| Incompatibilité | Problème de silence de fin | Un audio supplémentaire est entendu après le dernier mot. Examinez le script et le contenu audio pour vérifier qu’ils correspondent, contrôlez le niveau du bruit de fond et laissez un silence pour les 100 derniers ms. |
| Incompatibilité | Ratio signal-bruit faible | Le niveau du ratio signal-bruit de l’audio est inférieur à 20 dB. Un niveau de 35 dB minimum est recommandé. |
| Incompatibilité | Aucun score disponible | Échec de la reconnaissance du contenu vocal dans cet audio. Vérifiez l’audio et le contenu du script pour vous assurer que l’audio est valide et qu’il correspond au script. |
Étapes suivantes
Vous avez besoin d’un jeu de données d’apprentissage pour créer une voix professionnelle. Un jeu de données d’apprentissage inclut des fichiers audio et de script. Les fichiers audio sont des enregistrements du talent vocal lisant les fichiers de script. Les fichiers de script sont le texte des fichiers audio.
Dans cet article, vous allez créer un jeu d’apprentissage et obtenir son ID de ressource. Ensuite, à l’aide de l’ID de ressource, vous pouvez charger un ensemble de fichiers audio et de script.
Créer un script d’apprentissage
Pour créer un jeu d’apprentissage, utilisez l’opération TrainingSets_Create de l’API Custom Voice. Construisez le corps de la requête conformément aux instructions suivantes :
- Définissez la propriété requise
projectId. Consultez Créer un projet. - Définissez la propriété requise
voiceKindsurMaleouFemale. Vous ne pourrez plus changer ce type. - Définissez la propriété requise
locale. Il doit s’agir des paramètres régionaux des données du jeu d’apprentissage. Les paramètres régionaux du jeu d’apprentissage doivent être identiques aux paramètres régionaux de l’instruction de consentement. Désolé, vous ne pourrez plus changer de paramètres régionaux. Vous trouverez la liste des paramètres régionaux de synthèse vocale ici. - Si vous le souhaitez, définissez la propriété
descriptionpour la description du jeu d’apprentissage. La description du jeu d’apprentissage peut être modifiée ultérieurement.
Effectuez une requête HTTP PUT à l’aide de l’URI, comme illustré dans l’exemple TrainingSets_Create suivant.
- Remplacez
YourResourceKeypar votre clé de ressource Speech. - Remplacez par
YourResourceNamele nom de votre ressource Speech. - Remplacez
JessicaTrainingSetIdpar un ID de jeu d’apprentissage de votre choix. L’ID sensible à la casse est utilisé dans l’URI du jeu d’apprentissage et ne peut pas être modifié plus tard.
curl -v -X PUT -H "Ocp-Apim-Subscription-Key: YourResourceKey" -H "Content-Type: application/json" -d '{
  "description": "300 sentences Jessica data in general style.",
  "projectId": "ProjectId",
  "locale": "en-US",
  "voiceKind": "Female"
} '  "https://YourResourceName.cognitiveservices.azure.com/customvoice/trainingsets/JessicaTrainingSetId?api-version=2026-01-01"
Vous devriez recevoir un corps de réponse au format suivant :
{
  "id": "JessicaTrainingSetId",
  "description": "300 sentences Jessica data in general style.",
  "projectId": "ProjectId",
  "locale": "en-US",
  "voiceKind": "Female",
  "status": "Succeeded",
  "createdDateTime": "2023-04-01T05:30:00.000Z",
  "lastActionDateTime": "2023-04-02T10:15:30.000Z"
}
Charger les données du jeu d’apprentissage
Pour charger un jeu d’apprentissage constitué de fichiers audio et de scripts, utilisez l’opération TrainingSets_UploadData de l’API Custom Voice.
Avant d’appeler cette API, stockez les fichiers d’enregistrement et de script dans Azure Blob. Dans l’exemple suivant, les fichiers d’enregistrement sont https://contoso.blob.core.windows.net/voicecontainer/jessica300/*.wav, les fichiers de script sont https://contoso.blob.core.windows.net/voicecontainer/jessica300/*.txt.
Construisez le corps de la requête conformément aux instructions suivantes :
- Définissez la propriété requise
kindsurAudioAndScript,LongAudioouAudioOnly. Le type détermine le type de jeu d’apprentissage. - Si vous le souhaitez, définissez la
processAspropriété pour spécifier la méthode de traitement. Les valeurs prises en charge sontSegmented(par défaut) etContextual.Contextualest un mode amélioré qui conserve l’audio dans son ensemble pour conserver les informations contextuelles pour des intonations plus naturelles. LeContextualmode est disponible uniquement lorsqu’ilkindest défini surLongAudioouAudioOnly. S’il n’est pas spécifié, le mode par défautSegmentedest utilisé. Pour plus d’informations, consultez les types de données d’apprentissage. - Définissez la propriété requise
audios. Dans la propriétéaudios, définissez les propriétés suivantes :- Définissez la propriété requise
containerUrlsur l’URL du conteneur Stockage Blob Azure qui contient les fichiers audio. Utilisez des signatures d’accès partagé (SAP) pour un conteneur avec des autorisations de lecture et de liste. - Définissez la propriété requise
extensionssur les extensions des fichiers audio. - Si vous le souhaitez, définissez la propriété
prefixpour définir un préfixe pour le nom de l’objet blob.
- Définissez la propriété requise
- Définissez la propriété requise
scripts. Dans la propriétéscripts, définissez les propriétés suivantes :- Définissez la propriété requise
containerUrlsur l’URL du conteneur Stockage Blob Azure qui contient les fichiers de script. Utilisez des signatures d’accès partagé (SAP) pour un conteneur avec des autorisations de lecture et de liste. - Définissez la propriété requise
extensionssur les extensions des fichiers de script. - Si vous le souhaitez, définissez la propriété
prefixpour définir un préfixe pour le nom de l’objet blob.
- Définissez la propriété requise
Effectuez une requête HTTP POST à l’aide de l’URI, comme illustré dans l’exemple TrainingSets_UploadData suivant.
- Remplacez
YourResourceKeypar votre clé de ressource Speech. - Remplacez par
YourResourceNamele nom de votre ressource Speech. - Remplacez
JessicaTrainingSetIdsi vous avez spécifié un ID de jeu d’apprentissage différent à l’étape précédente.
curl -v -X POST -H "Ocp-Apim-Subscription-Key: YourResourceKey" -H "Content-Type: application/json" -d '{
  "kind": "AudioAndScript",
  "audios": {
    "containerUrl": "https://contoso.blob.core.windows.net/voicecontainer?mySasToken",
    "prefix": "jessica300/",
    "extensions": [
      ".wav"
    ]
  },
  "scripts": {
    "containerUrl": "https://contoso.blob.core.windows.net/voicecontainer?mySasToken",
    "prefix": "jessica300/",
    "extensions": [
      ".txt"
    ]
  }
} '  "https://YourResourceName.cognitiveservices.azure.com/customvoice/trainingsets/JessicaTrainingSetId:upload?api-version=2026-01-01"
L’exemple suivant charge des données audio longues avec un traitement contextuel :
curl -v -X POST -H "Ocp-Apim-Subscription-Key: YourResourceKey" -H "Content-Type: application/json" -d '{
  "kind": "LongAudio",
  "processAs": "Contextual",
  "audios": {
    "containerUrl": "https://contoso.blob.core.windows.net/voicecontainer?mySasToken",
    "prefix": "jessica-long/",
    "extensions": [
      ".wav"
    ]
  },
  "scripts": {
    "containerUrl": "https://contoso.blob.core.windows.net/voicecontainer?mySasToken",
    "prefix": "jessica-long/",
    "extensions": [
      ".txt"
    ]
  }
} '  "https://YourResourceName.cognitiveservices.azure.com/customvoice/trainingsets/JessicaTrainingSetId:upload?api-version=2026-01-01"
L’en-tête de réponse contient la propriété Operation-Location. Utilisez cet URI pour obtenir des informations sur l’opération TrainingSets_UploadData. Voici un exemple d’en-tête de réponse :
Operation-Location: https://YourResourceName.cognitiveservices.azure.com/customvoice/operations/aaaabbbb-0000-cccc-1111-dddd2222eeee?api-version=2026-01-01
Operation-Id: aaaabbbb-0000-cccc-1111-dddd2222eeee