Remarque
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de modifier des répertoires.
Créez et gérez des tables de recherche distinctes pour les données que les applications utilisent fréquemment dans les requêtes lorsqu’un magasin de données ne fournit pas d’index secondaires appropriés. Cette approche améliore les performances de lecture en évitant les analyses complètes des données lorsque les requêtes n’utilisent pas la clé primaire ou la clé de partition.
Contexte et problème
De nombreux magasins de données organisent les données pour une collection d’entités à l’aide de la clé primaire. Une application peut utiliser cette clé pour localiser et récupérer des données. La figure suivante montre un exemple de magasin de données contenant les informations client organisées par la clé primaire, l’ID client.
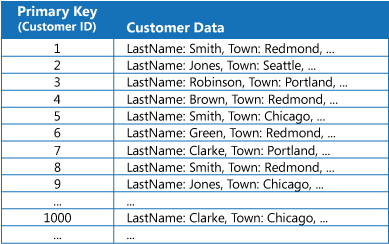
L’image montre un tableau à deux colonnes contenant des enregistrements de clients. La première colonne, clé primaire (ID client), contient les identifiants client de 1 à 9, suivis d’un point de suspension, de l’ID 1000, puis d’un autre point de suspension. La deuxième colonne, Customer Data, contient des données client composées d’un nom et d’une ville suivis d’un point de suspension. Les exemples visibles incluent l’ID 1, qui correspond au nom Smith et à la ville de Redmond, et à l’ID 2, qui correspond au nom Jones et à la ville de Seattle. Une autre ligne montre Smith à Chicago, et un autre montre Smith à Redmond. Encore une autre ligne indique que Jones est à Chicago.
Bien que la clé primaire soit utile pour les requêtes qui extraient des données en fonction de la valeur de cette clé, une application qui doit récupérer des données basées sur un autre champ ne peut pas utiliser la clé primaire pour cette requête. Dans l’exemple du client, une application ne peut pas utiliser la clé primaire d’ID client pour récupérer les clients si elle interroge les données uniquement en référençant la valeur d’un autre attribut, tel que la ville dans laquelle se trouve le client. Pour effectuer une requête qui référence uniquement la ville, l’application peut devoir extraire et examiner chaque enregistrement client, ce qui peut être un processus lent.
De nombreux systèmes de gestion de base de données relationnelle prennent en charge les index secondaires. Un index secondaire est une structure de données distincte organisée par un ou plusieurs champs de clés non primaires (secondaires). Un index secondaire indique où les données de chaque valeur indexée sont stockées. Les éléments dans un index secondaire sont généralement triés en fonction de la valeur des clés secondaires pour permettre une recherche rapide des données. Le système de gestion de base de données gère généralement ces index automatiquement.
Les bases de données relationnelles permettent à plusieurs index secondaires de prendre en charge différents modèles de requête. Par exemple, dans une table Customers dans une base de données relationnelle où l’ID client est la clé primaire, il est utile d’ajouter un index secondaire sur le champ Ville si l’application recherche fréquemment les clients par la ville où ils résident.
Bien que les index secondaires soient courants dans les systèmes relationnels, tous les magasins de données ne fournissent pas une fonctionnalité équivalente. Certains magasins de données ne disposent pas d’index secondaires, tandis que d’autres fournissent des index qui ne répondent pas aux exigences de requête, de partitionnement ou de performances d’une charge de travail. Dans ces cas, les applications doivent choisir entre les analyses complètes et la gestion manuelle des index.
Solution
Créez une table d’index qui organise les données par une clé spécifiée. La section suivante décrit trois stratégies courantes pour structurer une table d’index. Les deux sections suivantes décrivent les utilisations des tables d’index dans des scénarios spécifiques.
Stratégies standard de structuration
Les stratégies suivantes sont couramment utilisées pour structurer une table d’index. Choisissez une stratégie basée sur le nombre d’index secondaires requis par votre scénario et la nature des requêtes effectuées par votre application.
Dénormalisation complète
La dénormalisation complète duplique les données dans chaque table d’index, mais les organise selon des clés autres que la clé primaire. La figure suivante montre les tables d’index qui organisent les mêmes informations client par Ville et LastName.

Cette stratégie fonctionne bien pour les charges de travail lourdes en lecture dans lesquelles les données changent rarement. À mesure que le taux de mise à jour augmente, la maintenance de chaque copie ajoute une surcharge de traitement (voir Complexité de la cohérence). Pour les jeux de données à volume élevé, le stockage des copies peut également nécessiter un espace important.
Index normalisé
Une table d’index normalisée organise les données par des clés autres que la clé primaire. La table d’index normalisée référence les données d’origine à l’aide de la clé primaire plutôt que de dupliquer ces données, comme illustré dans la figure suivante. Les données d’origine sont appelées table de faits.
Tip
Ici, la table de faits signifie la table source faisant autorité référencée par un index. Il n’implique pas de modèle de données dimensionnel.

Cette technique économise de l’espace et réduit les frais de gestion des données dupliquées. L’inconvénient est qu’une application doit effectuer deux opérations de recherche pour rechercher des données à l’aide d’une clé secondaire. L’application doit rechercher la clé primaire pour les données de la table d’index, puis utiliser la clé primaire pour rechercher les données dans la table de faits.
Dénormalisation partielle
La dénormalisation partielle crée des tables d’index qui dupliquez des champs fréquemment récupérés et sont organisées par des clés autres que la clé primaire. La table de faits est référencée pour accéder aux champs moins fréquemment consultés. La figure suivante montre comment les données couramment sollicitées sont dupliquées dans chaque table d’index.

Cette stratégie équilibre les deux premières approches. Vous pouvez rapidement récupérer des données pour des requêtes courantes à l’aide d’une recherche unique, tandis que la surcharge d’espace et de maintenance n’est pas aussi importante que la duplication de l’ensemble du jeu de données.
Clés composites
Certaines applications interrogent fréquemment des données en spécifiant une combinaison de valeurs, par exemple « Rechercher tous les clients qui vivent à Redmond et qui ont un nom de famille de Smith ». Dans ce cas, créez des clés d’index à partir de plusieurs attributs, tels que les attributs Town et LastName.
Utilisez un encodage qui conserve les limites des composants afin que différentes combinaisons de valeurs ne puissent pas produire la même clé. Si les requêtes dépendent de l’ordre de clé, vérifiez également que l’encodage conserve l’ordre de tri requis sous les règles de classement de clé du magasin de données.
La figure suivante montre une table d’index basée sur des clés composites. Les clés sont triées par Ville, puis par LastName pour les enregistrements qui ont la même valeur pour Town.
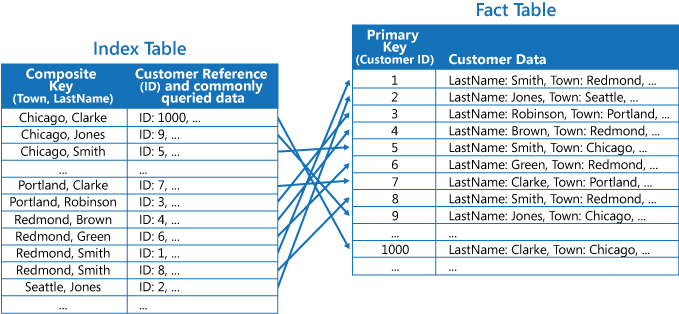
Le diagramme contient une table d’index à gauche et une table de faits à droite. La table de faits organise les données client par la clé primaire, ID client. Chaque ligne Données client contient un nom de client, une ville et un point de suspension indiquant d’autres données. La table d’index est organisée par une clé composite qui combine Town et LastName. Sa deuxième colonne, Référence client (ID) et les données fréquemment consultées, contiennent un identifiant client et un point de suspension. Les flèches s’étendent des lignes de la table d’index à la table de faits, chaque flèche pointant vers la ligne ID client référencée par cette entrée d’index. Les flèches croisées illustrent que les entrées ordonnées par la clé composite peuvent faire référence à des lignes de clients situées à différentes positions dans la table de faits.
Tables d’index sur des données fragmentées
Les tables d’index peuvent accélérer les opérations de requête sur les données partitionnées. Ils sont particulièrement utiles lorsque la clé de partition est hachée. La figure suivante montre un exemple où la clé de partition est un hachage de l’ID client. La table d’index organise les entrées par valeurs non hachées, Town et LastName, et stocke la clé de partition hachée correspondante avec chaque entrée.
Cette configuration prend en charge les recherches par plage et les recherches ordonnées sur les valeurs non hachées, tout en fournissant les informations de routage nécessaires pour récupérer chaque enregistrement dans la partition appropriée. Par exemple, une requête telle que « Rechercher tous les clients qui vivent dans Redmond » peut localiser les éléments correspondants dans un bloc contigu dans la table d’index. L’application suit ensuite les références aux données client à l’aide des clés de partition stockées dans la table d’index.

Problèmes et considérations
Tenez compte des points suivants lorsque vous décidez comment implémenter ce modèle :
Surcharge de maintenance. La gestion des index secondaires peut ajouter une surcharge importante. Analysez et comprenez les requêtes que votre application utilise. Créez des tables d’index uniquement lorsque vous êtes susceptible de les utiliser régulièrement. Ne créez pas de tables d’index spéculatives pour prendre en charge les requêtes qu’une application n’effectue pas ou effectue uniquement occasionnellement. À mesure que le nombre de schémas de requête augmente, le nombre de tables d’index augmente lui aussi, et chacune ajoute de la complexité opérationnelle à surveiller, maintenir et déboguer. Pesez l’avantage de la requête de chaque table d’index par rapport au coût opérationnel de la maintenance d’une autre structure de données dérivée. Passez régulièrement en revue les tables d’index existantes pour identifier et supprimer les tables d’index existantes qui ne sont plus interrogées.
Coût du stockage et du débit. La duplication de données dans une table d’index augmente les coûts de stockage en proportion du nombre de tables d’index et de la taille des champs copiés. La gestion de plusieurs copies de données ajoute également des efforts. Chaque écriture dans une table d'index consomme la capacité de débit, par exemple les transactions par rapport aux limites du compte de stockage dans Azure Table Storage ou les unités de requête dans Azure Cosmos DB. Le coût s’étend au-delà du stockage au débit côté écriture.
Pénalité de double consultation. L’implémentation d’une table d’index en tant que structure normalisée qui référence les données d’origine nécessite l’exécution de deux opérations de recherche par une application, afin de trouver des données. La première opération examine la table d’index pour récupérer la clé primaire, et la seconde utilise la clé primaire pour extraire les données.
Complexité de cohérence. Si un système incorpore un certain nombre de tables d’index sur des jeux de données volumineux, la cohérence entre les tables d’index et les données d’origine peut être difficile. Si les données sources et les entrées d’index ne peuvent pas être mises à jour dans la même transaction, concevez l’application autour d’un modèle de cohérence éventuel. Enregistrez durablement chaque modification apportée à la source avant de confirmer l’écriture. Par exemple, consommer un flux de modifications d’une base de données, utiliser le modèle de boîte d’envoi transactionnelle pour écrire un enregistrement de boîte d’envoi dans la même transaction que la modification source, ou mettre en file d’attente une commande avant de modifier les données source. Dans l’approche basée sur la commande, utilisez un worker pour traiter la commande et mettre à jour les données sources et ses index. Ne mettez pas à jour les données sources, puis publiez indépendamment un message de mise à jour d’index, car une défaillance entre ces opérations peut laisser l’index obsolète.
Concevez le consommateur asynchrone pour qu’il soit idempotent, car la remise des messages et les nouvelles tentatives peuvent entraîner l’exécution de la même mise à jour plusieurs fois. Les mises à jour du même enregistrement source peuvent également arriver dans le désordre. Incluez une version source ou un numéro de séquence dans chaque mise à jour d’index et appliquez une mise à jour uniquement si elle est plus récente que la version de l’index. Pour les suppressions, conservez un marqueur de suppression versionné ou une limite supérieure équivalente afin qu’une ancienne mise à jour arrivée en retard ne puisse pas recréer l’entrée d’index supprimée. Pendant l’intervalle entre l’écriture de données sources et la mise à jour d’index asynchrone, les requêtes sur la table d’index peuvent retourner des références obsolètes aux enregistrements qui ont été mis à jour ou supprimés dans les données sources, et ils peuvent omettre les enregistrements récemment ajoutés.
Partitionnement des tables d’index. Les tables d’index peuvent elles-mêmes être partitionnées ou fragmentées, ce qui complique le routage des requêtes et nécessite que la stratégie de partitionnement soit adaptée aux schémas de requêtes auxquels l’index est destiné.
Quand utiliser ce modèle
Utilisez ce modèle lorsqu’une application doit fréquemment récupérer des données à l’aide d’une clé autre que la clé primaire (ou partition) et que le magasin de données ne prend pas en charge en mode natif les index secondaires ou ses index natifs ne répondent pas aux exigences de requête, de partitionnement ou de performances de la charge de travail.
Ce modèle peut ne pas convenir lorsque :
Les données sont volatiles. Les données changent si fréquemment que le taux d’écriture dépasse le taux auquel les tables d’index peuvent être actualisées de manière asynchrone. La fenêtre d’obsolescence s’allonge jusqu’à ce que l’index soit définitivement périmé, ce qui le rend inefficace et fait que le surcoût en stockage et en débit lié à la maintenance de la table d’index dépasse toutes les économies réalisées sur les requêtes.
Vous avez des clés non discriminantes. Un champ sélectionné comme clé secondaire pour une table d’index n’est pas discriminatoire et ne peut avoir qu’un petit ensemble de valeurs (par exemple, un champ booléen qui enregistre si un élément est actif). La table d’index entraîne un stockage et un débit complets, mais offre une sélectivité de requête minimale.
Les valeurs de données ont une distribution asymétrique. L’équilibre des valeurs de données d’un champ sélectionné comme clé secondaire pour une table d’index est fortement asymétrique. Par exemple, si 90 % des enregistrements contiennent la même valeur dans un champ, la création et la maintenance d’une table d’index pour rechercher des données basées sur ce champ peuvent créer plus de surcharge que d’analyser séquentiellement les données. Toutefois, si les requêtes ciblent fréquemment des valeurs qui se trouvent dans les 10 % restants, cet index peut toujours être utile.
Conception de la charge de travail
Un architecte doit évaluer comment utiliser le modèle de table d’index dans sa conception de charge de travail pour répondre aux objectifs et principes abordés dans les piliers de l’infrastructure Azure Well-Architected. Le tableau suivant fournit des conseils sur la façon dont ce modèle prend en charge les objectifs de chaque pilier.
| Pilier | Comment ce modèle soutient les objectifs des piliers. |
|---|---|
| La fiabilité permet à votre charge de travail de répondre à ses cibles de résilience et de récupération en créant une redondance et en préservant les fonctionnalités pendant les défaillances. | La maintenance asynchrone des index peut empêcher les échecs temporaires de mise à jour d’index de bloquer les écritures de données sources. Le traitement Idempotent, la gestion des lettres mortes, la surveillance et la réconciliation permettent de restaurer la cohérence des index après des échecs. - RE :07 Autopréservation - RE:10 Supervision |
| L’efficacité des performances permet à votre charge de travail de répondre efficacement aux demandes par le biais d’optimisations de la mise à l’échelle, des données et du code. | Les tables d’index permettent d’activer des recherches rapides sur des champs de clé non primaire sans nécessiter d’analyses complètes des données. Pour les magasins de données partitionnés, les tables d’index peuvent organiser les entrées par des valeurs non hachées pour prendre en charge les requêtes de plage et de classement que la clé de partition seule ne peut pas servir efficacement. - PE :05 Mise à l’échelle et partitionnement - PE :08 Performance des données |
Comme pour toute décision de conception, si ce modèle introduit des compromis au sein d’un pilier, considérez-les contre les objectifs des autres piliers.
Exemple
Considérez une application qui stocke des informations sur les films. Supposons que le catalogue soit volumineux et principalement consulté en lecture, que chaque film ait un genre principal, que les requêtes sur les acteurs soient fréquentes, que les données de distribution changent rarement et qu’un bref retard de mise à jour de l’index soit acceptable. Table Storage stocke chaque entité sous forme d’un ensemble structuré de propriétés nommées. Chaque entité inclut un PartitionKey, un RowKey et un horodatage, et les entités d’une même table peuvent avoir des ensembles de propriétés différents.
Table Storage utilise une clé primaire composite composée de PartitionKey et RowKey. La PartitionKey valeur détermine la partition dans laquelle une entité est stockée. Dans une partition, la RowKey valeur identifie de façon unique une entité. Le Stockage de tables est optimisé pour les requêtes qui indiquent à la fois les deux clés ou qui récupèrent une plage contiguë de valeurs de clé de ligne au sein d’une même partition.
Tip
Le stockage de tables prend en charge les mises à jour transactionnelles pour les entités d’une même table et d’une même partition grâce aux transactions de groupe d’entités. Une transaction ne peut pas s’étendre sur une table de faits et une table d’index distincte. Pour mettre à jour une entité factuelle et des entités d’index de manière atomique, stockez-les dans une même table avec le même PartitionKey. Les transactions de groupe d’entités sont limitées à 100 entités par lot avec une charge utile maximale de 4 Mio.
Pour cet exemple, créez une table Azure avec des partitions pour chaque genre en utilisant un identificateur de genre encodé comme clé de partition et un identificateur de film stable et unique comme clé de ligne. Stockez les noms de genre et de film en tant que propriétés. La figure suivante utilise des noms lisibles à la place des identificateurs pour faciliter le suivi de l’exemple.

Cette approche est moins efficace si l’application doit également rechercher les films par acteur principal. Dans ce cas, créez une table Azure distincte qui agit comme une table d’index. Utilisez un identificateur d’acteur encodé et stable comme clé de partition et l’identificateur de film comme clé de ligne. Stockez les noms des acteurs et des films comme propriétés. La figure suivante utilise des noms lisibles à la place des identificateurs. Si un film met en vedette plusieurs acteurs, le même film se produit dans plusieurs partitions.
La figure suivante montre la table d’indexation des acteurs.

Procédure pas à pas de conception
La table de films utilise le genre comme clé de partition, ce qui signifie que les requêtes qui filtrent par genre s’exécutent efficacement sous forme d’analyses de partition sur des plages contiguës de clés de ligne. Toutefois, le stockage de tables ne prend en charge qu’un seul index clusterisé sur PartitionKey et RowKey. Il n’a pas d’index secondaires. Une requête telle que « trouver tous les films avec un acteur spécifique » nécessite une analyse complète de table sur chaque partition de genre, qui est coûteuse à grande échelle.
La table d’index d’acteur résout cette limitation en inversant le modèle d’accès. Chaque identificateur d’acteur devient une clé de partition et chaque identificateur de film devient une clé de ligne, de sorte que les requêtes basées sur les acteurs s’exécutent sous forme de recherches efficaces par partition. Étant donné que chaque partition ne contient qu’un seul film d’acteur, la requête retourne une plage contiguë d’entités sans analyser les données non liées.
Étant donné que les entrées de film et d’acteur utilisent des tables et des clés de partition distinctes, ces entrées ne peuvent pas partager une transaction de groupe d’entités. Maintenez l’index des acteurs au moyen d’un mécanisme durable de capture asynchrone des modifications, et concevez l’application pour tolérer un bref décalage des résultats de requête.
La table d’index applique une dénormalisation partielle : chaque entrée duplique les champs fréquemment consultés (tels que les noms d’autres acteurs) afin que les requêtes les plus fréquentes puissent trouver une réponse à partir de la seule table d’index, en une seule recherche. Pour les champs consultés moins fréquemment, l’entrée contient la clé de partition du genre issue de la table d’origine des films, ce qui permet d’effectuer une requête ponctuelle ciblée sur la partition du genre afin de récupérer l’enregistrement complet. Cette conception équilibre la vitesse des requêtes par rapport aux coûts de stockage et à la surcharge de maintenance.
Étapes suivantes
Les instructions de conception des requêtes stockage table décrivent des modèles d’index secondaires qui utilisent
PartitionKeyetRowKey, notamment, des approches pour stocker des entrées d’index dans la même partition ou dans des partitions distinctes.Les stratégies de partitionnement des données expliquent comment sélectionner des clés de partition et de ligne en fonction des modèles de requête, de la distribution des données, des exigences de transaction et des objectifs de scalabilité.
Les stratégies d’architecture pour optimiser les performances des données fournissent des conseils pour évaluer les modèles de requête, les index, les partitions et les exigences de supervision.
Les niveaux de cohérence dans Azure Cosmos DB décrivent les modèles de cohérence pertinents lorsque vous conservez des tables d’index dans Azure Cosmos DB.
Ressources associées
Les modèles suivants peuvent également être pertinents lors de l’implémentation de ce modèle :
Modèle de partitionnement. Le modèle de table d’index est souvent utilisé conjointement avec des données partitionnées par fragmentation. Le modèle de partitionnement décrit comment diviser un magasin de données en un ensemble de partitions.
Modèle de vue matérialisée. Au lieu d’indexer des données pour prendre en charge les requêtes qui résument les données, il peut être plus approprié de créer une vue matérialisée des données. Ce modèle décrit comment générer des vues préremplies sur des données pour prendre en charge des requêtes récapitulatives efficaces.
Modèle de boîte de réception transactionnelle. Utilisez le modèle de boîte d’envoi transactionnelle afin de publier de manière fiable les modifications pour la maintenance asynchrone de l’index lorsque les données sources et les entrées d’index ne peuvent pas être mises à jour au sein d’une seule transaction.